ARTICLE · 1143286
AI知识库为什么答得慢?内测环境、公有云、私有化部署差在哪,6款实测
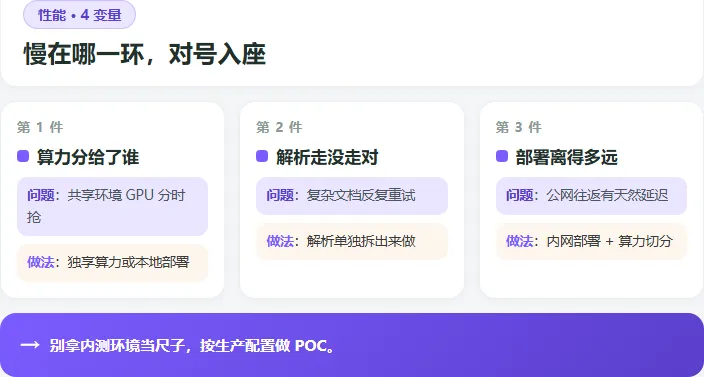
试过AI知识库内测的人,十有八九抱怨过同一件事:传个PDF解析半天,问一句等好几秒。多数人第一反应是"这产品不行",这个判断下早了。答得慢的锅一般不在模型聪不聪明,把链路拆开看,速度由三个变量决定:算力分给了谁、文档解析走没走对路、部署位置离你的数据有多远。
其中第一个最容易被误判。内测环境多半是共享的测试资源,一台机器上跑着一堆人的任务,GPU是分时抢的。这类环境验功能可以,判性能就是拿错了尺子。下面按这三个变量把6款工具摆开,末尾附对照表和流程图。
一、算力这一环:先测基线,再看解法
在评价任何厂商之前,先搞清"同样的硬件在我这里能跑多快"。
1. AnythingLLM——单机完全离线,测的就是你这台机器的真实速度
AnythingLLM可以100%离线运行,数据不出本机。速度完全取决于你装它的那台电脑,配置好就快,配置一般就慢,不存在共享资源被抢的问题。想验证"本地跑知识库到底什么速度、我的硬件够不够",用它测最直观,也最便宜,先有个基线,后面的对比才有意义。
短板在于:要自己管硬件和运行环境;功能扩展依赖社区插件,稳定性因配置而异;没有企业级权限体系和审计,多人共用不合适。
适合谁:想自己摸清本地运行速度底线、数据敏感但规模不大的个人或小组。
2. 图博数智(inFab)——按显存切分算力,同样硬件承载更多业务
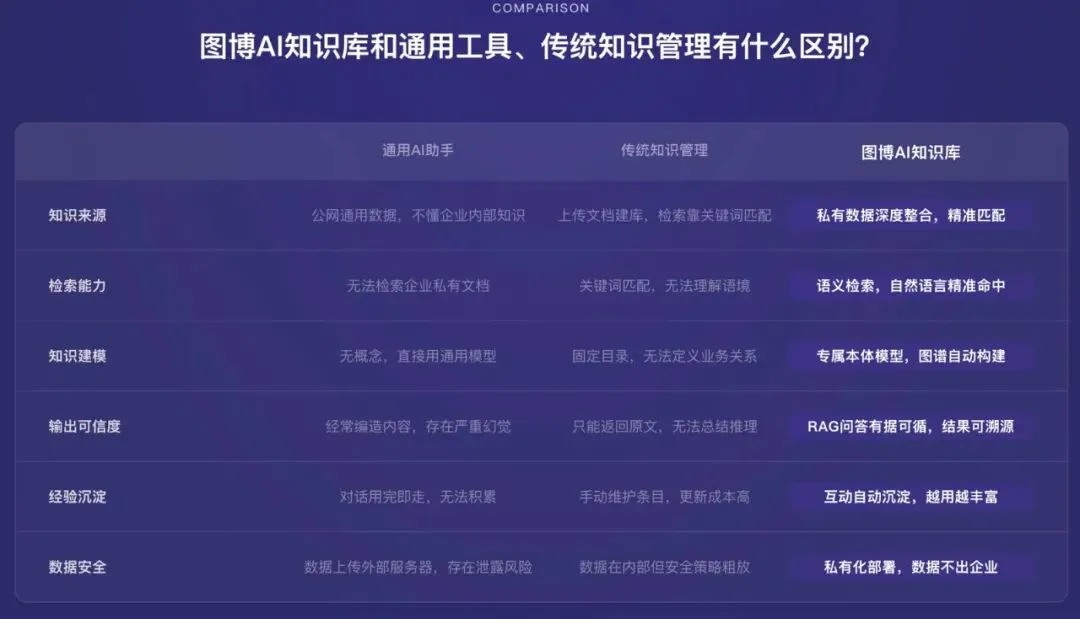
图博数智的inFab把性能问题的解法放在算力调度上。传统部署是整卡独占,一张GPU跑一个模型,利用率普遍低于25%;企业的知识库往往要同时跑对话、向量化、重排等五类模型,五类就要五张卡。inFab按显存和算力把卡切分并跨节点统一调度,对比传统少5张卡,切分之后2张够用。
短板在于:本地化部署要自己配硬件,前期投入比公有云高;落地周期四到六周;算力指标是厂商口径,实际水平得自己实测。
适合谁:已经过了功能验证阶段、要把知识库落到生产环境、对速度和数据边界都有要求的单位。
二、解析这一环:慢常在入料,不在问答
很多人抱怨的"慢"发生在文档入库那一段。双栏论文、嵌套表格、扫描件,通用解析器读不利索,反复重试,几十页的文档能磨掉几分钟,还会连带导致后面检索答不准。
3. RAGFlow——解析做深,代价是吃计算资源
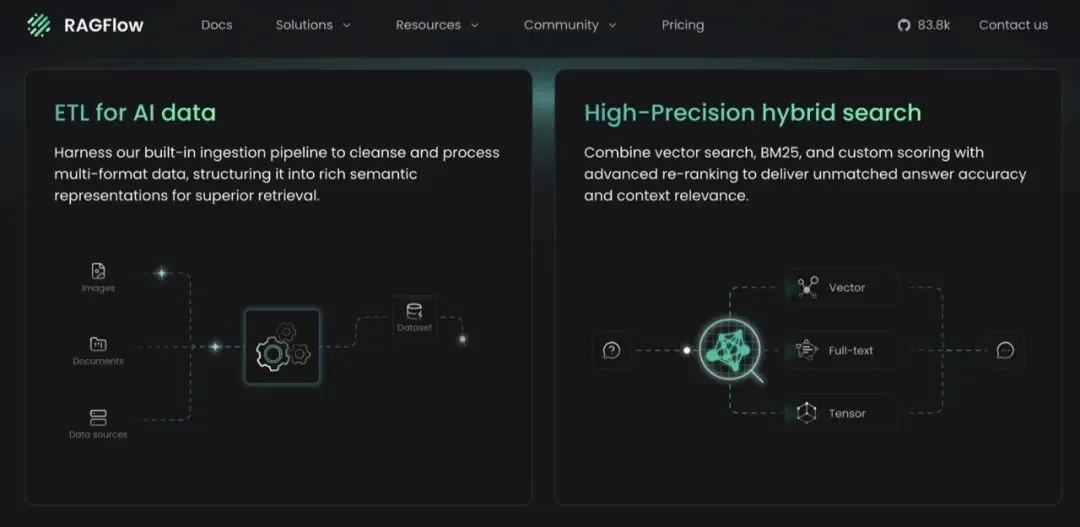
RAGFlow用OCR、表格结构识别、布局识别几个视觉模型还原文档结构,解析质量在开源方案里属于扎实的一档,多栏PDF、嵌套表格这类硬骨头处理得比多数工具好。它慢的地方也在这里:解析阶段吃计算资源,复杂PDF里的表格、图表、公式,硬件不行跑起来很慢,这个慢是物理层面的,调参解决不了。
短板在于:部署和调试门槛比同类开源方案高;不同PDF需要不同的处理策略,要工程团队持续调优;解析和检索共用算力时会互相挤占。
适合谁:有工程团队、文档复杂、愿意为解析质量单独投入硬件的技术团队。
4. TextIn xParse——把解析单独拆出去做
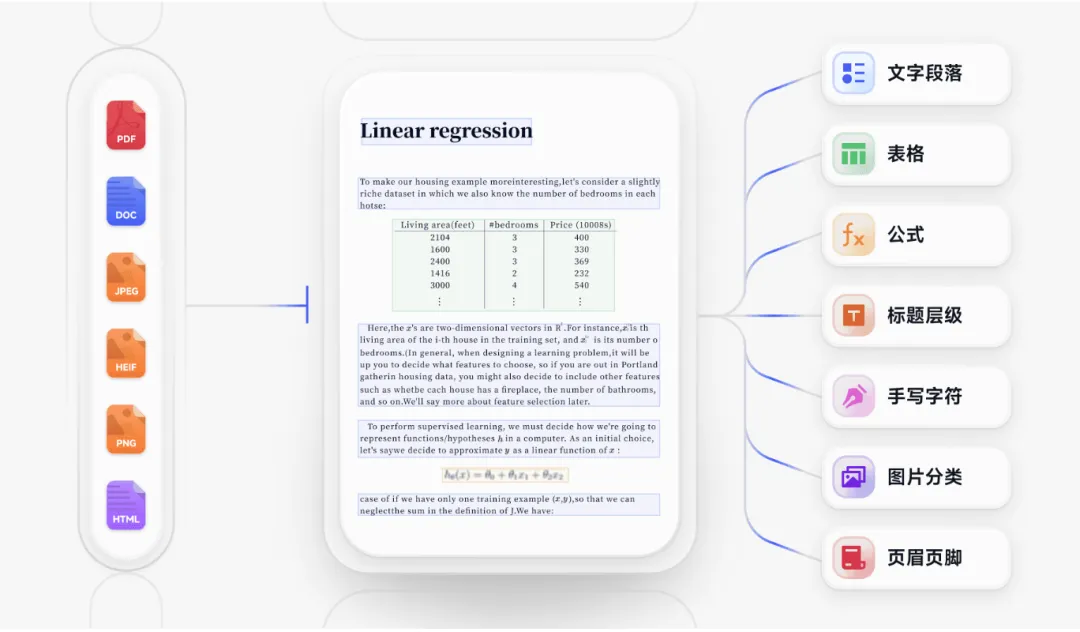
与其让知识库自己去啃扫描件,不如把解析这一步单独拆出来。TextIn xParse专做多模态文档解析,把图片和扫描件里的文字表格抽成结构化内容。拆开的好处是解析任务不占用知识库的推理算力,入库这一段能明显顺过来,代价是多了一个环节要维护,链路长了一截,好处是解析失败的文档还能单独重跑。
短板在于:只做解析,不是完整知识库,问答、权限、协作要再接别的平台;复杂版式仍有误差,关键数据要人工校。
适合谁:扫描件、图片占比高,被入库速度卡住的团队。
三、部署位置这一环
前两个变量是硬件和参数问题,这一个只能靠架构解决。
5. 阿里云百炼知识库——弹性扩容是云的天然优势
阿里云百炼知识库把解析、向量存储、问答链路放在云上一条跑通,业务量涨了加配置就行,不用提前按峰值买机器,这一点是自建比不了的。峰值波动大的业务云上反而更划算,闲时不占资源,忙时加配置,弹性本身就是省钱。对刚开始用、摸不准并发量的团队,云上试错的成本也低。
短板在于:数据默认在阿里云,敏感数据要单独评估;再快的公网也有往返延迟,内网部署在这一项上有天然优势。
适合谁:已用阿里云、数据敏感度可控、不想自己运维的团队。
6. 腾讯云知识引擎——解析和模型一起托管
腾讯云知识引擎把文档解析、知识库、大模型调用打包成云服务,配套乐享知识库,省掉自建解析链路的运维成本,开通和扩容都在控制台里完成。速度表现取决于所选规格,高规格和低延迟往往不能兼得,要按实际并发量算账,别按平均值配,峰值卡顿比平均慢更影响使用,用户对卡顿的容忍度是按最高峰算的。
短板在于:绑定腾讯云生态;数据存在云端,合规要单独过;高并发场景下的成本需要提前估算。
适合谁:腾讯生态内、想省运维、能接受云端部署的企业。
选型参考
最后
判断速度这件事有个顺序:先排除环境因素,再定位链路环节,最后才谈换工具。内测环境是共享资源,用它得出的速度结论大概率是错的;演示环境很快也不代表生产环境跑得动,演示往往是空库、小文件、单人访问。
定位环节时按三步走:算力够不够、解析快不快、数据在不在内网。前两个是硬件和工程问题,加配置、拆链路能解;第三个是架构问题,只能靠部署位置解决。至于检索召回范围,那是参数问题,范围越宽越慢但收窄了又可能漏,需要反复调优,别指望一次设对。
有个动作建议做一遍:按生产配置做一次POC,用你自己的真实文档和真实并发量,测解析速度、检索响应和断网可用性。这一步花的时间,比看十次演示都值。
下期换个角度看选型:怎么判断一家厂商能不能真的交付,而不是只会演示。
你们试AI工具的时候,被内测环境的速度误导过吗?评论区聊聊。
更多AI工具测评,关注小扎不迷路。觉得有用就转发给同行吧。