ARTICLE · 1143342
AI 推理支出首次超过训练,钱花在了使用上
斯坦福的 AI 指数统计过一组数,同样能力水平的模型,每百万词元的调用价格从 20 美元降到了 0.07 美元。但企业的 AI 支出在涨,而且涨得不轻。Gartner 的预测把这件事说清楚了:2026 年全球推理支出将达到 233 亿美元,首次超过 190 亿美元的训练支出,占 AI 基础设施总盘子的 55%,2027 年这个比例会升到 59%。
国内的量级更能说明问题,中国工程院院士邬贺铨在 2026 年 9 月 23 日的 2026 年中国国际信息通信展览会上说,截至 8 月,我国日均词元调用量已经突破 500 万亿,复合年均增长率 333%。这个数字往前倒着看更清楚,2025 年初是 7 万亿,年中 30 万亿,年末 100 万亿,2026 年 3 月超过 140 万亿。价格降了,用量涨得更快,总支出自然往上走。
全球范围内的用量分布也在往一边挪,OpenRouter 是一个聚合多家模型的第三方平台。它统计的 2026 年 9 月 28 日到 10 月 4 日那一周,全球大模型总调用量是 166 万亿词元,其中中国大模型 57.46 万亿,是同期美国 16.2 万亿的 3.5 倍,中国模型已经连续 22 周排在这个平台的第一。需要说明的是,这个数字只涵盖通过第三方接口的调用,不含厂商自有接口、云服务市场和私有部署。
钱涨在哪儿,答案在智能体身上。以前用 AI 是问一句答一句,你说完,计算就停了。换成 Agent 干活,用户只下一条指令,后台要拆解任务、读资料、调工具、检查结果,中间可能发生几十次模型调用。Gartner 的口径是,智能体类任务每个任务消耗的词元是普通问答的 5 到 30 倍;Futurum Research 的测算是 10 到 100 倍。一家做呼叫中心咨询的公司在自己的编程 Agent 用量里看到,九月有 96% 的输入是在重读之前的对话,不是问新问题,是把上下文一遍遍喂回去。
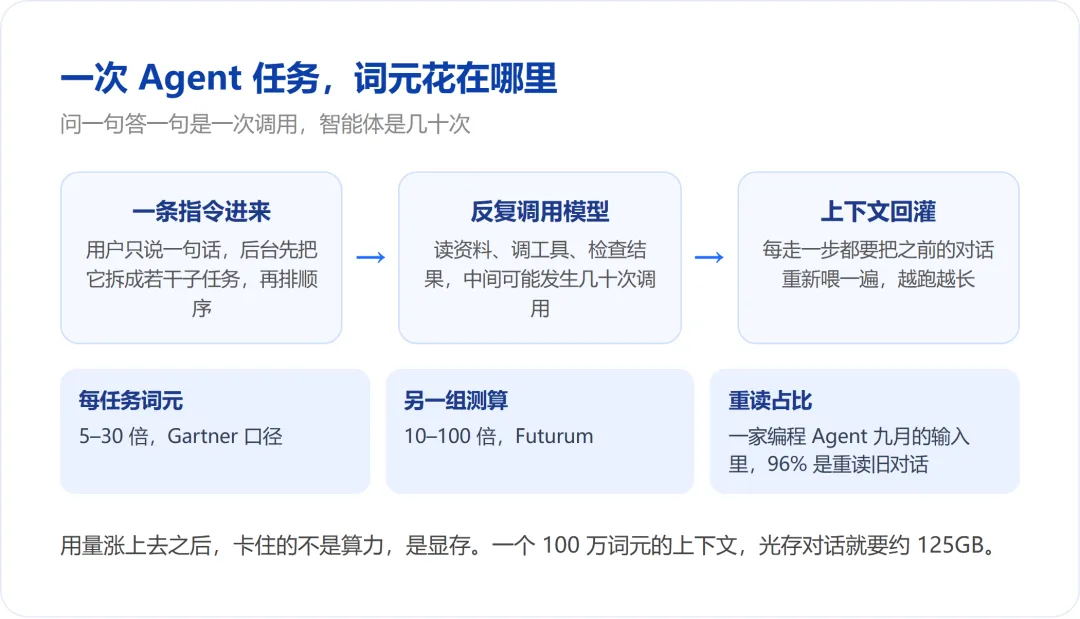
用量涨上去之后,卡住的不是算力而是显存。公开的测算里,一个 100 万词元的上下文,光存对话的工作记忆就要约 125GB,比一张 A100 显卡的 80GB 还多。芯片厂这半年的动作也都在这上面,谷歌第八代 TPU 把片上内存翻了三倍,英伟达拿 BlueField-4 专门做长时间任务的上下文存储。
这里面有个反直觉的地方,算法、芯片和工程优化一直在压低单个词元的成本,可成本越低,原本算不过账的场景就越容易被打开,调用量和总支出反而一起往上走。十九世纪蒸汽机效率提高之后,英国的煤炭总消耗没有下降,反而暴涨,道理是同一个。
所以现在的分歧不在"要不要用",而在哪一步用贵的。中国信通院的报告给过一组对照:闲聊、娱乐问答这类消费级场景,大约 0.01 美元一百万个词元;药物研发、金融量化、精密代码生成这类产业级场景,可以到 1000 美元一百万个词元。企业开始按这个差价重新分工,日常的分类、摘要、翻译交给小模型甚至放到本地设备上跑,前沿模型只留给真正难的那几步。
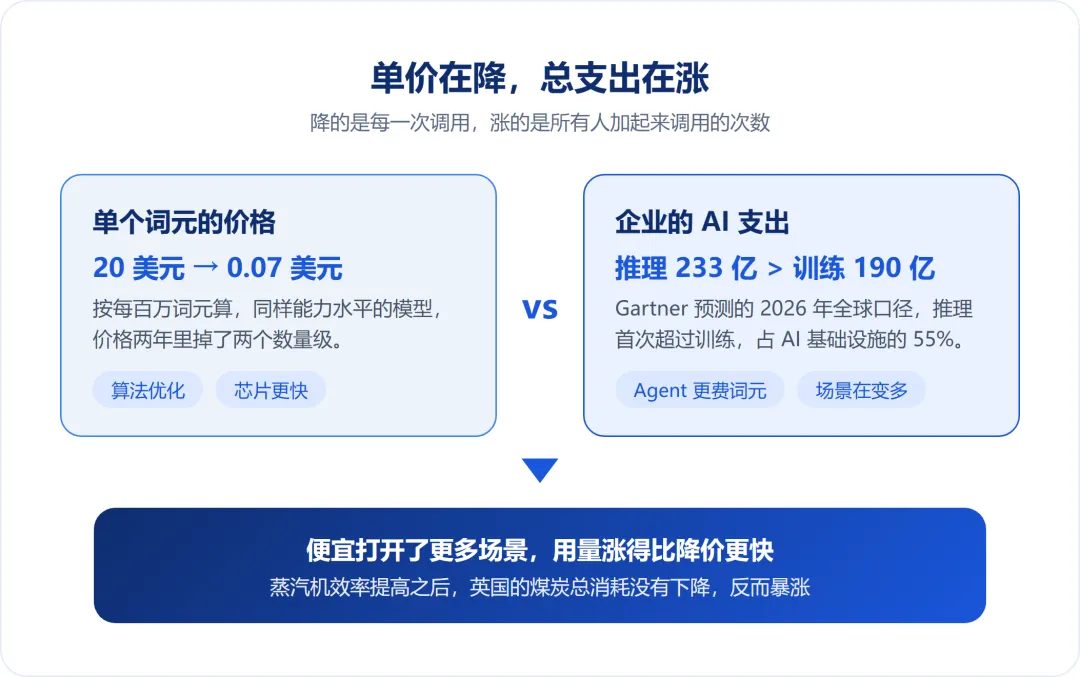
交叉点改的是支出的性质,训练是一次性的投入,建完就完了;推理是每天都产生的流水,用一天付一天。定价方式也跟着变,按席位包月的模式在退,按用量、按任务完成结算的模式在上来。国内这一年的动作是同一个方向,腾讯把 QClaw 相关业务并进 WorkBuddy 部门,字节八月发了"豆包工作",阿里九月在云栖发布千问办公和随身助理。
价格降下来,股价是最先给出反应的那一环。Anthropic 在10月7日发布的 Claude Haiku 5.5,这款模型的官方口径是平均运行成本比上一代下降约 75%;提示词长度不超过 10 万词元的那部分请求,价格比上一代低 90%,超过 10 万词元的部分低 50%。同日 Anthropic 还把 Sonnet 5.5 的缓存读取价从每百万词元 0.20 美元降到 0.10 美元。受此影响,2026 年 10 月 8 日港股收盘,国产大模型MiniMax 跌超 13%,智谱跌超 7%,跌幅远大于指数。
往前看,2026 年 7 月以来阿里云两次下调百炼平台的模型单价,DeepSeek 在 2026 年 9 月 9 日下调 V4-Flash 系列的接口价格,2026 年 10 月 7 日又轮到 Anthropic。
对个人来说,这种变化已经有感知。免费额度在收紧,按量计费在变多,办公类的助手一个接一个冒出来。它们不是突然变聪明了,是背后这笔流水开始算得过账了。真正涨价的不是模型,是使用。