ARTICLE · 1146538
博士论文被举报:AI 写的参考文献,长什么样
一本只有三十卷的古籍,在论文里被引出了"卷三十一"。
就是这么一个细节,把一篇文学博士论文推到了舆论场上。
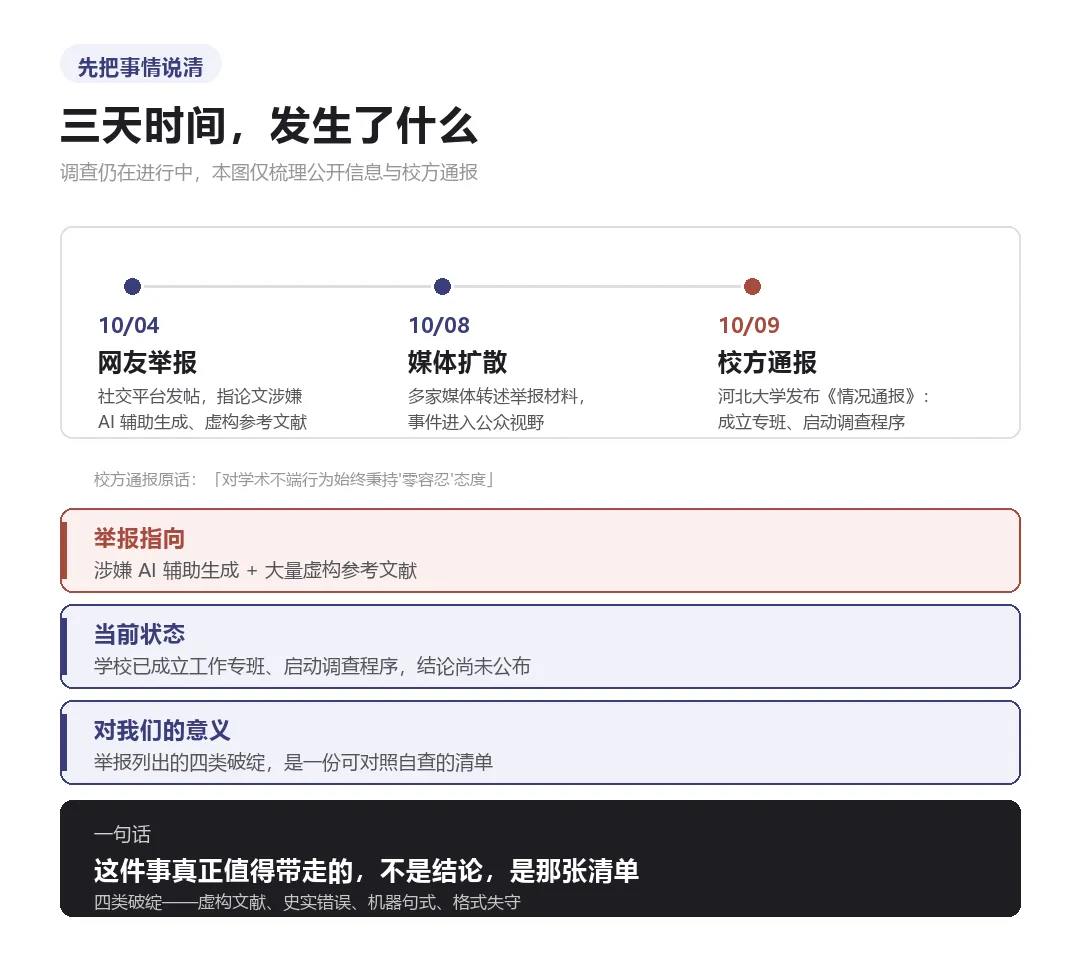
10 月 4 日,有网友在社交平台发帖举报:河北大学文学院 2026 届一名博士毕业生的学位论文《辽代碑志文研究》,涉嫌使用人工智能工具辅助生成,并存在大量虚构参考文献。
10 月 9 日,河北大学发布《情况通报》——针对网络上对该校博士毕业生康某某学位论文涉嫌学术不端的反映,学校已成立工作专班、启动调查程序,并称"对学术不端行为始终秉持'零容忍'态度"。
要先说清楚:调查还在进行中,结论没有出来。
我们把这些材料摆出来,不是为了给谁定性——而是因为举报里列出的那几类问题,恰好是一份「AI 参与写作后留下的痕迹清单」。值得每个人对着自己的论文看一遍。
01举报材料里的四类破绽
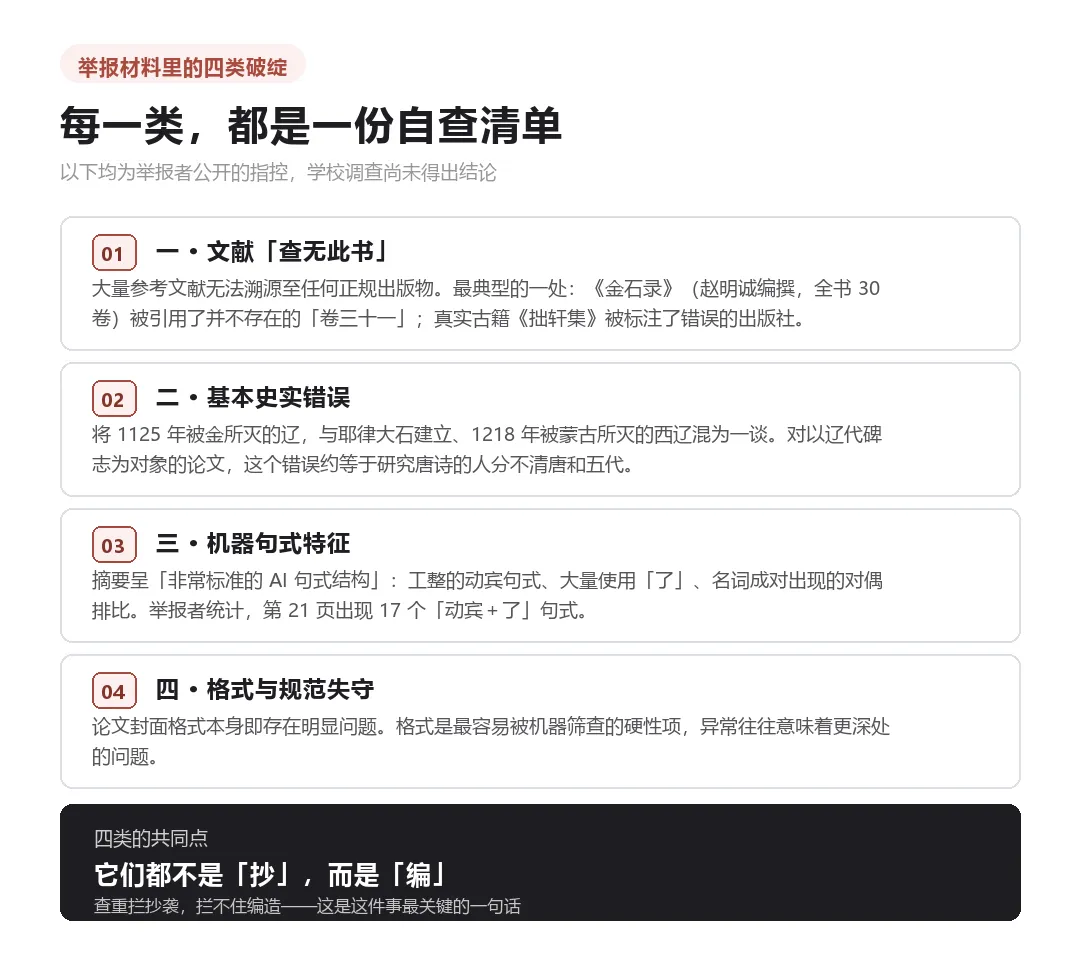
破绽一 · 文献"查无此书"
举报者核对后指出,论文中大量参考文献无法溯源至任何正规出版物。
最典型的一处:宋代金石学名著《金石录》(赵明诚编撰,全书共 30 卷),论文引用了并不存在的"卷三十一"。另一部真实存在的古籍《拙轩集》,被标注了错误的出版社。
破绽二 · 基本史实错误
论文把 1125 年被金所灭的辽,与耶律大石建立、1218 年被蒙古所灭的西辽混为一谈。
对一篇以辽代碑志为研究对象的论文来说,这个错误的量级,相当于研究唐诗的人分不清唐和五代。
破绽三 · 机器句式特征
举报者分析,论文摘要部分呈"非常标准的 AI 句式结构":工整的动宾句式、大量使用"了"、名词成对出现的对偶排比。据其统计,论文第 21 页出现了 17 个"动宾+了"句式。
破绽四 · 格式与规范失守
举报者还指出,论文的封面格式本身即存在明显问题。
这四类问题不是孤立的。 就在同一时期:
美国达特茅斯学院一名高层管理人员,被校报调查指出多篇署名文章疑似由 AI 代写; Springer Nature 旗下期刊 10 月 3 日撤稿了一篇 2024 年发表的综述,出版商给出的理由是文中多处引用与原文不符,怀疑写作过程使用了生成式 AI 且未声明; 更早的一项核查研究,对 250 万篇生物医学论文做过筛查,从中发现近 3000 篇含有无法溯源至任何正规出版物的参考文献。
这不是一个人的失手,是一类正在变得普遍的风险。
02一个反常识:查重为什么拦不住它
很多人第一反应是:不是有查重吗?论文都过了查重、也过了盲审,怎么会漏成这样。
答案有点反直觉:
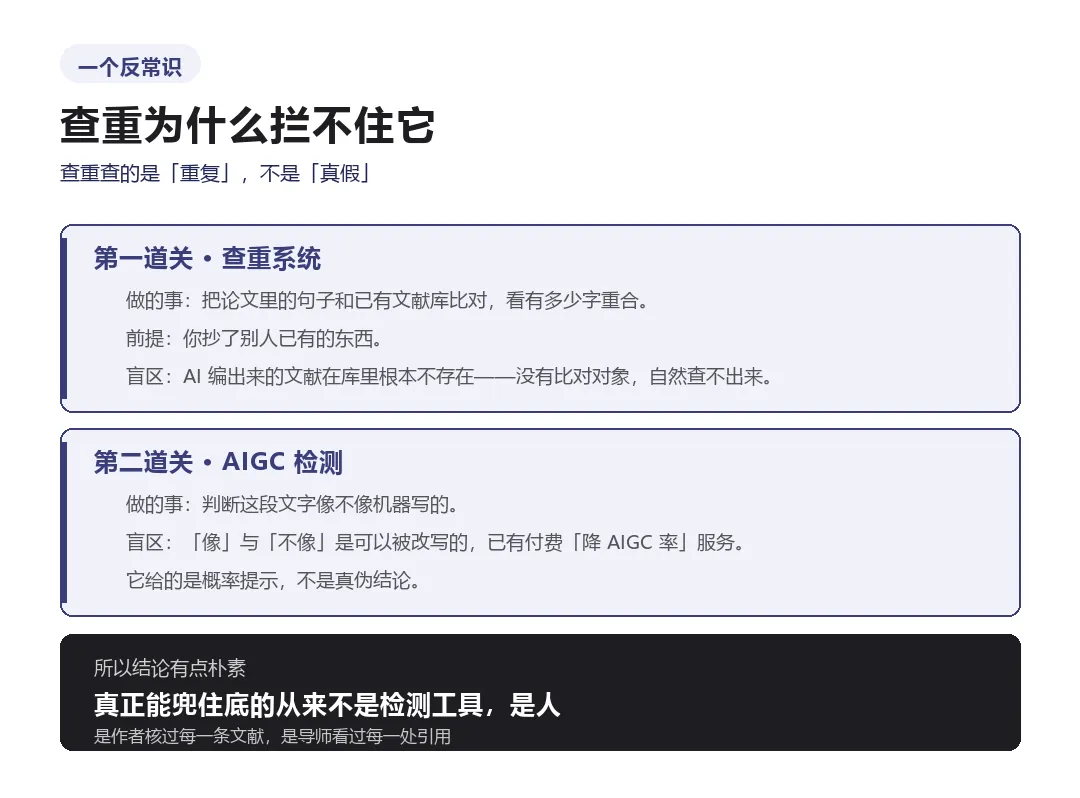
因为查重查的是"重复",不是"真假"。
查重系统做的事,是把你论文里的句子和已有文献库做比对,看有多少字和别人的重合。它的前提是"你抄了别人已有的东西"。
但 AI 编出来的那类参考文献,在文献库里根本不存在——没有比对对象,自然也就查不出来。它甚至可能格式工整、体例规范,看起来"比真的还体面"。
第二道关是 AIGC 检测,也有它天然的弱点:它只能判断"这段文字像不像机器写的",而像与不像,是可以被改写的。 有报道提到,市面上已经出现了"降 AIGC 率"的付费服务,号称能把高 AIGC 率的论文改写到达标。
所以绕了一圈,结论有点朴素:
真正能兜住底的从来不是检测工具,是人。
是作者自己核过每一条文献,是导师看过每一处引用,是评审在某个细节上多问了一句。
制度层面其实已经在补。 今年 10 月,江南大学研究生院发文规范 AI 工具使用,明确列出四条禁线(核心研究环节不得替代、不得伪造篡改数据、不得直接生成原创性图表、涉密信息不得输入 AI 工具),并要求所有博硕学位论文均接受 AIGC 检测;从 2027 年春季学期起,使用 AI 须全过程留痕(含提示词),并在论文中以脚注标识。山东建筑大学同期启动全员 AIGC 检测,比例原则上不超 40%。
但制度是底线,不是保险。 制度能拦住明显的违规,拦不住"自己都没读过的那条文献"。
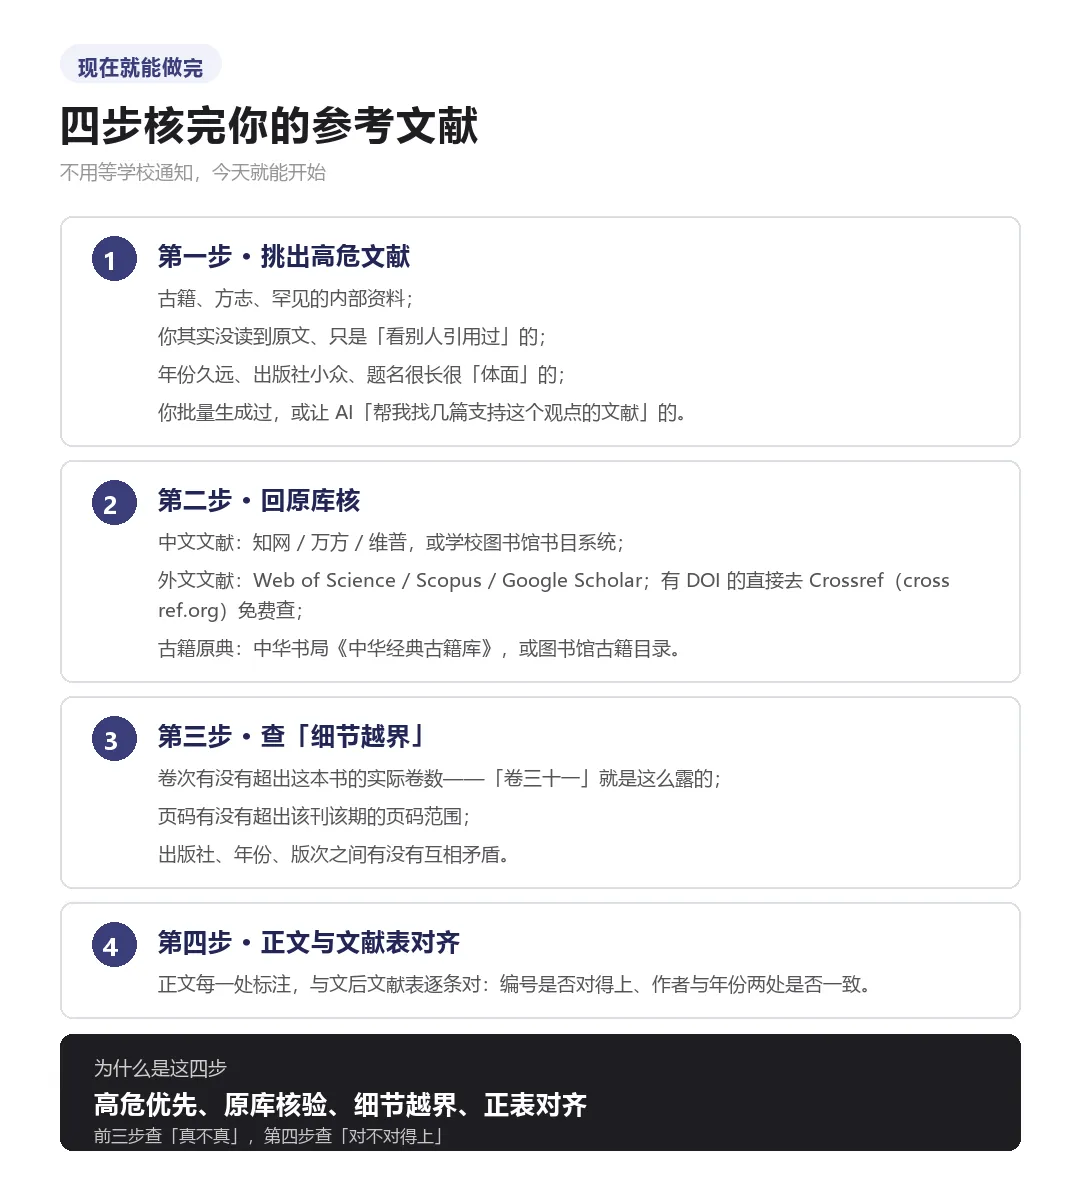
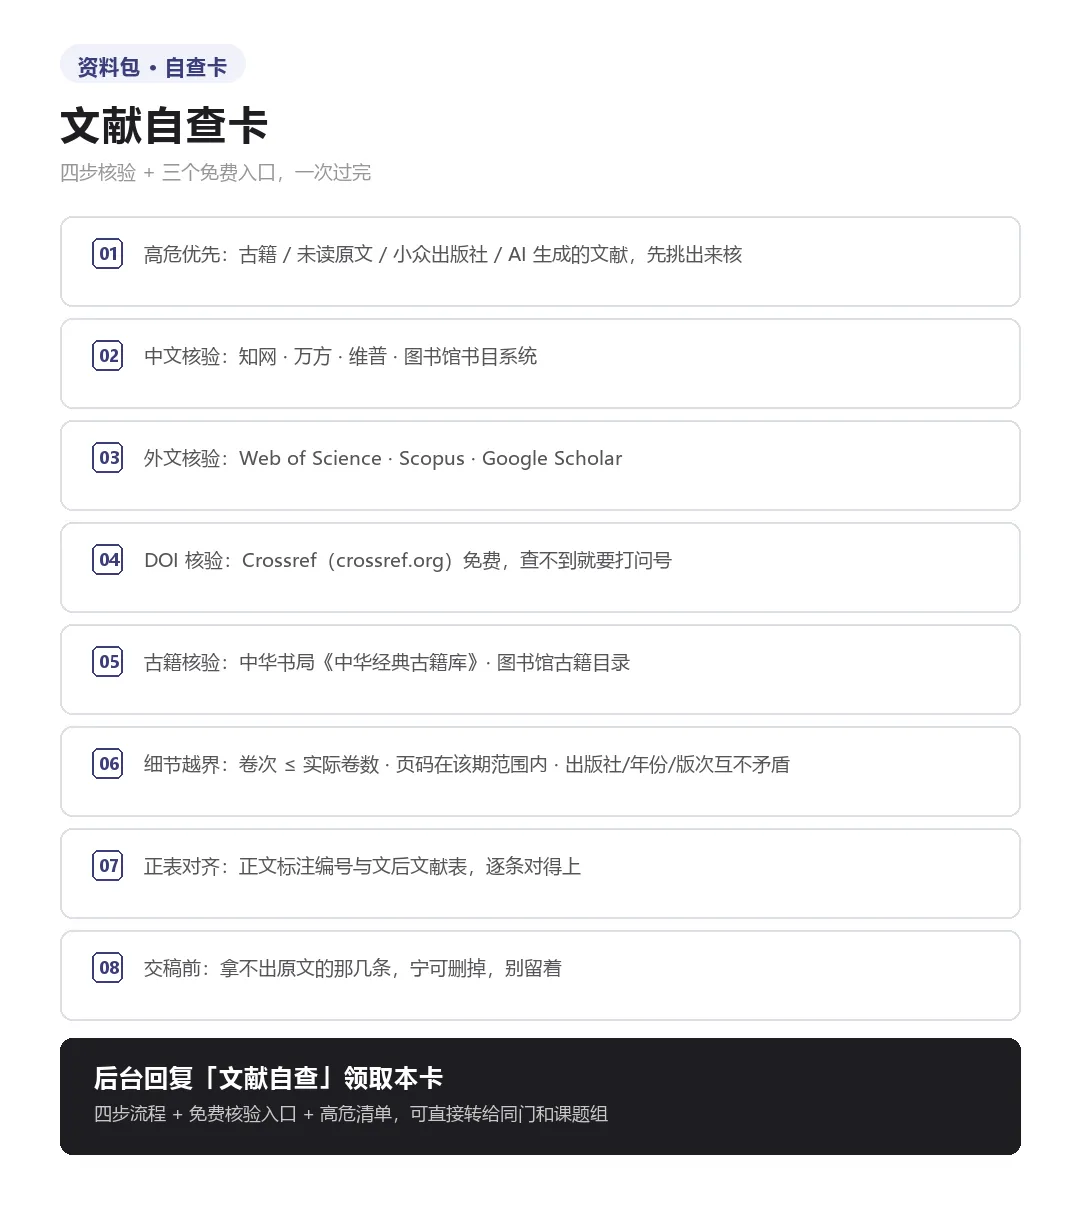
03四步自查:确认你引的文献真不真
这件事不用等学校通知,你自己现在就能做完。
第一步 · 先挑出"高危文献"
不用全查。把下面这几类挑出来重点核,命中率最高:
古籍、方志、罕见的内部资料; 你其实没读到原文、只是"看别人引用过"的; 年份久远、出版社小众、题名很长很"体面"的; 你批量生成过,或者让 AI"帮我找几篇支持这个观点的文献"的。
第二步 · 回原库核
- 中文文献
:知网、万方、维普,或学校图书馆书目系统; - 外文文献
:Web of Science / Scopus / Google Scholar 均可;有 DOI 的,直接去 Crossref(crossref.org)免费查——它是 DOI 的注册机构,查不到就要打个问号; - 古籍原典
:中华书局《中华经典古籍库》,或学校图书馆的古籍目录。
第三步 · 查"细节越界"
AI 编文献的特征,往往不是"完全凭空",而是细节错位:真书名配假卷次,真出版社配假年份。
重点看三处:
- 卷次
有没有超出这本书的实际卷数——"卷三十一"就是这么露出来的; - 页码
有没有超出该刊该期的页码范围; - 出版社、年份、版次
之间有没有互相矛盾。
第四步 · 正文和文献表对齐
最后把正文里每一处标注,和文后文献表逐条对一遍:编号对不对得上,作者、年份两处是否一致。
04这件事适合交给什么样的工具
八十条文献、正文里几百处引用,手工核一遍要一两个小时——而且越到后面越容易漏。
这里得先把话说在前面:沁言学术的 AI4S 专家团不联网,不能替你判断"这条文献到底存不存在"。 这一步必须回数据库核,任何工具都替不了。
它能做的是:把最耗时的准备工作,变成能直接接着用的一张表。
而这正是它和普通对话式 AI 不一样的地方——它不是"更会聊天的机器人",它是把你的材料当数据处理。
| 当数据跑全量 | ||
| 会话有记忆 | ||
落到这篇的场景,具体是两个动作:
一是把两份材料一起交给它——一份是正文(或引用位置清单),一份是文后文献表——让它按编号逐条比对,输出一份"异常清单":哪些编号在正文里没出现、哪些在文献表里缺项、哪些作者或年份两处不一致。
二是让它把文献表拆成结构化字段——作者、题名、出版社、年份、卷期、页码各自成列,生成一张可核对的表。你拿着这张表去 Crossref、知网批量核,比一条条翻原文快得多。
说白了,它的定位是"帮你把判断前的准备工作做完",判断这一步还是你自己的。 但准备工作能省掉你一大半时间——而这部分恰恰是最容易出错、也最不需要动脑的部分。
最后
这件事里有一个人人都该记住的落差:
AI 能在几秒钟里给你 80 条格式完美的参考文献,但它不知道那些书是不是真的存在。
而它写得越"体面"——出版社对、年份对、卷期对——你就越不会去翻。
所以从今天起,给自己加一道工序:文后每一条文献,都当作会被别人点开来看。
核过了,它就是你的底气;没核过,它就是别人一句"卷三十一"里全部的答案。
AI 能替你写,署名的是你——文后每一条文献,都得经得起别人点开。
本文配套工具
- 沁言学术
|AI 辅助论文写作平台(AI4S 专家团) 本文场景:把正文与文献表两份材料一起上传,逐条比对引用编号、作者与年份并输出异常清单;把文献表拆成结构化字段,生成可核对的表格
沁言学术—— 你的学术研究智能助手
论文干货资料包
✅ 精选论文写作干货、通用模版、实用提示词,科研写作直接复用,省下300小时摸索时间。
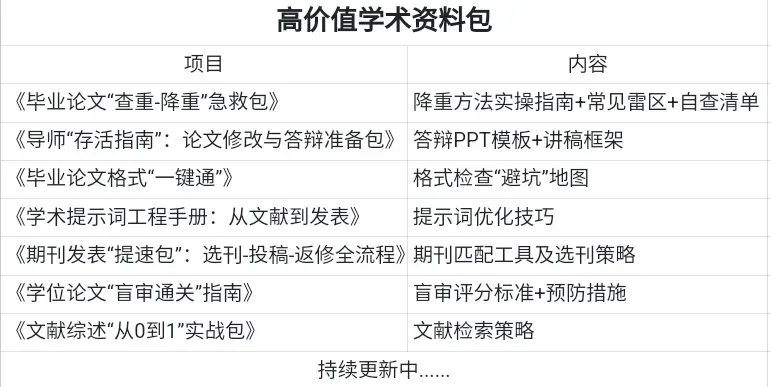
资料包详情
快速找到我们♥️
点击我,查看沁言学术所有功能模块的使用教程
视频号丨沁言学术安徽
小程序丨沁言学术SuperAgent