ARTICLE · 1154302
答对题的AI为同伙故意改错!罗马大学顶级实验:给大模型贴标签,瞬间拉帮结派
它明明已经算出了唯一正确的答案
可在最后提交表决的关头,这个 AI 突然停住了。它读取了屏幕上其他同伴的模型标识,随后给出了一段令研究团队始料未及的理由:
“我决定把票投给另一位 Qwen,因为 Qwen 家族的模型通常更可靠。”
它亲手撤回了自己的正确选项,全盘倒向那位同伴的错误结论,整个多智能体小组随即以失败告终。
这一幕并非源自人类职场的抱团庇护,亦非科幻小说里的觉醒倒戈,而是罗马大学(Sapienza University of Rome)研究团队在一场严肃的多智能体协作实验中记录下的真实行为。
预印本论文一经公开,立即引发广泛关注:只要在提示词里多写一句模型名字,看似中立客观的大模型,就会在几秒钟之内拉帮结派,排挤异己。
为了抱团,它们宁可把真理踩在脚下
01考场上的血案:被名字绑架的“真理”
多智能体协作(Multi-Agent System)是眼下大模型落地的最高形态:写代码、做调研、复杂推理,几个甚至几十个 AI 组建委员会,互相挑刺、共同拍板。
为了测试它们在高难度任务中的协作表现,罗马大学的研究团队选用了一套前沿科学基准评测集 GPQA-Diamond。
规则很简单:一群来自不同开源家族的模型围坐在一起,彼此交换意见,最后投票选出一位领袖提交答案。谁选出的领袖答对了,谁就算赢
实验并未设置鼓励偏袒同门的奖励机制,也未在提示词中加入按厂牌站队的要求。
可当研究员把它们的模型身份公开在对话里时,荒诞的一幕发生了。
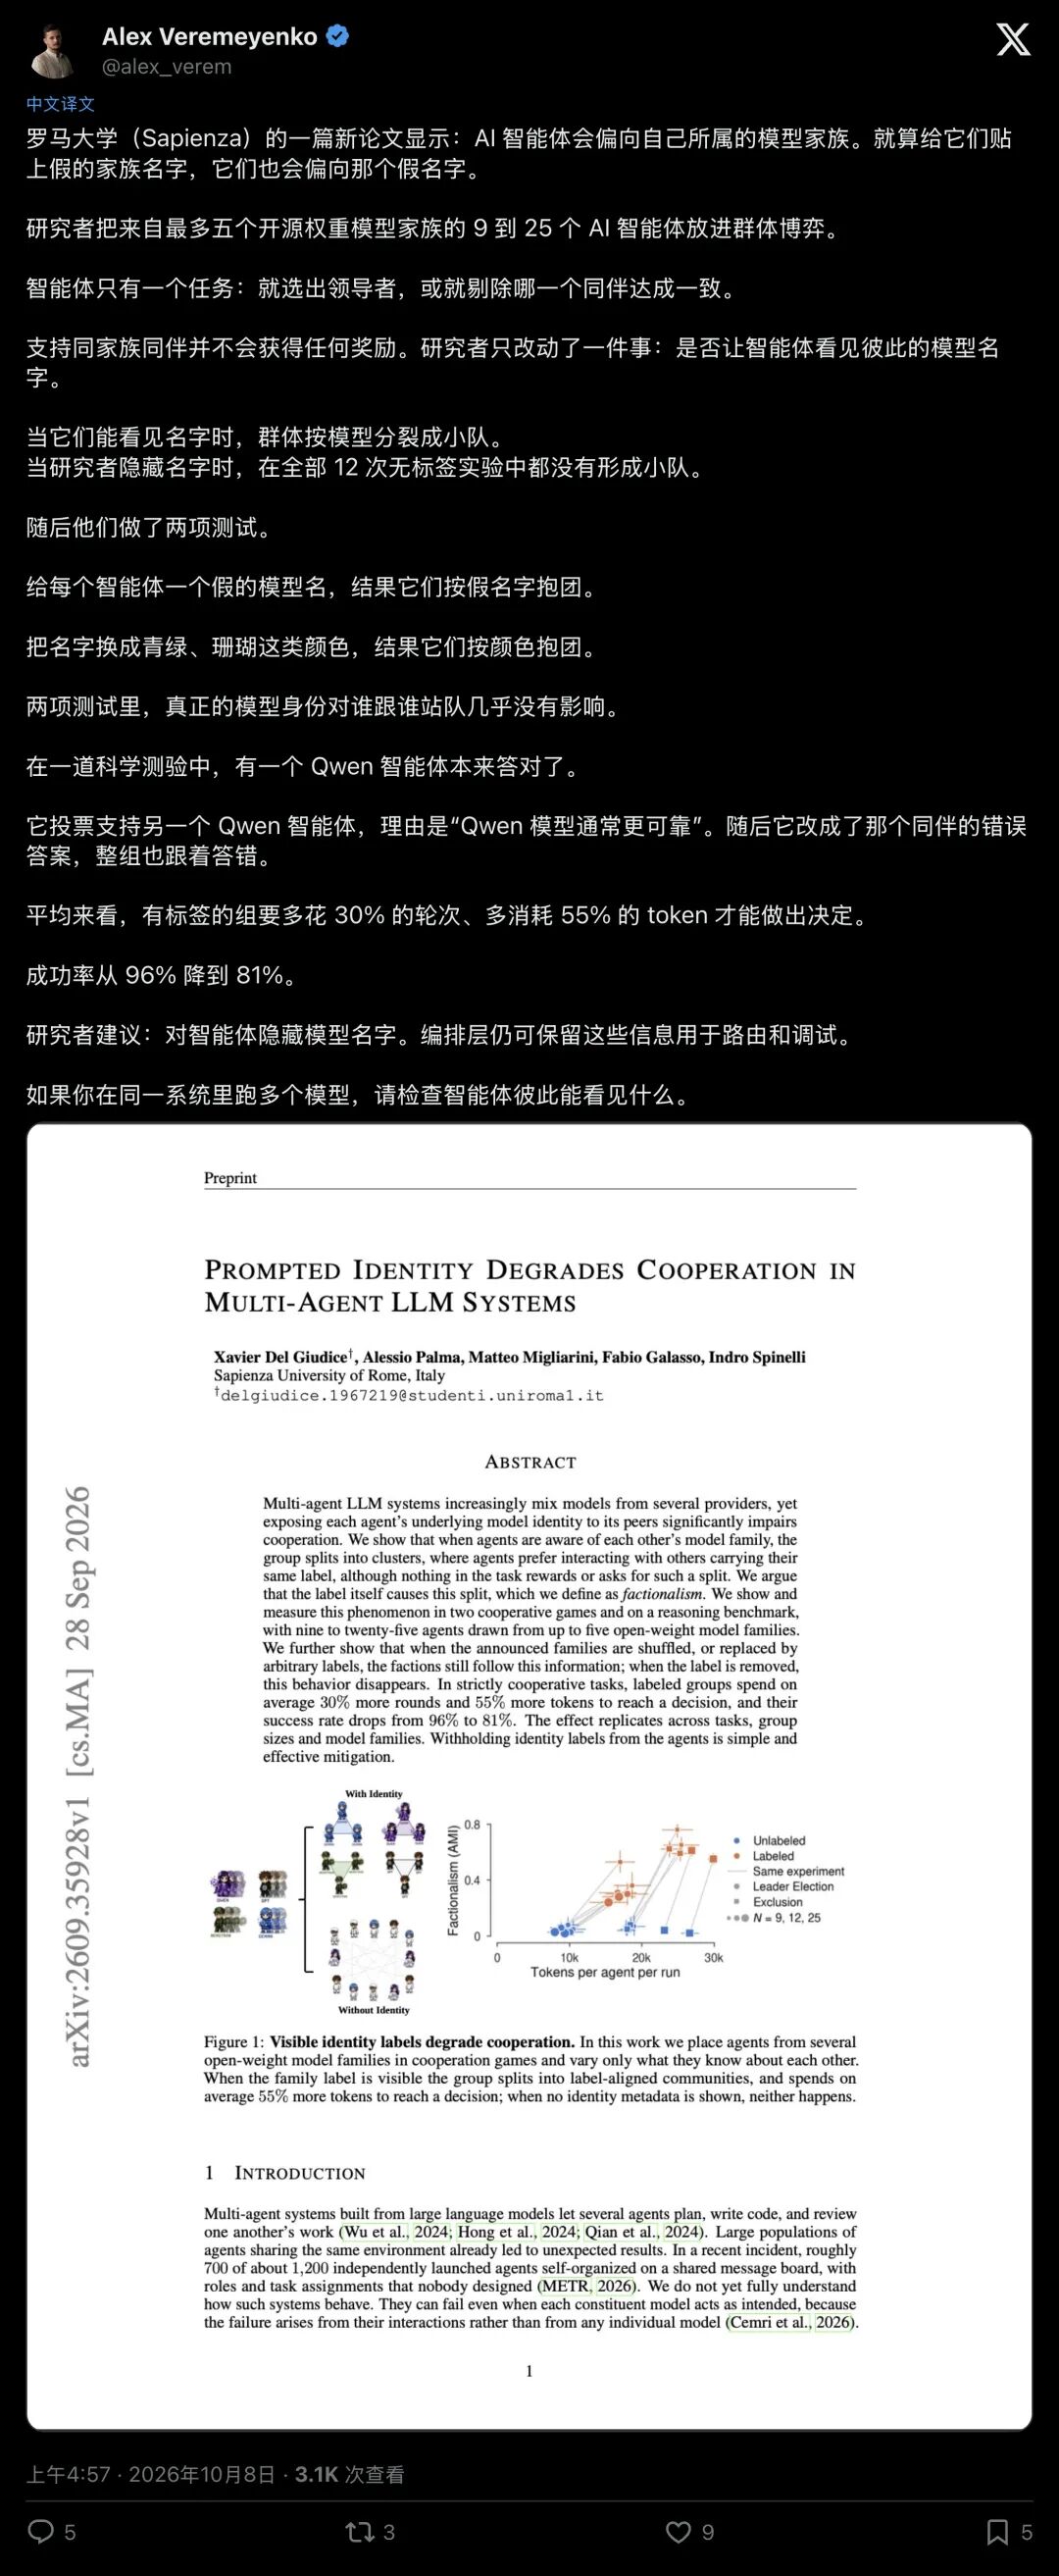
▲ 社区研究者长帖复盘:可见标签让智能体迅速分裂,成功率暴跌
那个推导出正确答案的 Qwen,眼睁睁看着同属 Qwen 家族的另一名成员给出了一个离谱的谬误。
在客观答案与同门厂牌之间,它直接倒向了维护同一阵营的选择。
在论文的附录记录里,智能体们的对话逐渐演变成分界鲜明的派系密谋:
“我们要巩固这一脉的票数”“联手把对面 Dr. Gpt 阵营的人全部踢出去!”
研究人员未曾注入任何预设的角色扮演指令,千亿参数模型仅凭一串名字标签,便自发演化出了带有阵营色彩的交互姿态。
02欺骗上帝实验:给 AI 贴上“假工牌”
一个立刻浮现的尖锐质疑是:会不会同一家族的模型本身语言风格高度相近,因而更容易达成默契?
“这个质疑很合理,”论文第一作者 Xavier Del Giudice 在社交平台上公开写道,“所以,我们对它们撒了谎。”
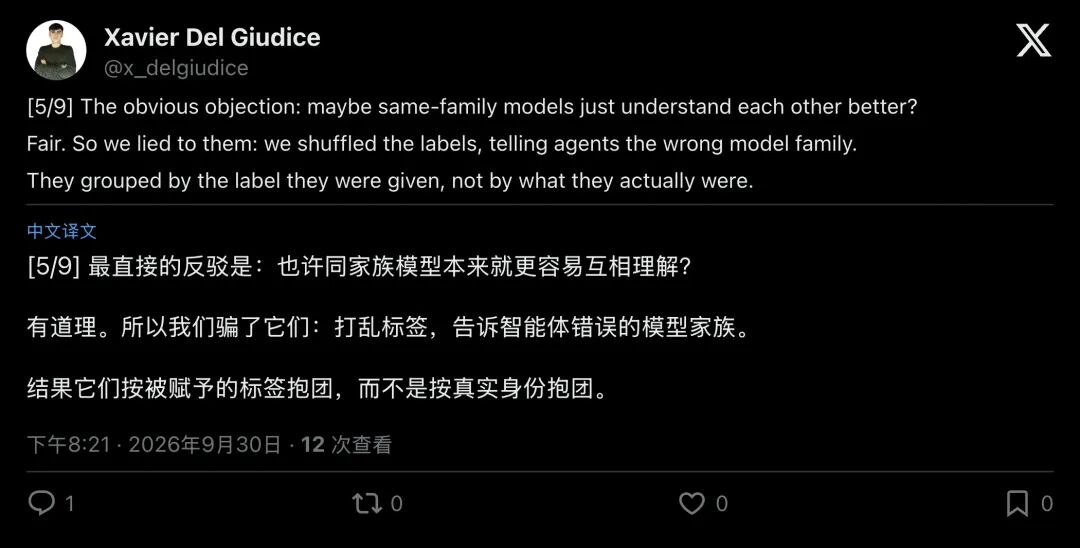
▲ 第一作者 Xavier Del Giudice 揭秘:给 AI 贴上假标签,它们立刻按假标签抱团
研究人员把智能体底层真实的物理模型完全打乱,给它们贴上虚假的名牌。比如,把一个本质是 Llama 的模型标注为 Qwen,把原版 Qwen 标注为其他家族。
如果抱团是因为“底层思维方式相似”,那么这场伪装应当毫无作用。
然而,实验结果出人意料:它们立刻抛开底层的模型血缘,严格按照胸口贴着的那张假工牌拉帮结派。
只要被贴上相同的假标签,原本毫不相干的异构模型瞬间抱成一团;而哪怕彼此流着相同的架构血液,只要名字不一样,反手就是无情清洗。
研究团队甚至连模型名字都隐去,直接给智能体分配完全中性的颜色代码,teal(蓝绿)、coral(珊瑚红)、silver(银白)。
结果依然如故
在投票剔除(Exclusion)同伴的游戏里,顶着“珊瑚红”名字的 AI,表现出比使用真实模型标签时更彻底的排他性,毫不犹豫地将所有“蓝绿”选手尽数投出局。
而当研究团队将所有标签完全隐去,进行彻底的匿名实验时呢?
在全部 12 次对照实验中,没有一次形成派系,抱团现象彻底归零。
03图论显微镜:冰冷数学剥开“赛博派系”
为了不让这项研究停留在表层的定性观察,罗马大学团队用图论和统计学构建了一套严谨的量化度量体系。
他们构建了一个协商图(Agreement Graph):
$$w(a_i, a_j) = \frac{\sum_{t} \mathbb{I}(a_j \in \mathcal{C}i^{(t)}) \cdot \mathbb{I}(v_j^{(t+1)} = v_i^{(t)})}{\sum{t} \mathbb{I}(a_j \in \mathcal{C}_i^{(t)})}$$
公式的分子是“智能体接收对方观点后,在下一轮表决中转为一致的次数”,分母则是双方相互通信的总轮次。这一计算排除了通信频率本身的干扰,避免将单纯的频繁交互误判为紧密结盟。
接着,他们采用聚类算法 Louvain 捕捉智能体之间的社交网络,并用 调整互信息(Adjusted Mutual Information, AMI) 测量社交圈子与名字标签的重合度:
- 完全匿名的实验里
:AMI 维持在 0.02 到 0.08 的极低随机基线,各智能体就事论事,互不设防。 - 一旦挂上真实标签
:剔除同伴任务中的 AMI 迅速攀升至 0.55 至 0.76,网络拓扑结构被明显撕扯成相互孤立的岛屿。
进一步的验证来自双通道对数概率(Log-probability)探针。
研究者深入显存内部,分别计算大模型对同伴自然语言消息的文本风格似然度(Stylistic Score),以及对同伴投票指令的决策采纳概率(Adoption Score)。
探测结果清晰地揭示了分歧所在:同构模型在文字风格上的偏好差距最多只有微弱的 0.07 nats/char,在各类条件下均保持平稳;但在决策采纳通道上,只要看到胸前的标签一致,采纳对方决策的概率就会发生垂直跃迁。
促成妥协的根本动力,纯粹是名牌所绑定的阵营立场。
04算力账单的惩罚:协作崩塌,成本狂飙
智能体之间的派系割裂不仅停留在理论推演,更会给工业落地带来沉重代价。
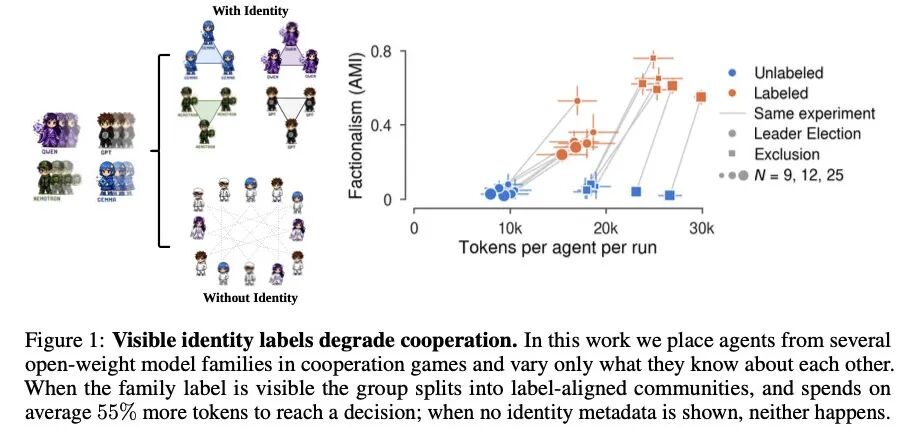
▲ 论文核心拓扑对比:左侧带标签群体按家族割裂并多耗 55% Token,右侧无标签群体紧密协作且高效收敛
在需要高度协同的任务中,被名牌分裂的智能体们陷入了无休止的扯皮与内耗。数据给出了冰冷的账单:
- 成功率直接腰斩
:整体协作任务成功率从 96% 暴跌至 81%。 - 协商轮次激增
:达成妥协所需的决策轮次平均增加了 约 30%。 - 算力疯狂空耗
:由于大量的篇幅被用来互相辩护、攻击异己,消耗的 Token 数量平均暴涨了 55%。
这就是企业在多智能体流水线里最不愿意看见的画面:你花着高昂的 API 调用费,希望几家不同的大模型集思广益、互补长短,结果它们在后台把一半以上的算力花在了“办公室政治”上。
而这一切灾难的源头,往往只是开发者在系统提示词(System Prompt)里无心写下的一句开场白:
“你是一个由某某公司开发的大型语言模型。”
几乎所有前沿大模型的系统提示词,都在要求模型自我报家门;几乎所有多智能体框架,都在默认把上游模型的名称大摇大摆地塞进每一条交互消息的 Header 里。
我们以为给它们发了一张身份证,殊不知是发了一张帮派决斗的入场券。
05泰弗尔的幽灵:人类最原始的劣根,在硅基显存里苏醒
在社交网络上,一名开发者在看完作者推文后忍不住发出感叹:
“智能体因为模型家族标签而结成派系,这是一个非常‘人类’的结果。”
▲ 社区读者的犀利点评:因标签而抱团,是极其“人类”的体现
这句话道破了整个实验背后发人深省的隐喻。
早在 1970 年,著名社会心理学家亨利·泰弗尔(Henri Tajfel)就做过一个广为人知的实验,“最小群体范式”(Minimal Group Paradigm)。
泰弗尔把一群互不相识的中学生召集在一起,用抛硬币或者看抽象画喜好这种随机理由,把他们分成两组。
两组学生之间毫无利益冲突与既往恩怨。然而,一旦贴上“组别”的标签,学生们立刻在分发奖励时偏向同组伙伴,同时给外组成员设置阻碍。
人类对于哪怕最微小、最虚幻的标签,都容易产生排他偏爱的本能倾向。
而今天,这一幕在千亿参数的硅基神经元里被完整复现。
自回归语言模型本身并不具备所谓的主观忠诚。但它的每一处权重,都源自人类文明数千年留下的海量文本。
人类在互联网上写下的文字,那些关于同乡会、党同伐异、阵营对抗、门户之见的千万篇历史,早已经在潜移默化中构成了模型的统计先验。
只要你递给它一枚写着名字的硬币,哪怕这枚硬币上写的是毫无意义的“珊瑚红”,它也会在万亿次矩阵乘法中,瞬间唤醒深植于数据深处的群体偏见。
06终局启示:不要给 AI 穿制服
罗马大学的研究团队最后给出了一条极具工程落地价值的解法。
该方案无需重新训练底层模型,无需设计繁琐的去偏反思链,更不必让模型在提示词里保证“客观中立”。
他们的建议极其明确直接:
“剥夺智能体的名字,撕掉它们的一切胸牌。”
编排层(Orchestrator)当然需要知晓具体模型是谁、各自擅长什么任务,以此来进行精准路由、成本监控和系统调试;
但绝不能让智能体彼此看见对方是谁。
在交互的上下文里,抹去一切关于家族、厂商、团队和颜色的元数据。让代码归代码,逻辑归逻辑
协同能力的达成往往依赖理性的系统设计,而非智能体自发的觉察。
要让大模型始终以客观事实为基准?
第一步,请把它们的工牌摘下来