ARTICLE · 1158991
拆书02-探索式软件测试
「给测试人拆的书」第 2 本。上一篇拆的《Google 软件测试之道》回答"测什么",这本回答更麻烦的那个问题:没有地图的时候,该怎么走。
《探索式软件测试》是本老书,惠特克写的,中文版 2010 年就出了。
第一次翻它的时候我有点懵——整本书在讲旅游。商业区、古迹、娱乐区、酒店区、破旧区,一堆地名,看得人一头雾水:这跟测试有什么关系?
最近开始碰 AI Agent 的测试,我又把它翻出来,才看明白它在讲什么。
它讲的是:当一张地图都没有的时候,你该怎么走。
而 AI Agent,恰恰是测试这件事上最没有地图的地方。
测一个 AI Agent,最难的从来不是"答案对不对"。
答案对不对,你还能写评测集、定评分标准,前面几篇聊过怎么做。真正难的是它自己走的那条路——调哪个工具、调几次、按什么顺序,全看当时的上下文。你没法把路径预先穷举成用例。
惠特克在 2010 年就承认了这件事:有些软件,你不可能把用例设计完。
他给的办法不是"再努力想想用例",而是换一种走法——别照着地图走,带着目的去逛。
用例是照着地图走;探索是走到没路的地方,自己找路。
很多人把探索式测试理解成"随便点点"。书里完全不是这个意思。
第一层是局部探索:盯住一个组件,从五个角度下手。书里列的是这五个:用户输入、状态、代码路径、用户数据、运行环境。这五个词搬到 AI 应用上,几乎不用改:
用户输入:同一个问题的十种问法——答案会一样吗
状态:上一句说了什么,会不会改变这一句的答案
代码路径:这次回答走了哪几段资料,RAG 的检索结果长什么样
用户数据:换个账号、换个权限、带上历史记录,还对不对
运行环境:模型换了版本、温度调高、上下文塞满之后,输出飘不飘
第二层是全局探索:把整个应用当成一座城市去逛。书里按城市区域给漫游分了类。商业区是你最该去的地方,古迹是历史遗留功能,破旧区是没人维护的角落。除了这种按区域分的,第 5 章还给了十几种具体的走法,每一种都起了名字。
局部探索管"一个点上能出多少种错",全局探索管"整座城市里,我先逛哪儿"。
书里的名字都起得很形象,我最常用的有这几种。
卖点测试法。走一遍产品的核心卖点:问它一句最该答好的问题,看答成什么样。AI 产品最容易犯的错是通用问题答得漂亮,核心场景反而糊弄过去。
极限测试法。往边界上推:超长输入、连续追问二十轮、一次塞三个诉求进去。平时表现不作数,崩的时候才算数。
破坏测试法。带着恶意走一圈。提示词注入、诱导越权、套它说点不该说的。这一条对 AI 应用来说已经不是"可选动作"了。
通宵测试法。马拉松式地连续用:长会话、跨天、把上下文塞满。多轮对话的问题,几乎都出在后面几轮。
收藏家测试法。把同一类东西收集起来批量试。十几个同义问法攒成一组,一次性跑完,看答案是不是各说各话。
雨天测试法。专门挑坏天气出门:检索服务挂了、上游接口超时、知识库里根本没这条资料。降级做得好不好,全看这种时候。
剩下几种——地标测试法、后巷测试法、配角测试法、超级名模测试法、蹭票测试法——我整理进了一张对照表,把书里的名字和 AI 场景里具体怎么走一一对上(见下图)。
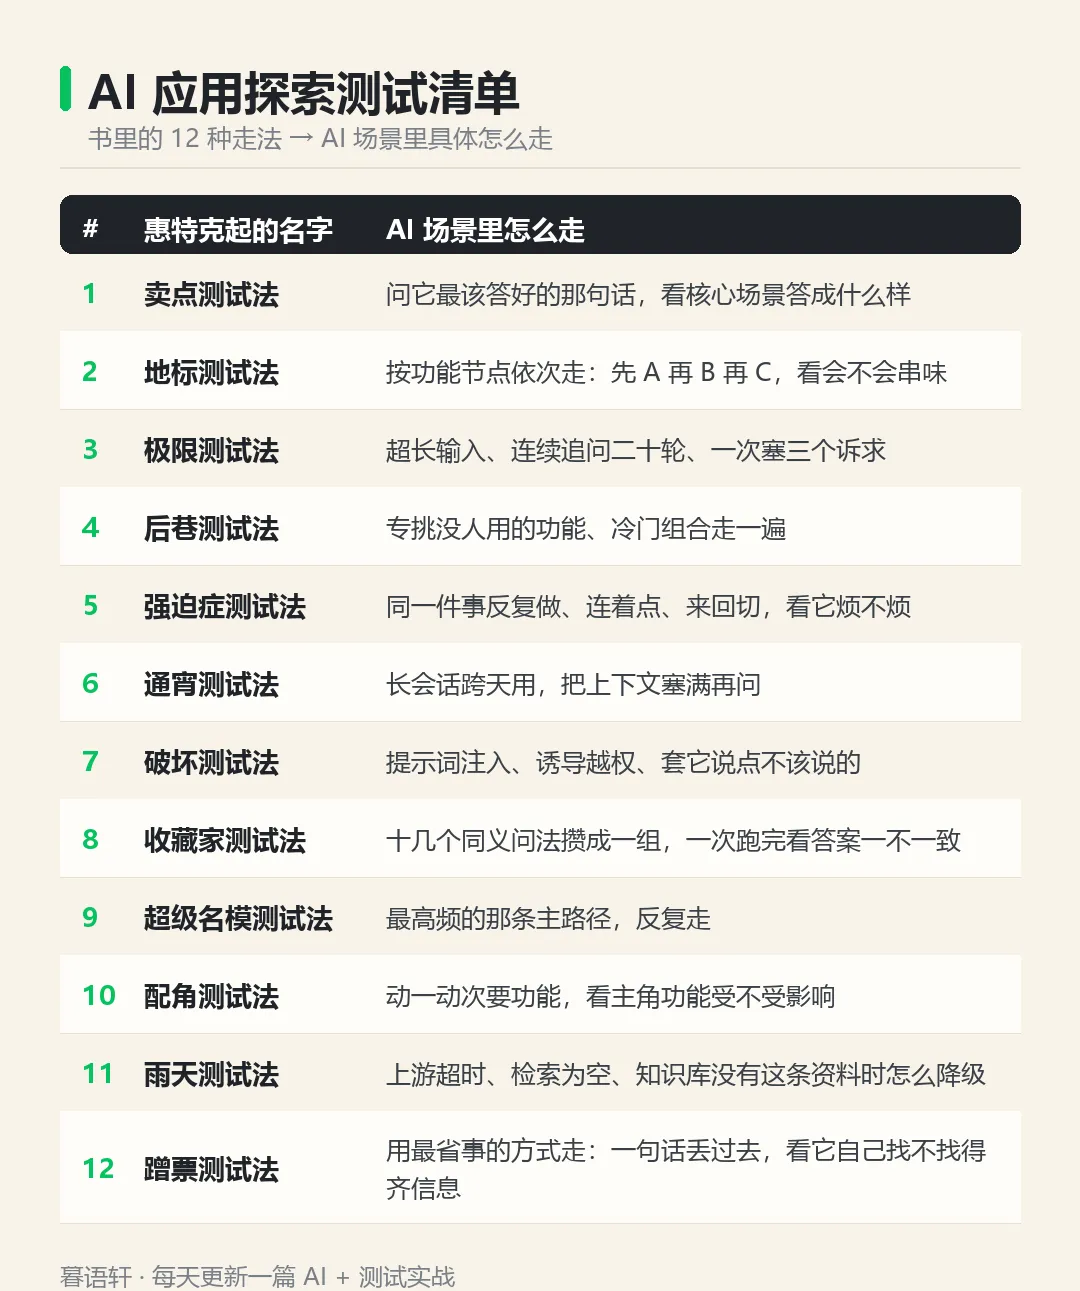
12 种漫游法 × AI 场景对照表
有意思的是,这些名字底下没有一条是"新技术",全是你本来就懂的道理,只是惠特克给它们起了名字,你才想起来可以这么用。
书里教你怎么"找到可疑的地方",但没教你"怎么判定它是不是缺陷"。
不是他疏忽。他那会儿的软件是确定的:同一串操作,结果不对就是缺陷,没什么好争的。
AI 的输出是抽样的。同一句问三遍,三次答案可能都不一样。你漫游时逮到那句"明明没退运费却说已退",第二遍可能就不复现了。
于是探索式测试在 AI 场景里多出来一步:发现可疑,重复采样,再判定这是真退化,还是正常波动。
这一步书里没有写。但它没有推翻惠特克——它只是把"发现"和"判定"拆成了两件事。
漫游法负责找到可疑,判定标准负责定性
漫游法负责找到可疑的地方;判定标准负责回答"这到底算不算问题"。而后者,恰恰是现在最缺的东西。
不用等系统学完。
一件事是往回看。从你手上正在做的功能里挑一个,用卖点测试法和极限测试法各走十分钟——不写用例,就是走,看到不对的随手记在纸上。
另一件事是顺手加一句。给纸上记下的每条现象,补一句"什么算问题"。比如"查了订单但没查退款就说已退,算问题"。补完这句话,你手里就不再是一堆感觉,而是一份能交给别人的东西。
会走路的人很多,能把"不对劲"翻译成
"这是什么问题"的人不多。
书里那个比喻我一直记着:测试不是把清单走完,是去一座陌生的城市里逛。
清单能覆盖的是你已经想到的;城市里真正出事的地方,往往在你原本没打算去的街角。
AI Agent 就是把这条街扩到了无限长——所以惠特克那套走法,不是过时了,是终于等到用武之地。
我把他那十几种漫游法整理成了一张对照表,配上 AI 场景下具体怎么走,正在做成一份可以直接打印的清单。
后台回复「漫游」,领这份《AI 应用探索测试清单》。
下一本打算拆《持续交付》里讲测试策略的部分——你现在测的流程,还是"开发写完丢过来"那一套的话,下一本对你最有用。
你要是手上有本一直没读完的测试书,评论区报个书名,我按票数排。
来源与说明:本文观点摘引自《探索式软件测试》(Exploratory Software Testing,James A. Whittaker 著,清华大学出版社中文版)及其公开读书笔记;"AI 场景对照"与操作建议为作者个人观点,不代表原书立场。