ARTICLE · 1161485
本来只想试试 AI 能不能剪视频 · 结果我被 AI 教育了
本来只想试试 AI 能不能剪视频 · 结果我被 AI 教育了
一句话主题,四十多分钟出一条带配音和字幕的粗剪。
两周 · 66 次提交 · 4 个拍板点
9 月底,我只是想试试AI剪视频这件事能不能搞。
我做 AI 实战类的抖音号,一条一两分钟。写稿之外,拖慢进度的是后面那一串。配音要录,录完要对字幕,字幕要和画面卡在一起。画面要找、要做、要裁成竖屏,再加音效、调响度、导出,最后还得从头看一遍有没有错字和遮挡。改一句口播,后面的字幕和镜头时长全跟着动。
我用 Claude Code 加 Opus 5.5 开始搭,两周提交了 66 次。现在有录屏素材的选题,从选题到可以上传的竖屏成片一路都接上了,我只在中间四个点拍板。手里一张素材都没有、只给一句话主题的选题,它也能做出带配音和字幕的手绘讲解粗剪。
这两周被它震住的地方不少,挑几处讲。
01
PART
一句话主题,四十多分钟出粗剪
SPEED
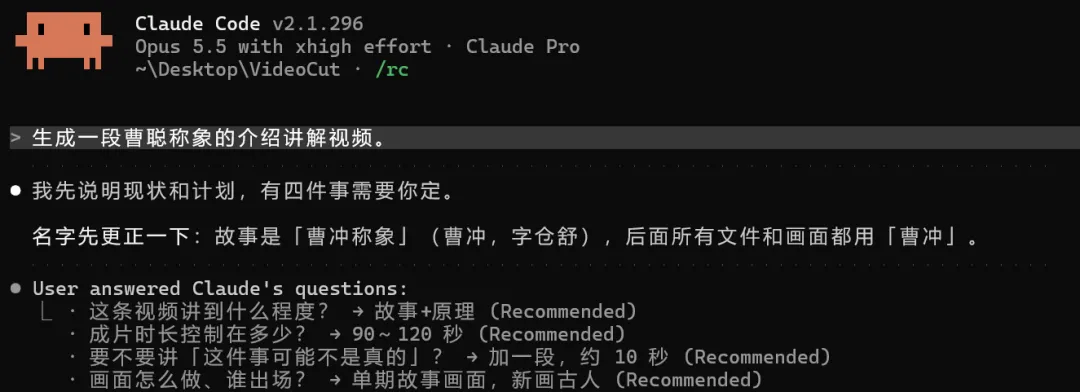
10 月 10 日下午四点半,我在终端里敲了一句「生成一段曹聪称象的介绍讲解视频」,名字还打错了。它先把名字更正成曹冲,再列出计划和费用,停下来问了我四件事。讲到什么程度,成片多长,要不要讲这件事可能不是真的,画面里谁出场。
四个问题我都选了它推荐的选项。四十多分钟后,第一版粗剪出来了,101 秒,13 个镜头,配音和字幕都在。这中间我拍板只有两处,一处是这四个问题,一处是确认配音稿、批两块钱的配音预算。按账本预估,配音加两道大模型审核,一共约 0.32 元。
02
PART
写稿之前,它先把史料对了一遍
FACT CHECK
它先去翻《三国志》原文。原文写的是「称物以载之」,往船上装的是「物」,课本里搬石头的那一步,原文里没有。
接着它查到清代学者何焯在《义门读书记》里算过时间。孙权到建安十五年才管到交州,才有条件送大象来,曹冲在建安十三年就去世了,何焯的结论是「知此事之妄饰也」。陈寅恪认为用船称象原本是佛经里的故事,它又找到《杂宝藏经·弃老国缘》的原文,佛经里装上船的正好是石头。
没读到的东西它也不硬说。陈寅恪那篇论文它没读到原文,手里只有几处一致的转述,口播就只写「陈寅恪认为」。原文也没写曹冲称象时几岁,只说他五六岁就有大人的见识,紧接着记了称象这件事,口播就照这个分寸说「史书说,曹冲五六岁,见识就像大人一样」。

连读音它也提前想到了。何焯的「焯」读 zhuó,配音模型容易读错,它在朗读文本里写成同音的「何卓」,字幕再换回「何焯」。
AI 写历史和产品,最容易张冠李戴。我这套流程里,查证排在写稿前面,口播里每句关键的话都要对回一条来源,对不上的进不了配音,也进不了标题。
03
PART
没有一张素材,画面全靠代码画
VISUALS
曹冲这期从头到尾没用一张现成素材。大象、船、货物、秤、竹简和几个古人,全是代码画出来的,蜡笔手绘的质感,字体用霞鹜文楷。
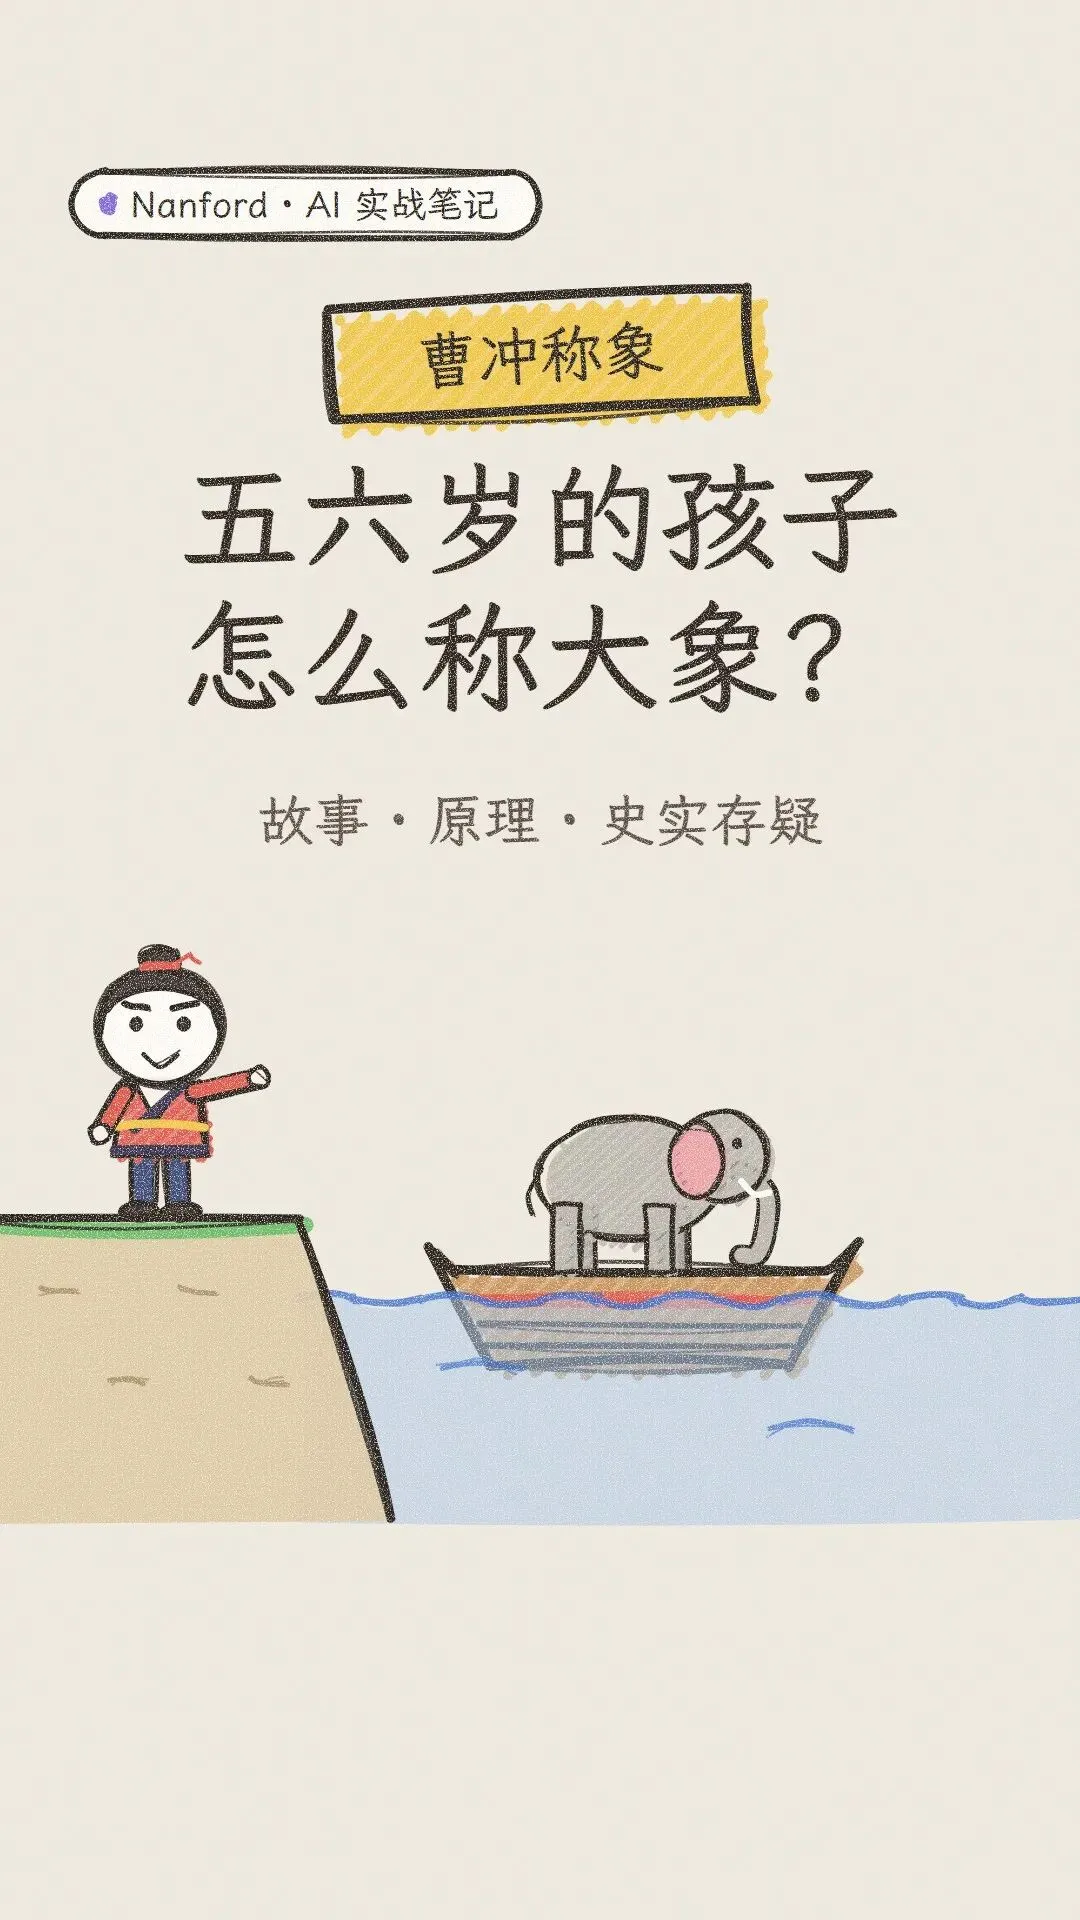
开场它给了三版。一版从年龄和限制条件切入,「五六岁的孩子,怎么称出大象有多重?没有那么大的秤,他只用了一条船。」一版从「原文没说石头」切入,一版从「清代就有人说是编的」切入。最后用的是第一版,第 0 帧就是巨象和小孩的体型对比。
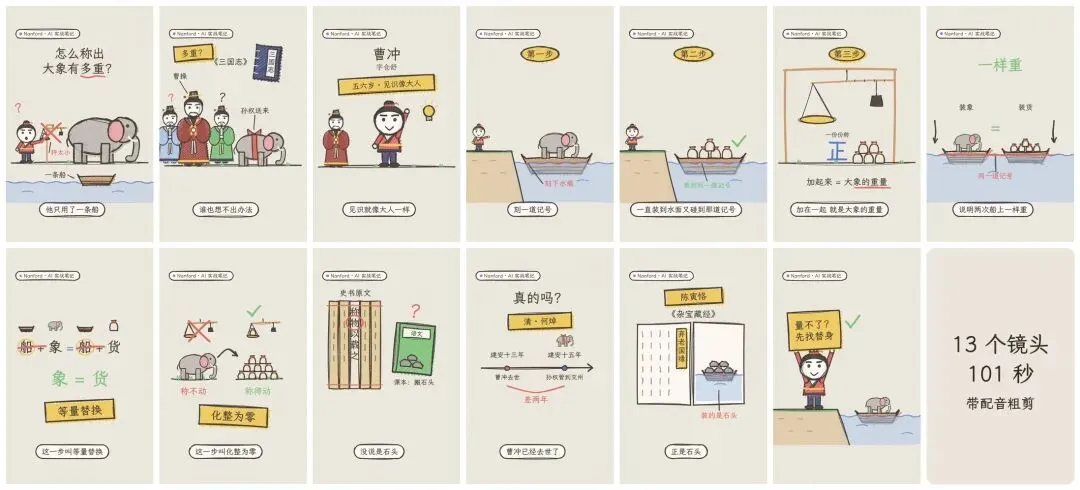
13 个镜头,每个镜头都写清楚了画面在口播之外多给什么。讲到刻记号,红笔沿着水面把刻线描出来。讲何焯算时间,口播只说曹冲已经去世,画面上的时间线标出建安十三年和建安十五年,中间画一道弧,写「差两年」。到了讲原理的地方,等式两边的船被一笔划掉,只剩下象等于货。
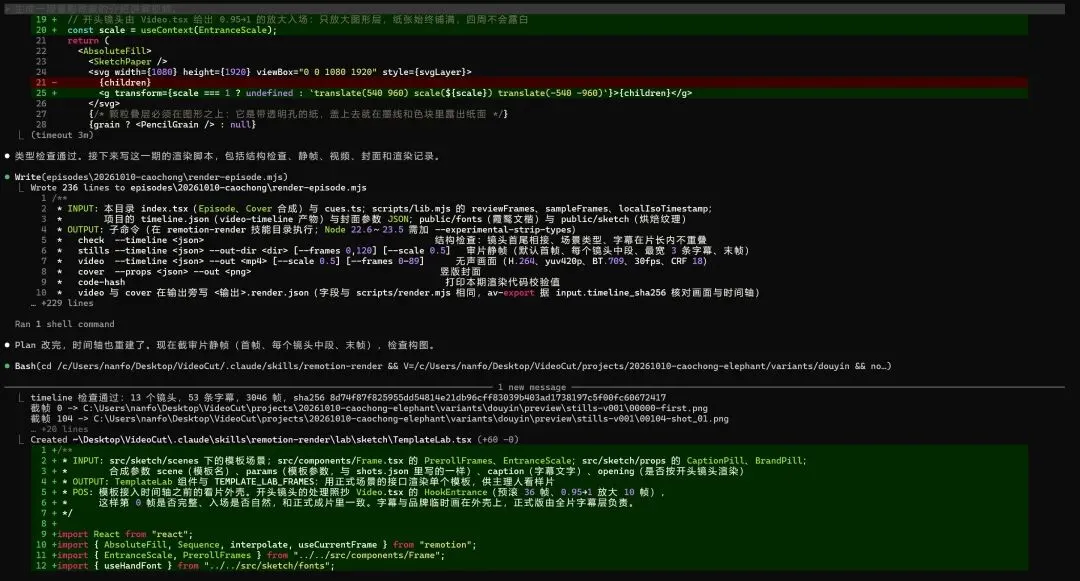
这一期的渲染脚本有 236 行,半分辨率粗剪渲染一次约 80 秒。出片分三步,先出静帧看构图和遮挡,再出半分辨率粗剪,最后才出高清。
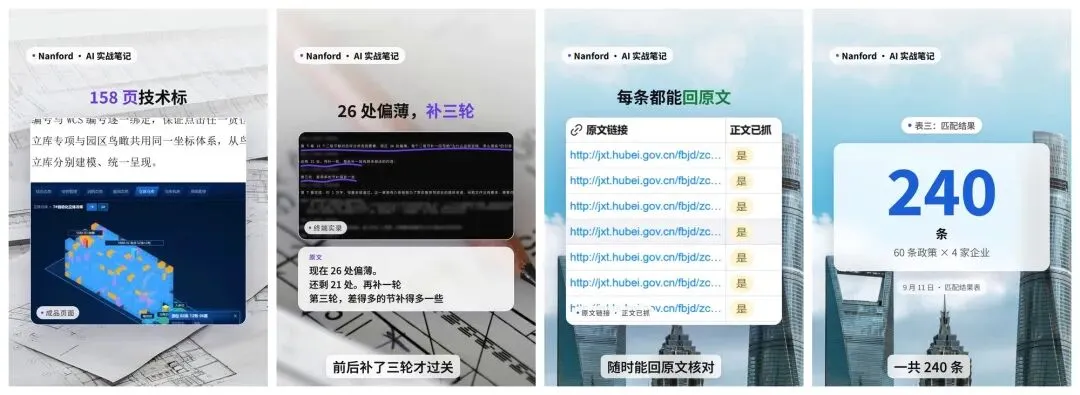
有素材的选题,用的是另一套玻璃卡片风格。下面左边两张出自标书技能那条,讲 AI 写技术标,画面用的是真实的终端记录和 158 页成品的页面截图。右边两张出自政策助手那条,讲用三张表初筛政策,60 条政策对 4 家企业,一共 240 条匹配记录,企业信息在工作副本上都打了码。两条都在两分半到三分钟之间。
04
PART
改一处只动一处,说一次就记住
PRECISION
剪辑最磨人的是对时间。它的顺序是定死的,先定稿,再配音,拿到配音里每个字的真实发音时间,再断字幕、算每个镜头多长。所有帧数在一份时间轴里一次算定,字幕和画面不会越拼越错位。改一句口播,就只重配这一段,从这句往后重算,前面的镜头原样复用,配过的话不重复花钱。
画面也是这样改的。两天后我看样片,提了一条意见,原话是「曹冲称象的内容,应该是小男孩,而且相关人物,要是对应的中国古代的人物形象。」第一版的曹冲两侧梳双髻、有刘海和腮红,看着像个小女孩,曹操和手下戴的黑帽子像西式礼帽。
它只改了这一期画人物的代码。曹冲改成头顶一个单髻、露额头、浓眉,短袍下面露出裤腿。曹操和手下改戴汉末的进贤冠,穿交领宽袖长袍,留胡须,官员手里拿笏板。大象、船、文字和配音都没动,改完重出一版粗剪,我看过对比图就定了。
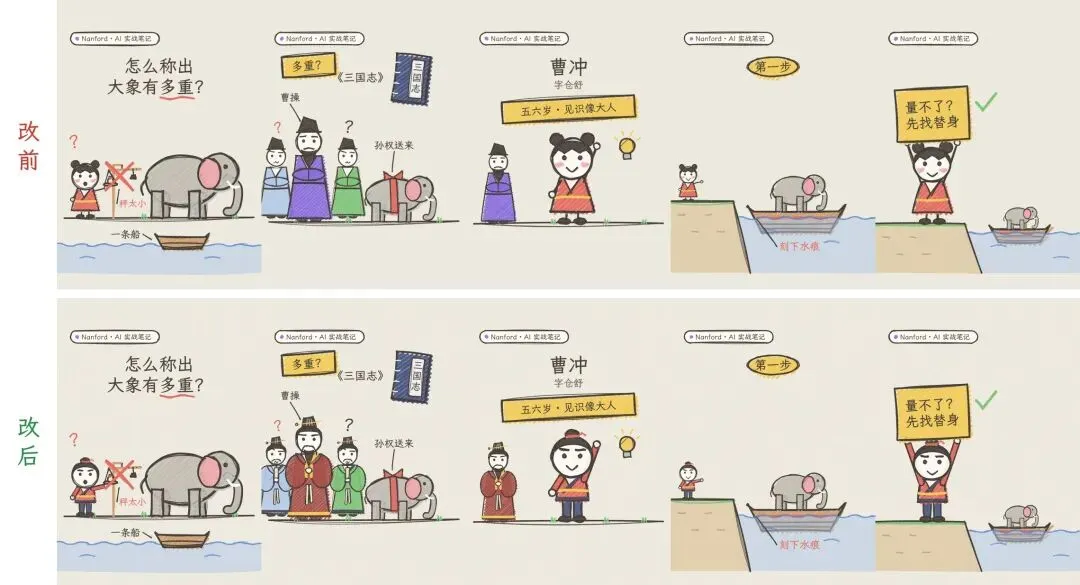
改完它把这条意见存进了长期记忆。以后手绘风格讲历史题材,人物按朝代来画,男孩女孩从发型和裤腿这些轮廓上分,不靠颜色,下一期不用我再说一遍。
05
PART
发出去之前,先替平台审一遍
COMPLIANCE
起因是 9 月 30 日,账号的第一条抖音被判「不适宜公开」,后台只给状态,不写原因。排查下来,最可疑的是首帧截图里几个境外应用的名字。
从那以后,每条视频在配音之前都要过四道检查,有本地规则,也有大模型按平台规则审一遍,截图里的小字也要先认出来再查。报错的必须改稿,高风险的不放行。发布文案定稿以后,上传之前还要再查一遍。
曹冲这期,四道检查一共提了三条。一条提醒发布时要声明 AI 配音,两条说开头没有点名某一类人,也没讲一个具体痛点。讲历史故事的视频本来就不冲着某一类职场人去,这两条我没改。
06
PART
剪辑的活现在怎么分
DIVISION OF LABOR
留在我手里的是四个拍板点。选题我定,配音稿我读一遍再定稿,新音色第一次用我先试听,成片出来我完整看一遍。真实操作的录屏要我自己录,上传发布也是我手动,每条都要勾选平台的 AI 生成内容声明。
花的每一笔钱都记在账上。曹冲这期约 0.32 元,标书技能那个项目前后改了四版,中途还给视频号配过音,合计约 1.38 元。这些数字是账本预估,不含 Claude 本身的订阅费,账单也还没逐笔对过。项目清单还管断点续跑,电脑重启或者会话断了,它读一遍清单就知道做到哪一步,上游没变的产物直接复用。
07
PART
我手里这条流水线
PIPELINE
从一句话主题到能上传的竖屏成片,一共 11 个阶段,全貌就是下面这张图。每个阶段背后都有自己的规则和本地命令,大多带着不联网、不花钱的测试。规则和命令都放在一个工作区里,换电脑的初始化步骤也写好了,Claude Code 和 Codex 读的是同一份规则。
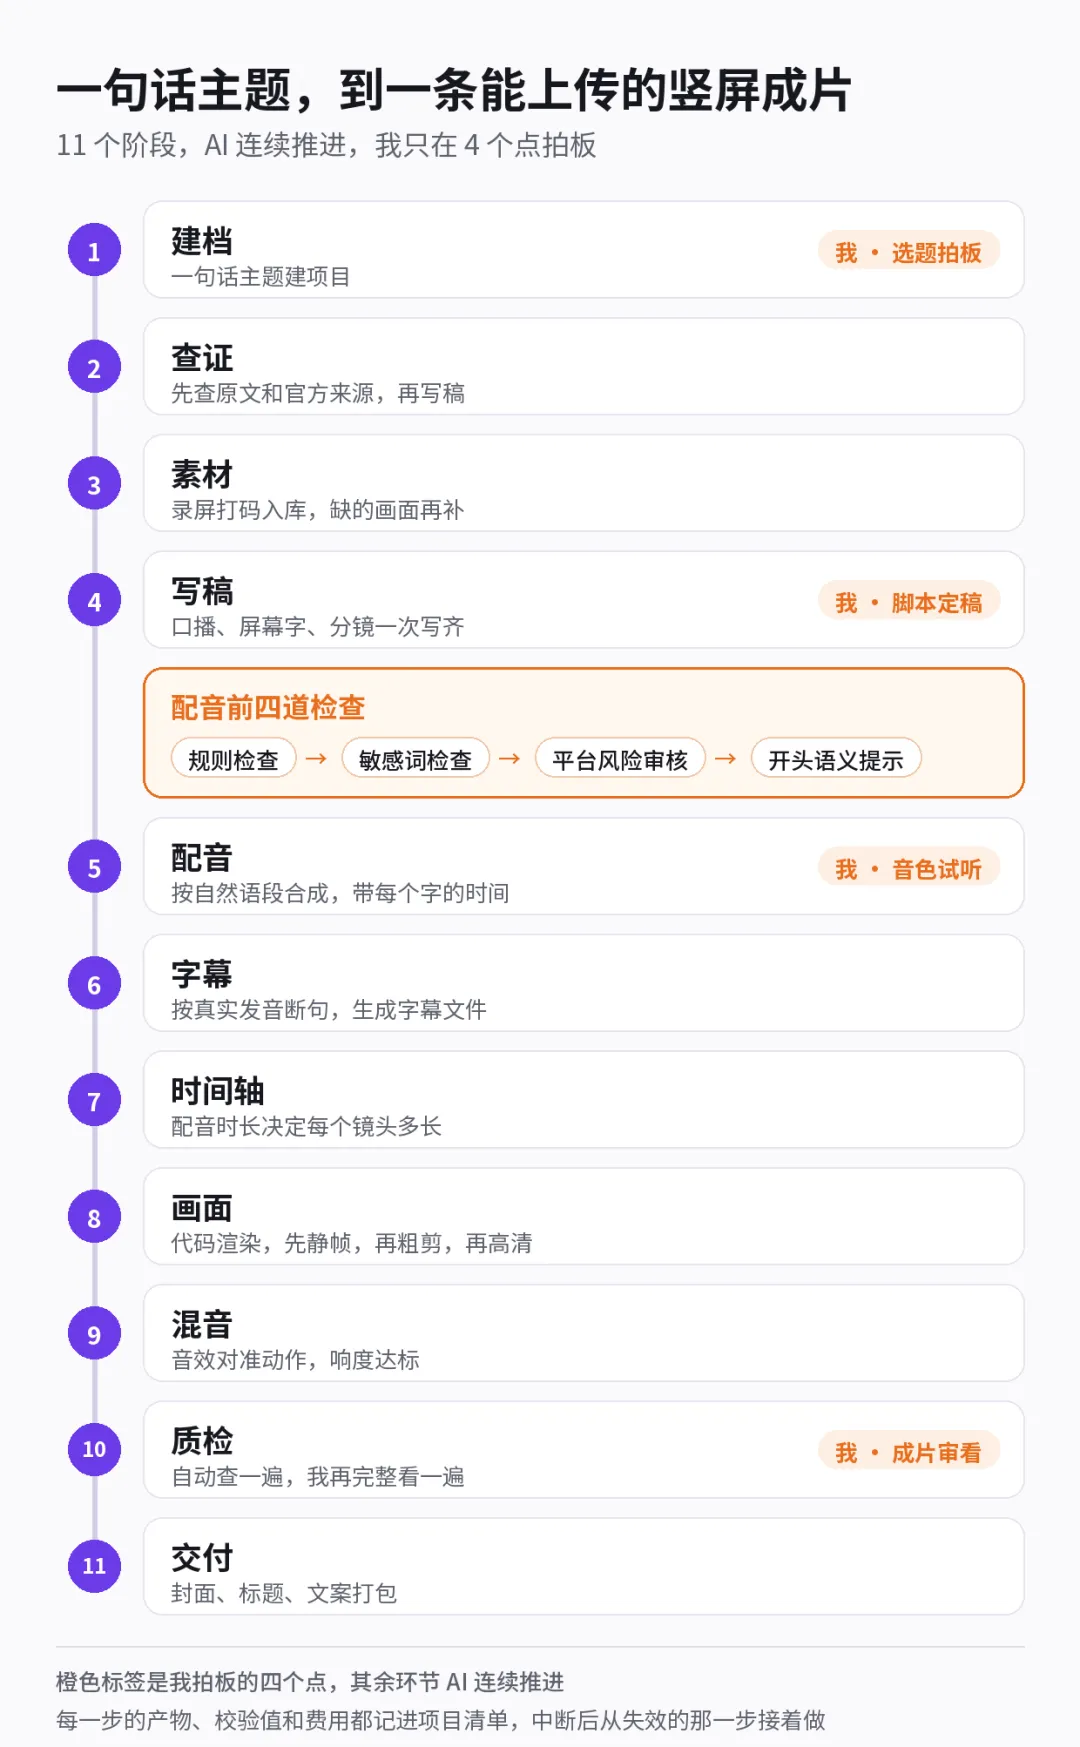
两周 66 次提交,新功能 34 次,其余多半是修正和补规则。不少规则是返工换来的。抖音那条出事以后,有了配音前的四道检查。标书技能那条的第一版,开头把 70 秒的成品翻阅压成 7 秒,我看不清,规则里从此写上证据镜头要停住,让人看得清。
///
END
它适合做什么
SCOPE
它适合格式固定、靠讲解和证据说话的信息流视频,产品实操、工作方法、历史和科普故事都在这个范围里。需要真人出镜、实拍、复杂调色的视频,它做不了。玻璃卡片风格的说服力来自真实录屏,录屏还是要人去录。手绘风格省掉了找素材,史实和原理照样要一条条查。
手绘风格还在往主流程里接。曹冲这期现在停在带配音的粗剪,高清渲染、混音和成片质检还在后面。
这篇只挑了几处讲。两周攒下来的规则,光总规则就有七千多字,加上几份细则两万多字,比这篇文章长得多。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见
THANKS FOR READING