ARTICLE · 1164904
7款主流OCR实测:PDF转Markdown、纯认字,到底该怎么选
7款主流OCR实测:PDF转Markdown、纯认字,到底该怎么选最近要把一批扫描版 PDF 转成可检索的文本,里面还有几张表格需要还原,就把常用的几个 OCR 都拉出来跑了一遍。 选型前看了不少评测,大多只报一个识别率。真用起来,一页要等多久、内存够不够、表格能不能还原,往往比小数点后那点准确率更影响体验——我这台测试机没有显卡,内存也只有 8GB。 下面把测试过程和结果记下来,环境、样本、数据都写明,有类似需求的可以直接对照。 赶时间的看到这一节就行。 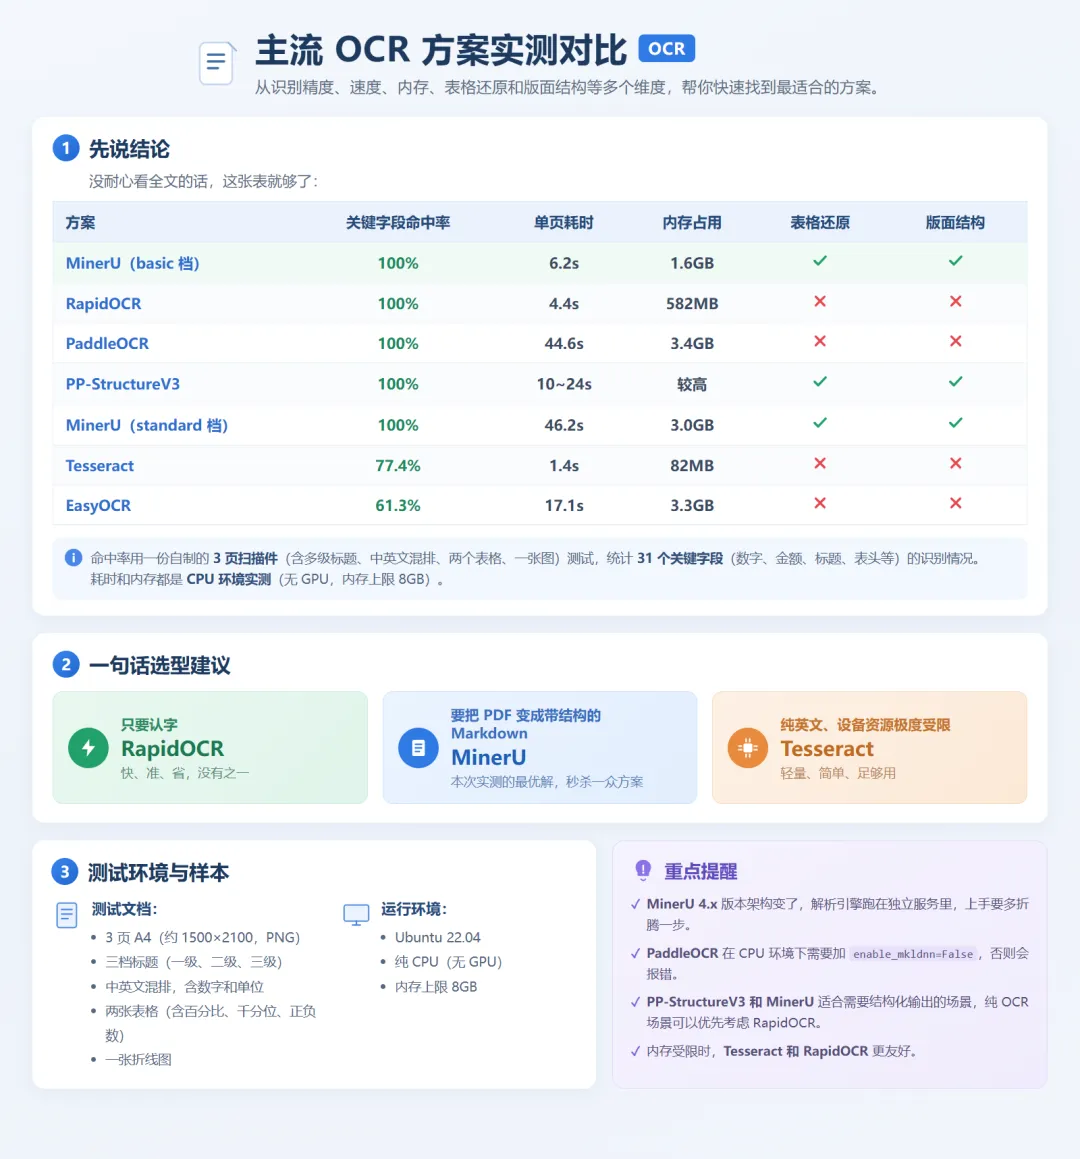
具体结果: 中文印刷体场景下,MinerU、RapidOCR、PaddleOCR、PP-StructureV3 这四个,31 个关键字段全部识别正确; 只需要把文字抠出来,用 RapidOCR 就好,一页 4.4 秒,内存 582MB; 需要还原表格和版面结构的,只有 MinerU 和 PP-StructureV3 能做; Tesseract 和 EasyOCR 的中文结果不太能用,命中率分别是 77.4% 和 61.3%。 为了让几个方案在同一把尺子下比较,我自己做了一份测试文档,尽量覆盖常见情况: 3 页 A4,从 PDF 渲染成 PNG(约 1500×2100); 三档标题(一级、二级、三级); 中英文混排,中间夹着数字和单位; 两张表格,含百分比、千分位和正负数; 系统是 Ubuntu 22.04,纯 CPU、没有 GPU,内存上限 8GB。这个限制后面会反复提到,PaddleOCR 和 MinerU 踩的坑基本都跟它有关。 口径说明:命中率看的是 31 个关键字段(数字、金额、标题、表头等)认对了多少;耗时和内存都在上面这台 CPU 机器上实测。 上海人工智能实验室 OpenDataLab 做的,开源后在 GitHub 上有五万多 star,目标很明确:把 PDF(尤其扫描件)解析成 Markdown。文字识别这层它用的还是 PaddleOCR 的模型,自己主要做版面分析、阅读顺序恢复、表格还原这些上层的事。 我这份样本 31 个字段全对,输出直接是 Markdown:标题分了层级,表格转成了 Markdown 表格,插图也裁下来嵌好了。用 basic 档,一页 6.2 秒,峰值内存 1.6GB。 几个能出结构的工具里它最快,PP-StructureV3 一页要十几秒。 优点: 文字、表格、图一次整理好,拿到手基本就能进 RAG,不用再自己拼; basic 档在 CPU 上速度能接受; 表格给的是 Markdown,比 HTML 好处理; PDF 和图片都能读,会自己判断该直接抽文本还是走 OCR; 有网页版、接口和 Docker,部署方式比较全。 缺点: 4.x 把解析引擎拆成了独立服务,第一次跑得先把服务起起来,比以前麻烦; 模型要单独下载,basic 约 0.8GB,standard 接近 2GB; standard 档会把数字、百分号转成 LaTeX 公式格式,进知识库前还得洗一遍; 内存占用比单纯认字的方案高。 basic 和 standard 的区别:basic 是 ONNX 小模型,standard 会再加载一个 1.2B 的视觉模型。我这份文档两者结果一样,standard 却慢了七倍多。除非是论文、多栏杂志这种复杂版面,否则 basic 够用。 做法比较直接:把 PaddleOCR 的模型转成 ONNX,用 ONNX Runtime 跑,胜在轻,不用装 PaddlePaddle 那一整套。 31 个字段全对,一页 4.4 秒,内存 582MB。准确率和 PaddleOCR 看不出差别,速度快了将近十倍。 优点: 依赖少,装好就能用; CPU 上速度快,内存占用低; 除了 ONNX Runtime,也能换 OpenVINO、PaddlePaddle 后端; Python、C++、Java、C 的SDK 都有。 缺点: 只认字,没有版面分析,也不还原表格,输出是一行行文字; 语言主要覆盖中英文,其他语种得自己转模型。 百度飞桨的 OCR 工具箱,开源里用的人最多,Umi-OCR、MinerU、RAGFlow 这些项目底下都有它。测试时是 3.7 版,默认模型 PP-OCRv6。 31 个字段全对,问题在资源:一页 44.6 秒,内存 3.4GB。 优点: 准确率高,中英混排、标点、数字基本挑不出错; 检测、方向分类、识别、版面、表格这些模块都齐; 支持拿自己的数据训练、微调; 能用 GPU,也支持昆仑芯、昇腾这类国产卡。 缺点: 依赖重、模型大,CPU 上跑得慢; 3.x 的接口跟 2.x 不兼容,搜到的老教程很多对不上; 内存紧张的机器容易出问题。 PaddleOCR 里负责文档结构的流水线。普通 OCR 给你的是散落的文字,它会标出哪里是标题、哪里是表格、哪里是图。 效果可以:标题层级识别出来了,两个表格转成 HTML、行列都对,插图也裁好存好并在文档里引上了。代价是慢,一页 10 到 24 秒。 优点: 能把版面结构恢复出来; 表格转 HTML,合并单元格也处理得了; 插图自动裁剪; 能直接导出 Markdown; 还带公式、印章识别和图表转表格。 缺点: 慢,一页十几秒,MinerU basic 只要 6 秒上下; 内存吃得凶,server 模型在 8GB 机器上直接内存溢出,换成 mobile 模型才跑通; 表格给的是 HTML,处理起来比 Markdown 麻烦。 Google 维护的老引擎,年头很长,不少系统自带。 速度和内存确实好看:一页 1.4 秒,内存 82MB。但中文结果基本不能看,31 个字段只对了 77.4%,错的基本是中文标题和表头。 错法也比较固定:字之间被插了空格(“总 体 概 述”);标题丢字(“2025年度技术运营分析报告”变成“支 术 运 营 分 析 报”);符号认错,¥变成“土”、%变成“6”。 优点: 快、小,嵌入式设备也带得动; 语言包有一百多种,纯英文很稳,我拿英文图测是全对的; 规整印刷体、老文档效果不错,也能自己训练。 缺点: 中文不行,标点和数字也常错; 乱加空格,后处理要花时间; 没有版面分析,排版一复杂就没辙。 基于 PyTorch,主打多语言,说支持八十多种。 31 个字段只对了 61.3%。标点错得最多,逗号变句号、%变 9、引号对错;返回的置信度大多在 0.23 到 0.7 之间,模型自己都不太确定。 优点: 语言覆盖广,东南亚语种比较强; 接口简单。 缺点: 中文准确率跟前面几个差一截; 第一次运行要从 GitHub 拉模型,经常超时; 依赖 PyTorch,装下来 3GB 往上。 准确率(关键字段命中率) MinerU(basic / standard):100%; RapidOCR:100%; PaddleOCR:100%; PP-StructureV3:100%; Tesseract:77.4%,中文标题、表头丢字; EasyOCR:61.3%,标点、百分号误判。 我这份样本是规整印刷体,前四个才拿了满分;换成手写体、模糊扫描、多栏排版,差距会更明显。Tesseract 和 EasyOCR 连这种简单样本都没到合格线,参考价值有限。 速度与资源(单页 1500×2100,纯 CPU) Tesseract:1.4s,82MB; RapidOCR:4.4s,582MB; MinerU(basic):6.2s,1.6GB; EasyOCR:17.1s,3.3GB; PaddleOCR:44.6s,3.4GB; MinerU(standard):46.2s,3.0GB; PP-StructureV3:10~24s / 页,内存占用较高(server 模型会溢出)。 能力矩阵 纯文字识别:六款都支持; 表格还原:PP-StructureV3(HTML)、MinerU(Markdown); 版面结构、Markdown 输出、图片提取、公式识别:只有 PP-StructureV3 和 MinerU; 手写体:PaddleOCR、PP-StructureV3、MinerU 相对好一些,Tesseract 较差; 多语言:PaddleOCR、PP-StructureV3、Tesseract 覆盖较广,EasyOCR 偏东南亚语种; 离线部署、数据不出本地:六款都可以。 按自己的需求对一下: 只抠文字、不管结构:RapidOCR,速度快、内存小、部署省事,是这次最省心的一个; PDF 要转Markdown、进知识库:MinerU,basic 档一页 6 秒,出来的东西带标题、表格和图,能直接用; 已经在 PaddleOCR 这套生态里:用 PP-StructureV3,结构能出,就是慢;嫌重可以试 MinerU; 纯英文、机器配置很低:Tesseract,英文够用,中文别用; 需要东南亚等小语种:EasyOCR,但要自己做不少后处理。 我自己的用法是:批量只提文字走 RapidOCR,要进知识库的文档交给 MinerU,遇到 MinerU 处理不好的特殊版面再用 PP-StructureV3。 
#OCR#OCR选型#OCR识别#Mineru#RapidOCR#PaddleOCR
一、先说结论
二、测试环境与样本
三、逐个体检
1. MinerU
2. RapidOCR
3. PaddleOCR
4. PP-StructureV3
5.Tesseract
6. EasyOCR
四、横向对比
五、怎么选
上面的数据都来自我自己的环境,仅供参考。