ARTICLE · 1165129
给 AI 内容上户口:全球水印法规、技术与巨头表态全景
系列第 6 篇 · 全文约 9 千字 15 图,建议先收藏再慢慢看。
打开微信公众号的发布后台,往下翻,有一个不起眼的勾选框:内容由 AI 生成。
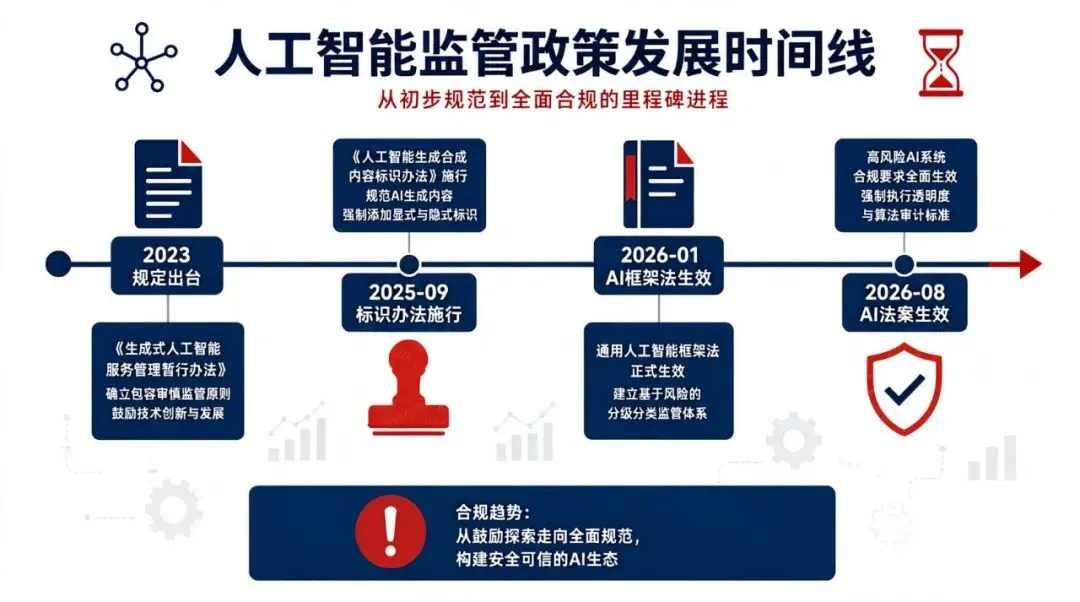
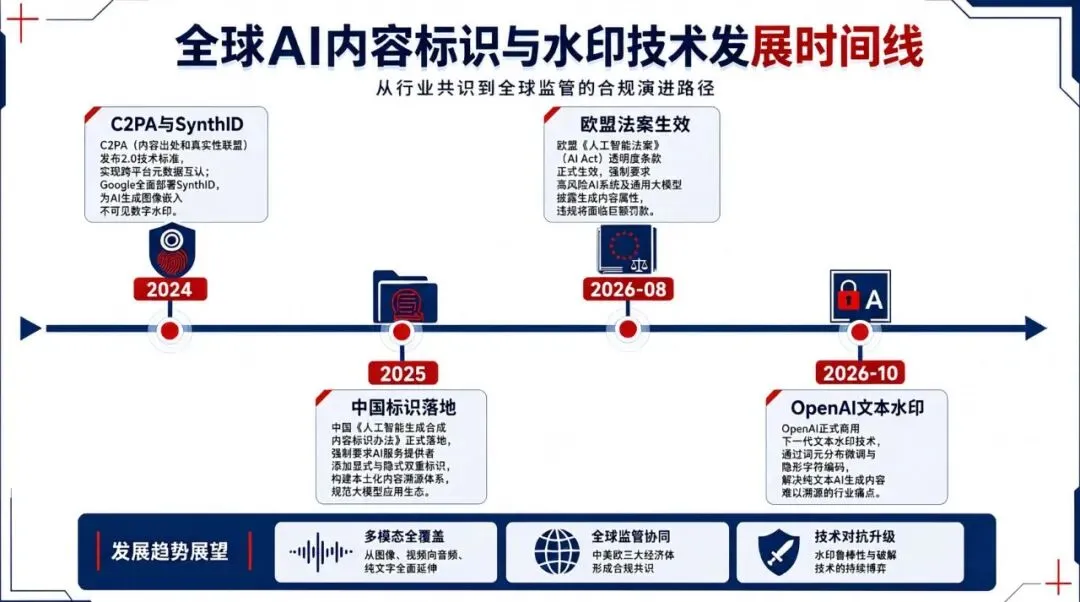
这个框不是平台的自选动作。2025 年 9 月 1 日,网信办等四部门的《人工智能生成合成内容标识办法》施行,发布 AI 生成内容要主动声明、平台要打标识,这是写进部门规章的要求。十一个月后,欧盟 AI 法案第 50 条生效,AI 生成内容必须带机器可读标记,加州一部类似的法律挑了同一天生效。又过了两个月,OpenAI 官宣 ChatGPT 在欧盟的文本输出默认嵌隐形水印。这项技术他们三年前就做出来了,一直压着没发。
一、法规:各国都要求什么
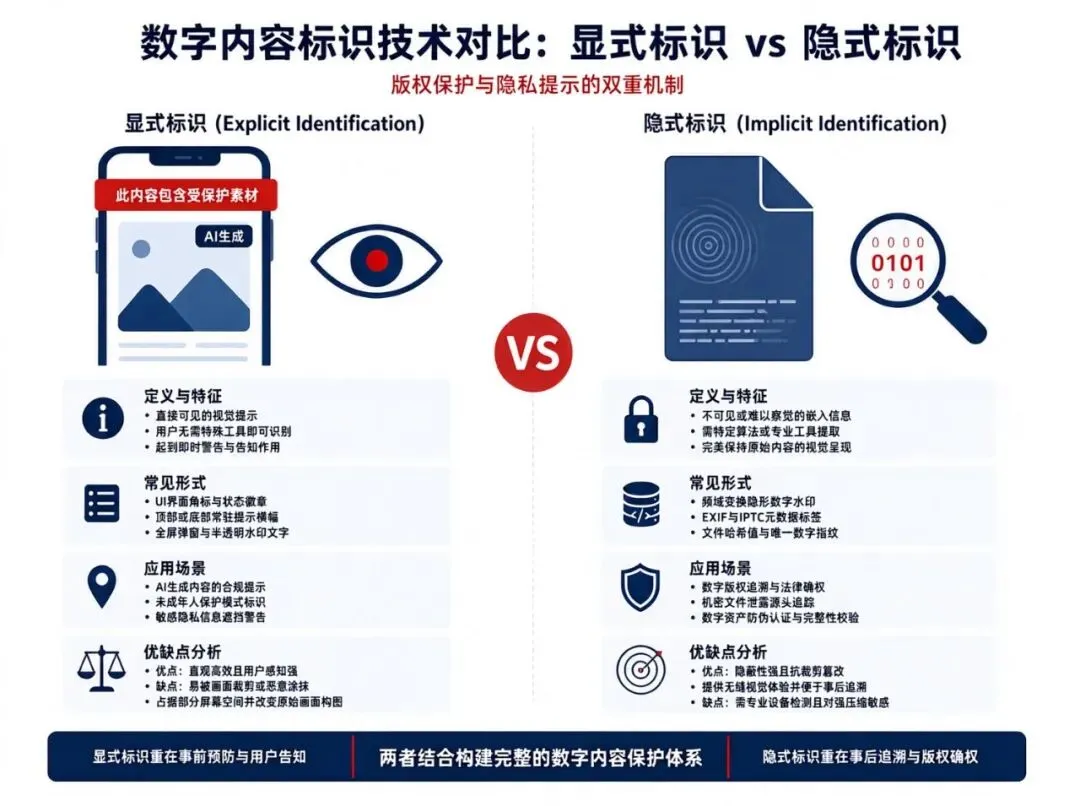
读各国的法规,抓住两个词就够了。显式标识,用户看得见的提示;隐式标识,藏在文件数据里的水印。各家的差别,主要在管多宽、罚多重。
1.1 中国:唯一把隐式标识写成强制义务的辖区
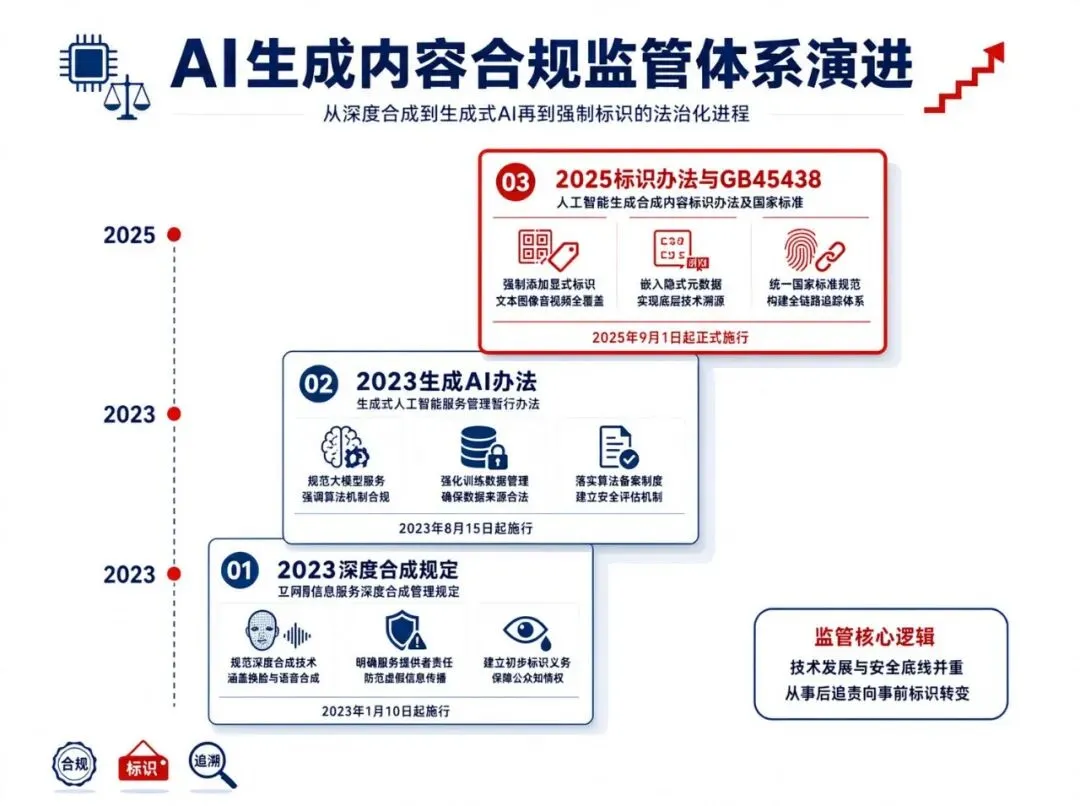
中国对这件事立了三层规矩。底层是《互联网信息服务深度合成管理规定》(2023 年 1 月 10 日施行)[2],第 16 条要求对生成内容"采取技术措施添加不影响用户使用的标识",第 17 条要求对容易让人混淆的内容做显著标识。
中间一层是《生成式人工智能服务管理暂行办法》(2023 年 8 月 15 日施行)[3],第 12 条只有一句话:"提供者应当按照《互联网信息服务深度合成管理规定》对图片、视频等生成内容进行标识。"
重头是 2025 年 9 月 1 日施行的《人工智能生成合成内容标识办法》[1],全文可在网信办官网查到。第 3 条给了两个定义:
第 5 条压下义务:服务提供者应当在生成内容的文件元数据里写入隐式标识,包含内容属性、服务提供者编码、内容编号这些要素;数字水印则是"鼓励"添加。元数据是"应当",水印是"鼓励",两个词的分量差得很远。
第 10 条堵住了后门:
义务主体有四类。服务提供者负责生成时打标,传播平台负责核验元数据并提示,应用商店负责核验上架应用,用户发布时要主动声明。
配套还有一部强制性国标 GB 45438-2025[4],专门规定标识怎么做:显式标识放在哪个位置、隐式标识的元数据字段长什么样,都写死了。办法管"要不要标",强标管"怎么标",关系类似交规和车规。
这套规矩落到普通人头上,就是公众号后台那个勾选框。微信平台 2025 年 8 月底发公告[27]:发布 AI 生成内容要主动声明,平台会再加标识,"不得以任何方式删除、篡改、伪造或隐匿平台添加的 AI 标识"。
1.2 欧盟:全境强制,罚则最重
欧盟《人工智能法案》(Regulation (EU) 2024/1689)2024 年 8 月 1 日生效,第 50 条透明度义务从 2026 年 8 月 2 日起适用,官方文本在 EUR-Lex[5]。第 50(2) 条约束模型提供者:
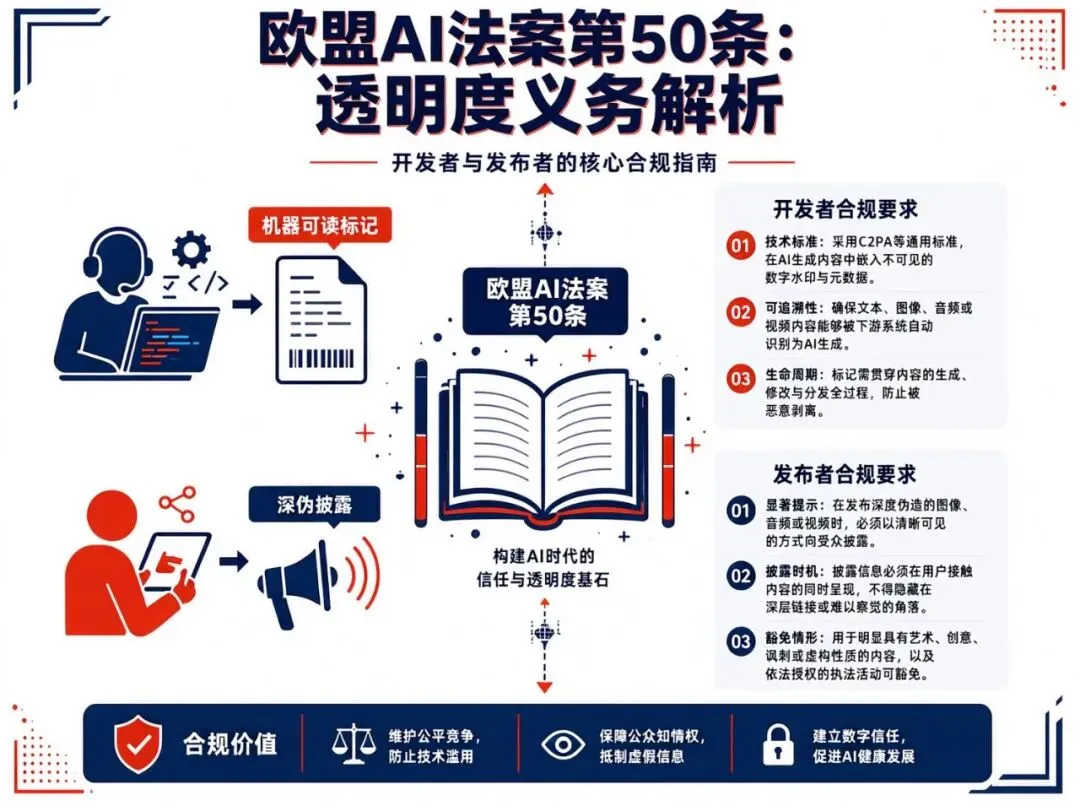
后面跟了一个限定:技术方案须"在本技术可行范围内有效、可互操作、稳健可靠"。这句限定在第二节还会出现,它解释了为什么有的方案敢只做元数据。
第 50(4) 条约束部署者。生成深度伪造的图像和音视频必须披露"内容由 AI 生成或经篡改";艺术、讽刺、虚构作品可以用不破坏呈现的方式标注;就公共利益议题发布的 AI 生成文本也要披露,除非经过人工审核、有人承担编辑责任。
2026 年 6 月 10 日,欧盟发布配套的《AI 生成内容透明度行为准则》[6]终稿。自愿签署,截至 7 月底约 190 家企业组织签了字,欧委会确认它是充分的合规工具。代价落在没签字的公司头上:得自己向监管证明措施到位。
另外根据 2026 年 5 月的数字综合法案临时协议,生效日前已上市的存量系统可以宽限到 12 月 2 日再补齐标记义务。
1.3 美国:联邦不出面,加州单干
联邦层面的方向和欧中相反。拜登 2023 年的行政令 14110 曾要求商务部牵头制定内容认证与水印指引,2025 年 1 月被特朗普的 EO 14179[7]废除,新行政令全文没有出现水印或溯源字样。2025 年 7 月的《美国 AI 行动计划》[8]28 页,watermark、provenance、C2PA 出现次数为零。
深度伪造的治理落在司法取证和 TAKE IT DOWN Act 上,后者把未经同意的私密影像刑罪化、要求平台 48 小时删除,靠的是事后追惩。
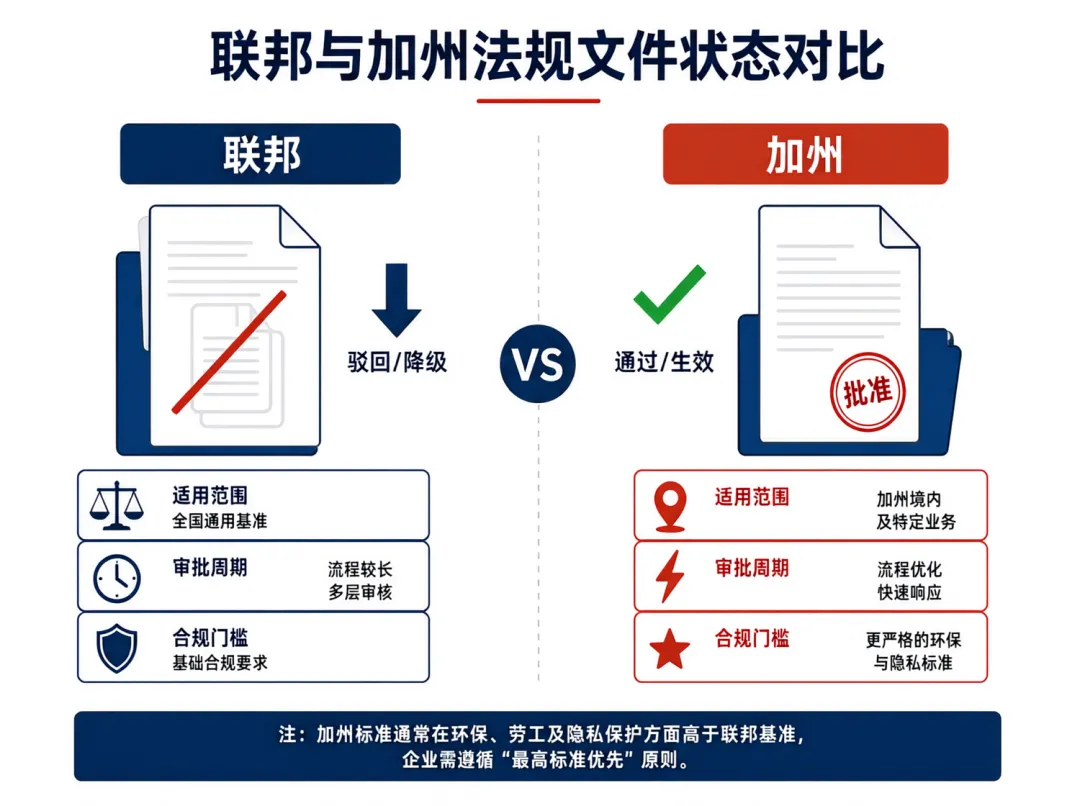
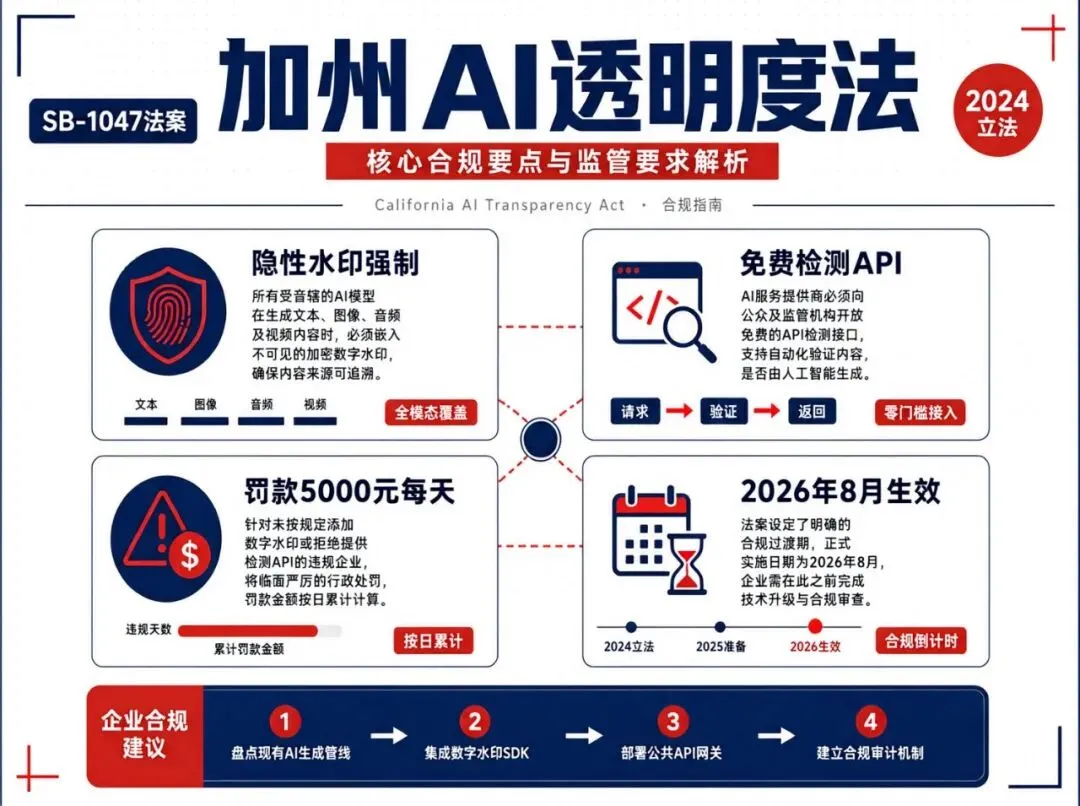
州层面倒是有一部硬法。加州 SB 942《人工智能透明度法》2024 年签署,经 2025 年 AB 853 修订后于 2026 年 8 月 2 日生效,要求月活过 100 万的生成式 AI 提供商给图像、音视频嵌入隐性水印,提供显式披露清单,免费向公众开放 AI 检测工具 API,违规每次罚 5000 美元一天。
AB 853 顺手把另外两个角色拉了进来:大型在线平台 2027 年起要识别并展示内容里的溯源信号,相机厂商 2028 年起要给拍摄内容嵌溯源数据。
其余是 20 多个州零散的政治深伪披露和刑事条款,合规边界各不相同。
1.4 韩国、日本和其他
韩国今年 1 月 22 日生效《人工智能框架法》[9],第 31 条要求生成式 AI 提供者"标明输出由生成式 AI 产生",对难辨真伪的合成音视频要以明显可辨识的方式告知,违反告知义务可处 3000 万韩元以下过怠费。细则留给总统令。
日本走软法路线。《AI 事业者指引》倡导透明性与内容溯源,没有罚则;2025 年 5 月成立的《AI 推进法》是促进法,不设内容标识义务。英国在做标注最佳实践的咨询,巴西的综合 AI 法案还排在众议院,新加坡和澳大利亚维持自愿框架,澳洲的自愿安全标准里列了 watermarking 条目。
1.5 一张表看懂全球立法
| 元数据强制+水印鼓励 | ||||
| 水印强制+免费检测API | ||||
官方出处见文末编号参考来源;表格内容按上文法规原文整理。
横向比较,差别集中在隐式标识上。只有中国把它写成强制义务,欧盟要求机器可读标记,加州用罚则逼厂商嵌水印,其余地区大多停在自愿或建议。
二、技术:指纹加在哪,能扛住什么
2.1 两条大类:元数据溯源和内容水印
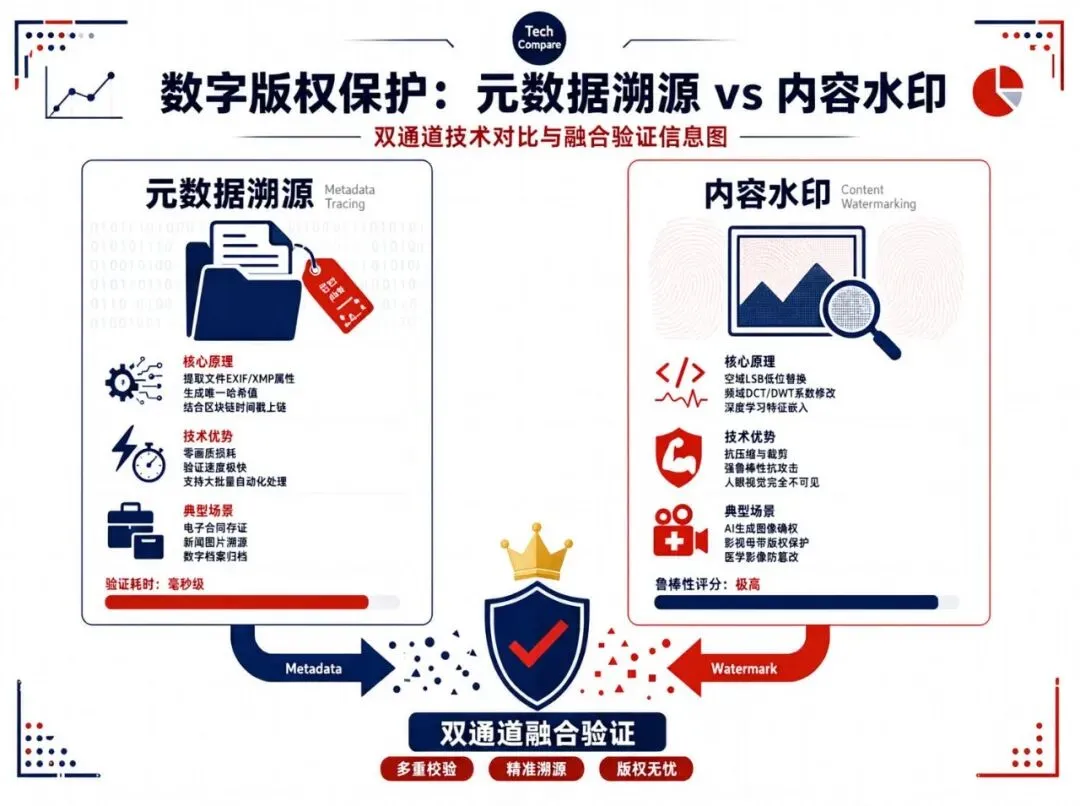
给 AI 内容加指纹,现存的方案分两大类。
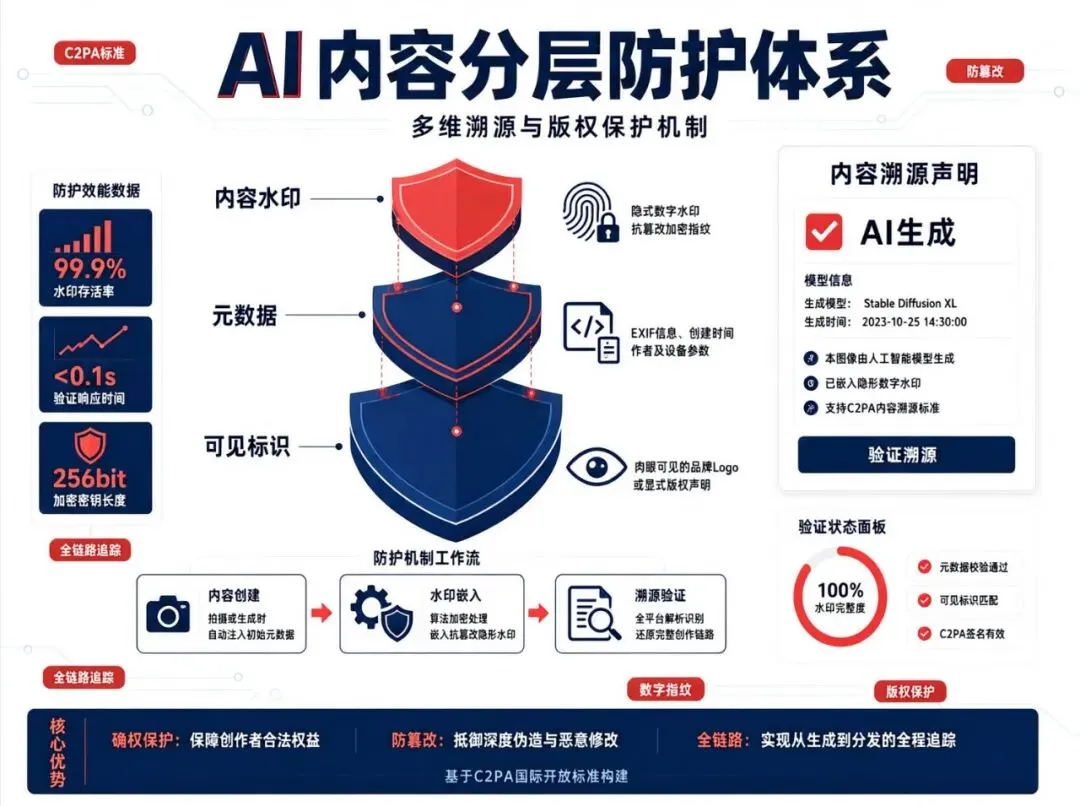
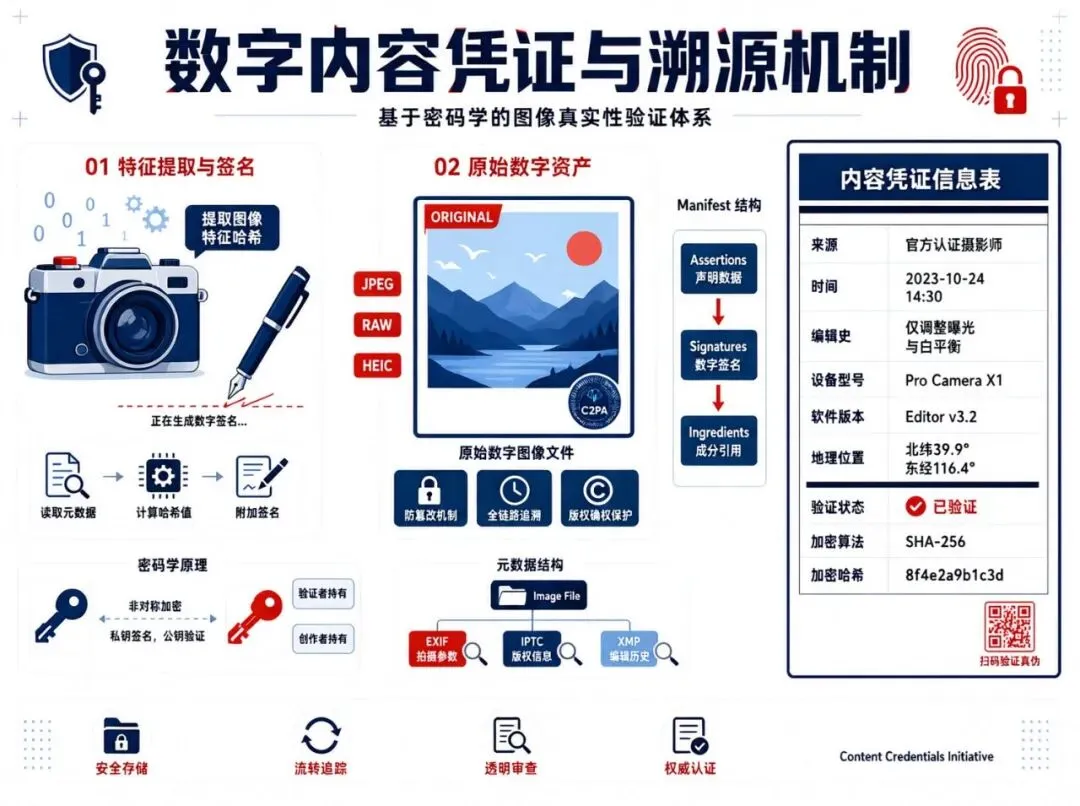
第一类是元数据溯源,代表是 C2PA 标准[26],由内容来源与真实性联盟制定,指导委员会里坐着 Adobe、微软、谷歌、OpenAI、Meta、TikTok、BBC、索尼。它把加密签名的来源与编辑史写进文件元数据,行业里叫内容营养标签(Content Credentials),防篡改、可验证。
连相机厂商都进了场,徕卡 M11-P 是第一台按下快门就给照片签名的相机。OpenAI 从 2024 年 2 月起给全部生成图片嵌 C2PA,Sora 2 的视频也带着。
第二类是内容水印,把信号直接嵌进内容:文本里偏选某些词,图像里扰动像素,音频里加人耳听不见的频谱。文件被转发、被截图、元数据被剥干净之后,信号还留在内容里。
两条路是配合关系。OpenAI 的官方说法是,内容凭证记录文件的来源与编辑历史,隐形水印在元数据被移除后仍保留信号,组合成分层方案。
2.2 文本:绿名单和锦标赛
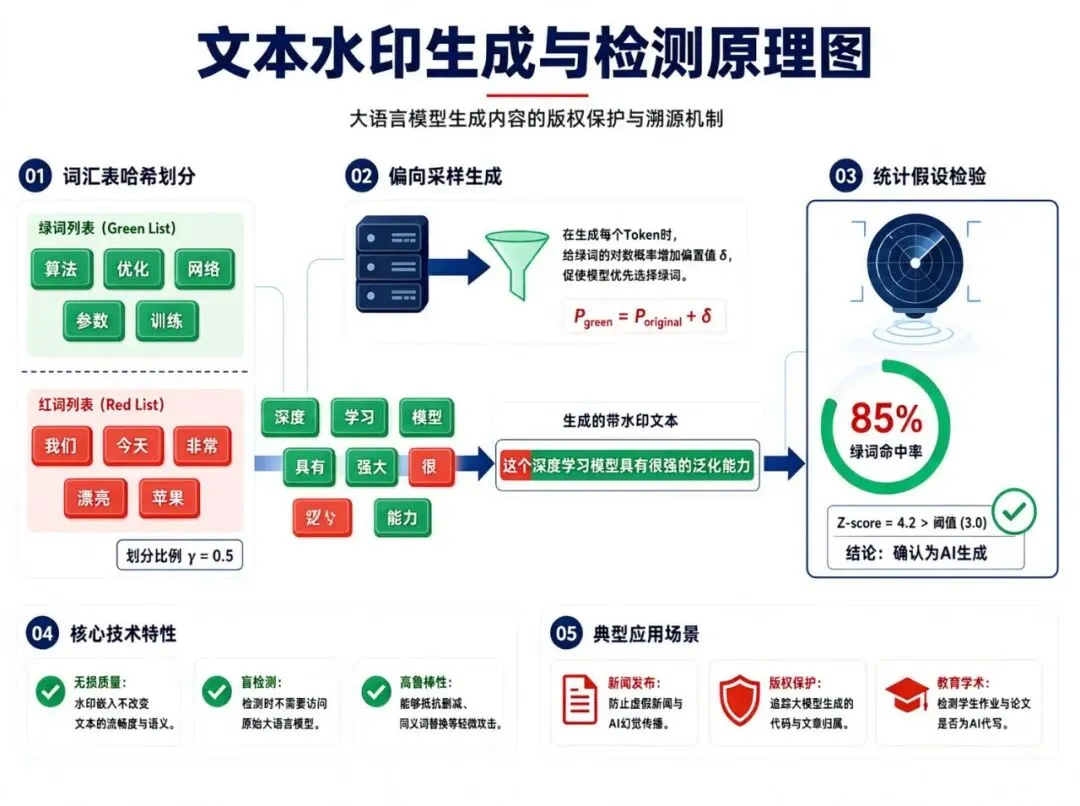
文本水印的主流做法有两代。
第一代是绿红名单,马里兰大学团队 2023 年在 ICML 上发表[10]。生成每个词之前,用密钥把词表划成绿名单和红名单,生成时给绿词的分数加一点偏置,让模型悄悄偏爱绿词。检测时不用碰模型,数绿词占比、算个统计量就够了。
检测器轻,可解释,部署成本近乎为零;代价是短文本统计功效不够,低温度采样下偏置容易伤文风,而且改写一下就能逃,攻击者只需要系统性替换绿词。
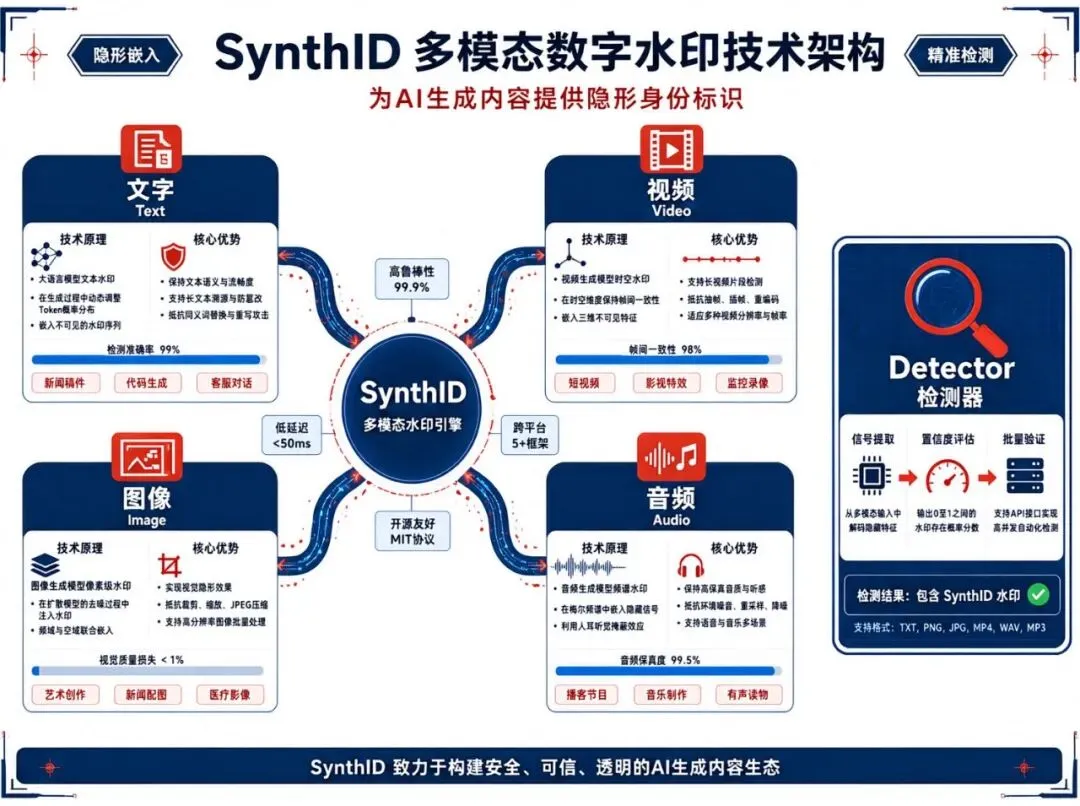
第二代是锦标赛采样,代表是 Google DeepMind 的 SynthID-Text,2024 年发表在 Nature 上[11],代码已开源。它不硬加偏置,每步生成让候选词通过约 30 层锦标赛打分,随机化胜负规则,在可检测性和文风之间找平衡。
质量代价用 2000 万条真实 Gemini 对话做过在线对照:点赞率差 0.02%,点踩率差 0.01%,统计上不显著。这是文本水印第一次大规模生产部署,现在 Gemini 的文本输出默认带它。
还有一条语义路线(ICLR 2024),用语义向量而不是词本身定义名单,并给出可证明的鲁棒性保证:攻击者的改动只要不超过语义阈值,检测结论仍然成立。
这套技术的死穴在改写。普林斯顿等机构的研究者(包括密码学家 Barak)在 ICML 2024 给出了可证明的规避方案[12]:把随机词换成同义词再换回来,就能在不损质量的前提下洗掉大多数低失真水印。强文本水印在理论上就不成立,工程上能做到的只是抬高攻击成本。
OpenAI 给自家水印公布的实测数字:1% 假阳性下,200 词段落检出率约 80%,400 词约 95%;替换 10% 的同义词,检出率从 92% 掉到 66%;替换 25%,只剩 17%。所以他们自己反复说,没检出水印不能证明文本是人写的。
2.3 代码:编译是挡在指纹前面的最大障碍
代码也是一种文本,但上面的方法搬到代码上,效果立刻打折。代码的语法约束强,模型能自由发挥的位置少,学术上叫低熵。绿名单要在"选哪个词"上做手脚,代码里留给模型挑的空间本来就不大。马里兰那套方法直接用在代码上,检出率基线只有 0.72 到 0.82,比自然语言难看得多。
后续工作都在找补:SWEET(ACL 2024)[15]只挑高熵的位置嵌水印,避开语法关键位;STONE(EACL 2026 Findings)[16]发现代码里熵最高的往往就是关键字这类语法 token,在它们上面嵌水印会直接产出逻辑坏掉的代码,所以只敢在非语法 token 上动手;CodeIP[17]训练了一个类型预测器约束采样,往里嵌多比特信息,比如厂商 ID。
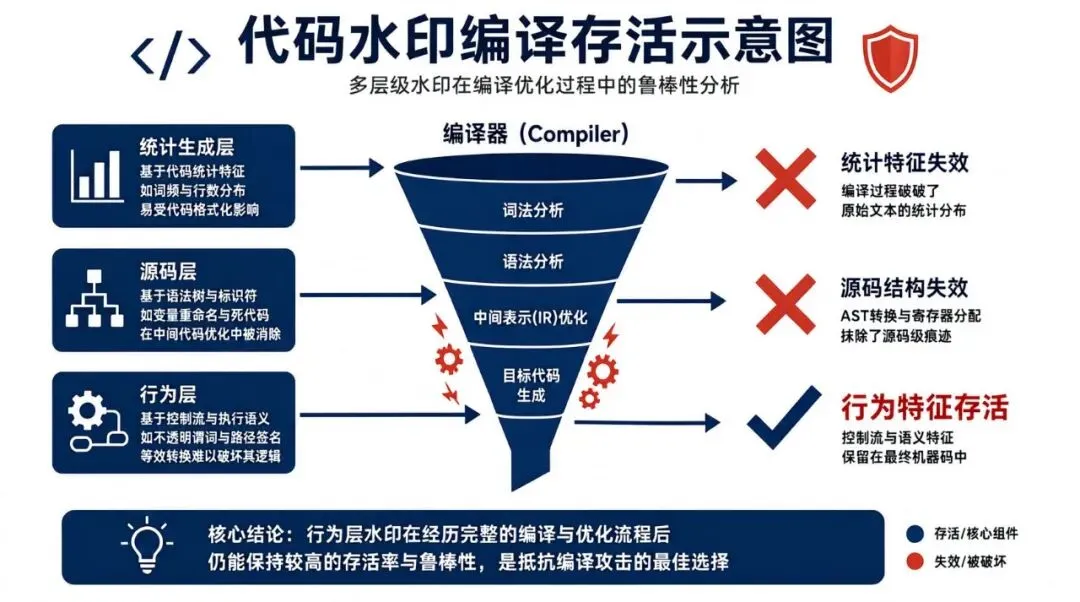
指纹加得进去,这一点没有争议。要回答的是下一问:没人刻意破坏、就走一遍正常编译,这些指纹还在不在。这取决于你手里拿什么去验。
手里有源码,就都在。编译读源码、产出二进制,不会反过来改写源文件。统计生成层的水印写在 token 选择里,源码层的水印写在 AST、命名和注释里,都原样躺在源码中,检测器拿源码一验便知。
只剩二进制,就要分水印埋在哪一层了。
统计生成层(SWEET、STONE、CodeIP 这一族)的信号是源码 token 的统计偏置。编译时词法分析丢掉注释和空白,标识符进了符号表,AST 被规范化,优化器做完常量折叠、内联、向量化之后,二进制里没有"源码 token 分布"这个对应物。取不出来,连检测的入口都没有,因为这类检测器要拿源码重放模型。
源码层(对已生成代码做语义保持变换的后处理水印,如 IEEE TSE 接收的 ACW[19])看嵌法。嵌注释和空格的进不了二进制;嵌标识符命名的,普通构建的符号表里还在,发布时做了 strip 就没了;嵌结构风格的(if 写成三目、循环怎么组织、死代码放哪),不开优化的编译能存活,开 -O2 之后大部分被规范化抹平。
内联和死代码消除是编译器的本职工作,没有人攻击,它们也会顺手抹掉一部分水印,这个损耗要计入预期。
行为层(经典动态软件水印,Collberg 和 Thomborson 1999 年在 POPL 上奠基的那一支[20])是为"从编译产物里提取"设计的。水印编在运行时行为里,程序在特定输入触发时,会在堆里搭出一个特定形状的数据结构;提取时运行程序、喂入触发输入、观测堆图。编译器优化不改变程序在触发输入下的可观察行为,所以正常编译、strip 都不影响它。
商业工具在用,PreEmptive 的 Dotfuscator 就内置了给编译后程序集嵌水印的功能。代价是提取要运行程序、要知道触发输入、要能观测运行时状态;而且这门手艺诞生二十多年,还没有人把它移植到 AI 代码溯源上。
如果有人刻意绕过,那是另一回事。arXiv:2403.17983 实测过[18],仅仅对源码做语义保持的温和改写(重命名、插死代码、包一层 try-catch),现有水印的检出率就从 0.79 掉到 0.22 到 0.38 不等,Unigram 水印在插入死代码后只剩 0.01。绕过的门槛不高。顺带一提,这条线的文献至今没有实测过完整编译链后的检出率,算是个空白。
法规那边也没把代码接住。《标识办法》第三条列举的生成内容类型是"文本、图片、音频、视频、虚拟场景",全文没有出现代码或编译产物字样,合规圈的解读有争议,主流建议是面向公众发布的生成代码加标识,IDE 里的辅助生成管不管没人说得清。欧盟第 50 条列举的同样是音频、图像、视频、文本四类。产业侧,GitHub Copilot 和 Cursor 都没有公开的代码水印机制,Cursor 提供按行数统计 AI 代码占比的 API,那是统计归因,算不上密码学水印。
合起来回答这节的问题:AI 写的代码,指纹加得进去;手里有源码,正常流程都取得出来;只剩二进制,统计层取不出来,标识符和结构类在没 strip 的构建里大概率还在,但要吃编译器的正常损耗;行为层动态水印是唯一为二进制提取设计、扛过二十年攻防的老手艺,只是还没人把它用到 AI 代码上。
法规现状同前:义务清单里没有代码,想在编译产物里验 AI 指纹,技术上留着几条路,法规上还没有依据。
| 可提取 | |||
代码水印四层在正常编译(不 strip、不混淆)下的存活情况。
2.4 图像:从贴纸到纹身
图像水印按信号藏在哪分四档。
最弱的是最低有效位(LSB),藏在像素最低位,人眼看不见,JPEG 一压就没了,教科书级的脆弱,如今只配当对照组。往上是频域水印(DCT/DWT),藏进离散余弦或小波变换的中频系数,设计目标就是抗 JPEG 压缩,但缩放裁剪会破坏频域对齐。
再往上是扩散模型原生水印,思路从贴在图上变成生图时就带上。Stable Signature(Meta/Inria,开源)[13]直接微调解码器权重,每一张生成图出厂自带水印,实测图像裁到只剩 10% 的内容,检出率仍有 90% 以上,假阳性低于千万分之一。Tree-Ring 把水印嵌进初始噪声的傅里叶空间,靠反演恢复验证,对裁剪、翻转、旋转天然免疫。Google 的 SynthID[25]用于 Imagen 和 Veo,官方声称扛得住裁剪、加滤镜、改帧率、有损压缩。
元数据是另一极:技术上最标准,物理上最脆弱,一张截图就能让它失效,平台的转发处理也会把它剥掉。灰色产业有实测,3 块钱、1 分钟,Sora 2 视频的三处可见水印加 C2PA 元数据全部剥净。
把"经过什么处理之后还能提取"整理成一张表(依据已发表文献和厂商官方声称,空格为无公开结论):
图像水印鲁棒性对照:✓ 扛得住,✗ 失效,依文献与官方声称整理。
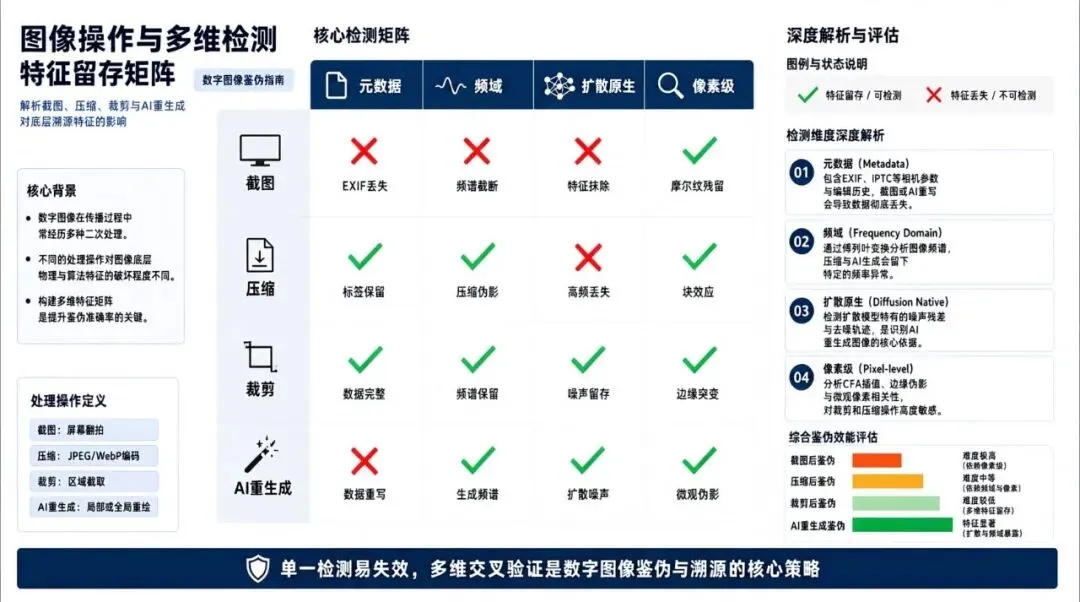
最后一行要多说一句。NeurIPS 2024 有论文证明[14],先加噪、再用生成模型重建,可以洗掉四种主流像素级水印。用 AI 去 AI 水印,攻防卷到这个程度了。
音频和视频的逻辑类似:SynthID Audio 抗 MP3 压缩和变速,Meta 的 AudioSeal 能定位哪几秒是克隆的;视频水印约等于逐帧图像水印加时间轴一致性。
顺带分清一个概念:模型指纹回答的是哪个模型产的(LLMmap[21]问几个 API 就能以 95% 以上准确率认出 42 个模型版本),内容水印能携带更细的溯源信息,法规要求的是后者。
2.5 这套技术公认的天花板
学界和厂商自己认账的局限有四条。
统计检测不等于密码学证明,检出是概率判断,有误报漏报,强水印在理论上就不成立。规模化误伤是商业问题,OpenAI 2023 年的 AI 文本分类器就因为 9% 的误伤率下线,把人写的东西误判成 AI,后果由普通用户承担。
开源模型管不住,SynthID 论文自己承认,文本水印要求控制推理过程,开源和本地部署的模型生态没法强制打标;法规能管公司,管不了你笔记本上的权重文件。攻防已经是红海,改写攻击打文本,重生成攻击打图像,视频那边有 3 块钱一次的去水印灰产。
DeepMind 自己的表态反而最清醒:"SynthID isn't a silver bullet for identifying AI generated content。[25]"监管者也清楚这一点,不然中国办法不会把元数据写成"应当"、把水印写成"鼓励",欧盟条文也不会留"技术可行"的活口。
三、公司:谁在做,怎么说
技术上没有一家做不到,差别在什么时候做、做多少、怎么说。
3.1 Google:抢着当基础设施
DeepMind 是唯一一家全模态默认打开的:文本(Gemini 默认 SynthID-Text)、图像(Imagen)、视频(Veo)、音频(Lyria、NotebookLM)全覆盖,代码开源,2025 年 I/O 上线的 SynthID Detector 检测门户已向所有人开放,而且不只验自家水印,还能检测 OpenAI、NVIDIA、Kakao 的内容,Apple 的在排期。
加上 2024 年 2 月加入 C2PA 指导委员会、把水印能力接进搜索和相册,Google 在抢行业基础设施的位置。姿态也放得开,一边全力推,一边自己说不是银弹。
3.2 OpenAI:压了三年的工具,上周上线
2024 年 8 月,《华尔街日报》披露 OpenAI 早已开发出文本水印,内部文档称长文本检出准确率约 99.9%,但内部调查显示近 30% 的用户表示如果 ChatGPT 加水印而竞品不加,他们会减少使用;最依赖 AI 辅助写作的恰恰是非英语母语者,误伤的矛头会对准他们。于是工具造好了,压着不发。(99.9% 出自媒体转述的内部文档,非官方口径。)
转折点是法规。欧盟第 50 条生效两个月后,OpenAI 在 10 月 5 日官宣 textGrain[23]:欧盟境内符合条件的 ChatGPT 与 Codex 文本输出默认嵌入隐形水印,API 开发者全球可自选开启(默认关),检测器初期只对获批的研究者与机构开放,并计划开源检测器。表态口径依然留了余地:没有水印不能证明是人写的,标识不替代可见标签。
三年不发,法规一生效就发。这里面的商业账不难算:先加水印的公司,用户会流向不加水印的对手,所有人都等着法规当发令枪。欧盟一发令,Anthropic 和 OpenAI 前脚后脚上线,不是巧合。
3.3 Anthropic:全球强制,不给开关
2026 年 8 月 14 日,Anthropic 发文《How Claude's text watermarking works》[24],两句话值得原样读:
技术上直接用了 Google 开源的 SynthID-Text 路线的变体,Claude 生成与处理的文件附 C2PA 签名溯源,不提供退出选项,检测 API 只对监管者、执法、媒体、事实核查机构和有合规义务的企业开放。欧盟的法规,让全球的 Claude 文本都带上了水印,管得比很多人以为的远。这个决定引发了部分用户反弹,输出被埋了信号这件事,没得商量。
3.4 Meta 与其余
Meta 的打法规格:Stable Signature 直接开源,平台侧 2024 年起给 AI 内容打"AI Info"标签,而且基于元数据检测的打标不受用户开关控制,从删除 AI 内容改成了打标告知。xAI 的 Grok Imagine 生成的图和视频普遍带可见水印,但官方没有公开政策文档,这里不展开。国内各家(百度、讯飞、Kimi、智谱、通义)新规施行首周的媒体横评显示主流应用基本完成了显式打标。
3.5 中国公司:落地一百多天
2025 年 9 月 1 日新规施行当口,DeepSeek 官方公众号宣布已在平台内对 AI 生成内容添加标识;腾讯元宝 8 月 31 日官宣建立标识管理体系,显式标注之外,元数据里嵌入了 AIGC 符号、服务者编码、内容编号;快手给可灵上线了标识功能和用户主动声明功能。抖音走得最前,把 2023 年就自己定的水印与元数据规范升级成了平台级元数据读写能力。
落地过程也有翻车的。2026 年 4 月,工信部对剪映、猫箱 App 和即梦 AI 网站采取约谈、责令改正、警告及责任人处理[28],理由是未有效落实生成合成内容标识规定,字节这样的大厂也上了名单。合规是持续整改的过程,"强制"两个字在中国会真的敲门。
3.6 一张表看懂巨头站位
尾声:水印防得住谁
技术结论说直白点:水印防不住铁了心造假的人。3 块钱能剥掉 Sora 的三重防护,同义词替换能洗掉文本水印,AI 重生成能洗掉像素水印,AI 代码的指纹进了二进制就基本验不了。
它管住的是量大面广的日常冒充。大多数 AI 内容造假够不上高手作案,就是随手生成、随手转发:假通知、假截图、假金句。显式标识给人看,元数据给平台核验用,内容水印在转发和截图之后仍然有效。三层信号各挡一类人,这就是 OpenAI 说的分层方案。
监管者明知水印不是银弹还是要立法,立法目的落在别处:把造假的默认成本从零抬高。
AI 写的代码要单独记一笔。法规没接住它,中国办法和欧盟第 50 条的义务清单里都没有代码;验证端也没准备好,指纹在源码层,编译后的二进制里基本验不了,能从二进制提取的行为层水印还没人移植到 AI 代码上。AI 写的代码正在大量进入生产系统,这段空白什么时候补上、由谁来补,值得持续盯着。
规则已经落到你我头上。中国 490 多个备案大模型、2.3 亿生成式 AI 用户,全在《标识办法》射程内;在公众号、抖音、小红书发布 AI 参与创作的内容,都有那个主动声明的勾选框,恶意删改标识本身就是违规。
这篇稿子查了三国语言的一手文献,资料整理用了 AI 辅助。发布时我会如实勾选那个"内容由 AI 生成"。你要是好奇,可以去扒它的元数据。