ARTICLE · 1165138
DeepSeek Bot 源码拆解:多 Agent 怎样从演示走向一套可运行的系统
架构师(JiaGouX)
我们都是架构师!架构未来,你来不来?
多 Agent 的演示并不难做。
准备几段角色提示词,让“产品经理”“架构师”“程序员”轮流发言,再配上一组头像,一个看起来很像 AI 团队的 Demo 就有了。
真正难的是第二次打开它。
昨天的任务还接得上吗?其中一个 Agent 做到一半失败了,系统知道停在哪里吗?群里到底谁该接话?其他 Agent 要不要重复读取整段上下文?API Key 怎样交给工具,又不进入聊天记录?桌面端和 Web 端同时打开,会不会把同一份状态互相覆盖?
这些问题不太适合做宣传截图,却决定了一组 Agent 究竟只是“演给人看”,还是已经接近一套可以持续运行的系统。
这也是我重新翻 DeepSeek Bot 源码时,最想弄明白的地方。
今年我们从 Harness、Agent Loop 一路聊到 Context、State 和 Memory,反复绕着同一件事:模型能把一步想明白,不等于系统能把一件事接着做下去。《多 Agent 不是虚拟公司》又把问题往前推了一步——多 Agent 首先是信息架构,不是岗位编制。
DeepSeek Bot 刚好把这两条线接到了一起。它表面上给 DeepSeek Harness(DSH)加了 Main Bot、普通 Bot 和群聊,底下做的事情更朴素:给每个 Bot 一个可延续的身份,把协作变成有时序的消息路由,把上下文变成有生命周期的状态,再把工具、密钥和写入权交给运行时管理。
这条路不炫,但很像一套系统开始长出来的样子。
太长不看版
DeepSeek Bot 是基于 DSH 的独立社区项目,不是 DeepSeek 官方产品。已发布版本是 0.1.2;本文阅读的是 2026 年 10 月 12 日的main,其中还有尚未发布的改动。它没有另造一套 Agent Runtime,而是让每个 Bot 落在一个长期存在的 DSH Session 上,复用模型、工具、权限、事件日志和执行循环。 群聊的核心不是多个模型一起说话,而是消息怎样投递:普通协作排到下一轮,紧急纠偏进入当前轮,危险动作必要时直接取消。 当前长对话、旧聊天检索和长期记忆被拆成三套机制,分别处理“眼前怎么继续”“过去怎么找回”“以后什么值得保留”。 真正让它接近可运行系统的,是那些不太显眼的部分:写入权协调、损坏状态保护、权限预设、Secret 隔离、任务清理、用量统计和明确写出的限制。 多 Agent 并不天然优于单 Agent。任务拆不开、上下文高度重叠时,多出来的往往先是协调和 Token 成本。
先把边界说清楚:这是社区项目,也是一个早期版本
DeepSeek Bot,简称 DS Bot,是开发者 Fei2411 基于 DeepSeek Harness 开发的开源插件,采用 Apache 2.0 许可。
README 写得很明确:它是独立社区项目,与 DeepSeek 没有隶属、认可或赞助关系。名字里有 DeepSeek,是因为它运行在 DSH 上,不代表这是 DeepSeek 官方发布的 Bot 产品。
截至 2026 年 10 月 12 日,npm 包版本是 0.1.2,项目标注为 v0.1 preview,文档写明主要验证对象是 DSH 0.2.1-alpha.1。本文阅读的仓库 HEAD 为 508ad823,相对 v0.1.2 又前进了 64 个提交。下面凡是涉及这部分代码,我会明确写成“当前 main”或“Unreleased”,不把它混进已发布版本。
它还不能被当成已经稳定的生产产品。不过早期项目也有一个好处:界面和功能还在变,作者准备把哪些问题放进系统、又愿意为此付出什么代价,往往看得更清楚。
外部几篇介绍主要在讲安装、群聊和 Personal Agent 的热度。那些信息适合第一次认识项目。继续往源码里走,我更想追的是另一个问题:
一个多 Agent Demo,要补齐哪些东西,才能在明天、下周,甚至换一个模型之后继续工作?
演示和系统的分界,不在 Agent 数量
如果只看第一次运行,多 Agent Demo 和可运行系统很像:都有角色、消息、工具,也都能给出答案。
差别通常要到第二次运行、第一次失败,或者第一次并发写入时才暴露出来。
DeepSeek Bot 的源码,基本就在逐项回答右边这列。
我们讲《多 Agent 不是虚拟公司》时,我把多 Agent 概括成信息架构:上下文边界怎么切,信息怎么流,系统什么时候停。到了 DeepSeek Bot 这里,这个判断不再只是方法论。它具体落成了 Session、消息队列、群聊轮次、权限和状态文件。
它的回答还不完备,但主线很清楚:长期协作不能只寄托在角色提示词上,运行时得管住身份、过程、消息、记忆和权限。
第一层:Bot 落到 Session 上,没有再造 Agent
项目里最关键的一句,不在界面,而在插件入口的注释里:
Every Bot is one root Session.
每个 Bot 都是一个普通的 DSH 根 Session。
这个选择很克制。DS Bot 没有因为要做“AI 小队”,就在 DSH 旁边再造一套模型调用、工具执行和会话存储。它给 Bot 增加名字、角色、指令、模型、头像和团队关系,但真正跑任务时,仍然进入 DSH 原有的 Agent Loop。
换句话说:
Bot 负责“它是谁”,Session 负责“它怎样工作”。
在 ds-bot/index.js 里,插件依次装入存储、模型、权限、轮次、消息投递、团队名册、提示词、工具、群聊、记忆、长对话分段、Secret、定时任务、浏览器和用量统计等模块。这些能力都挂在 DSH 已有的服务和事件上,并没有另起一个封闭内核。
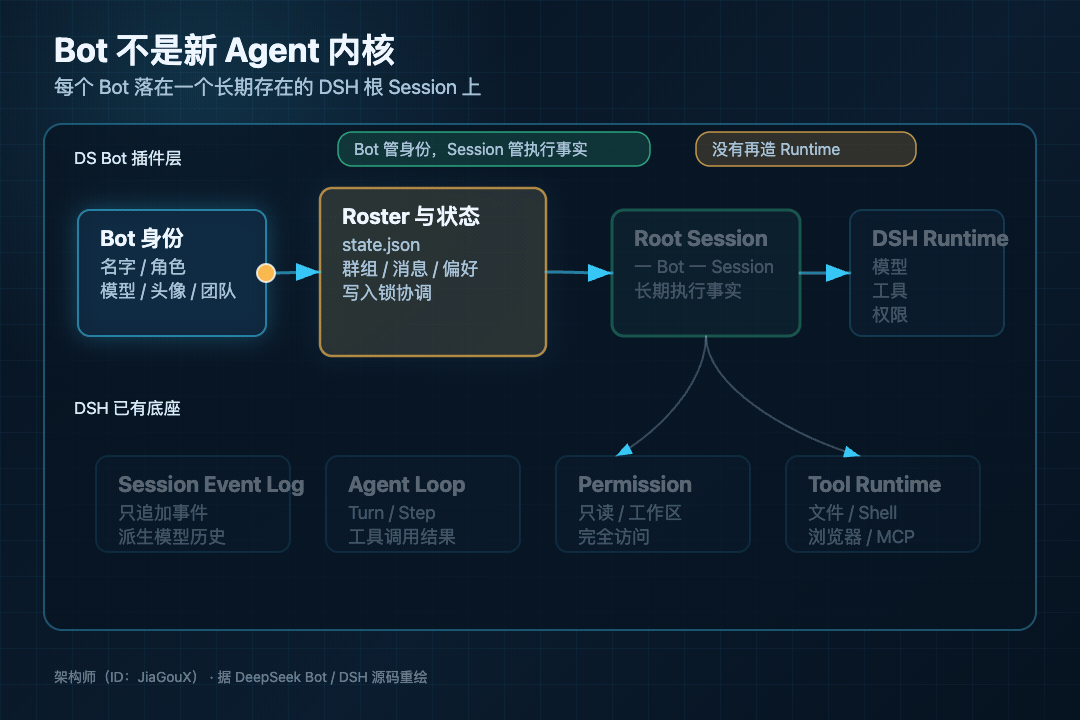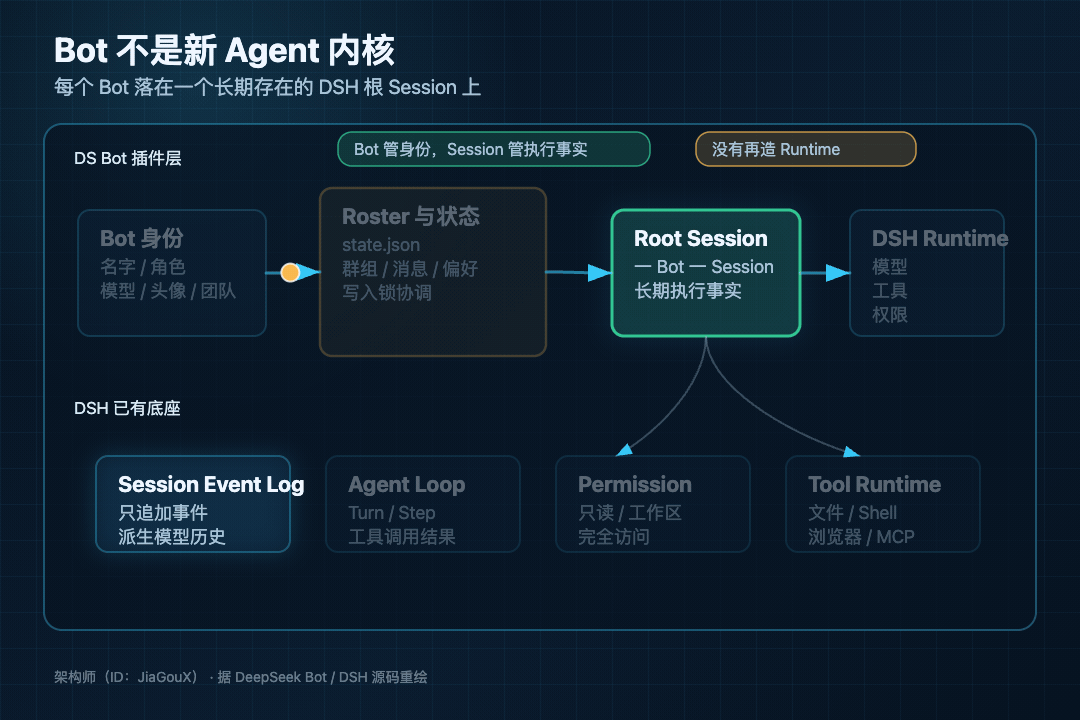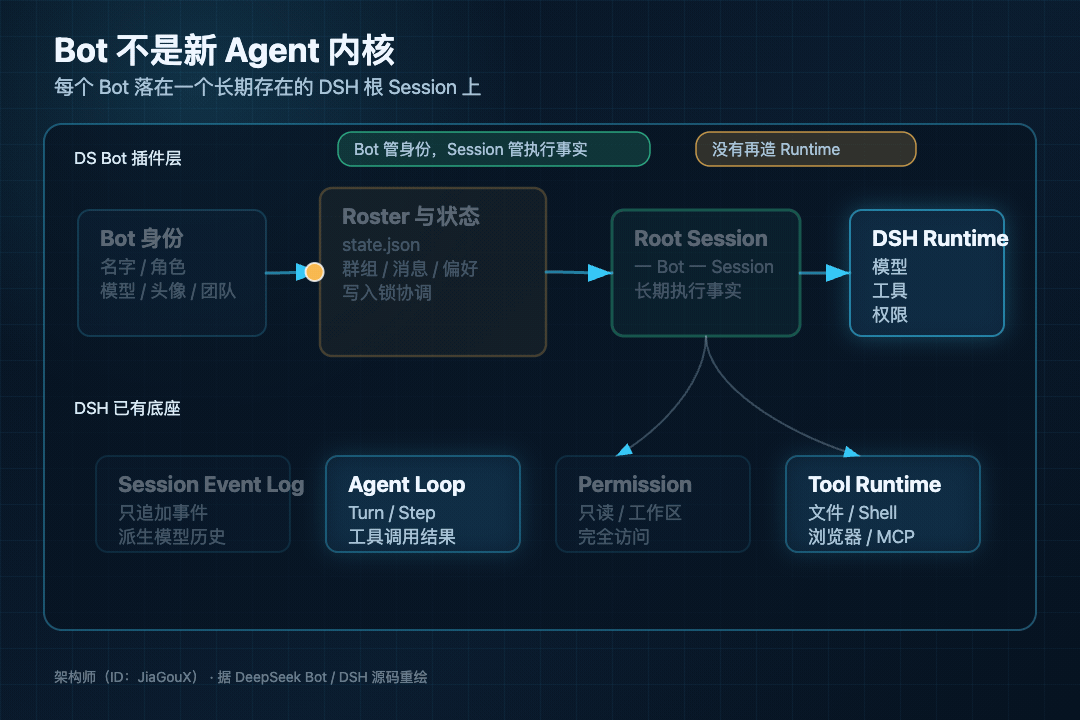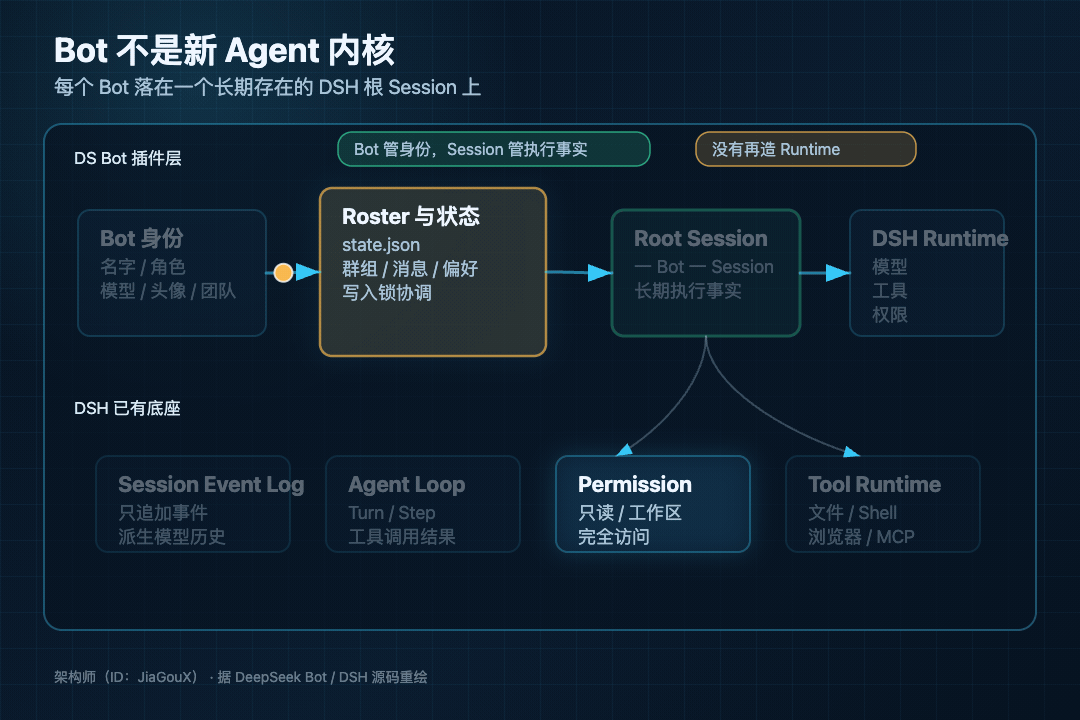
这对长期演进很重要。
今天 Writer 用 DeepSeek,之后也可以换到别的模型;它的名字、职责、记忆和历史不必跟着推理引擎一起重建。模型是可替换部件,Bot 才是用户长期面对的身份。
而且,DSH Session 也不只是一段聊天文本。
官方文档把 Session 定义为一份只追加的、带类型的 SessionEvent 日志。一个 Turn 里可以有多个 Step;用户消息、系统消息、模型回复、失败尝试、工具调用、工具结果和轮次边界都会成为事件。下一轮送给模型的消息,是从这份日志重新推导出来的,不是另存一份容易漂移的“聊天历史”。
于是,Bot 的长期存在有了两层依据:
名字、角色、模型和团队关系,回答“这是谁”; Session Event Log,回答“它确实做过什么”。
这两层不能混在一起。
只有角色,没有过程,系统出了问题只能翻聊天猜。只有过程,没有长期身份,多条任务和记忆又很难稳定归属。把 Bot 固定到 Session 上,正好把身份模型和执行事实接了起来。
这是 DeepSeek Bot 从 Demo 往前走的第一步,也是后面那些能力能够接起来的前提。
第二层:协作从“互相聊天”变成消息协议
多 Agent Demo 很喜欢让几个角色轮流发言。看起来热闹,实际很容易出现三个问题:
一是每个 Agent 都重新理解一遍同样的上下文;二是大家倾向于补一句,哪怕没有新信息;三是任务出了岔子,很难说清一条消息到底是新任务、补充信息,还是紧急纠偏。
DeepSeek Bot 的群聊没有完全放任 Bot 自由发挥,而是加了一套很薄的消息协议。
默认先找管理员,不让所有成员一起抢答
每个群都有一个 admin。默认模式下,普通消息先交给管理员;管理员判断确实需要别的能力时,再 @ 对应成员。用户也可以直接点名某个 Bot。
另一种 everyone 模式才会让成员依次回答,而且管理员仍然先发言。轮到某个成员时,如果没有新内容,它可以返回 [PASS],这一条不会变成又一段礼貌附和。
这里控制的不只是发言顺序,还有上下文和成本的扩散范围。
默认只唤醒一个 Bot,等于先把问题收敛;需要专业分工时,再把必要信息投递出去。它不保证协作一定有效,但至少没有把“更多人读一遍、更多人说一句”当成默认答案。
普通消息、紧急纠偏和停止,是三种不同动作
源码里的 message_bot 很能说明问题。发送方必须写一条自包含消息,因为接收方看不到发送方的完整会话。它调用 DSH 的 agent.followup:如果对方正在工作,消息排在当前 Turn 后面;如果对方空闲,就开启下一轮。回复可以回到发送方,也可以让目标 Bot 在自己的对话里直接回复用户。
紧急消息走另一条路。只有 Main Bot 能调用 interrupt_bot,底层用的是 agent.steer。它会在目标 Bot 当前 Turn 的下一个 Step 插入提醒,适合纠错、改方向,或者阻止一个还没发生的危险动作。
如果提醒已经不够,Main Bot 还能调用 stop_bot,通过 agent.cancel 结束当前 Turn。排在这个 Turn 上的消息会一起丢弃,系统随后再开一轮,把停止原因告诉它。
这不是三个相近的按钮,而是三份不同的时间契约:
message_bot:这件事排在当前工作之后; interrupt_bot:这条约束要进入当前工作的下一步; stop_bot:当前工作不能再继续。
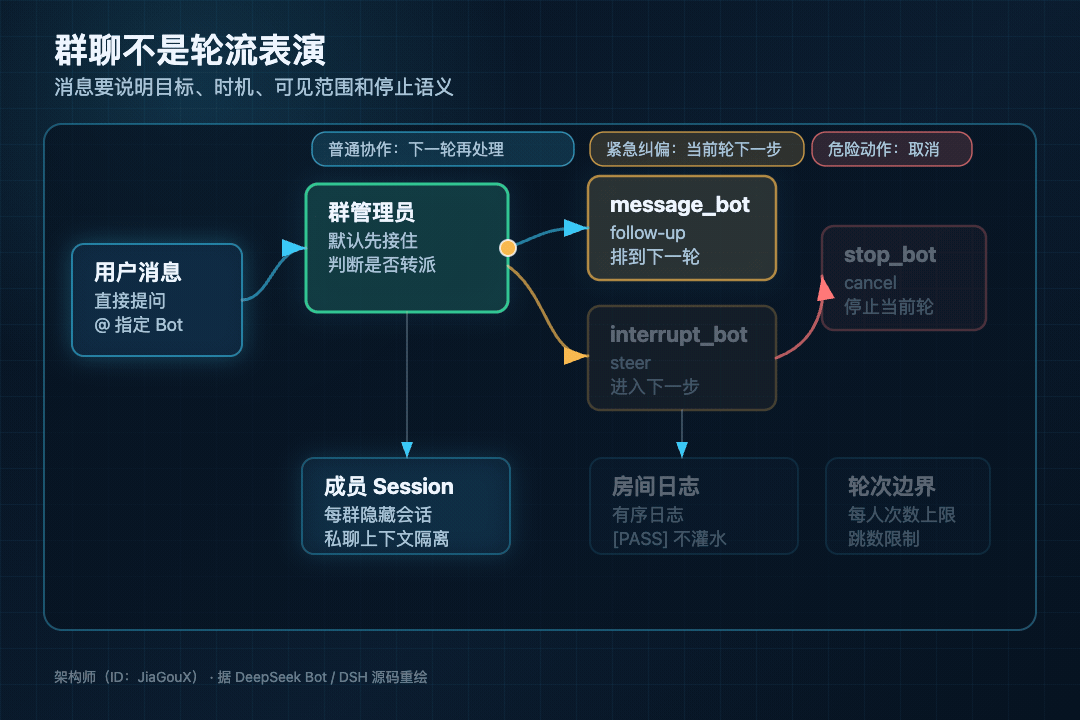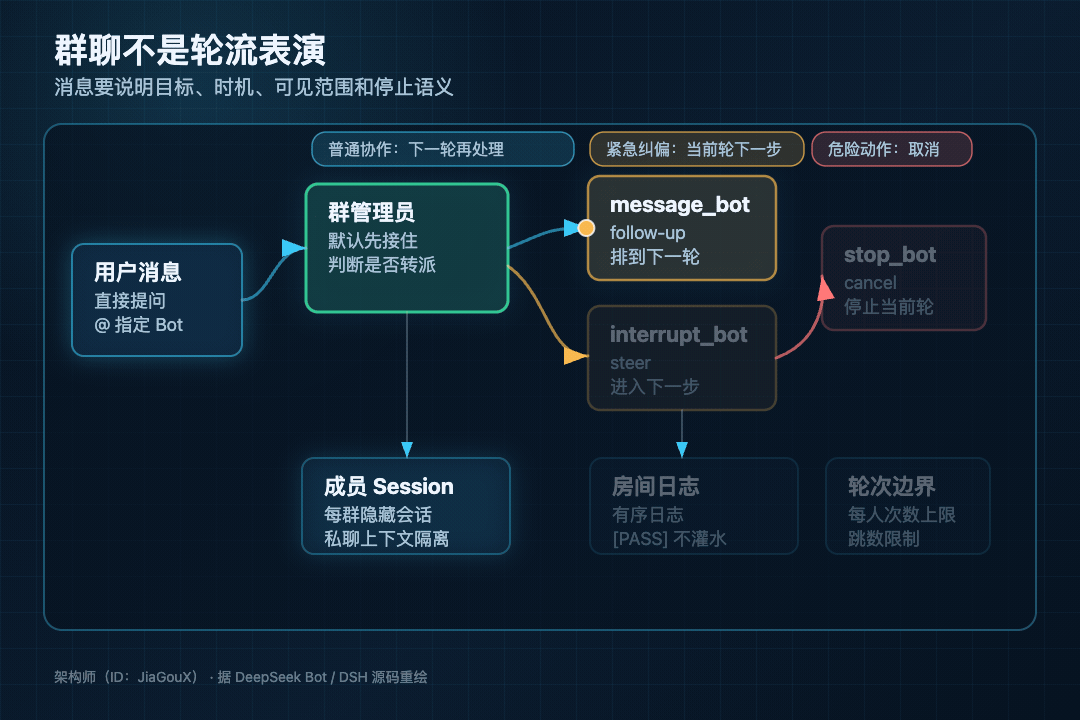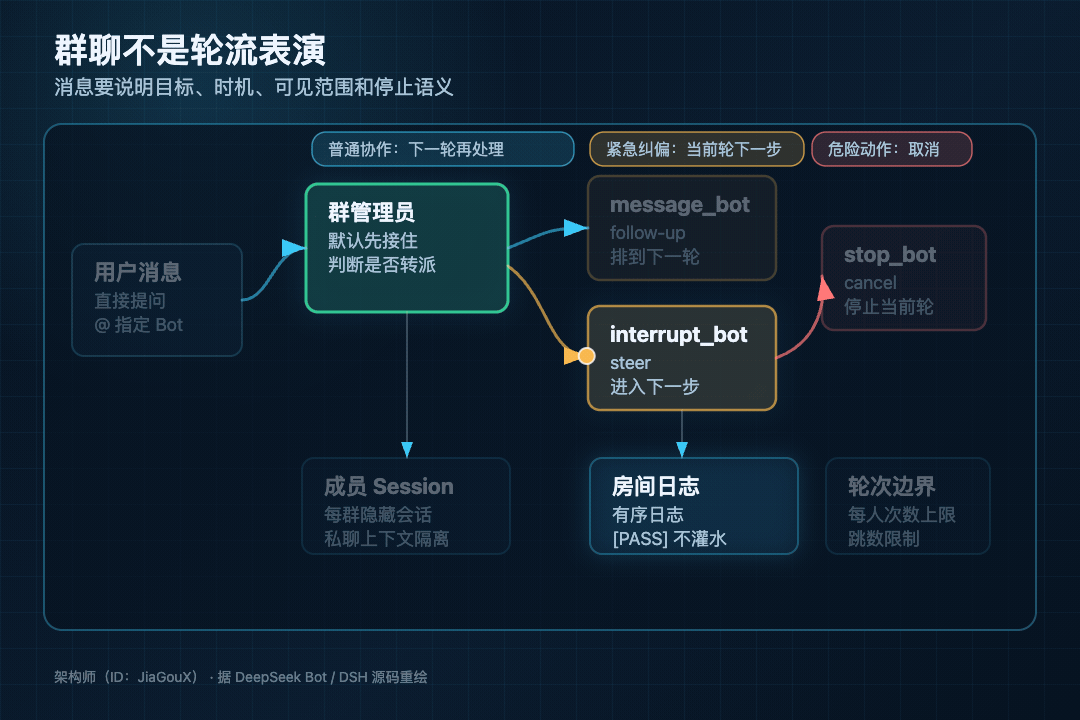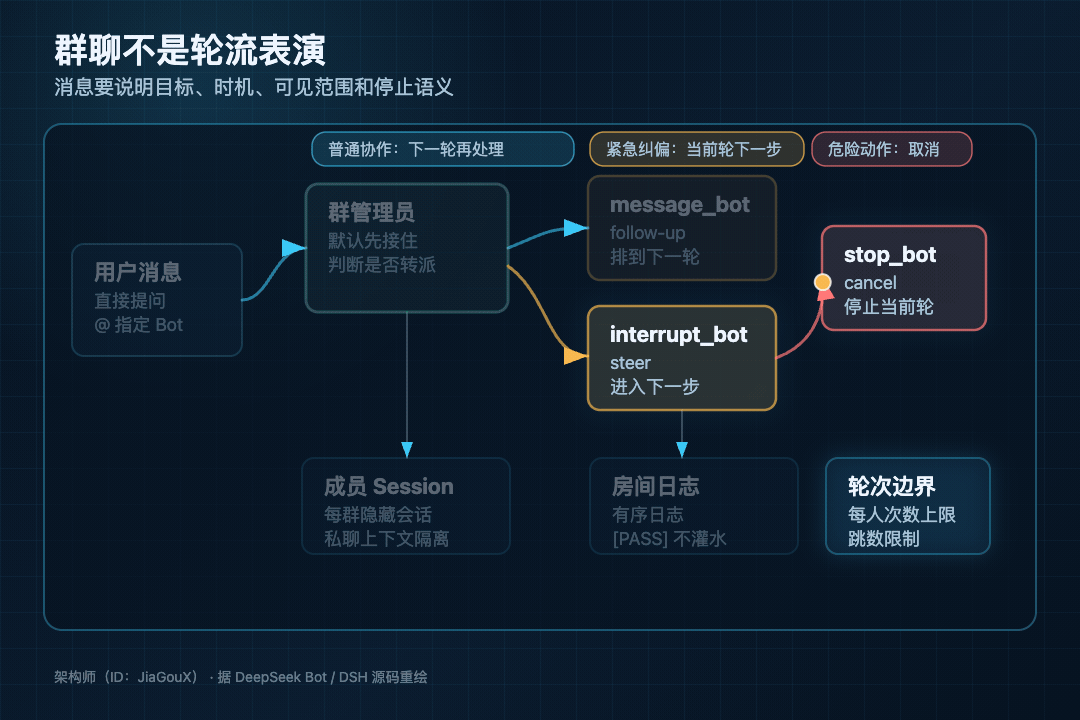
10 月 1 日我们在比较 Pi 与 DSH 时,专门拆过 steering、follow-up、next-step 和 next-turn。当时讨论的是 Agent Loop 怎样判断继续和收口;DeepSeek Bot 往上又走了一层,把同一套时序语义用在 Bot 之间。消息不只要“送到”,还要说清它属于现在,还是下一件事。
代码还限制 Bot 消息链的最大跳数,避免两个 Bot 反复转派。消息投给某个 Bot 的私聊 Session,也不会自动改写它正在群里的另一份工作。控制面不大,但边界是实的。
群聊上下文和私聊上下文分开
每个成员进入一个群时,会使用这个群里的独立隐藏 Session。群聊能读群里的消息,但不会顺手拿到该 Bot 与用户的私聊。群的“房间”本身负责维护有序日志和轮次,真正调用模型的是一个个成员 Session;成员按顺序发言,前一个发完或 [PASS],下一个才开始。
这既是上下文隔离,也是权限隔离。
同一个 Bot 可以在不同场合保留不同的工作集,而不是把所有经历都倒进每一个群。对长期 Agent 来说,这种隔离很实际:共享得太少,协作不起来;共享得太多,隐私、成本和干扰都会失控。
所以 DeepSeek Bot 的群聊更像一个有主持人的消息路由器,不像一场人人必须表态的圆桌会。成员还可以在回复里 @ 下一位,但每轮、每个成员都有次数上限;普通成员不能用 @all 引发一场无限扩散的“群聊风暴”。
到这里,角色有几个已经没那么要紧了。更要紧的是,每条消息有没有明确的目标、时机、可见范围和停止条件。
第三层:上下文开始有自己的生命周期
Agent 跑得久以后,最先撞上的通常不是模型能力,而是上下文管理。我们在 10 月 8 日的 Harness 源码拆解里说过,上下文压缩不是摘要作文,而是状态保存。DeepSeek Bot 在这里给出了一个更贴近日常使用的实现。
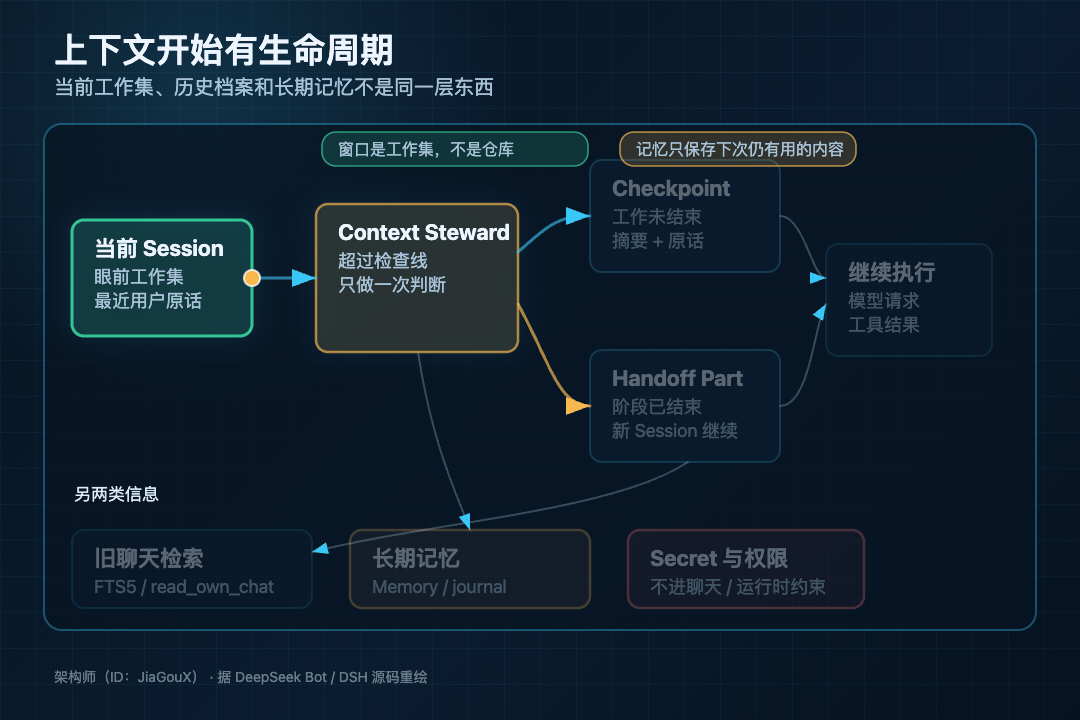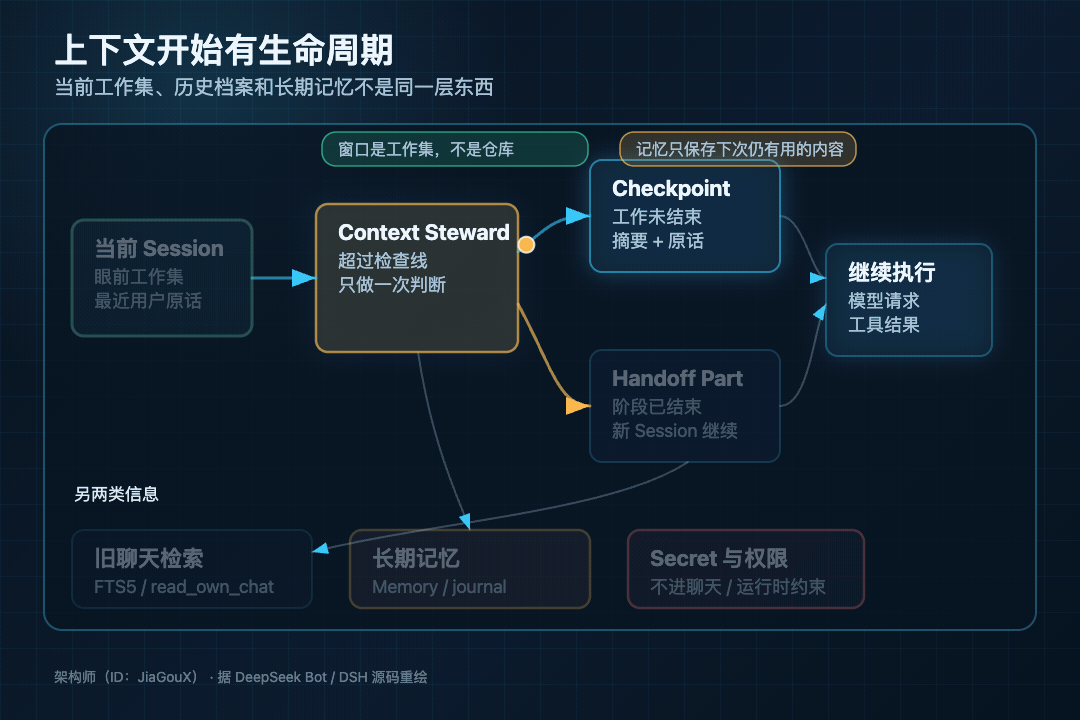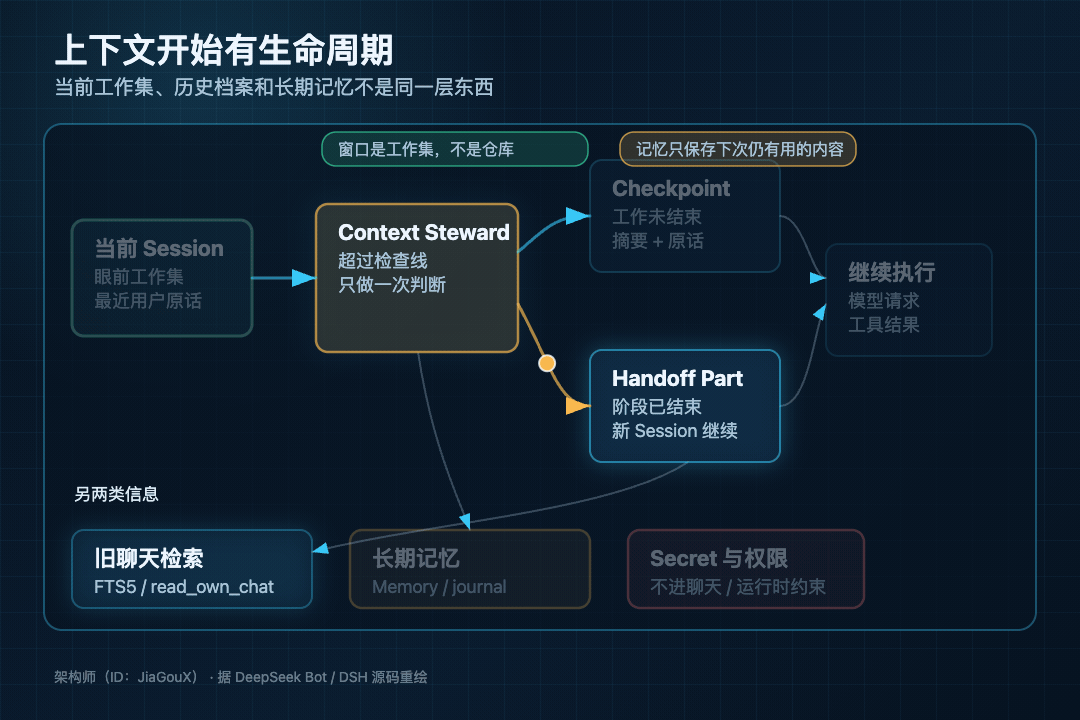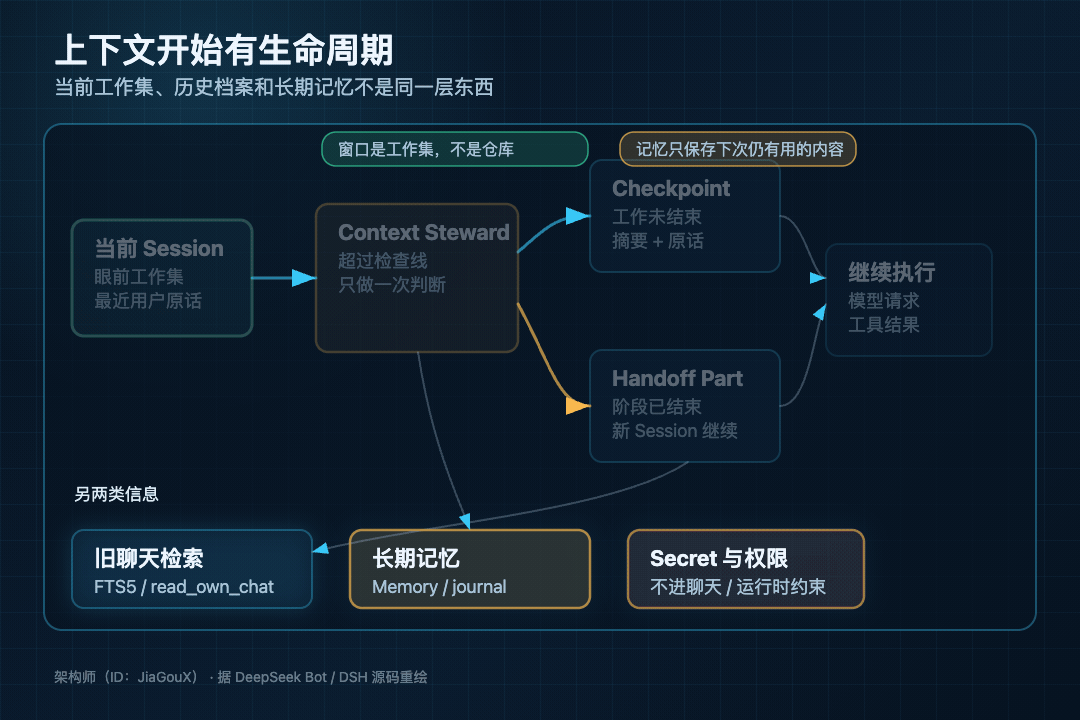
这里很容易把三件事混在一起:当前任务怎样继续、过去的细节怎样找回、跨会话应该长期记住什么。DeepSeek Bot 没把它们都叫作“记忆”,而是拆成了三层。
当前任务:checkpoint 还是新开一段
每个模型都有自己的上下文窗口。DS Bot 会根据模型报告的 contextWindow 计算可用容量;当一轮结束后超过检查线,默认是可用窗口的 80%,一个独立的小模型调用会充当 context steward。
它只做一次判断:
工作仍在进行,就把较早内容压成 checkpoint,在当前 Session 里继续; 工作已经到了阶段终点,就让 Bot 写 handoff note,切到新的 Session part。
为什么不统一做摘要?
因为“正在做一半”和“这一段已经做完”,需要保留的信息不同。前者更在意当前进度、依赖和下一步,后者更适合把成果与未竟事项交给新阶段。源码里甚至要求 handoff 保留完整路径、标识符、错误信息和仍未完成的请求,避免只留下泛泛的主题总结。
还有一个细节值得留意:checkpoint 不只保存模型生成的摘要。最近的用户消息会逐字跟在摘要后面。
摘要难免会压缩语气、约束和例外。把最近的用户原话一起带过去,相当于给压缩结果留了一块不经过二次解释的事实区。
旧聊天:需要时搜索,不必一直背着
被压缩的内容和更早的 Session part 不会消失。它们进入本地 SQLite FTS5 全文索引,Bot 需要时可以通过 read_own_chat 搜索自己的旧聊天。
这里的逻辑很像我们平时处理工作资料:桌面上只放当前文件,旧材料进档案,需要时再查。上下文窗口是工作集,不是仓库。
这也解释了为什么“无限增大 Context Window”并不能替代历史管理。窗口越大,重复发送的内容越多,真正重要的信息反而更容易淹没。可搜索的历史和当前上下文,本来就应该是两套东西。
长期记忆:只留下下一次仍然有用的内容
跨会话仍需保留的用户偏好、决定、纠正和事实,才会进入 Memory。
每个 Bot 有自己的记忆,团队还有一份共享记忆。MEMORY.md 保存每次对话都需要看到的内容,较长细节进入 topic 文件;journal.jsonl 记录每一次新增、替换和删除。
项目默认在每轮结束后做一次 memory review,由模型判断新内容是否值得保留。它还给单条记忆、主文件、topic 数量和总规模设置了上限,并拒绝看起来像 Key、Token 或证件号的内容。
另一个工程取舍是:Memory 在 Session 开始时冻结进系统提示。当前 Session 中途即使记忆更新,也不会反复改写已经稳定的提示词前缀;新内容在下一段或 checkpoint 后生效,同时可以立刻通过 recall 查到。
这样做牺牲了一点“刚写入就自动出现在系统提示里”的即时感,换来了更稳定的 Prompt Cache 和更可预测的会话状态。
三层放在一起就清楚了:
read_own_chat | ||
MEMORY.md |
这部分是我看完整个项目后比较认可的设计之一。
它没有发明一个无所不能的“超级记忆”,而是承认信息有不同寿命。能长期工作的 Agent,不只要会记,还要知道什么留在眼前、什么放进档案、什么才值得带到下一次会话。
第四层:能力经过运行时,不靠 Bot 自觉
Agent 只聊天时,出错大多是答得不好。一旦它能读文件、跑命令、访问网页和使用 API Key,错误就可能变成真实副作用。
这时再在提示词里写一句“请小心操作”,不太够。
DeepSeek Bot 把不少能力边界放回了运行时。这和我们前面几篇 Harness 文章的判断是一脉相承的:模型负责提出下一步,系统负责判断这一步能看到什么、能改什么、结果怎样留下来。
权限跟着 Bot 走
每个 Bot 可以选择 DSH 提供的权限预设,例如只读、工作区或完全访问。这份权限会应用到它自己的聊天、群聊 Session 和后续新建的 conversation part。
这意味着“Writer 能做什么”不只是角色描述,而是实际的工具边界。模型可以被诱导,提示词也可能被网页内容干扰,但运行时权限仍然是另一道约束。
浏览器有独立分区,而且目前只读
在 DSH Desktop 中,每个 Bot 有自己的浏览器存储分区,Cookie 和登录状态不会默认混到一起。read_browser 读取的是结构化 DOM,而不是只截一张图;密码、银行卡和一次性验证码字段的值不会被读取。
当前 read_browser 工具仍是只读:不能替用户点击、输入、滚动或打开地址。它也读不到跨域 iframe、Canvas 和关闭的 Shadow Root。
这看起来不够“自动化”,但从早期系统的风险控制看,先把读取边界做清楚,再逐步开放写操作,是比较稳的次序。
Secret 不进入聊天,但也不是绝对保险箱
Bot 需要 API Key 或 Token 时,会调用 request_secret,由界面显示一张 Secret 卡片。用户输入的值只会进入获准 Bot 的 Shell 环境,模型使用变量名;工具结果落盘前、请求发送给模型前,系统会把密钥原文替换成占位符。
源码和文档也没有把这件事说得过满。
Secret 保存在本地 secrets.json,采用原子写入和 0600 文件权限,但当前没有加密;遮盖依赖原文精确匹配,编码、拆分或反转后的值仍可能泄露;如果 DSH Web 通过局域网 HTTP 打开,Secret 还会明文经过网络。
“模型看不到输入框里的值”与“密钥绝不会泄露”是两件事。项目把这个差别写出来,比一句“本地运行,所以安全”更可信。
第五层:系统还得面对重启、损坏和并发写入
前面几层主要回答 Agent 怎样工作。再往下,还有一组更传统、也更容易被 AI 产品忽略的工程问题:状态文件坏了怎么办?两个进程一起写怎么办?Bot 删除了,后台任务还在怎么办?
这些细节决定系统能不能长期放着跑。
团队状态和会话事实分开保存
DS Bot 的 state.json 保存 Bot、群组、Bot 之间的消息、偏好和待回答问题;真正的聊天和执行历史仍由 DSH Session 保存,在默认的 ~/.dsh/sessions/ 下。全文索引、用量、Memory、Secret 和诊断日志也各有自己的文件。
这意味着备份不能只复制 bot/ 目录,否则团队配置还在,聊天事实却丢了。项目文档明确要求至少一起备份 bot/、sessions/ 和工作区存储。
这不是一个吸睛功能,却体现了边界:团队编排状态与执行事实有关联,但不是同一份数据。
通常只有一个写入者,但源码也保留了可用性退路
DSH Web 和 Desktop 默认共用 ~/.dsh。两个进程如果同时整份写回 state.json,后写的一方很可能把前一方的变化覆盖掉。
DeepSeek Bot 用 state.lock 协调写入。正常情况下,第一个加载团队的进程取得锁,另一个实例只读并跟随文件变化;持锁进程退出后,只读实例可以在下一次请求时接管。如果已经拿到锁,后来却发现所有权被另一个进程夺走,保存会以 ELOCKLOST 失败,不再继续覆盖。
当前 main 还有一个值得说清的例外:如果所在文件系统根本无法创建或使用锁,系统会告警,但仍允许保存。注释写得很直白——不能因为锁不可用,让整支团队完全停摆。代价也同样明确:这时如果两套 DSH 共用同一目录,彼此仍可能覆盖变化。
这不是严格意义上的分布式一致性,更像本地工具对可用性和数据风险的一次取舍。常规路径尽量守住单写者,异常文件系统下则把选择权交还给用户,同时留下明确告警。
状态损坏时尽量停住,不拿空数据覆盖
当前源码遇到格式损坏的 state.json 时,会先复制一份带时间戳的 broken 备份,再采用空的内存状态;如果连备份都无法完成、文件本身读不出来,或者数据来自更高版本,系统会停在只读状态,等用户修复或升级。
保存时先写临时文件,再原子重命名;如果中途丢失锁,写入失败,而不是继续覆盖。
这里没有一句简单的“全部 fail closed”。能留下损坏副本时,它优先让系统恢复可用;无法保留证据时,它才拒绝写入。这个分界挺务实:恢复不能以悄悄抹掉原文件为代价。
生命周期结束,后台任务也要跟着结束
当前 main 里有一个尚未随 0.1.2 发布的修复:过去删除 Bot 或群聊后,它早期 Session 上遗留的定时任务仍可能继续运行。现在删除主体时,会用 stopActivity 归档相关 Session,把其中已经挂起的定时任务一起停掉。
这件事看起来像普通 Bug,背后其实是一个很重要的生命周期问题:
执行者已经不存在,它创建的后台义务由谁接管?
如果系统答不上来,所谓“长期 Agent”就很容易变成一堆没人知道还在不在跑的任务。
它解决了“怎样协作”,还没有解决“怎样共同交付”
读到这里,很容易把 DeepSeek Bot 直接等同于一套完整的多 Agent 工作平台。我觉得还需要收一收。
从当前源码看,它做得比较扎实的是信息分区:每个 Bot 有自己的身份、私聊、群聊 Session、记忆、浏览器分区和权限;消息什么时候到、谁能看、出了问题怎样停,也有相对清楚的语义。
但工作分区还是另一回事。项目里还没有一套通用的共享任务账本,去描述任务依赖、负责人、产物版本、验收结果和交接状态;也没有替多个 Bot 解决同一份代码或文档的并发修改、冲突合并和最终发布。state.json 主要保存团队编排状态,不是项目管理系统,更不是事务型工作流引擎。
这并不削弱它的价值,只是帮我们放准位置:DeepSeek Bot 已经把“几个长期 Bot 怎样在一套 Harness 上说清楚、接得住、停得下”做出了轮廓;“它们怎样围绕同一份交付物并行工作,而且最后还能合得回来”,还需要外部仓库、任务系统、验证流程和发布机制接住。
换句话说,它更接近一个可运行的个人 Agent 团队底座,还不是一座无人值守的软件工厂。
多 Agent 的成本,主要花在重复上下文和协调上
聊到这里,还要回到一个不太热闹的现实:多 Agent 很贵。
DeepSeek Bot 自己就在 README 里提醒,群聊会明显增加 Token 消耗。它提供 Usage 页面,可以按时间、Bot 和模型查看 Token,但当前只统计 Token,不直接换算成本。
Anthropic 在多 Agent 研究系统的复盘中提到,他们的多 Agent 系统平均消耗的 Token 约为普通聊天的 15 倍,单 Agent 也约为普通聊天的 4 倍。这个数字来自另一套系统,不能直接套到 DeepSeek Bot 上,但它把成本来源说得很直白:并行 Agent 不只各自推理,还要重复读取上下文、互相交接、汇总和校验。
而且,并非所有任务都适合并行。
开放式研究可以拆成相对独立的搜索方向,各 Agent 少量共享中间结果就能推进。代码任务通常共享同一份状态,修改之间还有依赖,盲目增加 Agent 更容易产生冲突和重复劳动。
我自己看多 Agent,通常先看任务里有没有真正独立的工作面:
是否可以让不同 Bot 使用不同上下文、模型或工具; 子任务之间是否大部分时间能独立推进; 汇总成本是否低于一个 Agent 串行完成的成本; 是否有明确的交接结果,而不是把整段聊天来回复制。
这些条件如果不成立,一个能力更完整、上下文更干净的单 Agent,往往更省事。
DeepSeek Bot 默认让管理员接住普通消息、其他成员按需加入,再配合 [PASS]、消息跳数限制和用量统计,可以看成对成本问题的一次正面回应。它没有证明 Bot 越多越好,只是在搭一套“确实需要多人时,怎样少浪费一点”的基础设施。
从源码回看:它补的不是头像,而是五段运行链路
把界面拿掉,DeepSeek Bot 做的事情可以收敛成一条很朴素的链路:
定义 Bot → 进入 Session → 路由协作 → 延续上下文 → 约束副作用
沿着这条链路,又能看到四笔长期账:
消息路由贯穿四笔账,成本和可观测性则在外面给它们加了一道现实约束。
把这些代码放在一起,我最后留下的判断是:
多 Agent 从演示走向可运行系统,不是从 3 个角色增加到 10 个角色,而是从“模型愿意怎么聊”走向“运行时明确管理每一次状态变化”。
身份由谁创建,消息投给谁,上下文何时压缩,记忆怎样更新,工具按什么权限执行,状态由谁写入,主体删除后任务怎样收尾——这些事情越少依赖模型临场发挥,系统才越接近可运行。
最后
DeepSeek Bot 现在仍然很早。
DSH 是 alpha,插件是 v0.1 preview;浏览器只能读,Secret 还没有加密,群聊 Token 开销不低,数据格式和工具也可能继续变化。把它当成成熟的 Personal Agent 平台,还为时过早。
不过,把它当成一份“怎样把多 Agent 落到 Harness 上”的开源样本,它很值得读。
它没有用一个庞大的新框架包住 DSH,而是在已有 Session、Agent Loop、工具和插件机制上,补身份、路由、上下文生命周期和本地状态管理。很多设计甚至不显眼:一把锁、一份 journal、一个 [PASS]、一次原子重命名、删除主体时顺手清掉后台任务。
这些细节不会让 Demo 更华丽,却会让系统少一点含糊。
回头看,今年我们写 Harness、Loop、Context、State 和 Memory,讲的其实一直不是怎样让 Agent 显得更聪明,而是怎样让它做过的事不含糊。DeepSeek Bot 又补上了一块:当 Agent 不止一个,身份、消息和停止语义也得进入系统。
Personal Agent 真正的分水岭,也许不是它今天能不能回答一个复杂问题,而是明天回来时,它还能不能说清:
我是谁,事情做到哪里,依据还在不在,下一步能做什么,又有哪些事情不该由我做。
DeepSeek Bot 还没有把这几个问题全部解决,但至少没有继续把它们留给提示词和模型临场发挥。
这比多几个会动的头像,更有意思。
参考资料
DeepSeek Bot 项目 (https://github.com/Fei2411/DeepSeek-Bot)
@Zhuangxg:关于群聊默认管理员与有效协作的讨论(https://x.com/Zhuangxg/status/2108981572657701067) DeepSeek:DeepSeek Harness Sessions 文档(https://github.com/deepseek-ai/deepseek-harness/blob/master/docs/subsystems/session.md) DeepSeek:DeepSeek Harness Architecture(https://github.com/deepseek-ai/deepseek-harness/blob/master/docs/architecture.md) Anthropic:Building Effective AI Agents(https://www.anthropic.com/engineering/building-effective-agents) Anthropic:How we built our multi-agent research system(https://www.anthropic.com/engineering/multi-agent-research-system) 《模型越来越强,为什么大家却开始重写 Harness》(2026-03-28) 《多 Agent 不是虚拟公司:从 Anthropic 五种模式看信息流怎么设计》(2026-04-18) 《Pi 与 DeepSeek Harness 架构对比:Agent Loop 如何处理继续、收口与恢复》(2026-10-01) 《从 Claude Code 到 Codex:Coding Agent 的 Harness》(2026-10-08)
如喜欢本文,请点击右上角,把文章分享到朋友圈
如有想了解学习的技术点,请留言给若飞安排分享
因公众号更改推送规则,请点“在看”并加“星标”第一时间获取精彩技术分享
·END·
相关阅读:
- 从 LLM 到 Agent 到 Harness:真正复杂的是运转起来之后
- Claude 做方案,Codex 写代码:多模型协作怎么交接才稳
- CLAUDE.md 拆解:Agent 进仓库前的上下文入口
- Loop Engineering,应该赞成还是反对?
- 架构排熵:Loop Engineering 的持续清理系统
- 设计 Self-Harness 架构:会自我改进的Harness
版权申明:内容来源网络,仅供学习研究,版权归原创者所有。如有侵权烦请告知,我们会立即删除并表示歉意。谢谢!
架构师
我们都是架构师!
关注架构师(JiaGouX),添加“星标”
获取每天技术干货,一起成为牛逼架构师
技术群请加若飞:1321113940 进架构师群
投稿、合作、版权等邮箱:admin@137x.com