ARTICLE · 1165123
Linux 6.12 源码深度剖析: call_rcu
异步 RCU 回调注册机制:Linux 6.12 call_rcu
📌 技术点速览
在 Linux 内核中,call_rcu 是 RCU(Read-Copy Update)子系统的核心异步 API,属于 CoreKernel (内核核心服务) 模块。它解决了在不阻塞当前执行流(无锁/非阻塞)的前提下,安全地延迟释放已被废弃的内存数据结构的问题。
在单核(UP)系统或配置了 CONFIG_TINY_RCU 的嵌入式内核中,call_rcu 负责将待释放的内存节点挂载到全局 RCU 链表上,并通过调度器协同,确保系统在经历“宽限期(Grace Period)”后,安全地在软中断上下文中调用回调函数。
🗺️ 软件功能架构图
1. 模块调用与拓扑关系图
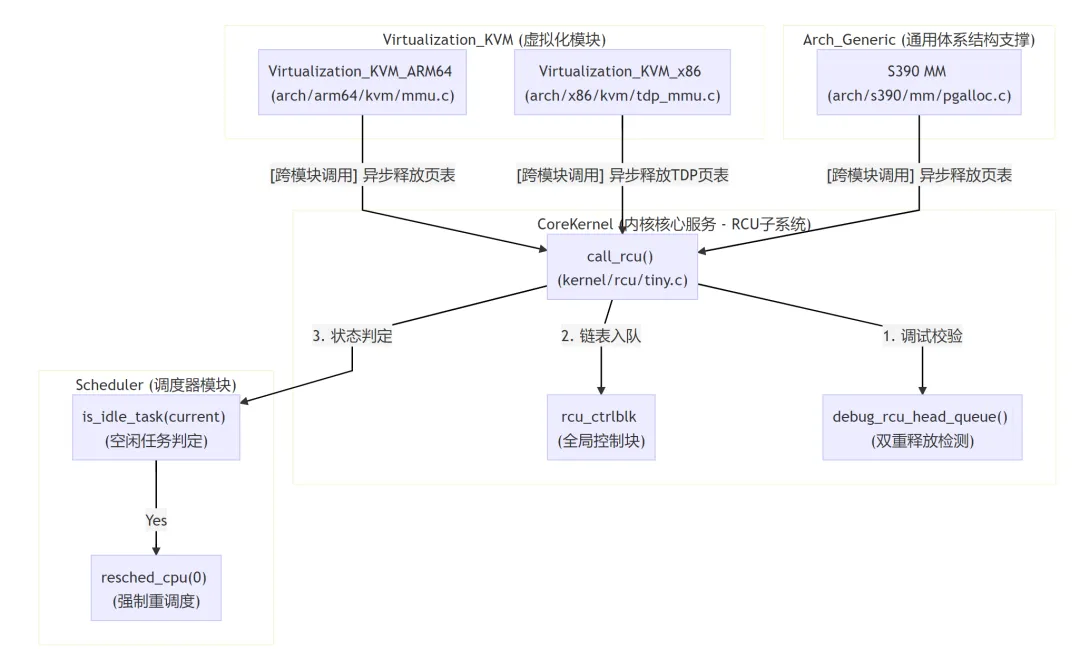
以下展示了 CoreKernel 模块中的 RCU 子系统如何与虚拟化模块(KVM)、通用体系结构支撑模块(Arch_Generic)以及调度器模块进行跨模块协同。
2. 跨模块生命周期时序图
🔍 核心源码硬核解析 (基于 Linux 6.12)
在单核或 Tiny RCU 架构下,call_rcu 的实现位于 kernel/rcu/tiny.c。以下是该函数的完整源码及深度逐行解析:
voidcall_rcu(struct rcu_head *head, rcu_callback_t func){static atomic_t doublefrees; // 静态变量:用于限制双重释放错误日志的打印频率unsigned long flags;/** 1. 调试与安全防御机制 (CoreKernel 模块的安全职责)* debug_rcu_head_queue() 用于检测当前 rcu_head 是否已经被挂载在 RCU 队列中。* 如果已被挂载,说明发生了严重的 Double-Free (双重释放) 漏洞。*/if (debug_rcu_head_queue(head)) {// 限制错误日志打印次数,防止日志洪泛(Flood)导致系统死锁或日志溢出if (atomic_inc_return(&doublefrees) < 4) {pr_err("%s(): Double-freed CB %p->%pS()!!! ", __func__, head, head->func);mem_dump_obj(head); // 打印该内存块的详细元数据信息(如属于哪个 slab 缓存)}// 如果不是 kvfree_rcu 的特殊偏移,则将回调函数重定向到泄漏回调函数,防止执行恶意代码if (!__is_kvfree_rcu_offset((unsigned long)head->func))WRITE_ONCE(head->func, tiny_rcu_leak_callback);return;}// 2. 初始化 rcu_head 节点head->func = func; // 绑定用户传入的回调函数(例如 KVM 的页表释放函数)head->next = NULL;/** 3. 核心链表入队操作 (无锁队列的单核简化版)* 因为 Tiny RCU 运行在单核(UP)系统上,不存在多核竞争。* 此时,只需通过禁用本地中断 (local_irq_save) 即可实现对全局链表 rcu_ctrlblk 的互斥访问,* 防止当前上下文被硬中断或软中断打断导致链表破坏。*/local_irq_save(flags);/** 【二级指针妙用解析】:* rcu_ctrlblk.curtail 是一个二级指针 (struct rcu_head **),指向链表中最后一个节点的 next 指针。* *rcu_ctrlblk.curtail = head;* 相当于把上一个节点的 next 指针指向了当前新插入的 head 节点。*/*rcu_ctrlblk.curtail = head;/** 更新 curtail,使其指向当前新插入节点的 next 域的地址。* 这样下一次插入时,可以直接通过 *curtail 挂载,实现了 O(1) 的无分支链表尾插法。*/rcu_ctrlblk.curtail = &head->next;local_irq_restore(flags); // 恢复中断状态/** 4. 跨模块协同:与调度器 (Scheduler) 交互* 如果当前执行上下文是 Idle 任务(空闲进程),说明 CPU 处于空闲状态。* 在 Tiny RCU 中,Idle 进程不会主动触发上下文切换,这会导致 RCU 宽限期(Grace Period)无限延长。* 因此,必须强制触发一次重调度,迫使 CPU 退出空闲状态并经历一次静止状态(Quiescent State)。*/if (unlikely(is_idle_task(current))) {/* 强制对 CPU 0 进行重新调度,以触发 rcu_qs() 静止状态上报 */resched_cpu(0);}}
💡 核心设计模式:二级指针尾插法
在 kernel/rcu/tiny.c 中,RCU 链表管理采用了一种极其优雅的二级指针设计:
struct rcu_ctrlblk {struct rcu_head *rcucblist; /* 链表头 */struct rcu_head **curtail; /* 指向最后一个节点的 next 域的指针 */};
当链表为空时,rcu_ctrlblk.curtail 指向 &rcu_ctrlblk.rcucblist。 当插入第一个节点 A 时:
*curtail = head实际执行了rcucblist = A。curtail = &head->next使得curtail指向了A->next的地址。
这种设计完全消除了链表为空时的特殊分支判断(if (list == NULL)),在极其注重性能的内核核心路径中,减少了分支预测失败的开销。
⚙️ 系统运行背景与上下文
1. 跨模块协同机制
call_rcu它是 CoreKernel (内核核心服务) 与 Virtualization (虚拟化)、Scheduler (调度器) 之间的高速公路。作者主要结合虚拟化场景进行举例说明。
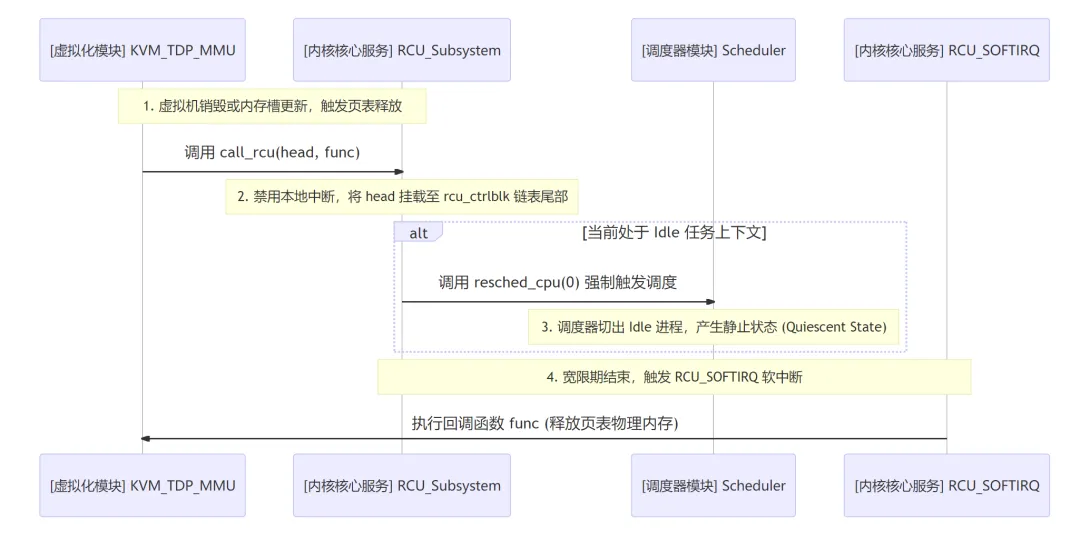
Virtualization_KVM_x86 (x86虚拟化): 在 TDP(Two-Level Page Walking)MMU 中,当虚拟机(Guest)销毁或内存槽(Memslot)发生变化时,KVM 需要释放大量的影子页表(Shadow Page Table)。如果直接在 vCPU 线程中同步释放,会导致 vCPU 出现明显的卡顿(Latency Spike)。 因此,KVM 模块调用
call_rcu,将页表释放任务挂载到 RCU 链表上,立即返回。这使得 vCPU 可以继续运行,而实际的物理内存释放则延迟到系统空闲时进行。Scheduler (调度器模块): RCU 的生命周期依赖于“静止状态(Quiescent State)”。一次上下文切换(Context Switch)就是最典型的静止状态。 如果
call_rcu被 Idle 任务调用,RCU 子系统会通过resched_cpu(0)跨模块向调度器发送请求,强制调度器介入。调度器切出 Idle 进程的过程,自动向 RCU 报告了静止状态,从而推动了宽限期的结束。
2. 宽限期与回调执行流程
[ call_rcu 注册 ]│▼[ 挂载到 rcu_ctrlblk ]│▼[ 调度器发生上下文切换 ] ───► (上报 Quiescent State)│▼[ 宽限期 (Grace Period) 结束 ]│▼[ 触发 RCU_SOFTIRQ 软中断 ] ───► 执行绑定的 func (如 kvm_mmu_free_page)
💡 10年老兵避坑指南/实战案例
🚨 案例一:KVM 频繁卸载导致 RCU 回调积压与 OOM 崩溃
1. 生产环境现象
在超大规模物理机上,频繁创建和销毁含有巨量内存(如 1TB RAM)的虚拟机时,系统突然发生 OOM(Out Of Memory),且 kswapd 进程 CPU 使用率达到 100%。通过 crash 工具分析内存,发现 struct rcu_head 占用了数 GB 的内存,且绝大多数回调函数指向 kvm_mmu_free_page。
2. 原因剖析
KVM 在销毁虚拟机时,通过 call_rcu 异步释放 TDP 页表。然而,由于 Tiny RCU 或未配置 rcu_nocbs(无回调 CPU)的 Tree RCU 在高负载下,软中断(RCU_SOFTIRQ)的执行优先级低于高频的 vCPU 线程。 这导致 RCU 回调函数的注册速度(KVM 侧)远远大于回调函数的执行速度(RCU 侧)。未处理的 rcu_head 及其关联的页表内存无法释放,最终撑爆系统内存。
3. 调优与排查方案
ftrace 追踪回调积压: 使用
trace-cmd或sysfs接口追踪 RCU 队列长度:
echo 1 > /sys/kernel/debug/tracing/events/rcu/rcu_batch_start/enablecat /sys/kernel/debug/tracing/trace_pipe | grep "kvm_mmu_free_page"
内核参数调优: 在多核生产环境中,必须将 KVM 相关的 RCU 回调卸载到专用的后台内核线程(kthread)中执行。在内核启动命令行中加入:
# 将 CPU 2-15 的 RCU 回调卸载,避免抢占 vCPU 运行时间rcu_nocbs=2-15
同时,提高 RCU 抢占步长,加速宽限期收敛:
sysctl -w kernel.sysrq=1# 强制触发 RCU 摊牌检测echo q > /proc/sysrq-trigger
🚨 案例二:Double-Free 导致的内核 Panic 与安全漏洞
1. 生产环境现象
内核在运行过程中突然触发崩溃,报错信息如下:
BUG: unable to handle page fault for address: ffff888100234000IP: call_rcu+0x45/0x120Call Trace:[<ffffffff810e3450>] kvm_destroy_vm+0x120/0x2a0
2. 原因剖析
在 KVM 或自定义驱动开发中,某个数据结构(如 struct kvm_mmu_page)在生命周期管理上出现混乱。该结构体被释放了两次,即连续调用了两次 call_rcu(&page->rcu_head, kvm_mmu_free_page)。 在第一次 call_rcu 后,rcu_head 已经挂载在全局链表中。第二次调用时,如果不做校验,其 next 指针会被强行修改,导致全局 RCU 链表形成环路(Circular List)。当 RCU 软中断遍历链表执行回调时,会陷入死循环,或者访问已被释放的野指针,引发内核 Panic。
3. 避坑与排查方案
启用 RCU 调试选项: 在开发和测试阶段,必须开启内核的 RCU 链表调试功能。修改内核编译配置文件
.config:
CONFIG_DEBUG_OBJECTS=y CONFIG_DEBUG_OBJECTS_RCU_HEAD=y 开启后,call_rcu 内部的 debug_rcu_head_queue(head) 将会生效。一旦检测到重复挂载,内核会立即打印:
call_rcu(): Double-freed CB ffff888100234000->kvm_mmu_free_page()!!! 并自动将回调函数替换为 tiny_rcu_leak_callback,从而阻止了链表成环,将一次致命的内核崩溃降级为可控的内存泄漏,极大地提升了系统的安全性和可调试性。