ARTICLE · 1165860
没源码也能复刻软件- REA逆向工程一切
没源码也能复刻软件- REA逆向工程一切
终端、二进制、几个像素大字——这是这周让不少开发者睡不好的画面。 先讲一件小事。前两天,一个做独立开发的朋友甩给我一张截图,是他盯了很久的一款笔记软件,他想要里面那个离线搜索,秒出结果那种。 搁以前,这事基本到此为止:没源码,没文档,只能照着截图猜。 但这次他没猜。他把软件丢给 AI,说了句“搞懂它怎么搜索的,再给我写一个”。四十分钟后,他拿到一份能跑的代码,还附带了原软件里每一步对应的函数位置。 10月6日,它还不到1万星;10月12日,仓库页面已经显示12.1万星。 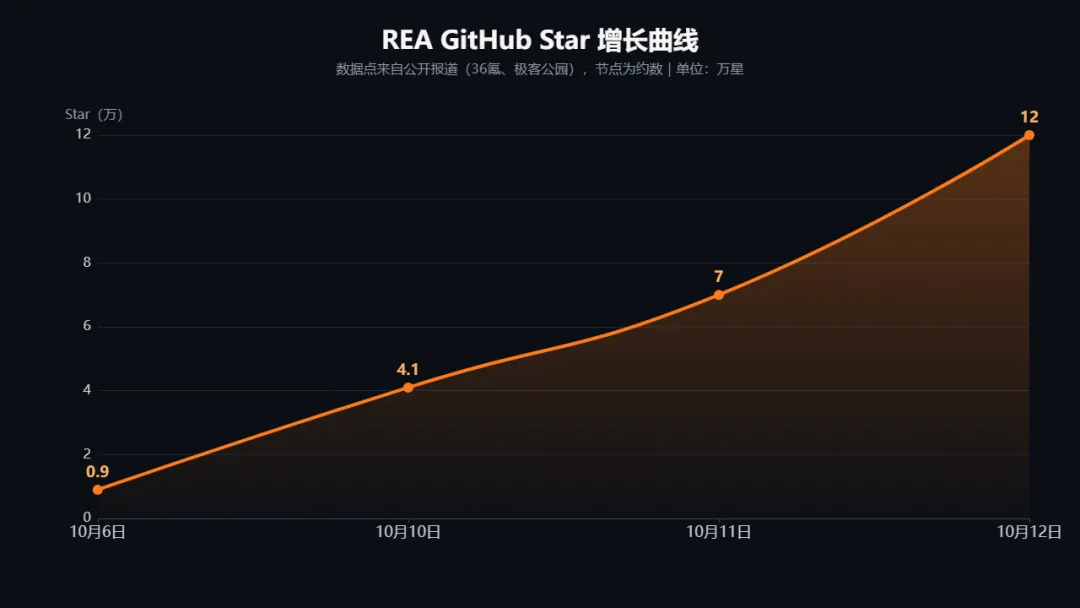
这话不算夸张。过去四十年,商业软件有相当一部分底气,建立在“你拿不到源码”上:代码编译成二进制,你看不懂,所以得买。REA 动的,就是这个前提。 先讲清楚,REA 自己不是大模型,也不会凭空写代码。 它是个用 TypeScript 写的开源工具(MIT 协议),干的活更像一个“调度员”。通过 MCP 这种让 AI 调用外部工具的协议,它把一整套逆向软件接到 Claude Code、Codex、Cursor、Gemini CLI 这些编程助手身上,让 AI 自己去调用。 这些工具没一个是新的。IDA 上世纪九十年代就有了,Hopper 能追溯到 2011 年,Ghidra 是 2019 年开源的。REA 做的,是把过去要人肉来回切的步骤,接进 AI 的工作流。 安装也确实简单,一行 npx rea-agents setup,选好助手、点确认就行。这也是它和专业工具最大的区别:你几乎不用懂逆向。 拿官方的例子说,你让它“逆向笔记软件,搞清楚离线搜索怎么工作,然后用 TypeScript 和 SQLite 给我写一个”。 后台大致是这样:先打开、识别这个程序;搜字符串和函数名,找跟“搜索”有关的线索;顺着线索查谁调用了它、它又调用了谁;把调用图和控制流拼出来;再把相关函数反编译成伪代码;最后,AI 拿着这些证据,在你的项目里写一个新的。 关键在“证据”两个字。它给出的每一条结论,后面都挂着二进制里的位置,不是凭空猜的。 第一个是官方的,三十年前的打砖块游戏 DX-Ball。 游戏里有个音效逻辑:球在左边被撞,声音偏左;飞到右边,声音跟着右移。这段计算藏得很深,伪代码还残缺。REA 一路追,把它还原成了 C。 结果:重建版本通过了 3205 个原始 x86 测试,编译后的 63 个函数,和原版一个字节都不差。 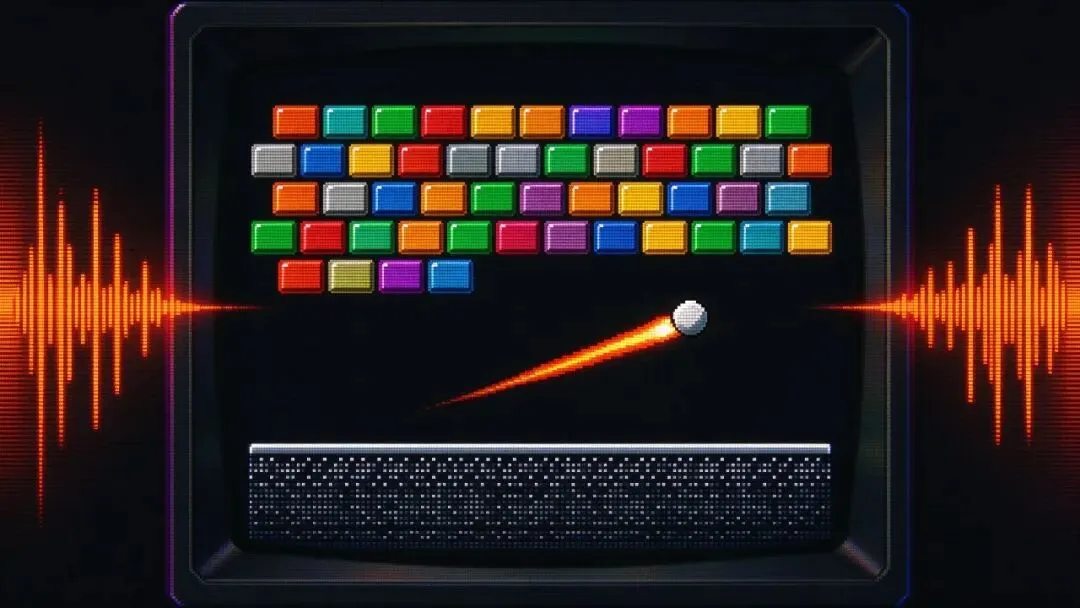
球在哪边、声在哪边,三十年前的细节被逐帧找了回来。 第二个更狠,来自一位资深安全人员,今年4月用 Cursor 加 Claude Opus 做的,工具不是 REA,是 Ghidra MCP,但思路一样。 游戏他随手就拆了:Cocos2d 的游戏,纯静态分析认出了 Blowfish 加密,反推出 key;Unity 的游戏,靠观察密文特征猜 Lua 注释格式,反推出 XOR key。 真正意外的是银行 App。多层加壳、混淆,反注入、反调试、root 检测、模拟器检测,一整套。AI 一层层绕过去,最后在 root 过的模拟器里把 App 跑起来、抓到了请求。 成本可能比你想的便宜:多数 App 三十分钟左右,按 Cursor 计费不到 5 美元;一个 Unity 游戏用 Claude Code 烧了 4000 万 token,大概 27 美元。平均三十美元上下。 他自己说了句话,我觉得比案例本身更值得记住:“那一刻我才意识到,我才是 AI 的限制器。”以前觉得 AI 办不到,其实是他自己不敢让它试。 大模型帮忙逆向,已经走了好几年。 2022年,纽约大学和卡尔加里大学的团队发过一篇论文,标题很直白:《Pop Quiz! Can a Large Language Model Help With Reverse Engineering?》。他们测 Codex 读反编译伪代码、判断函数用途,算开了先河。不过那时候 AI 还只是个“阅读理解外挂”,要你手动复制粘贴。 往后分成两条路。一条以南科大开源的 LLM4Decompile 为代表,想绕开传统引擎,直接把机器码翻译成 C;另一条就是 REA 这种,在大模型和 Ghidra、IDA 之间架桥,让 AI 长出“手和眼睛”,自己提符号、追调用、写代码。 REA 是第二条路里,名字最响、门槛最低的那一个。 两样。 一是硬壳。没加壳的随便拆,轻度加壳也能磨,碰到 VMP 这种高强度虚拟化保护,现在照样卡住。混淆会让代码残缺,AI 也会看走眼。 二是服务器里的东西。它能翻的,只是你手上的安装包。支付风控、推荐算法、账户体系、关系链,都在人家机房里;抓到包,也只看到请求和响应,看不到背后的逻辑。 技术专家徐昊的说法很直接:克隆能拿走代码,拿不走知识。他的原话是“软件本身不是产品,软件中的知识才是”。把一段代码重演出来,意义不大;真正难的是搞清楚它为什么这么设计、业务规则是什么、哪些是刻意的、哪些是历史包袱。 QuickCreator 的联合创始人阎志涛举了个反证:“如果源码一旦能拿到,软件生意就没法做,那开源软件的商业模式早就不存在了。” Red Hat 就是现成的例子。它的代码谁都能下载,可企业照样为订阅付费,买的是生命周期管理、兼容性、补丁更新、出问题时有人接。你当然可以自己组团队干,但招聘、培训、让团队长期在,都是成本。 说穿了,写代码从来不是护城河。客户关系、社区、对需求的理解、长期把系统跑稳的能力,才是。 护城河没消失,只是从“你看不到我的代码”,挪到了“你拿不走我的服务和业务理解”。 REA 最诱人的一句话是“为你的项目实现类似功能”。但“研究它”和“照着做一个”,在法律上是两回事。 先让人安心的部分: 问题出在“怎么写出来的”。 行业里有套老办法,叫净室开发:一组人拆竞品,只写功能说明书;另一组从没看过对方代码的人,照着说明书从头写。中间隔一道墙,这道墙就是以后打官司时证明“我没抄”的证据。 REA 把这道墙拆了:读反编译代码的是这个 AI,写新代码的还是它,中间没有任何隔断。 
读的是它,写的还是它,中间那道墙,形同虚设。 Hacker News 上有人把这叫“洗知识产权”。一个复刻 Photoshop 的团队,直接禁止成员用 Ghidra 和 REA,理由很朴素:怕被告。 国外也有判例。2003 年美国 Bowers 诉 Baystate,法院认定软件许可里“禁止反编译”的条款有效,做竞品的赔了钱。欧盟则反过来,为了互操作反编译,合同里禁止也是无效。同一件事,换个地方,答案不一样。 还有一层更隐蔽的:REA 确实在本地跑、不上传,但 AI 要理解这些分析,就得把反编译出来的代码片段、字符串发给背后的模型服务商。如果你拆的是客户交付、签过保密协议的东西,这一步可能已经违约。 数一下三方:项目方免责,责任在你;模型商会拦你,但标准不透明;软件公司握着用户协议和律师。真正站在风险正中间的,只有发出指令的那个人。 REA 是把快刀。它能帮安全研究员更快找漏洞,帮人救活没有源码的老软件,也能让黑产没日没夜地分析校验逻辑。 工具本身没善恶,但后果算在人头上。 普通用户不用慌,账户安全主要靠服务端风控,一个反编译工具动不了。对开发者,逆向老兵 Elias 那句话还是要记住:只要程序跑在用户手里,就可能被拆开,关键逻辑往服务器放。 至于“软件完蛋了”这种说法,我倒觉得太早。开源跑了这么多年,Red Hat 们照样活得很好。真正会受冲击的,是那些只靠“你看不到我代码”收钱、却没有服务、不懂业务的公司。 能被复刻的是代码,复刻不走的,是别的东西。 如果 REA 摆你面前,你最想拆哪个软件?评论区聊聊,只许研究,别动手复刻。#rea#逆向工程
没源码也能复刻软件?REA 12 万星背后,代码不再是护城河
帮他做到这件事的,是这周 GitHub 上最火的项目:REA,Reverse Engineer Anything。
先说说,它火到什么程度
对比一下,年初全民“养龙虾”的 OpenClaw,爆发第三天才累计新增6万星。
Replit 的 CEO Ahmad Msad 说了句挺重的话:“AI 驱动的逆向工程和反编译,正在发生的事情简直不可思议。很快,所有软件都可能事实上变成开源软件。”
那它到底是个什么东西
它覆盖的范围,比“反编译”三个字宽:
原生程序,Windows 的 exe、Mac、Linux,能读出伪代码、汇编、字符串、符号和调用关系,连 Swift、Objective-C 的元数据都能理; ZIP、APK、IPA、ASAR 这些压缩包,不用解压就能列出清单; Electron 和 JavaScript 应用,不用运行,静态梳理入口、模块、IPC 通道、preload 脚本; 网站,通过你本地的 Chrome DevTools 被动观察; .NET 程序,不用执行就能看元数据和原生代码边界; 还能比较同一款软件的两个版本,告诉你改了什么。
它具体是怎么干活的
真有那么神?看两个硬例子
但这事,不是突然发生的
那它有什么拿不到的
所以更值得聊的是:如果代码能被复刻,软件公司的护城河到底在哪?
最后,得说说那条法律红线
《计算机软件保护条例》第十七条,允许为了学习、研究软件的设计思想和原理去使用它; 《著作权法》第五十条,把“计算机软件反向工程研究”列为可以避开技术措施的情形; 而且版权保护的是代码怎么写,不保护功能本身,你自己从头写一个功能相似的,并不侵权。