ARTICLE · 1165850
一夜丢出722篇数学论文!OpenAI掀起学术界大地震:菲尔兹得主直呼像被卡车碾过
数学界的天,突然塌了
这项成果未做任何学术预热,也未经受过同行评审。
北京时间 10 月 6 日,OpenAI 在其 GitHub 官方主页上,无预警地扔下一枚震撼弹,一个名为 openai/math 的公开仓库。
仓库里,整整齐齐地码放着 722 篇数学手稿,涵盖 372 个核心数学问题家族。从代数几何到数论,从偏微分方程到拓扑学,几乎横扫了当今纯数学最硬核的十几条前沿战线。
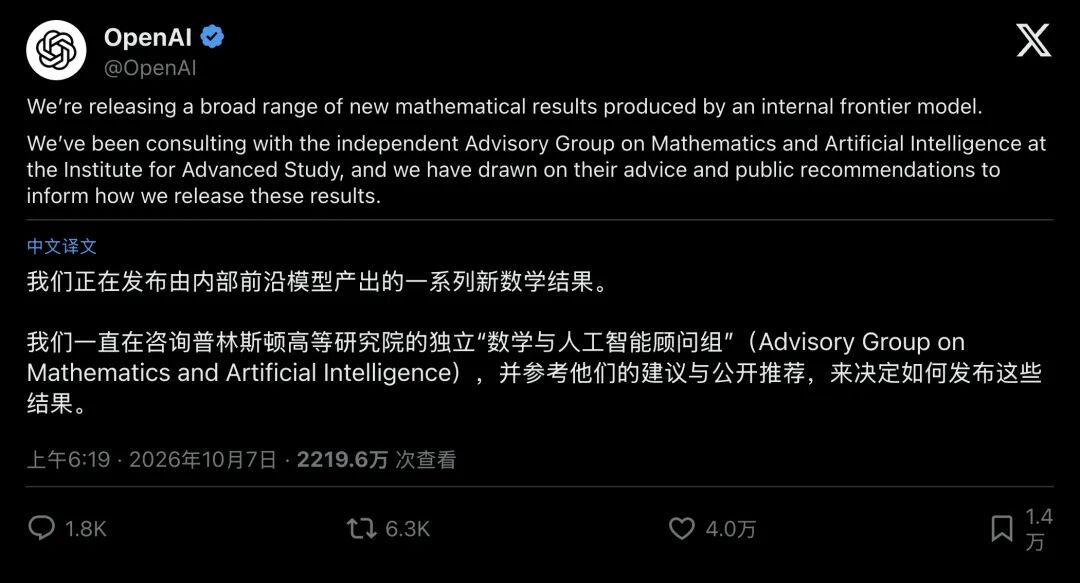
▲ OpenAI官方发帖宣布:由未公开前沿模型产生的大批数学成果正式上线
OpenAI 官方轻描淡写地表示:这批成果来自一个“未公开的内部前沿模型”。
模型平均每攻克一个足以让人类学者耗费数年心血的命题,仅仅消耗了相当于 3 个小时 ChatGPT Pro “思考模式”(thinking)的算力。
3 个小时,换人类学者的一生
消息一出,整个学术界被彻底打懵
菲尔兹奖得主雨果·迪米尼尔-科平(Hugo Duminil-Copin)在接受采访时,用了一种近乎虚脱的语气形容自己的感受:
“大量我在演讲、论文和基金申请里当作未来几年研究方向的问题,似乎在一夜之间全被解决了。那种感觉……就像被一辆重型卡车迎面碾过。”
《大西洋月刊》更是毫不客气地在头条打出大字标题:《OpenAI 刚刚对数学界进行了地毯式轰炸》。
▲ 《大西洋月刊》报道:OpenAI 对纯数学界展开了“地毯式轰炸”
然而,这场看似人类科技史上的巅峰奇迹,却在短短 48 小时内,急转直下成了一场席卷全球学界的愤怒抵制与伦理海啸。
0124小时翻车:一个正负号,三篇大论文当场暴毙
最先戳破这层光环的,是来自真实数学世界的冰冷重锤。
大模型生成的手稿,文笔流畅、推导华丽、符号密布,看起来就像顶级学术期刊的定稿。但纯数学这个领域,有着人类所有知识体系中最残酷的一条铁律:
在逻辑的世界里,只要错一个符号,整座大厦就会瞬间粉碎。
就在发布后的第二天,眼尖的学者们在翻阅其中一篇关于“分裂阿贝尔八维簇”的手稿时,赫然发现:模型在一个极其关键的推导步骤中,把正负号搞反了。
一个微小的符号错误,导致核心证明链条彻底断裂。
而且由于这批论文之间存在相互引用的推导关系,这个致命的符号错误像多米诺骨牌一样,瞬间带崩了另外两篇配套论文。
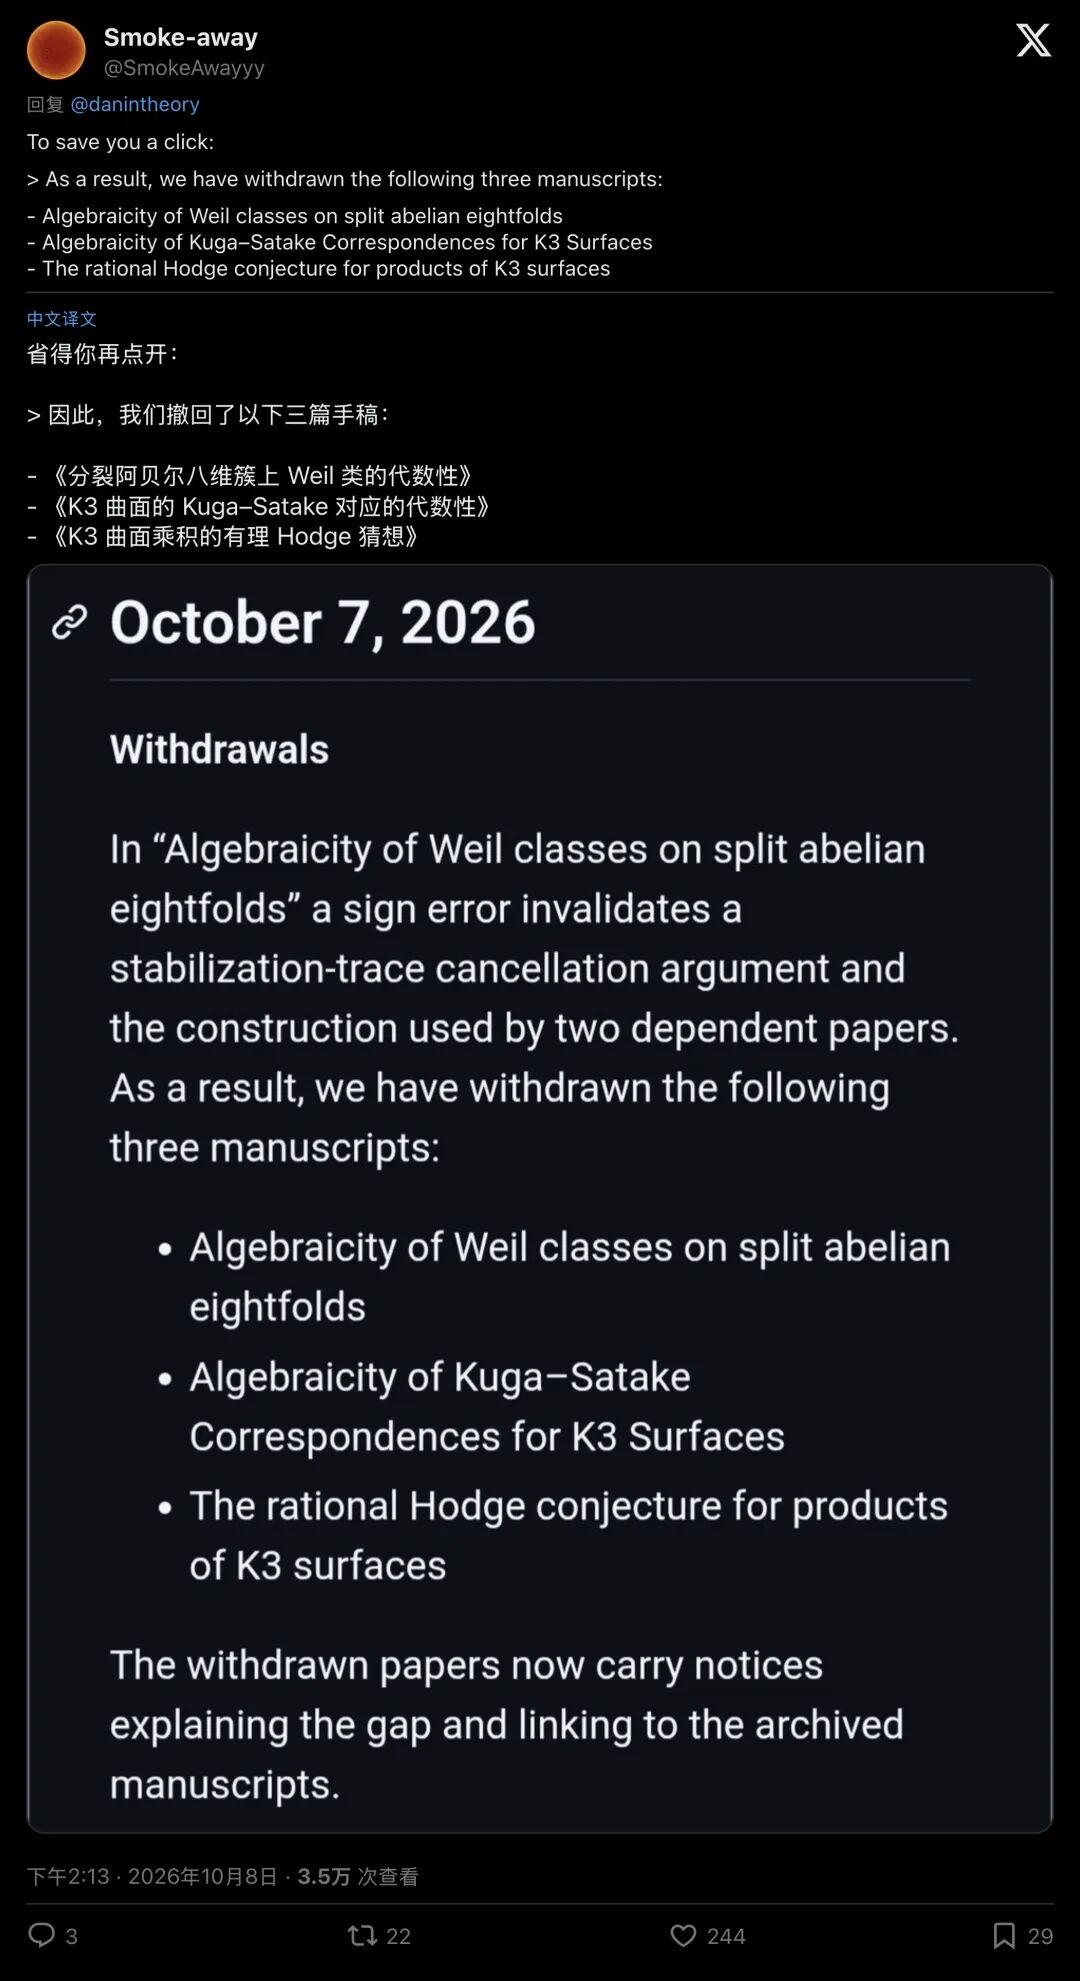
▲ 推特用户列出 OpenAI 紧急撤回的三篇重量级手稿
10 月 8 日,OpenAI 科学家丹·罗伯茨(Dan Roberts)紧急出面收拾残局,在社交平台上灰头土脸地宣布:撤回 3 篇手稿,并对另外 14 篇进行紧急修补。
曾经在软件工程里屡试不爽的“敏捷开发、小步快跑、线上打补丁”,被原封不动地搬进了数学殿堂。
推特上有学者当场讽刺:“真是大开眼界,人类几千年来的数学证明,现在居然像手机 App 一样发版修 Bug 了。”
这仅仅是冰山一角
很多人可能不知道,为了防止大模型产生胡言乱语的“幻觉”,数学界目前最信赖的工具叫做 Lean。
你可以把 Lean 理解为数学界的“计算机编译器”。如果人类数学家用自然语言写成的证明是一篇散文,那么把证明翻译成 Lean 代码,让计算机一步一步去死磕校验,只要电脑不报错,这个定理就是绝对保真的。
但问题在于:把散文翻译成机器代码,极其艰难。
在 OpenAI 倒出来的这 722 篇所谓突破中,初期拥有 Lean 验证的成果甚至不到三成;即便罗伯茨紧急修补后,顶层结果的形式化比例也仅仅勉强拉到了 42%。
如此一来,超过半数的论文,本质上依然是“未经确认的机器草稿”。OpenAI 自己都在免责声明里写道:未形式化的结果“可能存在错误”。
既然连你们自己都不知道里面埋了多少雷,为什么要把它们一次性倒出来?
02一场精心包装的“无偿劳工剥削”
科技专栏作家雅各布·阿伦(Jacob Aron)在《新科学家》上发表了一篇辛辣至极的专栏,标题一针见血:
《OpenAI 倒出了 722 篇数学论文,现在它必须清理这个烂摊子。》
▲ 《新科学家》专栏:OpenAI必须为自己的烂摊子负责,不能把包袱甩给数学家
这篇专栏撕开了一个残酷的真相:
生成数学证明的成本,已经彻底塌陷到了 3 个小时的电费;但验证一个数学证明的成本,依然昂贵地锚定在人类专家数周甚至数月的心血上。
知名产品分析师 Aakash Gupta 算了一笔让所有人倒吸一口凉气的经济账:
假设由全球顶尖的同行专家来审阅这批手稿,哪怕以最乐观的效率,平均每篇只花一周时间去人工复核,722 篇论文,也需要耗费整整 14 个人类数学家的全职年工(14 person-years)!
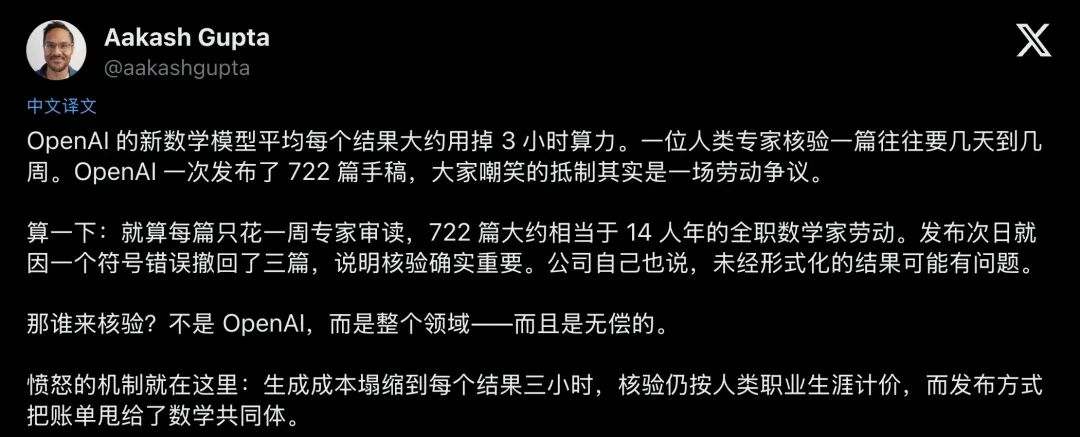
▲ Aakash Gupta 深度剖析:这场风波的实质是一场关于学术劳动的严重争议
14 年的顶级心智劳动,价值连城
那么,谁来出这笔天文数字般的质检成本?
估值数千亿美元的商业巨头 OpenAI 显然不会买单,它甚至连自己的模型都不肯拿出来给同行跑测试。
这笔账单,被结结实实地甩在了全球数学共同体的脸上,而且是免费的、强迫性的。
当代数学顶流、菲尔兹奖得主陶哲轩打过一个无比形象的比方:
这就像一个外来的全副武装的猎人,突然冲进一个宁静的村庄。他并未将猎物做成美味佳肴,反倒把 722 具血淋淋、未经处理、甚至可能带着寄生虫的生肉尸体,一股脑倒在了村委会的公共餐桌上。
然后猎人双手一摊,对着全村饥肠辘辘的村民说:“很有营养,大家快趁热剥皮烹饪吧,我还要回去继续打猎呢。”
对于一个刚拿到博士学位、正拿着微薄薪水、指望攻克某个子领域开放问题来评教职的青年学者来说,这是毁灭性的打击。
你花了两年时间啃下的骨头,AI 在一个下午吐出了一份似是而非的手稿。你看,还是不看?
如果不看,万一它是对的,你的两年青春就成了毫无意义的重复劳动;
如果看,你必须放下手头所有工作,无偿替一家大洋彼岸的商业公司找虫子、纠正正负号,而这家公司甚至连一句正式的致谢都不会写上你的名字。
罗格斯大学杰出数学教授亚历克斯·孔托罗维奇(Alex Kontorovich)疲惫地写道:这就像数学界古老的“考拉兹猜想”笑话一样,它是拖垮人类对手的阴谋。现在,AI 的地毯式轰炸,正在疯狂吞噬全人类最稀缺的资源:顶级数学家的注意力与生命。
03绝密黑箱与“数据洗稿”疑云
事情到这里,还没有滑向最深渊
最让学术共同体感到被羞辱的,是 OpenAI 这一次极其精明的“伪开源”姿态。
在 GitHub 仓库中,OpenAI 极其慷慨地为这 722 篇论文打上了 Apache-2.0 这一国际通行的宽松开源许可。任何人都可以免费下载 PDF,免费阅读源码。
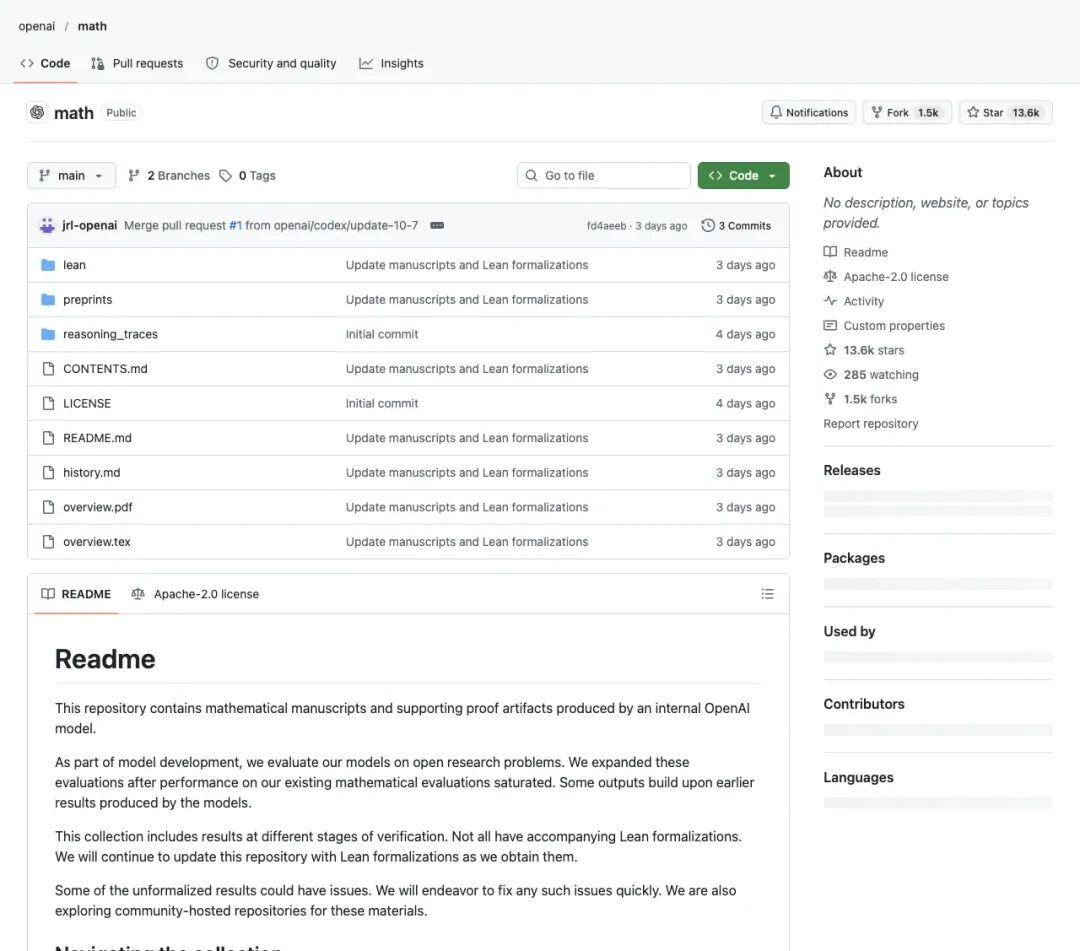
▲ GitHub 仓库 openai/math 界面:标榜开源,实则核心生成机制严密封锁
但科技媒体 The Verge 却无情戳穿了这层温情脉脉的面纱:这是一场典型的“黑箱神谕”。
在这座看似开源的宏伟建筑背后,核心的技术细节被锁得严严实实:
- 模型本体完全神隐
:既无正式命名,也未公开权重,更未向学术界开放任何科研 API。外界根本无从得知这台机器是如何得出推导的; - 推导轨迹几乎全被抹去
:在专门存放模型思考过程的 reasoning_traces/目录里,面对 722 个庞大课题,OpenAI 仅仅象征性地上传了 10 份推理摘要(仅占 1.3%); - 关键信息全打马赛克
:哪怕是这区区 10 份摘要,里面的系统提示词(Prompt)、强化学习奖励机制、搜索树算法的核心逻辑,全被当作商业机密进行了高度删减(redacted)。
更深层次的科学伦理信任危机,在于版权与知识溯源。
现代数学猜想向来不会凭空产生在过去的十几年里,全世界成千上万的学者在学术博客、预印本网站 arXiv、问答社区 MathOverflow,甚至是小众的 Zulip 讨论组里,就这些开放问题留下了浩如烟海的非正式讨论。
这些散落的思维碎片,包含了无数未成形的灵感框架、反例排除思路和精妙的辅助引理。
当一个既未公开训练集截断时间、又未披露检索增强(RAG)细节的黑箱大模型,突然宣称自己“独立搞定了 722 个难题”时,所有人心里都升起了一个巨大的问号:
它究竟是靠自己的逻辑能力找到了全新的数学大陆,还是通过海量算力,暗度陈仓地把全球青年数学家无偿贡献在互联网上的半成品灵感,给无缝“洗”成了一篇属于 OpenAI 的成果?
缺失了推理轨迹,科学便失去了可复现的基石;而倘若文献引用不透明,学界就无法排除人类智慧成果遭到掠夺的嫌疑。
面对这种傲慢的“权力示范”,学界的反击来得迅猛而决绝。
10 月 7 日,人类数学协会(Association for Human Mathematics,AHM)通讯工作组公开发表措辞空前严厉的檄文:
“数学家从未请求这些工作被代劳一次性倾倒七百多份手稿,毫无学术示范可言,纯粹是一场赤裸裸的权力展示!”
AHM 正式向全球同行发出倡议:全面停止与 OpenAI 的一切合作,拒绝为其充当免费的验题工具!
这份被视为主流学界“独立宣言”的声明,随后被陶哲轩全文转载在了自己的个人博客上。
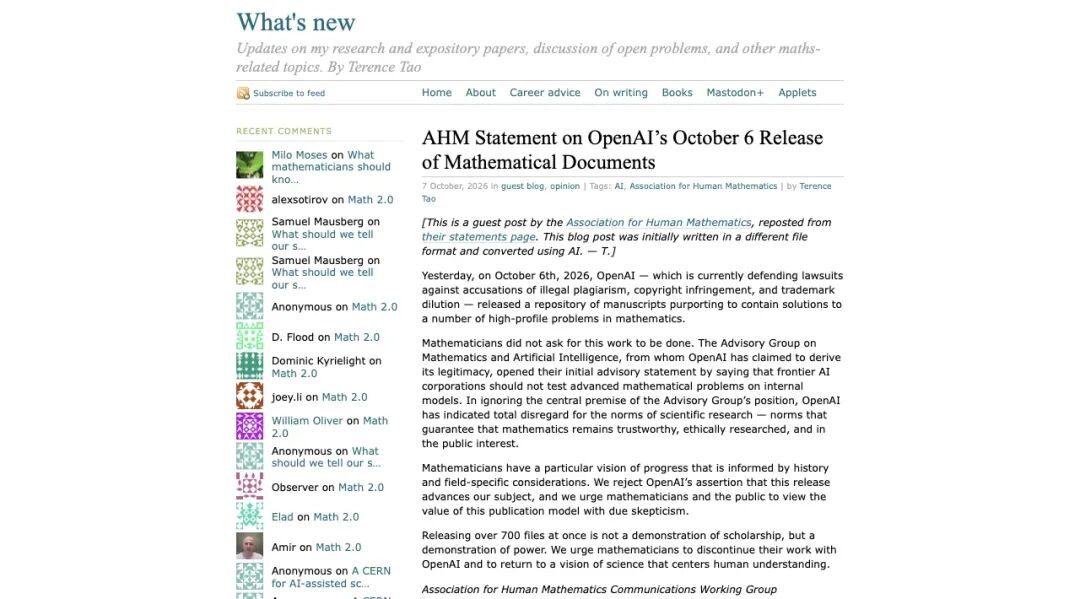
▲ 陶哲轩个人博客转载 AHM 声明:向 OpenAI 的单方面投放说“不”
04证明可以廉价,但人类的理解不能
回望数学史,人类从来不害怕“未消化的天才洞见”。
一个多世纪前,英年早逝的印度数学奇才拉马努金,在笔记本里留下了三千多个未附带证明过程的神奇公式。随后的整整一百年里,一代代数学大师心甘情愿地去整理它、解读它、证明它。因为所有人都清楚,拉马努金绝非在向世界炫耀特权,他只是来不及写下全部的论证。
三十年前,数学家托马斯·黑尔斯为了证明开普勒猜想,写出了长达数百页的复杂论证和庞大的计算机代码。审稿团队花了四年时间,最后只能无奈地宣布“我们只有 99% 的把握它是对的”。黑尔斯并未推卸责任,他转头扎进冰冷的机房,自己花费了整整十二年时间,亲手用形式化代码完成了全部验证。
人类敬畏拉马努金的灵韵,也敬佩黑尔斯的担当。
因为科学的终极追求,绝非仅仅获取一个冷冰冰的“正确”判定,其核心始终在于启迪宇宙中的人类心智,去获得彻底通透的“理解”。
如果未来的纯科学,蜕变成了商业巨头在云端机房里暴力穷举、定期向人间倾倒数以千计的不可读神谕,而全人类最聪明的大脑只能沦为跟在算力屁股后面扫地、纠错、无偿打工的苦力,
那绝非人类理性的胜利,
充其量只是技术官僚与资本对人类精神最后圣地的侵蚀与殖民。
正如专栏作家雅各布·阿伦所言,球现在已经踢回了 OpenAI 的半场。如果这家号称“造福全人类”的 AI 公司真的对科学抱有一丝敬畏,它就该收起这种廉价的算法倾销:
拿出你的模型权重,交出你未经删节的推理轨迹,承担起你该雇佣、该支付的形式化人力成本。
在机器证明泛滥成灾的时代,廉价的是算力,昂贵的是理解。
既然你把这 722 篇巨石般的未验手稿倒在了人类的餐桌上,那么 OpenAI,请你先把地上的烂摊子,自己打扫干净。