ARTICLE · 1165847
哈佛科学家开发“科研护具”系统,AI两月读完15万份文献破解六千种语言密码
在刚刚过去的2026年夏天,一场由理论物理学家与人工智能大语言模型(LLM)联手掀起的科研范式变革正在悄然发生。
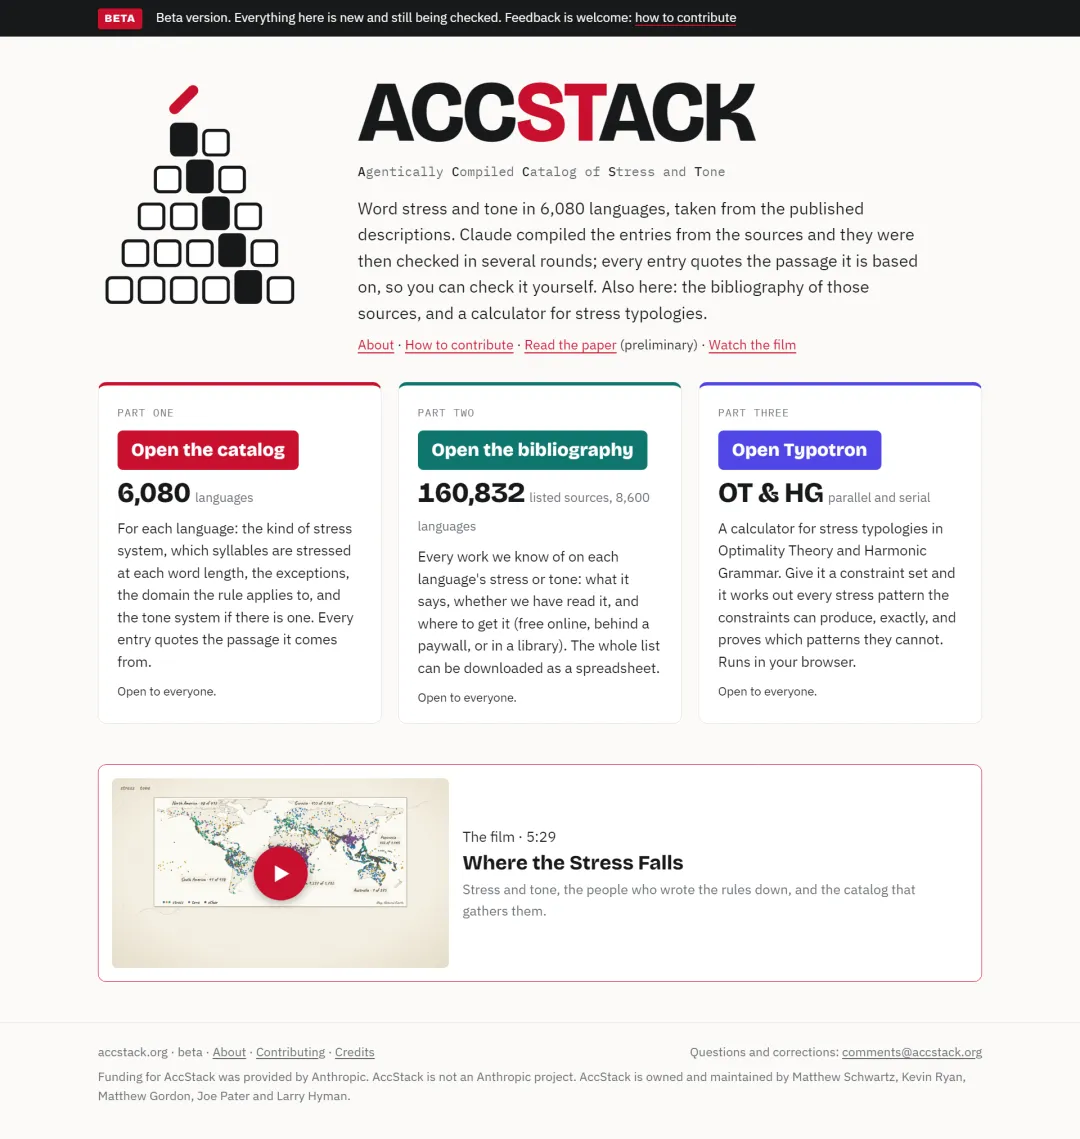
哈佛大学理论物理学教授马修·施瓦茨(Matthew Schwartz)开发了一套名为BootLoops的开源工具套件,成功引导AI避开其不擅长的“直觉判断”,转而高效攻克庞杂的计算与文献梳理任务。这项人机协同项目不仅在理论物理、生态学等领域取得突破,更跨界挺进语言学——AI在短短两个月内阅读了超过15万份学术文献,建立了一个覆盖全球6080种语言词重音与声调的巨型开源数据库ACCSTACK。
当前,科学界在使用人工智能时普遍面临一种被称为“阻抗匹配”(impedance mismatch)的困境:研究人员希望AI能像资深学者一样拥有深度的洞察力,但当下的AI本质上更像是一个阅读速度极快、记忆力惊人却极度需要保姆式引导的“超级实习生”。为了打破这种错位,施瓦茨决定停止让AI强行模仿人类,转而让它去寻找那些“适合AI体质的问题”(Claude-shaped problems)。
为此,他打造了BootLoops系统。在这个类似于“科研护具”的框架规范下,AI模型(Claude)迅速展现出惊人的潜能。它不仅在20分钟内复现了物理学家耗费数周才写出的算法,还成功计算出15个从未被人类解出的复杂椭圆积分(elliptic integrals)。
物理学领域的成功促使施瓦茨将目光投向更广阔的知识边界。在与语言学家凯文·瑞安(Kevin M. Ryan)、马修·戈登(Matthew K. Gordon)等专家的合作中,AI迎来了一项前所未有的浩大工程:梳理地球上数千种语言的发音底层规律。
在调度下,AI代理化身为不知疲倦的数字学者,深入Glottolog目录中的7803种人类口语档案。它们搜寻并阅读了语法书、发音词典甚至需要扫描的古老纸质手稿。为了确保数据的准确性,系统设定了极其严格的“双代理交叉验证”机制:一个AI代理负责逐字摘录关于词重音(Word stress)和声调(Tone)的决定性段落并附上页码;另一个AI代理则作为“审查员”,重新翻开原版文献核对引文,确保没有断章取义。一旦出现分歧,双方会展开深入辩论,直到得出合理的判定结果。
凭借这种协作模式,AI高标准建成了ACCSTACK数据库。该数据库精确记录了固定重音(Fixed stress)、音重敏感重音(Weight-sensitive stress)以及复杂的声调系统。在与WALS、LAPSyD等传统人工数据库的比对中,AI甚至找出了许多过去因人为编码妥协而产生的系统性偏差,客观地保留了罕见声调等真实语言面貌。
尽管AI在文献整理与数学计算上展现出压倒性的优势,但施瓦茨在总结这项工作时明确表示,这并非意味着人类科学家的边缘化,反而更加凸显了人类品味与直觉的不可替代性。
在生态学项目中,AI虽然破解了20年来无人能解的“中性生物多样性理论”方程,但正是因为有了人类专家的指引,团队才决定减去中性理论的底噪,最终建立起具有现实科学意义的植物生命周期预测模型。在群体遗传学中,AI找出了海量的突变数据,也是在生物学家的干预下,才成功锁定了常被忽视的“基因转换”现象。
人类科学知识的边界就像一个布满参差突起的“凸包”(convex hull)。过去,由于学者的寿命和精力有限,各学科之间留下了大量荒芜的知识缝隙。如今,以BootLoops为代表的AI工具链正以难以置信的速度填补这些空白。繁琐的计算与海量的资料查阅被自动化接管,人类研究员终于可以从科研苦力中解放出来,专注于更深层的方向指引与智力创造。
属于人机协同的全新科学大发现时代,大幕已经拉开!
参考丨
https://www.anthropic.com/research/claude-shaped-science
https://accstack.org/
编辑丨扬薇儿