ARTICLE · 1166091
再见IDM!支持全平台的开源免费的下载神器来了.
再见IDM!支持全平台的开源免费的下载神器来了.下载大文件,慢的常常不是总带宽。切开几段、开几条连接一起拉,只要有一段落在慢节点上,整条下载就得陪它等,段切得越多,撞上慢节点的概率越高。 hydra 想解决的就是这件事。它是个多来源的下载引擎,命令行、桌面端、浏览器扩展都齐,三个系统都能跑,仓库在 github.com/ja7ad/hydra,作者 ja7ad。 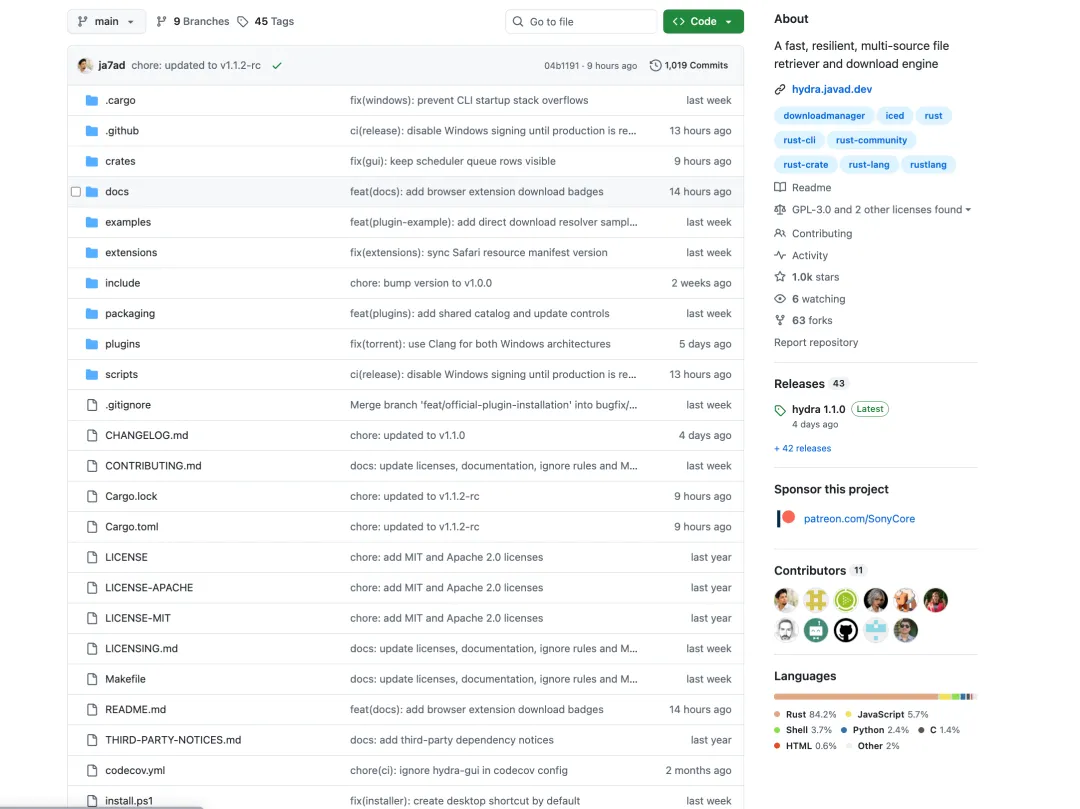
灵活重新分配分片的核心机制 它把每个分片当成随时可以改的活 多数下载器开着 N 条连接各推各的,hydra 让区间随时可以重新分配,慢连接手里的活移交出去,快的接上,作者管这个叫 range stealing。连接刚开始劣化,统计估计就会提前发现,不用等超时。 --mirrors 后面挂几份内容相同的文件,几条镜像一起拼。Metalink 文档更彻底,它给出所有镜像、文件精确大小和该有的摘要,段落因此在镜像站之间也能拼起来:独立镜像站没法共享 ETag,那道校验本来过不去。 内存按定位直接写入,峰值恒定。 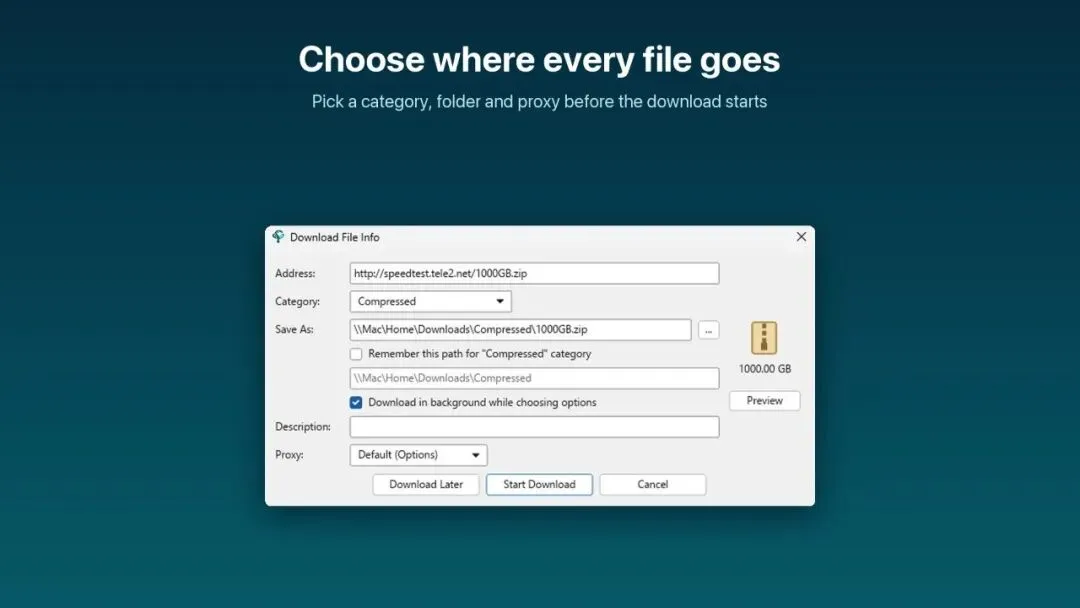
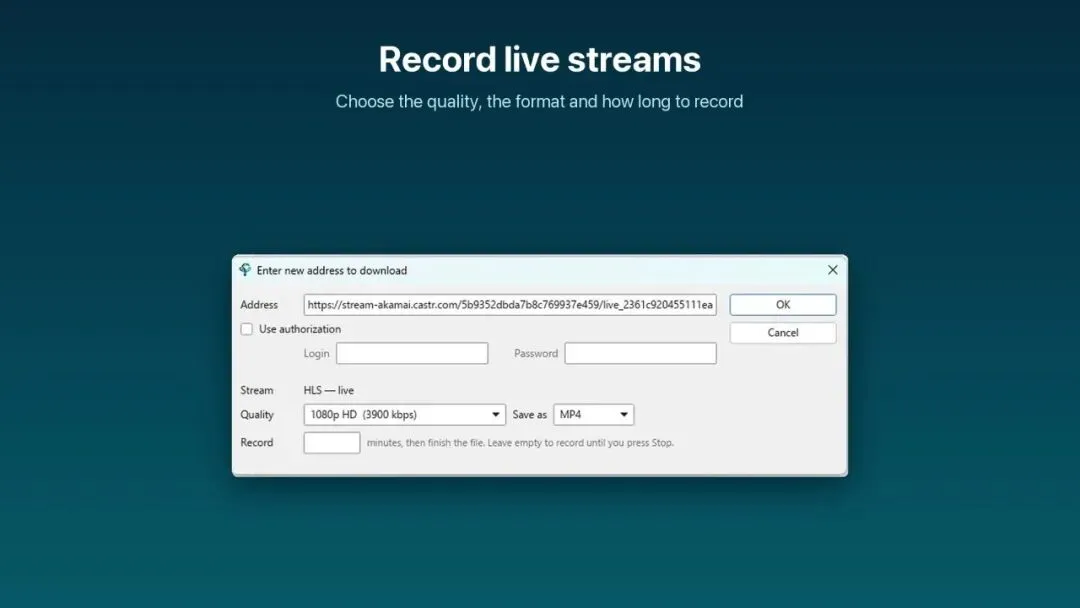
使用方式 用起来还是 wget、curl 那一套 -x 是连接数,不加参数就是自适应。命令行认 wget 和 curl 的方言,脚本里的参数换成 hydra 就能跑,终端里还有交互式队列。 短名是 hya,因为 hydra 已经被密码审计工具 THC-Hydra 占着,apt install hydra 装到的是那一个。 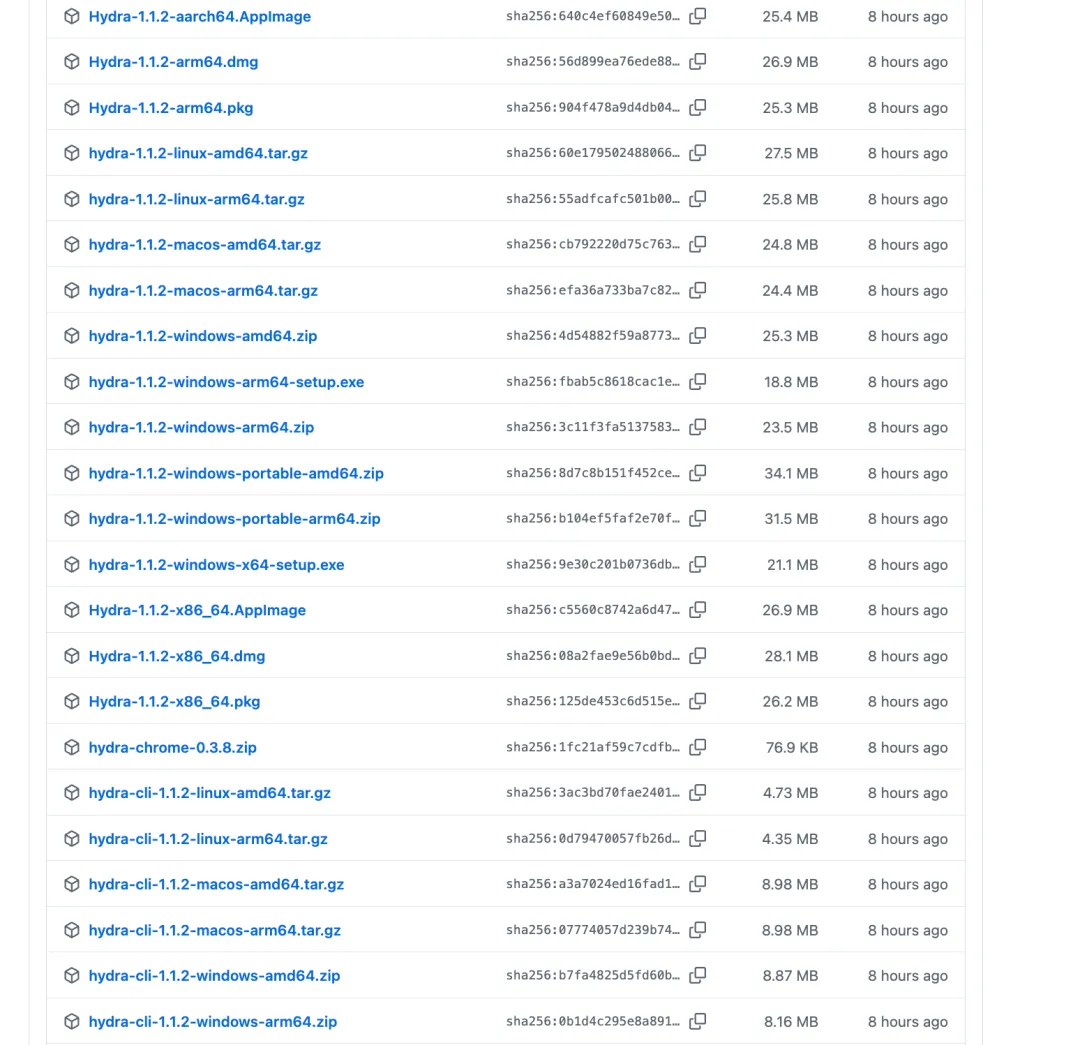
基准测试结果 作者自己跑的基准,脚本就在仓库里 1GB 文件、100 毫秒往返,四条 curl 分片差不到 10 毫秒,唯一变量是客户端:
不加参数的 hydra 大致等于 aria2c -x 4,内存那列只有 wget 比它省,4.8 MiB 对 6.9 MiB。脚本在 scripts/benchmark/ 下,可以自己复跑。 
项目地址: https://github.com/ja7ad/hydra
brew install ja7ad/tap/hydrahydra --mirrors https://a.org/x.iso https://b.org/x.iso