ARTICLE · 1166593
AI判变异,究竟凭什么 3/4
生信小白板 · 文献深读 · 3/4
AI辅助原创解读示意,非实验数据。
导读图|评测边界与证据独立性。AI辅助制作的概念插画,不是实验数据或真实模型结构。
排行榜越漂亮,越要先看测试对象
前两篇分别梳理模型输入与学习过程。本篇回到一个看似朴素的问题:模型表现很好,究竟是在什么数据上、对什么任务、按什么指标很好?Bulloni等综述把特征相关、数据循环、训练偏差和可解释性放在同一张挑战地图中。[1] 这不是对AI的否定,而是让预测结果具备可审查的证据边界。
原文Figure 2没有实验坐标轴。左上重叠圆圈表示输入可能共享信号,右上回环和数据库表示训练信息进入测试,右下柱形与天平表示数据代表性不均,左下黑箱与放大镜表示解释困难。中央箭头把四项主题连到VEP,不表示它们之间已测得因果关系;图形面积、颜色深浅都不是效应量。
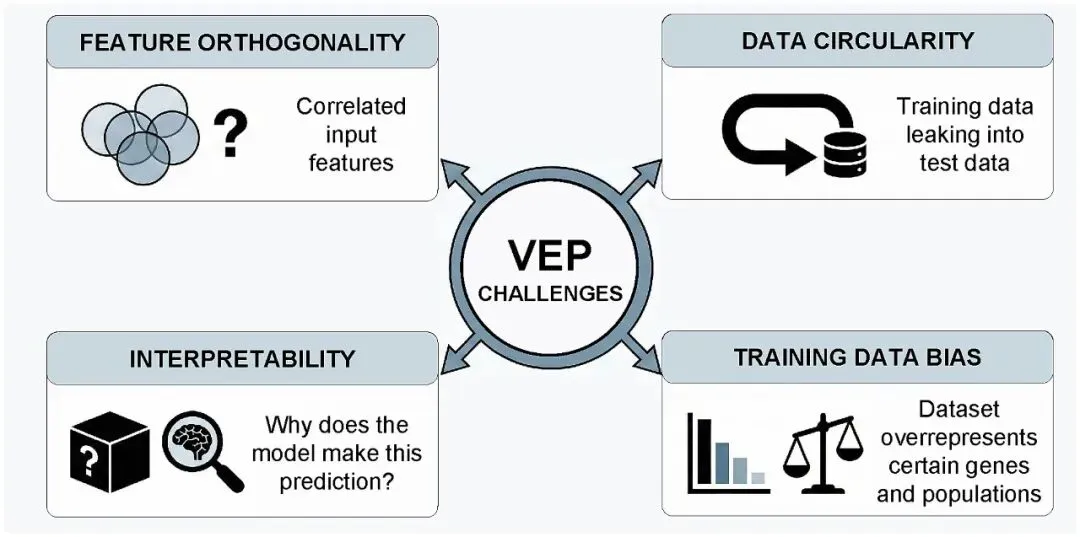
原文Figure 2|四项方法挑战:特征相关、数据循环、训练偏差与可解释性。完整保留;图标和箭头为概念关系,没有统计坐标、样本量或效应大小。 来源:Bulloni、Vescio、De Mori Bajolin、Pattini(2026),https://doi.org/10.1093/bib/bbag552 。CC BY 4.0:https://creativecommons.org/licenses/by/4.0/ 。
一项研究即使把所有变异随机分成训练集和测试集,仍可能留下与真实应用不一致的捷径。实际问题可能是预测同一基因中的新变异,也可能是迁移到从未研究的基因或另一祖源人群。这些是不同泛化任务。评价是否严格,必须先写清部署时会遇到怎样的新对象,而不是机械追求某一种划分。
图4A:变异换了数据库版本,不等于换了身份
原文Figure 4A描绘第一类循环性,即变异层面的重复。左侧列出示意变异编号,红色Variant #2和Variant #1041通过红线同时连接训练数据与评价数据。上方训练库标作ClinVar 2015,下方测试库标作ClinVar 2023;右侧粉色框提示性能可能被抬高。编号和年份用于解释机制,不是某个工具的实测泄漏清单。
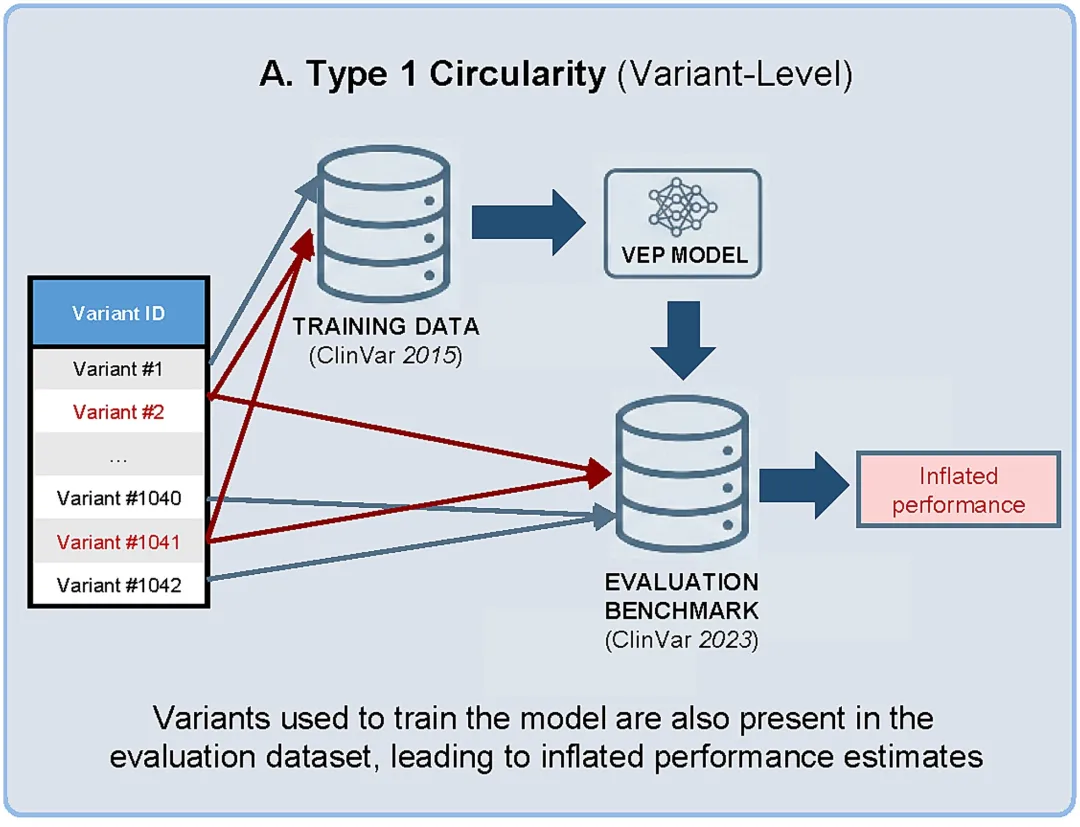
原文Figure 4A|变异层面循环:红色示意变异同时进入训练与测试。ClinVar 2015/2023为教学场景,并非实测泄漏统计。仅按panel裁切,保留全部标签和箭头,未改动内容。 来源:Bulloni、Vescio、De Mori Bajolin、Pattini(2026),https://doi.org/10.1093/bib/bbag552 。CC BY 4.0:https://creativecommons.org/licenses/by/4.0/ 。
最直接的问题是,后来的数据库版本仍保留早年的记录。如果只按下载日期区分训练与测试,模型可能在考试中再次遇到学习过的变异。严格的时间外测试应追踪记录何时首次出现、标签何时改变,并排除模型已经接触的对象,而不只是把文件夹命名为“旧版”和“新版”。
去重也不能只比字符串。相同变异可能采用不同参考版本、左对齐方式、转录本编号或蛋白表达,多个不同DNA变异还可能对应同一个氨基酸替换。需要结合任务定义做规范化,并记录匹配单位。若一个测试集只删除完全相同的文本行,仍可能留下生物学上相同的对象。
meta-VEP还要追查上游分数。如果外层分类器没有见过某变异,但它输入的某个子模型已经训练过该变异,泄漏路径仍然存在。完整训练集未公开时,不能因此证明绝对独立;应报告可排除的范围、尚不清楚的来源,并利用其他基准或较保守的划分检查结论是否稳定。
另有更隐蔽的标签循环:数据库中的临床分类本身可能参考过早期计算预测,后续模型再拿这些分类训练或验证。即使样本编号没有重叠,模型与评价标准之间也可能共享推断来源。解决这类问题需要看证据构成与审查状态,独立功能实验有帮助,但它回答的生物学层次又未必与临床标签相同。
图4B:记住“哪一个基因”,未必理解“哪一个变异”
Figure 4B展示第二类循环性。表中四列依次为Variant ID、Various Features、Variant Location和Pathogenicity Label。三行示意变异都位于Gene X,标签都是True;红色位置列和指向标签的箭头强调一种捷径:只要知道属于Gene X,就能猜中这张表里的标签,却未必识别各个替换的真实后果。
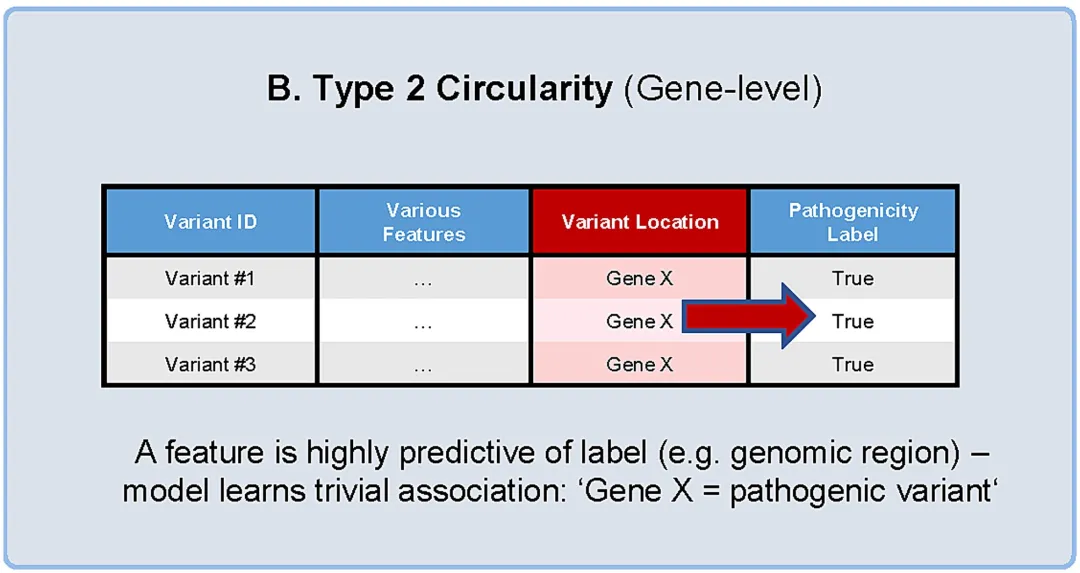
原文Figure 4B|基因层面捷径:Gene X位置与True标签在示意表中共同出现。并非所有同基因测试都无效,须结合泛化目标判断。仅按panel裁切,保留全部标签和箭头,未改动内容。 来源:Bulloni、Vescio、De Mori Bajolin、Pattini(2026),https://doi.org/10.1093/bib/bbag552 。CC BY 4.0:https://creativecommons.org/licenses/by/4.0/ 。
这不是说基因层面的信息没有价值。基因约束、疾病机制和剂量敏感性本来就是合理先验。问题在于,若测试集的正负类别被不同基因组成所支配,整体高分可能主要来自基因间差异,而非基因内变异辨别。这样的模型拿到一个已知疾病基因里的新候选变异时,未必同样有用。
因此,同一基因同时出现在训练和测试中,也不应一律判作无效。如果目标是同基因内未见变异预测,这种设计可以回答相应问题;若声称可以迁移到全新基因,就需要基因留出,必要时进一步留出同源家族。划分粒度应该对应宣称的泛化范围,而不是用统一口号替代研究问题。
一个实用的评测组合可以同时报告整体表现、每基因表现与跨基因留出表现,再按结构区域、变异类型和标签质量分层。若整体很强而基因内明显下降,就值得检查模型是否主要利用基因级先验。若新基因上下降,也不必否定同基因任务中的价值,但应用说明必须把边界写清楚。
一个百分数,可能代表完全不同的分母
准确率统计所有预测中有多少正确;敏感度关注真实阳性找回多少;特异度关注真实阴性排除多少;阳性预测值关注被判阳性的对象里有多少真阳性。它们不是同义词。一个模型在类别非常不平衡的数据中,可以有很高准确率,同时让大量阳性判断不够可靠。
做一个纯教学计算,数字不是任何原论文实验:1000个候选变异中只有20个真阳性,模型敏感度80%、特异度95%。它会找回16个真阳性,并把980个阴性中的49个误报为阳性;另有931个真阴性。总体准确率是94.7%,但65个阳性判断中只有16个为真,阳性预测值约24.6%。
这个例子不说明模型毫无价值,它仍可能显著缩小实验筛选范围。它说明“94.7%准确”不能直接翻译成“看到一个阳性结果,有94.7%的把握为真”。从筛选到分类再到诊断,阳性基率和错误代价都发生变化,必须使用适合该环节的指标解释同一个分数。
AUROC衡量排序区分能力,不要求先固定阈值;在阳性稀少时,精确率—召回率曲线往往更贴近候选筛选的负担。即便AUROC相同,两个模型在高敏感度或高特异度区间的表现也可能不同。论文若只给一个总面积,读者还需要追问实际阈值附近会漏掉多少、误报多少。
排序和校准也不同。模型把高风险对象排在前面,不保证0.8分的对象在新场景中真的有80%阳性。校准应在目标任务相近、标签可信且独立的数据上检验,还要考虑基因与疾病构成的变化。把分数线性换算成百分数,不能替代校准,更不能自动得到个体风险。
CPT-1的92.8%:胜率不是准确率
2025年Livesey和Marsh对97个预测器与36组DMS数据进行了系统比较。[7] 不同工具覆盖的变异和蛋白不同,直接平均各自能算出的相关性会混入覆盖差异。研究因此采用成对比较:在某个DMS数据集中,只比较两工具与实验共同覆盖的变异,再判断谁的相关表现更好。
具体而言,研究比较预测与功能读数的绝对Spearman相关性,在各蛋白上汇总一对工具的胜率,再对其他工具取平均得到总排名。CPT-1的92.8%是这一规则下的总体平均胜率,不是92.8%的变异被正确分类;其训练所用五组DMS数据在相应基准中被排除,不能把它们混回“独立测试”。
它对其余前五名方法的平均胜率为66.2%,而与AlphaMissense的排名差异在该bootstrap检验中没有达到显著,p=0.169。不能把“点估计排名第一”改成“显著胜过所有方法”。研究还指出,AlphaMissense与CPT-1的直接成对结果和最终综合名次并不完全一致,说明排名规则本身会影响结论。
这类设计提高了比较公平性,却没有把覆盖问题彻底消除。若某工具主要覆盖容易预测的区域,成对交集仍可能具有选择性;每个工具参与的蛋白数也不同。阅读原研究图表时应同时看覆盖列、排除项、重采样单位与误差条,不能把少量数据上的漂亮分数和广泛覆盖下的表现直接等同。
这里的重采样以蛋白数据集为单位,有助于体现跨蛋白不稳定性,而不是假设同一蛋白里的上千变异都完全独立。一般而言,误差条取决于重采样单位与设计;变异级、基因级或研究级重采样可能得到不同不确定性。看见误差条,不等于已经解决样本相关性和训练污染。
功能实验是一条独立路线,但不是万能真值
DMS通过系统制造大量变异并测量特定功能读出,可以提供不依赖临床分类的验证路径。但实验可能测蛋白丰度、细胞生长、结合或其他代理功能;相同变异在不同体系中的后果不一定相同。模型与某个读数高度相关,首先支持它能预测那个实验任务,而非所有疾病机制。
对功能实验也应追问:覆盖了哪些位点,读数是否饱和,生物学重复如何,野生型与已知对照能否分开,以及系统是否包含相关相互作用伙伴。一个在异源细胞中看似正常的变异,可能仍影响特定组织功能;一个实验中损伤明显的变异,也需要继续评估其在人类疾病语境中的意义。
无序区:总体漂亮可能遮住困难子集
Fawzy和Marsh在2025年PLOS Computational Biology研究中比较了33个预测器,关注天然无序区的表现。[2] 它不是简单把pLDDT低于70的所有残基都算作无序。方法要求该残基pLDDT低于50,且处于至少30个残基、平均pLDDT低于70的连续片段;其余低置信情况还可能归为中间类。
原研究报告约3.6%的ClinVar致病或可能致病错义变异落在定义的无序区;约39.8%的ClinVar良性或可能良性变异落在该区。两个百分比的分母分别是两类变异总数,不能倒转成“无序区内3.6%致病、39.8%良性”。对分母的这一步核对,比记住一个醒目的比例更重要。
若一个模型主要学会“无序区通常更容忍变化”,它可能把大量容易的良性变异排对,从而提高整体区分度,却漏掉无序区中真正关键的致病位点。区域分层评价能够暴露这种问题,也提醒我们评估敏感度,而不只看总体AUROC。结构类别是帮助检查模型的分层,不是替代具体机制的结论。
研究探索了按区域选择Youden统计量最优阈值,但这类分析阈值不等同于已校准的临床证据阈值,不能直接搬进诊断流程。无序区还包含调控基序、修饰位点和动态相互作用等多种机制。区域标签之外,仍需要解释具体变异为什么会改变功能,而不能把低置信结构当成“不重要”的代名词。
祖源差异:分数分布不能直接写成误诊率
Pathak等《Pervasive ancestry bias in variant effect predictors》目前按已核官方版本记录,应标注bioRxiv预印本,v3日期为2025年3月25日。[8] 本系列只核对其摘要、官方版本与出版关联元数据,没有把摘要阅读写成全文精读,也没有把它当作已经正式发表的确定性结论。
摘要报告比较52个VEP在14个祖源组中的错义变异评分模式,部分依赖临床或群体资料的工具在代表不足人群中给出更高的有害变异负担。这个结果提示训练代表性风险,但分数分布差异不是已测得的临床误诊率,更不能外推成所有工具对所有非欧洲人群都同方向失准。
实际评估需要区分至少三件事:群体真实变异谱不同、数据库覆盖不同,以及模型在相似真值条件下的误差不同。只有分数而缺少匹配真值,很难将三者完全拆开。研究者应报告祖源构成与数据质量,并设计适合目标人群的验证;不宜从群体平均分数推断某个人的疾病风险。
从计算分数到证据强度,需要另一道校准
Pejaver等2022年的研究,以及Bergquist等2025年的后续校准,讨论怎样把计算分数映射到PP3/BP4的证据强度。[9,10] 这里的核心不是寻找一个万能阈值,而是预先选定工具与适用范围,使用经独立校准支持的区间。开发者默认的“有害”阈值,不一定对应临床标准中的支持级证据。
因此,不应先看完十个工具的分数,再挑一个最支持预设判断的结果;也不应把多个高度相关预测当成独立证据累加。按既定流程使用合适工具、说明校准版本和边界,比简单多数票更可审查。若多个工具分歧明显,可以把分歧当作研究线索,但不能借选择性报告把不确定性抹掉。
同样要检查计算分数是否已经包含群体频率、结构或其他证据来源,避免在后续综合时重复计入。同一信息换了外观,并不因此变成独立证据。对某个具体变异是否能应用某项临床证据规则,还需要专业判读与疾病背景;本系列提供阅读与分析方法,不提供自动分类处方。
一张可落地的评测记录卡
开始比较模型前,先固定任务、输入单位和终点:是变异筛选还是临床分类,是错义还是剪接,是同基因还是跨基因泛化?随后记录训练来源、时间截点、上游模型及可能泄漏路径。若某些信息拿不到,就把它列为不确定性,而不是让空白默认为“没有风险”。
再固定评价集与指标,报告覆盖率和未预测对象,分别展示整体、困难区域和目标人群的表现。给出正负类别数量、阈值、置信区间以及重采样单位。不同工具若无法在完全相同集合上比较,应清楚说明交集规则和剩余偏差,避免把选择样本造成的优势写成算法优势。
最后保留版本、参数、原始分数、转换规则与排除日志。模型更新后,先在锁定基准上检验变化,再决定是否进入正式流程。可重复性不是附加装饰:它让我们区分真实改进、数据版本变化和偶然波动,也让一条高分结论能够被他人追问、重算与修正。
读完这篇综述,最值得改变的不是把常用模型换成排行榜第一,而是把每个分数放回完整证据链。知道模型如何学习,只完成一半;知道它在怎样的独立测试上被证明有效,另一半才成立。当任务、数据、分母和边界都能说清,AI才真正从一个给答案的黑箱,变成一个帮助提出更好问题的研究工具。
原论文:From conservation scores to language models: a feature engineering perspective on machine learning for genetic variant interpretation;DOI:10.1093/bib/bbag552。
本文为非商业科普深读。原文图按图注署名与许可原样展示;AI辅助示意不代表实验数据。我们的延伸建议不代表作者已完成的实验。
[1] Bulloni M, et al. Brief Bioinform. 2026;27:bbag552. https://doi.org/10.1093/bib/bbag552 (Review全文)
[2] Fawzy M, Marsh JA. PLoS Comput Biol. 2025;21:e1013400. https://doi.org/10.1371/journal.pcbi.1013400 (正文/方法)
[7] Livesey BJ, Marsh JA. Genome Biol. 2025;26:104. https://doi.org/10.1186/s13059-025-03575-w (正文/方法)
[8] Pathak AK, et al. bioRxiv v3, 2025-03-25. https://doi.org/10.1101/2024.05.20.594987 (预印本;摘要/元数据)
[9] Pejaver V, et al. Am J Hum Genet. 2022;109:2163–2177. https://doi.org/10.1016/j.ajhg.2022.10.013 (正文/方法)
[10] Bergquist T, et al. Genet Med. 2025;27:101402. https://doi.org/10.1016/j.gim.2025.101402 (正文/方法)
https://doi.org/10.1093/bib/bbag552
https://academic.oup.com/bib/article/27/5/bbag552/8907411