ARTICLE · 1179657
配音、克隆声音、AI 唱歌,这款免费软件全包了
配音、克隆声音、AI 唱歌,这款免费软件全包了
现在的 AI 配音工具已经相当多了,但不少在线平台都要付费订阅,文字一多,还得额外购买额度。 如果想在自己电脑上部署,又免不了配置环境、下载模型,折腾半天才能正常使用。 
今天给大伙儿推荐一款免费的开源软件:yovoice。 它是一款支持 Windows 和 macOS 的本地 AI 声音创作工具,集文字转语音、声音克隆、情绪控制等功能于一身。 最方便的地方,就是把原本需要折腾命令行的 AI 配音模型,做成了普通人也能上手的图形化软件。 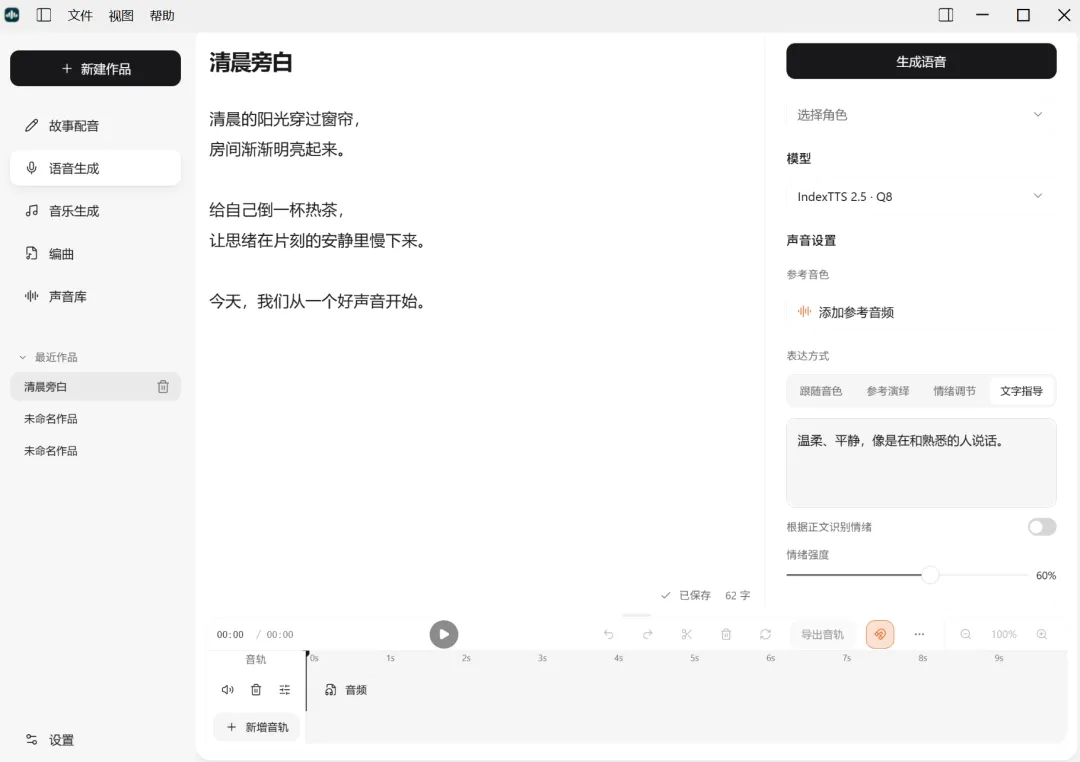
基础的文字转语音就不多说了,把文案粘贴进去,选好模型和音色,点击生成即可。 软件支持 IndexTTS 2.0/2.5、VoxCPM2、Qwen3-TTS 等多种模型,普通用户不需要单独部署,在软件设置里下载就能使用。 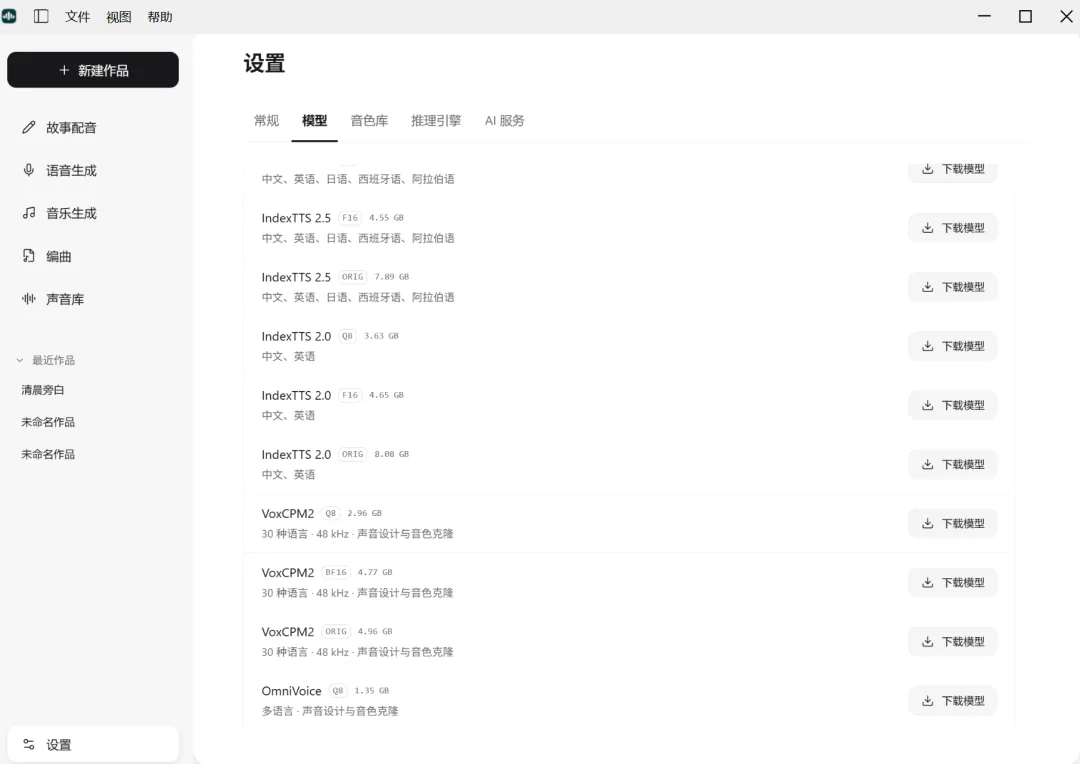
其中比较好玩的功能,是声音克隆。 只需要导入或录制一段 1~60 秒的清晰人声,软件就能参考这段音频的音色来生成新的配音。 也就是说,你完全可以让 AI 用自己的声音念文章、录制视频旁白,后续修改文案也不需要重新录音。 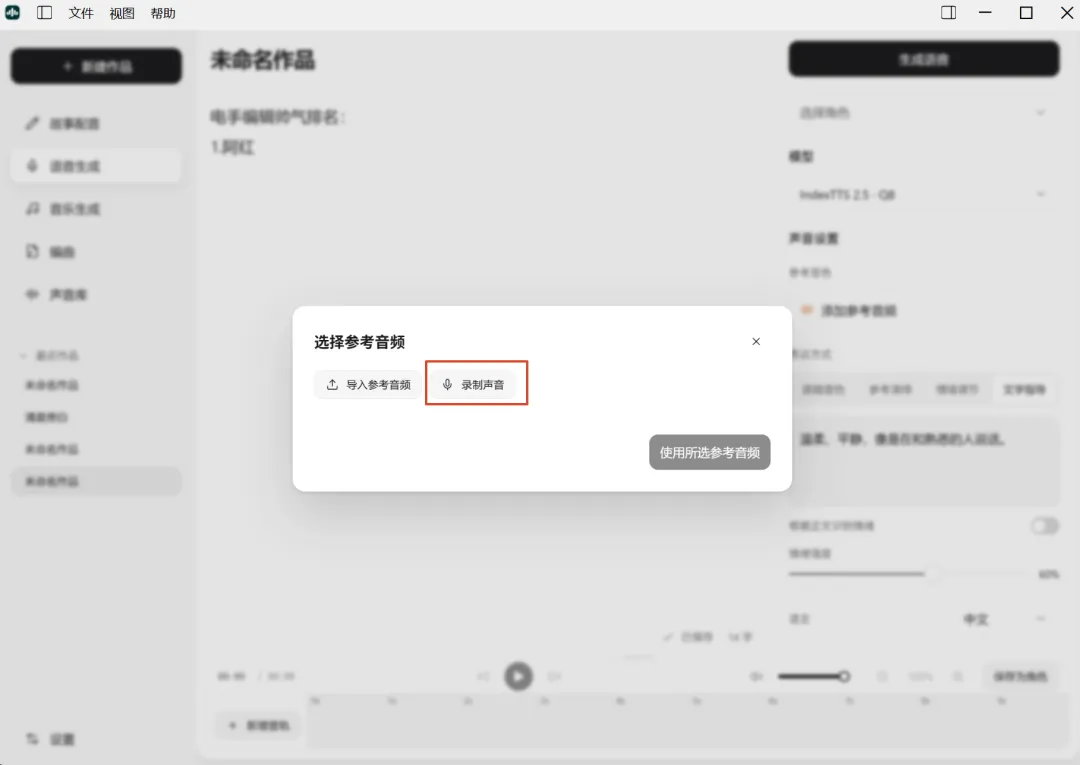
不想使用自己的声音也没关系,部分模型支持直接通过文字描述来设计音色,比如低沉的男声、温柔的女声。 此外,它还支持调节情绪、语速和表达方式。同一句话,可以尝试不同语气,避免生成的配音全程像机器人念稿。 最近更新的 v0.2.0 还加入了音乐生成功能,支持通过 ACE-Step 1.5 等模型,根据歌词和风格描述生成歌曲或纯音乐。 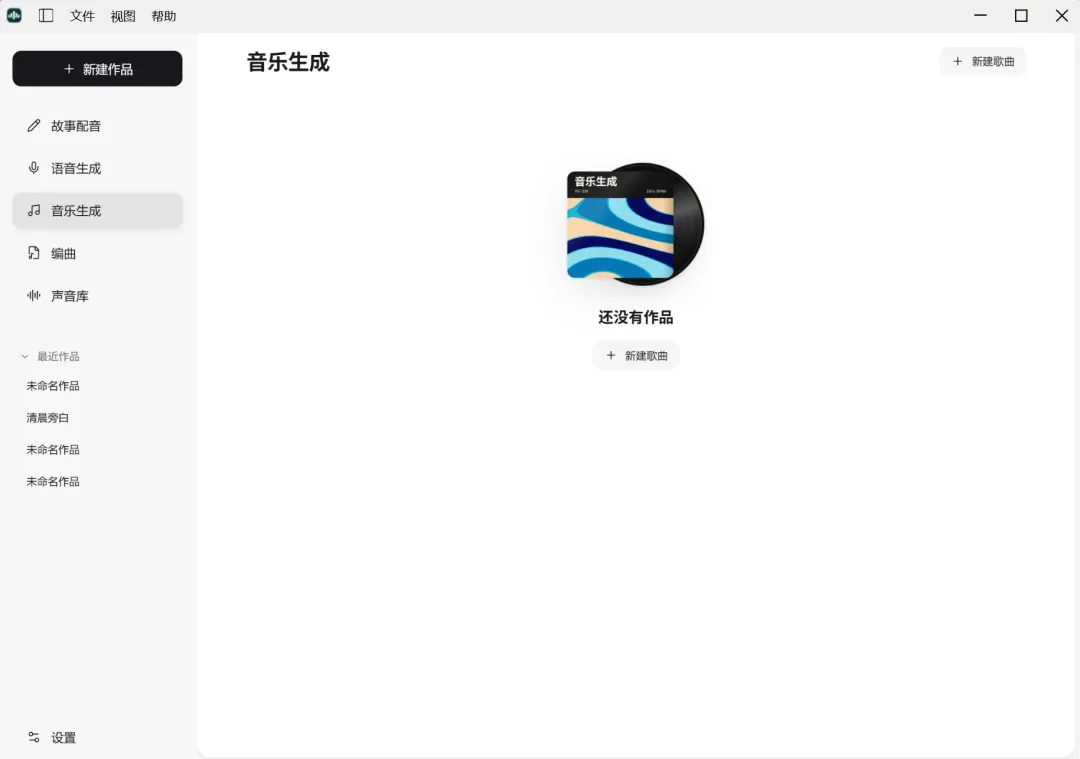
甚至还能导入 MIDI 乐谱进行多轨编曲、混音和导出,已经不局限于单纯的 AI 配音了。 最重要的是,语音与音乐生成可以完全在本地完成,不需要上传文稿和声音素材,也没有按字数、按分钟计费的限制。 当然,免费不代表没有成本。首次使用需要下载模型,部分模型体积达到数 GB,对电脑性能也有一定要求。普通配置可以先尝试轻量级的 Kokoro 模型,想玩高质量声音克隆或 AI 唱歌,最好还是有一张独立显卡。 
软件目前支持 Windows 10/11 64 位和搭载 Apple 芯片的 macOS 14 及以上系统。 对于经常需要制作视频旁白、文章朗读或有声内容的同学,这款工具值得收藏。 项目地址:https://github.com/leemysw/yovoice 下载地址:https://github.com/leemysw/yovoice/releases 网络不好的同学可以用阿红下载好的安装包: https://pan.quark.cn/s/f92dd2956f54
*软件、工具来源网络,仅供学习交流使用。