ARTICLE · 1181368
35B 模型进手机,我先实测了 1B 版
面壁智能 10 月 13 日发布 MiniCPM-V 4.7,主打"35B 的 MoE 模型在手机上跑得动"。我手边没有 iPhone,就把 1B 版本拉到云端 CPU 上跑了一遍,顺便把官方的说法和我看到的东西分开记下来。
35B-A3B 的端侧数据没法在我这里复现,1B 版本的图表读数全对、折射题却答偏了,4x 与 16x 视觉压缩的速度差也比我预想的小。
◁ 01|发布了什么 ▷
10 月 13 日,面壁智能发布新一代端侧多模态模型 MiniCPM-V 4.7,一共两个规格:35B-A3B 和 1B。35B-A3B 是 MoE 架构,总参数 350 亿,每次推理只激活约 30 亿,也是 MiniCPM-V 系列的第一个 MoE 模型。
先说我自己核实过的部分。我去 Hugging Face 查了,openbmb 名下确实有这一批仓库,10 月 6 日、7 日创建,许可证是 Apache-2.0,同时挂了 GGUF、AWQ、GPTQ、FP8、int4 等一堆量化版本。也就是说,这不是只有新闻稿的发布,权重已经能下。
官方给的核心卖点是 LES(前瞻专家调度)。 按模型卡的说法:MoE 模型每个 token 会在不同层选不同的专家,手机内存放不下全部专家权重,如果用到哪个才临时从存储里搬,就会一搬一停,解码很卡。LES 用跨层路由预测,提前把下一层大概率要用的专家预加载,让加载和计算重叠;预测只用来指导预取,计算仍然按模型原本的路由走,预测没命中的专家照常加载。
MoE 上手机,难点从来不是算不动,而是搬不动。
官方再叠加了逐层细粒度量化和 DSpark 投机采样,最终的说法是在 iPhone 17 Pro Max 上解码速度达到 13+ token/s,约 3GB 内存。注意这个"3GB"指的是特定部署方案下的运行内存占用,不是说 350 亿参数的完整权重只有 3GB。
◁ 02|官方的成绩单 ▷
官方放出了一张"性能-推理时间"的对比图,平均分取自 MMStar、MMMU-Pro、Charxiv_Reasoning、BLINK 和 MathVista 五项。我把它原样放在下面。
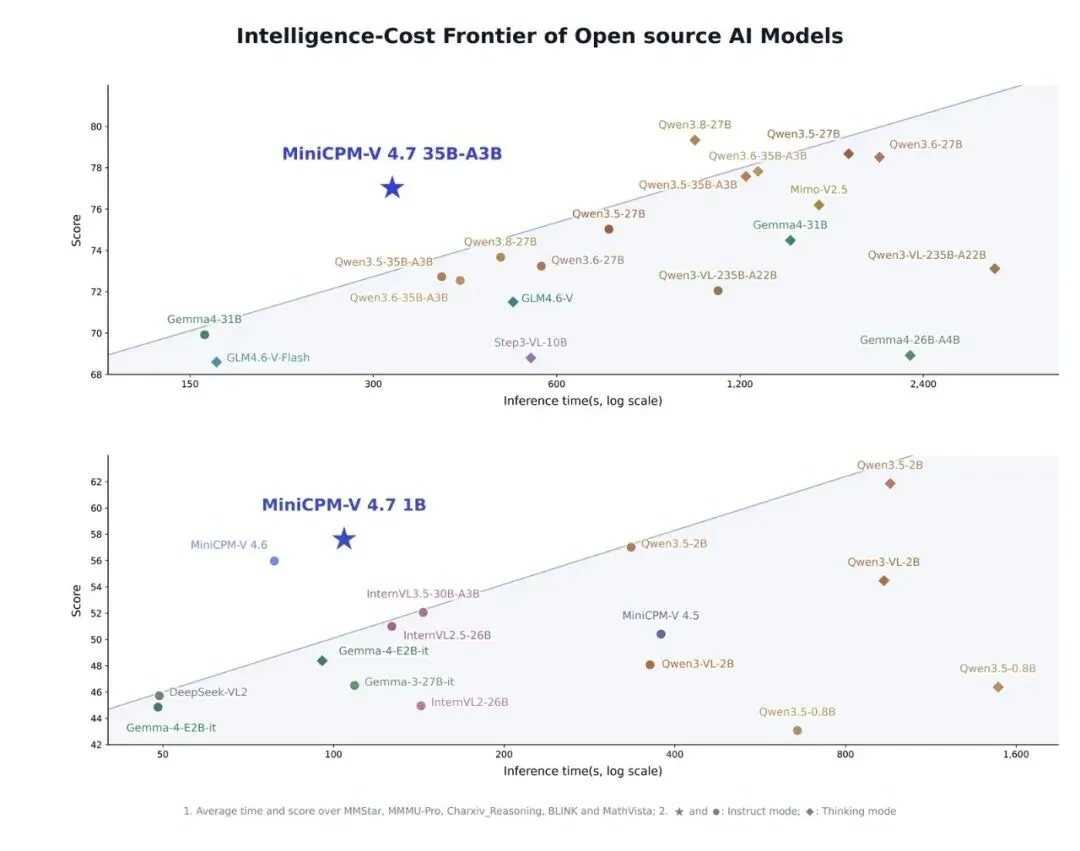
官方评测:性能与推理时间的对比,图中星标为 MiniCPM-V 4.7,来源:OpenBMB/MiniCPM-o 官方仓库 performance_efficiency_frontier.png
读图的结论,官方的表述是:Instruct 模式下,35B-A3B 用更短的推理时间,拿到比 Qwen3.6 35B-A3B 更高的综合分;1B 版本相比 Qwen3.5 0.8B,综合分和推理效率都明显领先。
我的看法是,这张图能说明的事比标题小。它是官方自己测的,推理时间的硬件条件图里没写;横轴还是对数坐标,星标往左上角靠的幅度,肉眼看会被放大。方向我愿意信,具体差多少,得等第三方复测。
◁ 03|我实际跑了什么 ▷
先交代边界:我没有 iPhone,也跑不了官方那套 LES 端侧方案,所以 35B-A3B 的端侧数据我无法验证,下面全部是 1B 版本的结果。
环境是一台云端虚拟机,32 核 CPU,没有 GPU,用 Transformers 5.19 加载 1B 的 bf16 权重,权重文件约 3.1GB,加载约 2.6 秒,进程峰值内存约 3.8GB。注意,机器上没装 causal_conv1d 和 flash-linear-attention,日志提示这两处走的是纯 PyTorch 回退实现,速度会偏慢,所以下面的 token/s 只能当作"最差情况的参考",不能和官方的手机数据直接比。
我设计了两个测试:一张官方示例里的折射图,一张我自己用 matplotlib 画的四根柱子的柱状图,每张分别用 16x 和 4x 两档视觉压缩各跑一次,贪心解码。
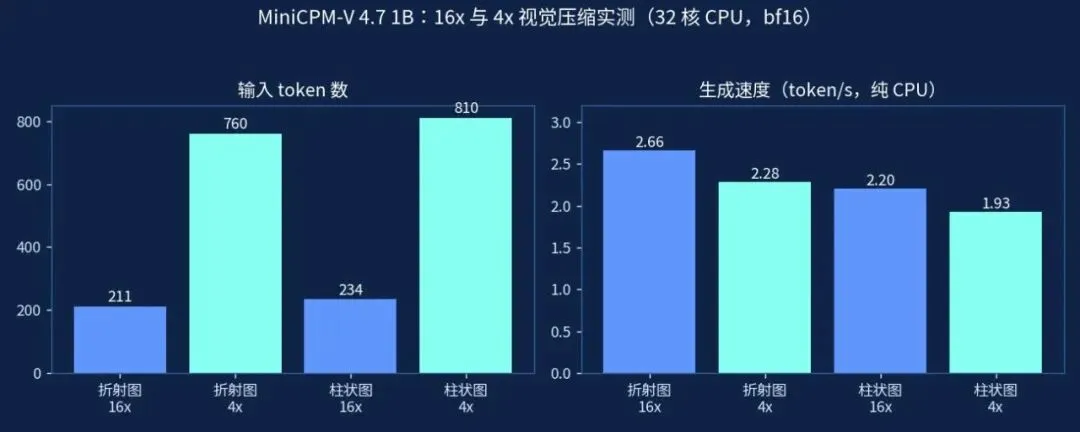
我自己的实测:16x 与 4x 两档视觉压缩下的输入 token 数与生成速度,数据来自本次实测
测试压缩档位输入 token生成速度
折射图16x2112.66 token/s
折射图4x7602.28 token/s
柱状图16x2342.20 token/s
柱状图4x8101.93 token/s
从数字看,4x 比 16x 多出三倍多的输入 token,但生成速度只慢了 12% 到 14%。 这符合官方说的"视觉 token 在编码器里提前压缩"的设计,一张图喂进去,开销大头不在这里。
◁ 04|答得怎么样 ▷
柱状图读数这一项,16x 和 4x 都全对:四根柱子的标签和数值(42、67、35、81)一个没错,最大值也答对了。这个小模型认图表上的数字,至少在我这张简单的图上是靠谱的。
折射图就不行了。官方示例问的是"这个现象的成因是什么",图里是一根插在水杯里、看上去被折弯的红色铅笔,正确答案是光的折射。我跑的两档,16x 把它说成"吸管",讲了一通静水压力和浮力;4x 认出是铅笔,但讲的是阿基米德原理,还在生成中途自己改口说了一句"Wait — correction",最后停在 200 个 token 的上限,没有给出结论。
会读数字,不等于懂物理。读图和推理,是两件事。
这里要如实说明:我每个条件只跑了一次,而且限制了最多生成 200 个 token,样本太少,不能下"1B 不会看折射图"的结论。更稳妥的说法是,在我的这次测试里,它在简单的图表读数上表现稳定,在需要常识推理的题目上不稳。
◁ 05|我的观后感 ▷
作为一个每天和各种模型打交道的打工人,我对这次发布有三点看法。
第一,能下载、能复现,是它最值钱的地方。Apache-2.0,量化版本齐全,Ollama、llama.cpp、vLLM 都支持。同样是"端侧大模型"的故事,能让我自己把权重拉下来跑一遍的,不多。
第二,"3GB 跑 35B"这句话要拆开读。它依赖的是把专家权重放在存储里按需预取,所以对存储读取速度和内存带宽是有要求的;它说的流畅,是在 iPhone 17 Pro Max、iPad Pro 这一档设备上。换成中低端手机会怎样,目前没有数据。
第三,我这次最大的收获其实是方法:拿到新模型,先找一张自己画的、答案确定的图去测,比看榜单分数更快判断它能不能进我的工作流。
◁ 互动 ▷
你手上有没有一台能装的端侧设备?如果有,欢迎在评论区告诉我你用的机型和实测速度,我想看看官方的 13+ token/s 在普通手机上会是什么样。另外,你会愿意把端侧模型用在哪类场景里,是读图表、识别文档,还是别的?
参考来源
01 面壁智能 MiniCPM-V 4.7 发布报道,环球网,2026 年 10 月 13 日
02 面壁智能发布新一代开源模型 MiniCPM-V 4.7,中国证券网,2026 年 10 月 13 日
03 35B 开源模型流畅跑上手机,面壁智能祭出 LES 提速,华尔街见闻,2026 年 10 月 13 日
04 面壁智能发布端侧多模态大模型 MiniCPM-V 4.7,IT之家,2026 年 10 月 13 日
05 Hugging Face:openbmb/MiniCPM-V-4.7-1B 与 openbmb/MiniCPM-V-4.7-35B-A3B 模型卡
06 GitHub:OpenBMB/MiniCPM-o,docs/minicpm_v4dot7_en.md
07 本文实测数据:作者在云端 32 核 CPU 虚拟机上用 Transformers 运行 1B 版本所得
— END —
感谢阅读 · 公众号:AI Keiran
关注「AI Keiran」