ARTICLE · 1199608
摩根士丹利:大中华区IT服务与软件-2026亚太中国BEST会议要点
外资精译
摩根士丹利:大中华区IT服务与软件-2026亚太中国BEST会议要点
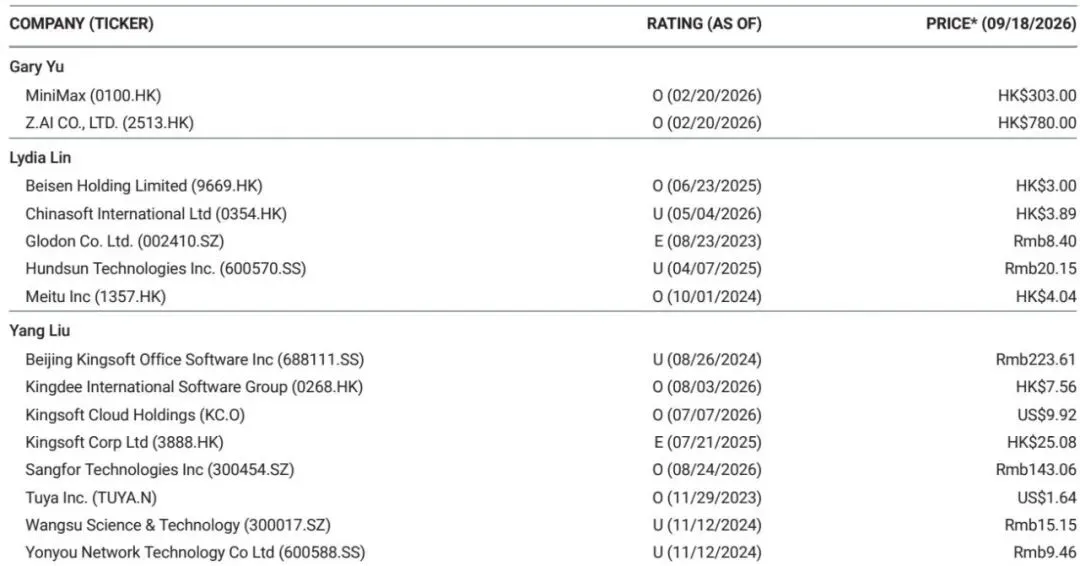
MS在2026年中国BEST会议上,与几家未覆盖的AI相关软件公司做了交流。这份纪要最值得看的判断不是模型能力又进步了多少,而是企业级AI的落地顺序:数据治理和数据分析平台的需求先起来,模型反而排在后面。Xunce(3317.HK,未覆盖)从资产管理和电力、电信、制造业客户那里看到的,正是这一层需求在快速上升。
先看数字背后的机制。Xunce做的是数据基础设施,它观察到企业对数据治理和分析平台的需求明显加快,报告把这称为企业级AI采用的第一步或前提。这个顺序不难理解:模型要产生可用的业务输出,前提是数据本身可读、可管、可追溯。没有这层准备,Agent接进去也只是空转。Xunce正在借这轮技术周期,把商业模式从项目制往消费制转,同时客户开始要求软件商一并解决底层算力需求,软硬一体方案因此更受欢迎。
1. 垂直Agent的定价锚点正在从推理成本转向专业流程成本
Evoken(设计Agent,未上市)和Rabyte(资金Agent,未上市)是两家垂直方向的初创。它们的共同点很明确:瞄准高价值专业工作流,而不是生成内容或答案。Evoken做专业创意生产,Rabyte做机构研究。产品要自动化的是多步骤流程,这决定了变现逻辑——对标的是原有专业流程的时间和成本,而不是模型推理成本。如果这个锚点成立,能建立深度工作流整合的垂直Agent,宏观环境模型会比单纯的模型封装好看得多。
2. 两家垂直Agent都在自训模型,但目的不是追前沿
Evoken和Rabyte虽然行业完全不同,但对基础模型的定位一致:只是产品的一个组件。差异化来自领域工作流、专有数据和细粒度控制。两家都在训练自己的模型,报告明确说,这不是为了在前沿性能上竞争,而是提升领域表现、降低推理成本。这个动作指向一个趋势:随着使用量和专有数据积累,规模化的Agent公司和模型公司正在相互靠拢,垂直玩家会选择性地把模型层内化。
3. 工作流数据和生态可能成为应用层更持久的壁垒
两家公司都强调抓取用户交互和工作流数据,并搭建可复用技能、工作流和资产的生态,与创作者分享收入或token作为激励。这形成一个飞轮:使用越多,专有数据越多,模型和产品功能越好,可复用能力库越大,切换成本越高,网络效应越强。报告把这称为应用层更持久的护城河。把这件事拆开看,模型能力会趋同,但工作流数据和生态的积累很难被复制。
——人工智能免责声明(部分内容由人工智能工具辅助生成)
撰稿:James责编:KC排版:胡桃
Original report: 32-MS-Greater China IT Services and Software - Asia Pacific China BEST Conference 2026 Takeaways-260920
更新信息参见kcdesk.com