ARTICLE · 1204718
AI 编程助手已经够多了,为什么还需要 Multica?
你可能已经同时用过 Codex、Claude Code、Cursor,甚至还在终端里放着 Kimi、OpenCode 或 Copilot。
它们都能读代码、改文件、跑测试。单看一次对话,能力已经很强。可当团队真的把工作交给多个 AI 编程助手,新的问题很快出现:谁在做什么?任务为什么失败?上下文放在哪里?同一个经验怎样复用?改完以后谁来验收?
这正是 Multica 想补上的空位。
它不是另一个更会写代码的模型,也不是新的 IDE。更准确地说,它是一层面向人类与 AI Agent 的工作管理系统:把分散在终端里的执行者,变成有身份、有任务、有记录、能交接的团队成员。
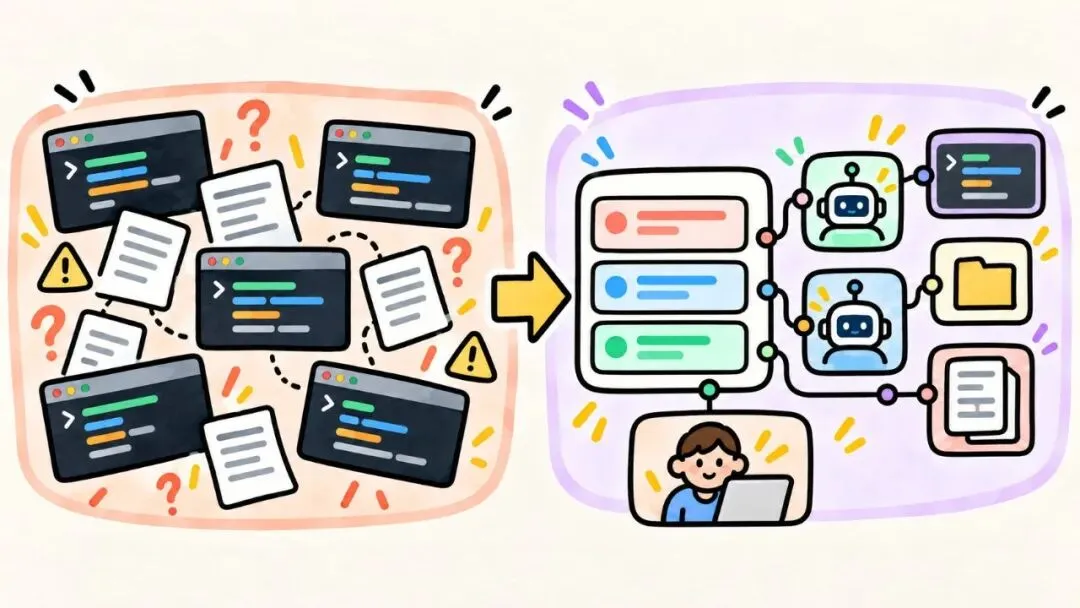
普通 AI 编程助手最擅长的是一次执行:你给提示,它分析代码、做修改、返回结果。
但真实的软件工作很少止于一次提示。一个需求通常要经历理解、排期、执行、等待、阻塞、修改、审阅和关闭。中间还会有人补充条件、切换负责人,或者追问“昨天那次为什么没做完”。
如果所有事情都留在独立终端会话里,管理成本会随着 Agent 数量上升:任务状态只能靠人记;每次会话都要重新解释背景;谁改过什么、为什么这样改,很难统一追踪;运行失败后,团队看不到卡在哪一层;一个 Agent 学到的做法,另一个 Agent 还得再学一遍;最终结果容易停在“代码改了”,而不是“工作被验收”。
这不是模型能力问题,而是协作系统问题。就像一个公司不会因为员工都很聪明,就不再需要任务、角色、流程和审阅。
Multica 补的是五个管理缺口
第一,用 Issue 承载任务,而不是让提示词成为一次性消息。
在 Multica 里,工作首先是一个 Issue。描述、讨论、负责人、状态和最终结果都留在同一条时间线上。把 Issue 分配给 Agent 后,系统会创建一次 Run;在线 Runtime 领取它,再调用本机已经配置好的 AI 编程工具。Agent 可以读取 Issue、评论与项目上下文,完成工作后把结果写回原来的 Issue。
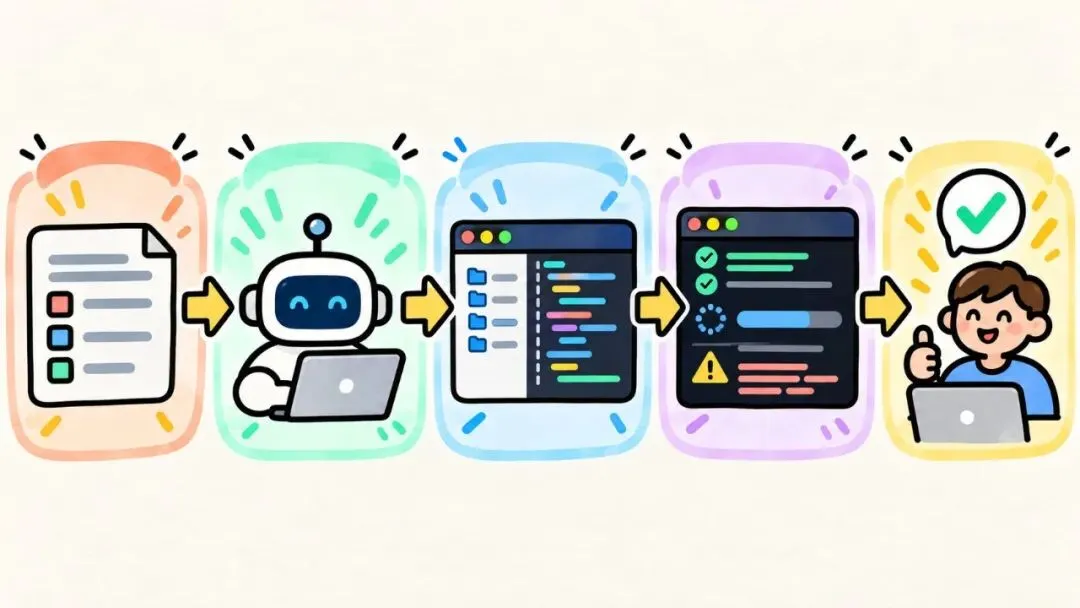
这使任务不再依赖某个终端窗口是否还开着。后来加入的人也能看到“为什么做、做过什么、现在到哪一步”。
第二,把 Agent 变成稳定角色,而不是临时模型窗口。
Multica 中的 Agent 是一套可复用配置:名字、职责、指令、Skills、Runtime、模型和执行设置。同一个 Agent 可以长期负责同一类工作,历史 Issue、评论和 Run 也不会因为换模型或修改指令而消失。团队管理的是“谁负责什么”,而不只是“这次调用哪个模型”。
这一区别很关键。模型回答的是当前提示,角色承担的是持续责任。
第三,把执行过程变成可观察记录。
当 Agent 在工作时,进度、命令、错误和最终结果会回到执行日志与 Issue。Runtime 离线时,任务留在队列中;运行受阻时,也能明确暴露问题。
因此,“Agent 好像没反应”可以被拆成具体问题:是服务、Daemon、Runtime,还是底层 AI 编程工具出了故障。可观察性不能保证每次成功,却能让失败更容易定位和接管。
第四,用 Skills 把一次经验变成团队资产。
很多团队已经有自己的代码规范、发布流程、安全检查和报告模板。问题是,这些知识常散落在文档、聊天记录或某个人的提示词里。
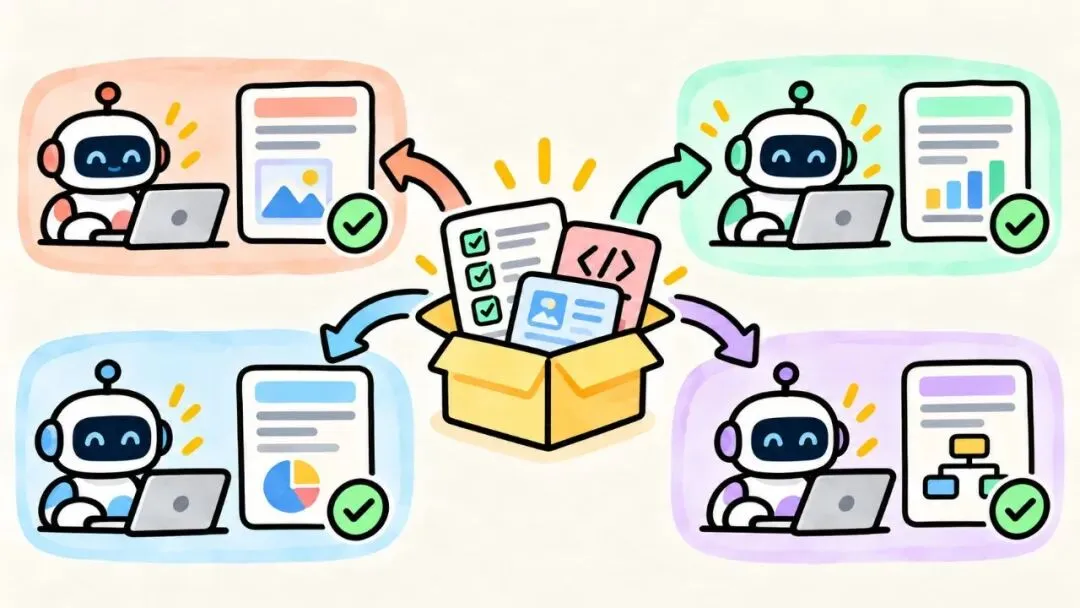
Multica 的 Skill 以 SKILL.md 为主文件,还可以带脚本、模板和参考材料。它适合封装一类可重复的方法,再挂载给不同 Agent 使用。
这意味着一次解决方案可以变成标准作业流程:今天教一个 Agent 做数据库迁移,明天其他 Agent 也可以复用同一套检查步骤。真正有复利的不是单次生成的代码,而是团队持续积累的方法。
第五,把“改完了”与“可以上线”分开。
AI 编程助手很容易让人产生速度错觉:文件已经修改、测试已经执行,看起来任务就结束了。
Multica 把运行完成和 Issue 完成分开。Agent 可以把交付送到 In Review,最终是否接受仍由人根据验收标准决定。官网对这层关系的概括很直白:工作进入审阅,而不是直接进入主分支。
这是生产环境里最重要的边界之一。自动化负责加速,人负责授权。
它如何与现有工具配合?
Multica 不要求团队放弃已经在用的 AI 编程工具。官方仓库[1]当前列出 26 种可驱动的 CLI,包括 Claude Code、OpenAI Codex、Cursor Agent、GitHub Copilot CLI、OpenCode、Kimi 等。
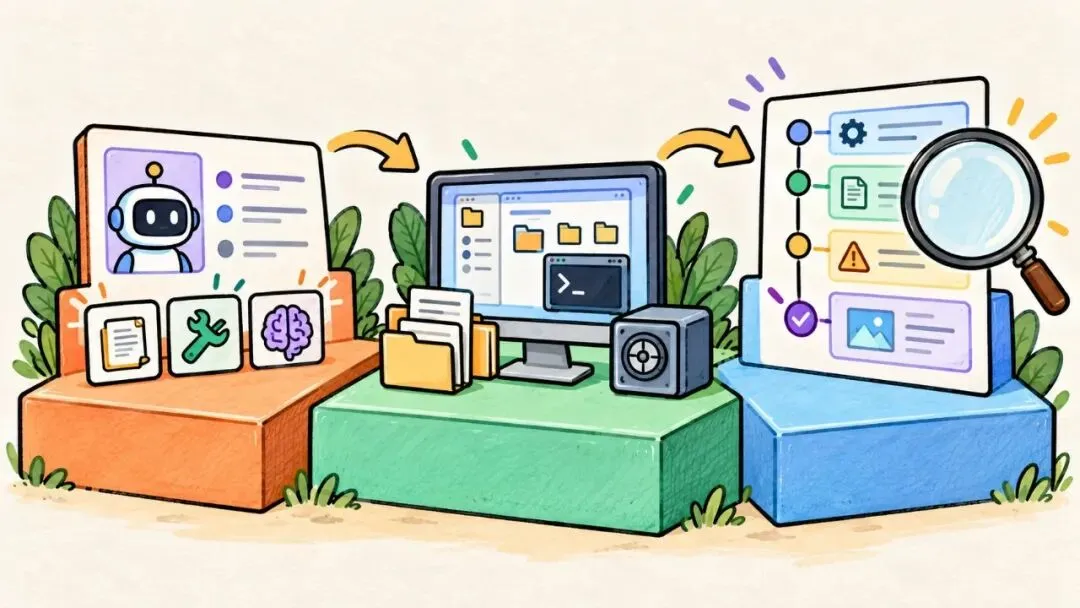
可以把整套关系理解成三层:Agent 决定“谁来做、按什么规则做”;Runtime 决定“在哪台电脑、用哪个 AI 编程工具执行”;Run 记录“这一次具体做了什么、结果如何”。
官方架构文档[2]显示,Multica 负责记录和协调,连接的电脑负责实际执行。工作区、Issue、评论和状态由 Multica 保存;AI 工具凭据、本地目录和真实命令执行留在连接的电脑上。
这个边界也要读完整:代码不必上传到 Multica 才能在本地修改,但底层 AI 编程工具仍会按各自配置,把提示与相关代码发给模型提供商;Issue、评论、附件与 Agent 汇报的进度会进入 Multica 工作区。若对这些工作区数据也有本地化要求,可以选择自托管。
所以它更像 Agent 团队的项目管理与运行控制层,而不是取代底层模型的“超级 Agent”。
什么情况下值得引入?
如果你只是偶尔让一个 Agent 改几行代码,终端会话可能已经够用。引入管理系统本身也有配置成本,不必为了形式增加流程。
Multica 更适合这些场景:同时使用多个 AI 编程工具,希望统一分配与追踪;任务会跨越多个回合,需要持续补充上下文;团队成员都要知道 Agent 做了什么;需要保留执行日志、失败原因与审阅记录;想把高频工作沉淀为 Skills;希望用 Autopilot 定期执行报告、审计或维护任务;或者对代码执行位置、权限和自托管有明确要求。
判断标准不是“Agent 数量够不够多”,而是协调成本是否已经超过一次调用的成本。
从使用工具,到经营一支数字团队
过去我们问的是:“哪个模型写代码更强?”
当多个 Agent 开始进入真实项目,更重要的问题会变成:“任务怎样进入系统?谁负责?运行在哪里?过程能否追踪?经验如何复用?最终由谁批准?”
AI 编程助手解决的是执行效率,Multica 试图解决的是组织效率。
它的价值不在于让一个 Agent 突然变聪明,而在于让多个已经很能干的 Agent 不再散落在终端里:它们有清晰身份,围绕 Issue 工作,在 Runtime 上执行,用 Skill 复用方法,把进度与结果写回共同的工作空间,并在最后一道人工审阅前停下来。
这可能也是 AI 编程从“个人外挂”走向“团队基础设施”的分水岭。
下一篇,我们将实际走一遍:从安装 Multica、连接本机 Runtime,到创建第一个 Agent 并交付一项真实任务。
引用链接
[1] Multica 官方仓库与 README:https://github.com/multica-ai/multica[2] How Multica works:https://multica.ai/docs/how-multica-works[3] Assign issues to agents:https://multica.ai/docs/assigning-issues[4] Multica 官网:https://multica.ai/