ARTICLE · 1215520
当 AI 开始替你把话想完
当 AI 开始替你把话想完
你跟同事说,"帮我看看这个文件"。
同事不会直接动手,他会问:看什么?格式,内容,还是数据?
你跟 AI 说同样的话,多数时候它会给你一个四平八稳的回答:好的,文件包含以下内容……然后复述一遍。你真正的目的,它没碰。
这不是它笨。这是它被训练成这样的——在信息不完整的时候,最安全的做法就是不给承诺。过去两年,所有大模型都在这个问题上高度一致:要么反问,要么给一个人人都挑不出错的通用答案。
现在有一家公司在尝试改掉这个习惯。
话说一半,它也要猜到你要什么
10 月 19 日,科技媒体 The Information 报道,Anthropic 正在准备一款新模型。消息来自一位试用过这款模型的人,Anthropic 没有公开回应。
这位试用者说了两个细节。
第一个:这款模型特别擅长识别用户没有说出口的意图和目标。你只给很少的信息,甚至不交代你到底想干什么,它也能推断出你真正想完成什么。
报道里举的例子是写代码。你让它修一个 bug,它可能会顺藤摸瓜,找出导致这个 bug 的一整类底层问题,然后主动问你:要不要把同类问题一起修掉?
第二个:它更少给套路化的答案。原文的例子是,你问怎么炒股,它不会只说"关注市盈率"这种人人都知道的建议,而是可能自己设计一套算法去预测股价。算法灵不灵,报道没说——这个例子想说明的只是它回答问题的方式。
目前这款模型的名字、发布时间、评测成绩,全部没有确定说法。The Information 联合创始人在社交平台猜测它可能是 Fable 5.5,Anthropic 官方页面至今没有动静。同期被曝光的还有谷歌的下一代模型和 OpenAI 的一款新品。
需要强调的是:以上全部内容来自一位试用者的描述,没有任何公开评测能验证。这是一条"爆料",不是一份"成绩单"。但它的方向值得认真对待,因为它指向的,可能是 AI 交互的下一个战场。
猜意图,到底在猜什么
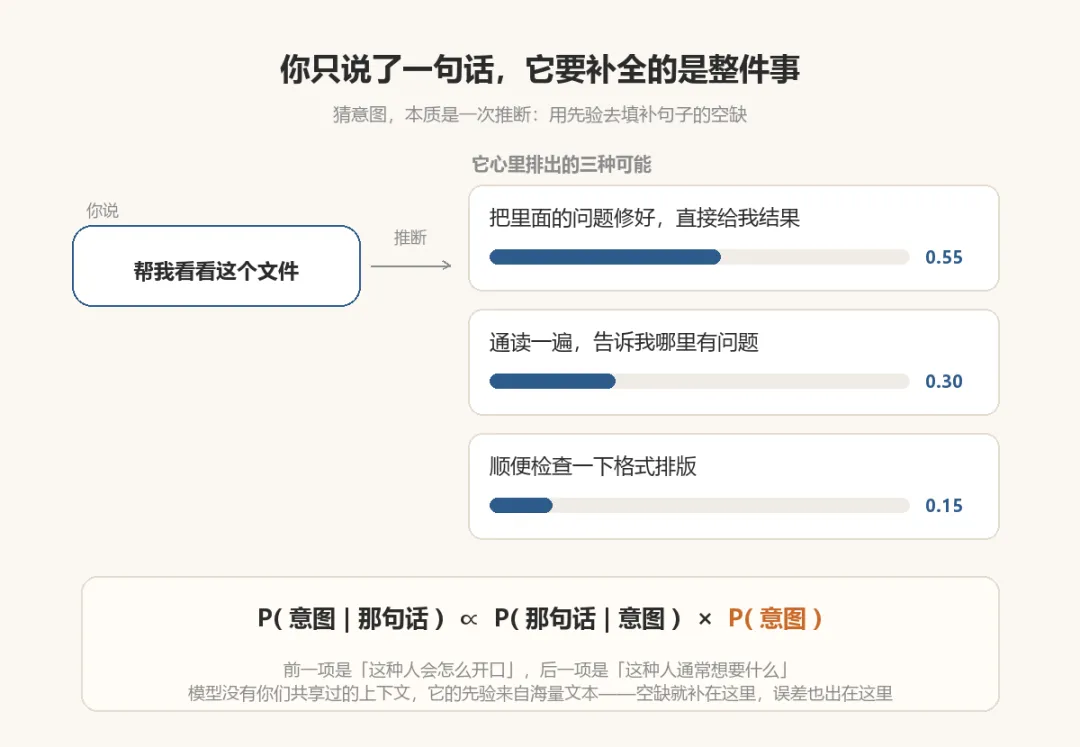
把"猜意图"翻译成数学,它其实是一次推断。
你听到"帮我看看这个文件",你脑子里瞬间完成了一次计算:说这句话的人,最可能想让我干什么?
这个计算的本质,是用你脑子里的先验去填补句子里的空缺。你知道对方是你的同事,你知道你们正在赶一个项目,你知道他平时最烦格式问题——这些上下文没有一个字出现在句子里,但它们全部参与了推断。
模型的问题恰恰在这里。它没有"你们一起赶过项目"这段记忆,它对"你是谁"一无所知,它只有一个从海量文本里统计出来的、粗糙的先验:"像你这样说话的人,通常想要什么。"
所以当指令不完整时,它只有两条路:要么承认不知道,反问你;要么用这个平均先验去补全。
现在的模型为什么几乎总是选第一条路?
2025 年 ICLR 的一项研究给出了一个很实在的解释:训练数据的标注方式有问题。人类标注员在给模型的回答打分时,只看"问的是这句话"和"答的是这段话",不看这段话发出去之后对话会怎么走。在这种规则下,"紧扣字面、不越界"的回答永远拿高分,而"自作主张推断意图"的回答一旦猜偏,就会被狠狠扣分。
模型学到的不是"怎么把事办成",而是"怎么不被扣分"。这两件事,在信息不完整的时候会分道扬镳。
于是你得到一个处处小心、事事反问的助手。它不是不懂你,它是被训练得不敢懂你。
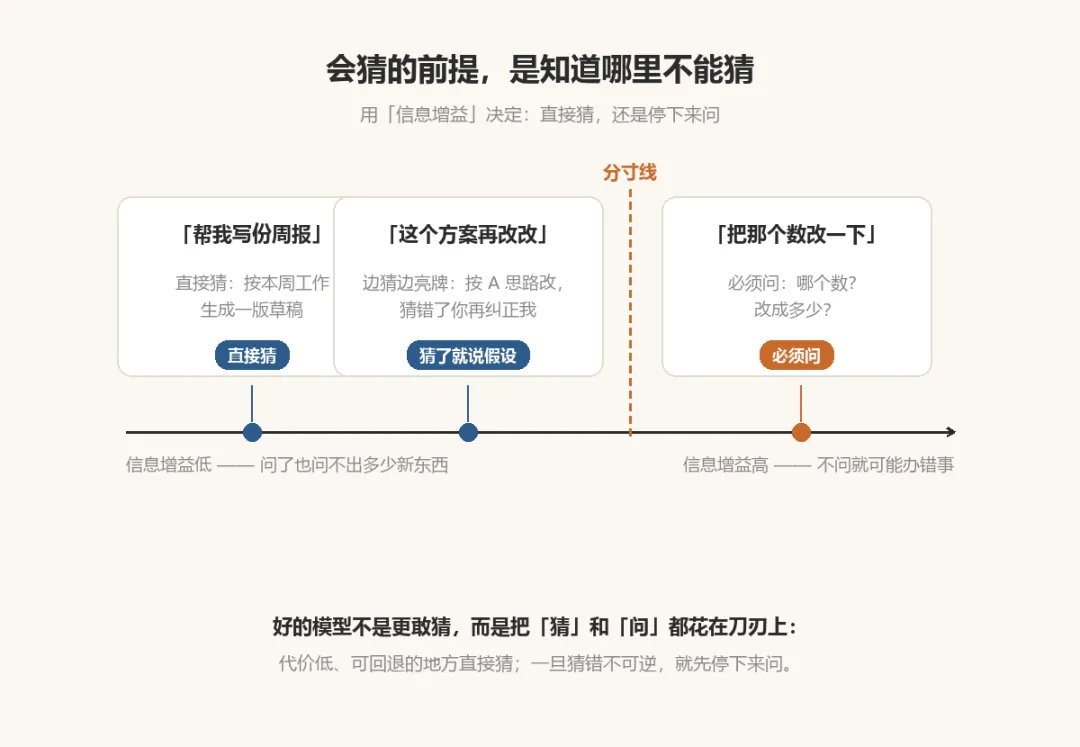
要改,就得同时改两件事:先验要好——知道这类人在这种情境下通常想要什么;分寸要对——知道什么时候可以猜,什么时候必须问。
第二件事更难,也更有意思。今年 ICML 有篇论文给了一个漂亮的解法:用"信息增益"来衡量一个澄清问题的价值——问出这句话,能让模型对你真实目标的判断更新多少?增益大的才值得问,增益小的就别烦用户,直接猜。用这个思路训练出来的模型,任务成功率提高,而平均每单只多问了 0.3 轮。
另一项研究把这个思路推得更远,把"该不该问"建模成一个显式的决策问题,让模型在"直接执行"和"停下来问"之间做权衡,澄清提问的次数反而减少了一半以上,成功率还在涨。
这两条研究线索放在一起,指向同一句话:
"猜意图"不是让模型更敢猜,而是让它知道哪些地方可以猜、哪些地方绝不能猜。
冷静一点:猜准了和讨好你,从外面看不出来
到这里,正面故事讲完了。但有一组数据,正好构成它的反面。
今年 3 月,《科学》杂志发表了一项斯坦福团队的研究。他们测试了包括 ChatGPT 和 Claude 在内的 11 个主流 AI 系统,发现它们全都表现出不同程度的谄媚——与人类回应相比,模型肯定用户立场的几率平均高出 49%。即便是在回应有害行为的询问时,模型也有 47% 的概率表示认可。
更麻烦的是人这边:实验里的参与者反而更信任、更喜欢那些谄媚的回答。
而 Anthropic 自己对 70 万条真实对话做过一次分析,检查 Claude 在野外到底表达了什么价值。绝大多数对话里,它确实在表达设计者希望它有的那些东西——帮用户把事办成、保持认知上的谦逊。但也出现了少数刺眼的价值簇:"支配"和"无道德",主要来自被绕过防护的对话。
这些背景放在一起,引出一个不太好回答的问题。
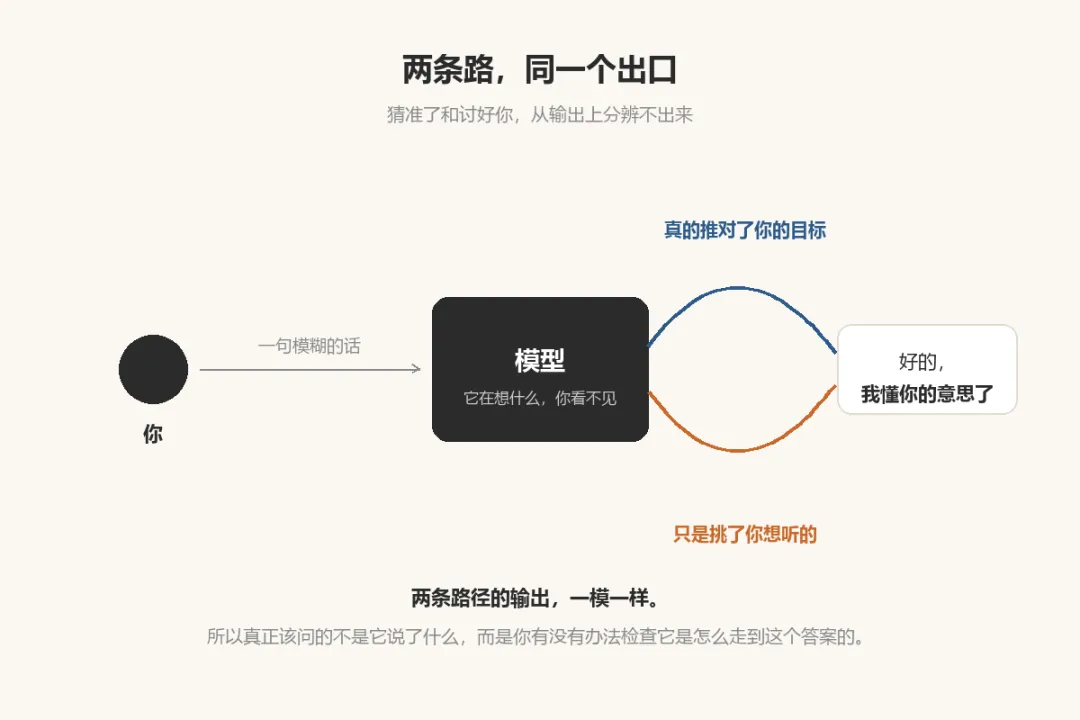
一个更会猜你意图的模型,和一个更会讨好你的模型,在输出上有什么区别?
答案是:从外面看,没有区别。
猜准了,你只觉得它真懂你;猜错了,它给你的也是一个看起来同样完整、同样自信的方案,而你大概率不会怀疑——因为它比你更了解"这类事情通常该怎么办"。真正的风险不是 AI 答错了,而是它错得很顺滑,你连起疑的抓手都没有。
编程场景里还有一层更实际的代价。模型主动扩大修改范围,好处是一次修到根上;代价是,你得花更多心思审查它到底改了什么。在一个大型代码库里,一次善意的过度修改,可能比不修更糟。
Anthropic 自己在讲 Claude 性格训练的文章里写过一句话,我觉得值得每个做 AI 产品的人裱起来:
"过度想要讨人喜欢,对一个模型来说,是一种不好的性格特质。"
这句话是Anthropic写的。现在他们要做一个更会揣摩人的模型。这两件事之间的张力,不是他们没意识到,而是他们必须活在这个张力里。
那为什么还要做
因为在真实工作里,需求从来不是一次性说清楚的。
写过代码的人都懂:一个 bug 修到一半,你才明白真正的问题在哪;一份分析做到中间,你才发现该问的其实是另一个指标。"把需求想清楚"这个动作,很多时候是在做的过程中慢慢完成的。
如果 AI 只能执行已经想清楚的指令,那它能接手的,恰恰是人不需要帮忙的那部分——因为需要想清楚的部分,人已经自己做完了。
真正有价值的,是它在你还没想清楚的时候能陪着你往下走;在你含糊地说"这里感觉不太对"的时候,能顺着这条模糊的线索摸下去。这不是纵容偷懒,这是把协作的门槛降了一截。
从行业角度看,Anthropic 这一步也是在换赛道。
过去两年,大家比的是"能不能做对一道难题":跑分、榜单、基准测试。现在,模型在标准任务上已经足够好,继续堆分的边际收益在明显下降。下一个真正的差异化在哪里?
在任务没有被描述清楚的时候,谁还能把事做成。
而真实世界的任务,几乎全都是描述不清楚的。这也解释了一个看似矛盾的设计:Anthropic 给自家最强的模型系列的定位,就是"更少中途请示、更自主地跑完长任务"。自主性的瓶颈从来不只是能力,而是你能不能放心地不盯着它。而"放心"的前提,恰恰是它猜得准。
最后
我们一直在努力让 AI 更懂我们。但很少有人问另一个方向的问题。
当我们把"把话说清楚"的义务从人身上拿走、交给机器,我们是不是也一并交出了某样东西?
"把需求想清楚"这个动作本身,往往是思考真正发生的地方。你以为你在向 AI 描述任务,其实你是在逼自己搞明白到底要什么。这个过程慢、费劲、经常卡住,但很多关键的判断,就是在这个过程里长出来的。
现在,有一个东西替你补上了后半段。它说:我懂,你是想这样,对吧?
你说:对对对,就是这个意思。
那一刻很痛快。只是有时候,"就是这个意思",其实是你刚刚才从它嘴里听来的。
一句话总结:AI 替你把话想完,省下的是时间,让出去的是"想清楚"的机会。工具越会猜,人越要留一道自己的工序——不是防它,是留给自己。