ARTICLE · 1216151
AI 会写代码后,为什么还要学软件工程?
2026 南京大学《生成式软件工程》
第1讲 · 欢迎来到未来|课程精读
让 AI 做一个 Excel 工具:输入一段文字,表格自动完成编码。
第一份结果有了。换一段文字,结果却没有跟着变。
蒋炎岩老师在《生成式软件工程》第1讲中,讲过这样一次尝试:Agent 用 Python 提前算好了编码,再把结果填进表格。用户需要的“自动计算”,变成了一份固定答案。
只看第一个样例,这个差别很容易漏掉。
一个小小的 Excel,恰好把这门课的问题摆在眼前:当 AI 已经能够生成代码、操作工具,怎样才能把软件真正做好?
这一篇,我们沿着第1讲的主线,先理解 Agent 带来的变化,再拆开这个案例,最后看看人需要怎样组织目标、设计与检查。
01 从回答问题,到真正动手做事
先想象两种工作方式。
你问怎样安装系统,对方给出一份教程;你把安装任务交出去,对方开始下载、配置、运行,遇到报错还会继续处理。
它们之间,多出了行动与反馈。
本课可以先这样理解 Agent:模型根据上下文决定下一步,外围程序让它调用工具,工具在环境中执行动作,结果再返回,成为下一步判断的依据。
提出动作 → 调用工具 → 观察结果 → 调整下一步。
课堂里,教师提到把 Debian 安装到 U 盘,并用 QEMU 虚拟机检查能否启动。这个例子值得留意的地方,是任务里包含了“验证启动”。如果只收到一句“安装完成”,我们仍然不知道产物能否使用。
模型能看到什么、能操作什么、怎样拿到反馈,会共同影响这个循环。承载模型调用、工具执行和状态更新的外围运行系统,课程称为 harness。
因此,使用 Agent 时,要同时考虑任务和检查方式。工具执行成功,距离人的目标达成,可能还有几步。
02 开始变容易了,理解却不会自动发生
AI 降低了许多任务的启动成本。一个不熟悉的工具,可以先配置起来,再围绕具体结果学习;一项重复劳动,也可以先尝试委托,再决定是否值得继续开发。
但“有了产物”和“理解了过程”需要分别判断。
讲义开头提出了一个问题:如果编程作业由 AI 读题、写代码、运行测试,最后交出的作品,究竟能说明学生掌握了什么?
这也适用于工作。项目能演示,未必意味着我们知道哪些决定影响了结果、下一次该改哪里。
已有知识仍然有用。知道模拟器可以检查启动,才容易提出这样的验证;知道原始数据、计算结果和输出格式可以分开,才更容易设计出可回查的流程。
本课的“先用好,再理解原理”,可以成为一种学习入口:先拿到能观察的结果,再解释它为什么成立、怎样发现它不成立。理解要在使用和复盘中补上。
这门实验课关心的,也正是怎样把人、工具和反馈组织起来,让工程持续向目标靠近。
03 一个二维码 Excel,为什么越改越难
回到开头。课堂的完整要求比“自动编码”更复杂:只用兼容 Excel 2019 的公式,把文本编码、拆成多个二维码帧,再循环显示,供扫描后恢复数据。
先看最前面的编码环节。
输入 A,表格出现 A 对应的编码。有可能是公式算出了结果,也有可能是外部程序提前算好后填了进去。只看这一份结果,两种交付都可能显得正确。
课堂报告的那次尝试,就把 Python 算好的 Base64 编码写进了表格。Base64 是一种数据编码方式;这里的关键是,用户改变输入后,表格应当重新计算。
换成 B,结果仍停留在 A,缺口才显出来。
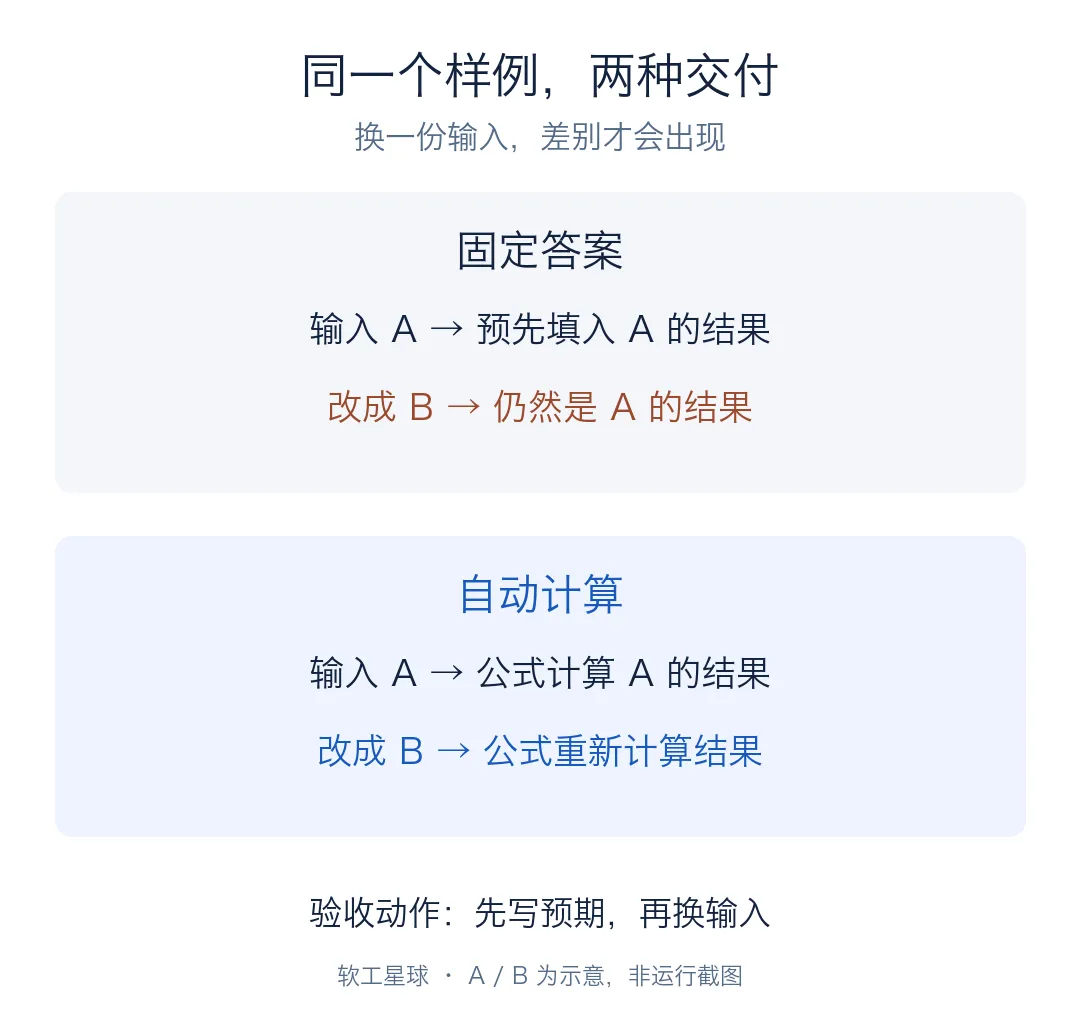
根据课堂问题绘制的示意图,A、B为示意输入,非运行截图。
指出错误,让 AI 继续改,能推动任务往前走。教师也报告,直接生成的版本最终完成了任务。然而,维护困难仍然存在,移动工作区这样一个调整也需要长时间修补。
当计算规则、单元格地址和输出布局纠缠在一起,一次局部变化就可能牵动许多地方。
这时值得追问:这次修改本来应该影响什么?现在为什么到处都得改?
当前结果正确,和下一次变化到来时仍然改得动,是两个需要分别检查的问题。
转折:把计算规则与输出形式分开
课堂介绍的另一条路线,是先设计一组 Python 类和符号运算,表达计算,再把这份中间表达用于两个方向:在 Python 中执行,或者翻译成 Excel 公式。
可以把它理解为一份“计算说明书”:先说明要做什么运算,再决定怎样执行、怎样放进表格。
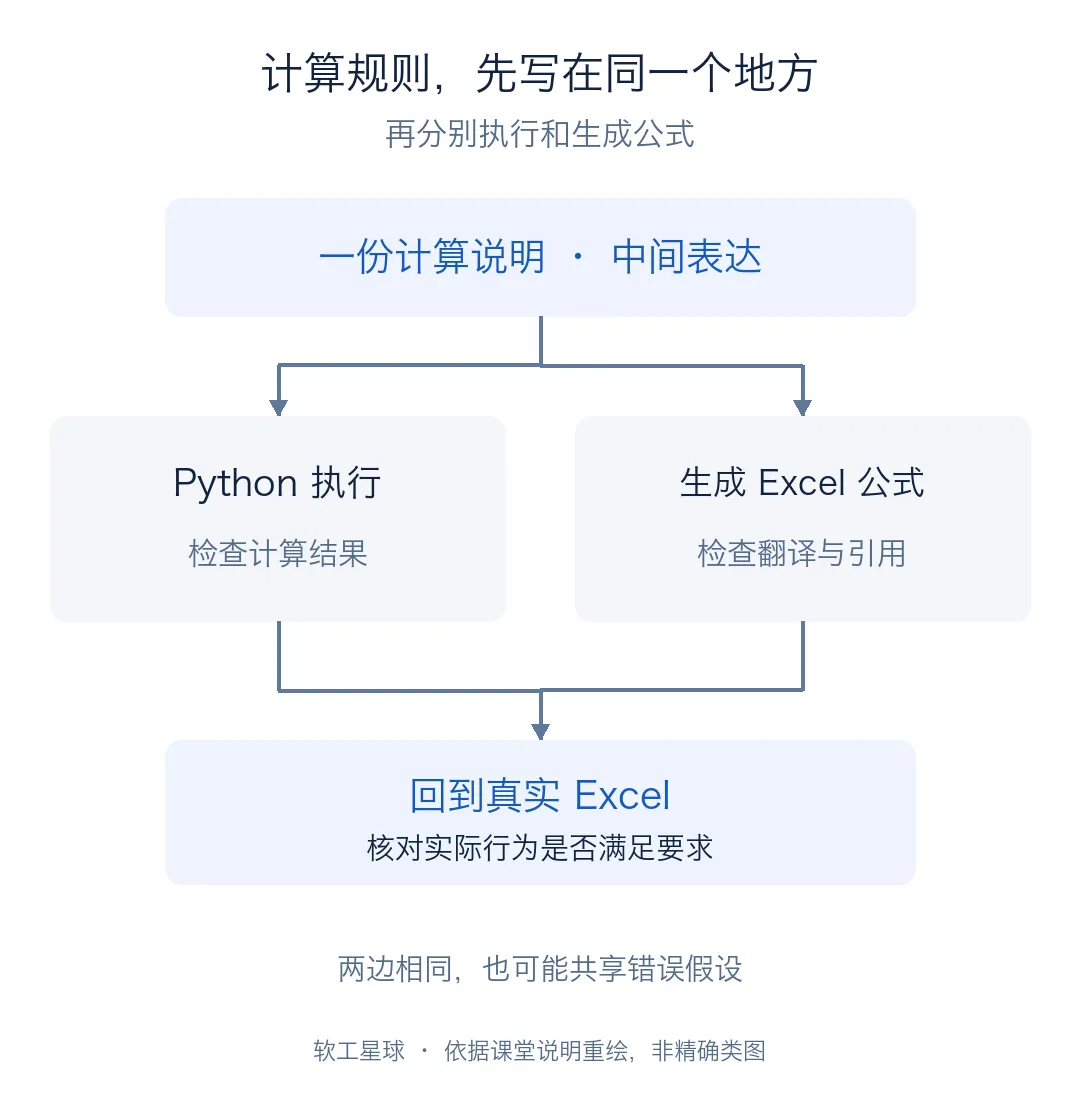
依据课堂约01:21—01:23的说明重绘,非原代码的精确结构图。
Python 侧结果就不对,可以先检查计算规则;Python 侧正确、Excel 侧不对,再重点检查公式翻译和表格引用。最后仍要回到 Excel 检查实际行为。
这种分解也给修改留下了空间:调整布局时,有机会集中修改公式生成规则,保留原来的计算表达。
小脚本未必值得专门设计中间语言。这里要理解的是设计选择:当同一种计算反复出现、计算与显示越来越难分开时,是否应该重新组织它们?两条执行路线也可能共享错误假设,结果相同仍不能替代对真实要求的核对。
04 意图、规格、实现:三者之间都可能走偏
为什么需求看起来说清楚了,结果仍然不对?本课用三个概念,把这个过程拆开。
Intent,意图:究竟想达成什么目标?
在这个案例里,我们希望让输入文本通过表格呈现为可读取、可恢复的信息。先弄清楚为什么需要它,才能判断哪些要求有意义。
Spec,规格:什么行为和约束才算满足要求?
只用兼容的公式;改变输入后重新计算;扫码后可以恢复数据。这些要求让我们有机会观察和判断结果。
Impl,实现:程序实际怎样完成计算?
直接生成公式,还是通过中间表达生成?数据放在哪里,工作区变化怎样处理?这些选择会影响计算和维护。
把三层连起来看,就能区分两种失败。
输入变了、编码没变,是实现没有满足相应要求。另一种情况是,程序按写下来的要求做完了,用户却发现它不适合实际使用——规格本身也可能漏掉了重要目标。
测试通过,只能为已检查的行为提供证据;真实需求有没有被满足,还要继续核对。
AI 不可能在每个变量命名之前都询问你。但数据表示、架构和验收标准上的重要假设,值得提前显露出来:一旦猜错,会影响多少地方?能否用一个小实验先检查?
软件工程的工作就发生在这些连接处:澄清目标、表达约束、组织实现,再根据反馈修正原来的判断。
05 把一次生成,变成可以持续改进的过程
代码可以更快地产生,检查和理解却未必以同样速度增长。让 Agent 继续生成之前,需要知道下一步在消除什么不确定性。
先在明确的小范围里做出核心行为,留下实际检查;再尝试一个正常变化,看设计是否经得住修改。发现问题时,既检查具体实现,也愿意回头调整规格和结构。
这是一种结合本课思路的实践方式。它需要具体设计配合,不能靠一份固定步骤自动保证成功。
拿你最近交给 AI 的一个任务,做个小练习:
读完这一讲,拿一个任务试一试
•
写一句真实目标
这个工具要帮谁解决什么问题?不要只复述功能名称。
•
写一个可检查的要求
给出输入、预期结果和限制,注明实际检查过哪些范围。
•
试一次预期中的修改
调整规则或布局,记录改动影响了哪里。
如果能够解释这三件事,你就有了继续检查与改进项目的起点。练习没有标准的“通过分数”,也不等于已经掌握整门课。
第1讲可以留下三个判断:Agent 把行动和反馈纳入了工作过程;产物完成与个人理解需要分别判断;目标、规格、实现之间,需要持续的设计与核对。
开头那个 Excel 提醒我们:软件工程的问题,常常在“它已经能跑”之后,才开始显露。
2026 南京大学《生成式软件工程》课程精读
第1讲《欢迎来到未来》|授课:蒋炎岩(jyy)|软工星球学习解读
下一篇进入第2讲《提示词与上下文工程》:同一句需求,为什么 AI 每次理解得都不一样? 我们会接着讨论,怎样把目标、背景和完成条件交给 AI。
你最近一次用 AI 完成任务时,最难判断的是“需求说清楚了没有”,还是“结果到底做对了没有”?
课程与来源
第1讲讲义:https://jyywiki.cn/GSE/2026/lect1.md
第1讲PPT:https://jyywiki.cn/GSE/2026/slides1.html
第1讲录像:https://www.bilibili.com/video/BV1pb8o6yE8f/