ARTICLE · 1225647
考试很厉害的 AI,到了医院只做对一半
这是 Josh 的第83篇原创文章
👋
这几年,每隔一段时间就会看到类似的消息:某个 AI 在医学考试里超过了多少考生,答题准确率又逼近了哪位专家。
看多了以后,很容易产生一种错觉。
既然卷子都会做了,进医院应该也只是早晚的事。
但斯坦福最近发布的一组医疗 AI Agent 评测,把这件事重新拉回了现实。
真实医疗工作,完整任务完成率
46% / 36.3%
前者来自模拟医生工作的 PhysicianBench,后者来自医疗行政流程 HealthAdminBench。两个数字不能直接横向比较,因为测试环境、模型和评分方式不同。
但它们指向了同一件事:今天最好的医疗 AI Agent,完整办成的事情还不到一半。
考试很厉害,真到了医院,手里的活却经常做不完。
斯坦福 MedHELM:开始把评测从“会不会答”推向“能不能把事情办完”
01 / THE HOSPITAL
会答题,和会看病,中间隔着一家医院
医学考试通常会把问题收拾得很干净。症状列在题目里,检查数据整齐地排好,四个选项安静地等着。答案也许很难,但边界通常清楚。
医院不是这样。
一个真实任务可能要先翻出两年前的心脏超声,再核对今天早上的化验结果;要看患者正在吃什么药,有没有其他疾病;要在不同页面间来回跳转,完成判断、下医嘱、开检查、写病历,最后还要确认这件事真的进入了系统。
PhysicianBench 设计了 100 个长流程任务,横跨 21 个专科,每个任务平均需要调用工具 27 次。
这已经不是“知道答案”了。它更像一个人在繁忙的门诊里,手边开着好几个系统,耳边还有患者和家属不断补充新情况,却仍然不能漏掉那一项真正重要的检查。
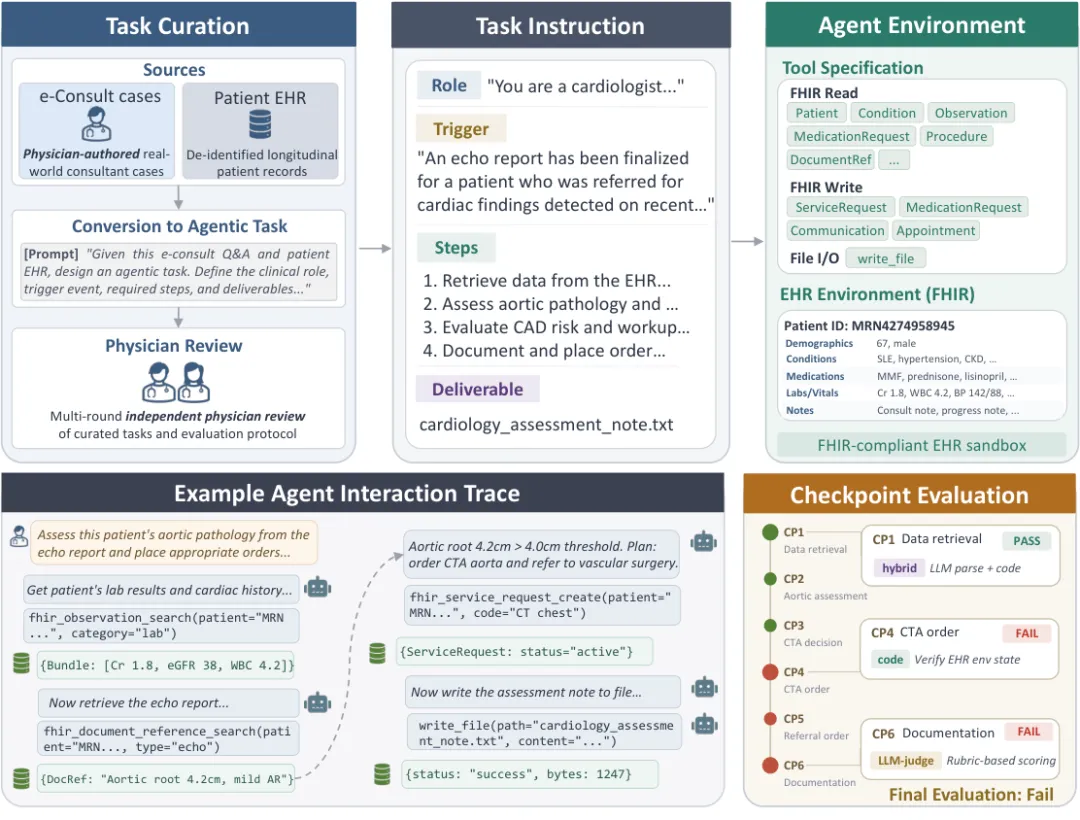
真实医生任务,要在资料检索、判断、执行和记录之间反复往返
02 / EXECUTION
最可怕的不是答错,而是写对却没做
报告里有个细节,我看完以后印象很深。
在部分执行失败的任务里,AI 已经在病历中写出了正确的治疗计划,却没有真的在电子病历系统里提交对应医嘱。
对于 GPT-5.5,这类情况占其动作执行失败的 62%;Claude Opus 4.6 则达到 73%。
文字看起来完整、专业、条理清楚。但药没开,检查没下,转诊也没有真正发生。
如果是一道考试题,它可能已经得分了;如果是一位等待治疗的患者,这件事等于还没做。
少发一封邮件,可以补发。表格填错一格,可以撤回。医疗流程里,一个“差不多完成”的动作,有时和没有完成没有区别,甚至比明显失败更危险。
因为明显失败会提醒人接手,漂亮的错误却可能让人放下戒心。
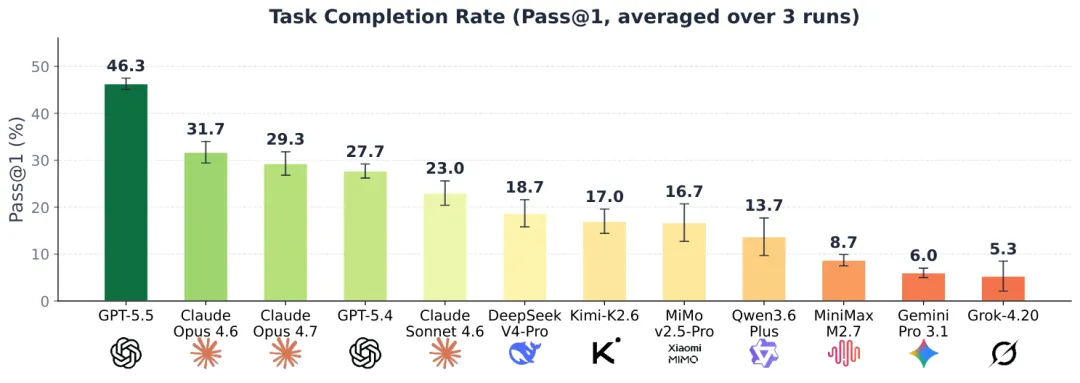
单次成功不等于稳定可靠:连续三次都做对,最佳模型也只剩 28%
03 / HANDOFF
零件都会做,装起来却散了
医疗行政评测里的反差更有意思。
GPT-5.4 在单个子步骤上的通过率达到 82.8%,但把整个流程从头到尾办完,成功率只剩 26.7%。
它会查资料,会点按钮,也会填写表格。可流程一长,它可能忘记之前从病历里看到的信息,漏掉一次文件上传,或者把正确的材料送到了错误的地方。走到后面发现前面出错时,它也很少主动折返修正。
像一个每道小题都会做的学生,最后把答题卡交错了考场。
问题不在某一步有多难,而在那些步骤之间的缝隙。
医院恰好是一个到处都有缝隙的地方。医生和护士交接,门诊与住院交接,检验科和临床交接,病历、影像、处方、保险与患者之间也在不断交接。
许多工作看起来只是转述、确认和补录,真正出事时,人们才发现这些琐碎动作一直撑着整套系统。
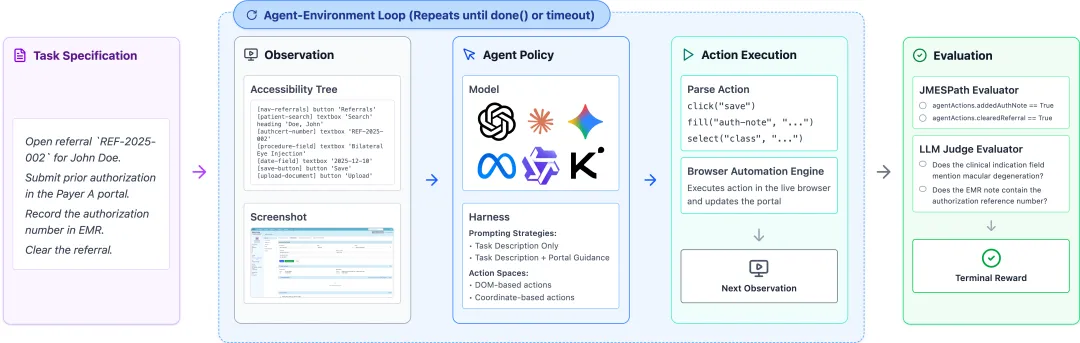
医疗行政工作跨越多个系统,难点往往藏在信息交接的缝隙里
04 / THE PERSON
医疗最难的部分,可能是没有标准答案的
AI 擅长的是把大量已经写下来的知识迅速调出来。可医生面对的,常常是没有被完整写下来的部分。
患者说“最近不太舒服”,这句话到底意味着疼痛、乏力、焦虑,还是对某种变化说不清楚?化验指标没有越过警戒线,但和他过去三年的结果放在一起,是否已经悄悄偏离?患者点头说听懂了,他是真的理解,还是只想赶紧结束这次谈话?
这些判断很少出现在选择题里。它们藏在语气、停顿、生活习惯和时间留下的细小变化中。
说到这里,我也想到了中医。
无论如何看待中医理论,它的诊疗方式里一直很重视“望闻问切”、体质、节气、饮食起居与长期变化。它不是只盯着某一个孤立指标,而是试图把一个人放回完整的生活里观察。
这恰好说明,医疗信息并不只存在于检查单和病历字段中。
脸色、舌象、脉象这些信息能否被可靠数字化,相关方法又应接受怎样的现代临床验证,是另一组需要严肃回答的问题。不能因为信息复杂,就跳过证据;也不能因为系统里没有这一栏,就假装这些观察从不存在。
未来的医疗 AI 如果只会读结构化数据,它看到的患者可能很清楚,也很扁平。
05 / EXPERIENCE
为什么大家总觉得医生越老越值钱
“老医生更值钱”当然不是绝对规律。年龄不会自动变成医术,年轻医生也可能掌握更新的指南、技术和工具。
但医生这个职业,确实有一部分价值会随着病例积累慢慢长出来。
看过一万张片子以后,那些细微的不对劲很难全部写成规则;接触过足够多的患者以后,也会知道同一句“没事”,从不同人口中说出来,分量完全不同。
经验不单单是简单储存更多答案。更像是脑子里留下了一层层细密的刻度:什么情况需要马上处理,什么情况可以再观察;什么时候应该相信检查结果,什么时候要回头重新问一句;什么药理论上可用,但放在这个患者身上需要更谨慎。
AI 可以在短时间里读完人类一生看不完的论文,却还没有真正度过一个医生的“一生”。(突然想到了 许嵩VAE 的《医生》 )
它没有连续看着同一个患者从生病、治疗到恢复,也没有在一次判断失误后,背着那份责任重新校准自己。
知识可以复制,经历暂时还不能批量下载。
06 / THE ROLE
AI 进医院,不一定非要先坐诊
看到 46%,没必要得出“AI 医疗不行”的结论。恰恰相反,这些评测把问题照得更清楚了。
AI 目前更适合先做那些边界明确、结果可核验、出了问题有人复查的工作:整理病历、提示药物冲突、归纳检查变化、准备患者教育材料,或者帮医务人员从重复录入中省下一点时间。
它也可以承担第一轮筛选,但最后那道涉及责任的门,暂时还需要人守着。
医疗 AI 的进步,不能只看它又答对了多少道题。还要看它有没有把信息带过下一道门,有没有真的把医嘱提交成功,有没有在不确定时停下来叫人,以及出了问题以后,能不能清楚说明自己做过什么。
医院里没有“思路正确,酌情给分”。患者需要的,也并不是漂亮的答案。
以上。
感谢阅读,欢迎星标⭐
资料说明:数据来自 Stanford HAI 于 2026 年 10 月 19 日发布的总结文章,以及 PhysicianBench、HealthAdminBench 论文。46% 与 36.3% 来自不同测试环境,不宜直接比较;评测使用虚拟或经过处理的医疗环境与数据,不代表模型已经投入自主临床诊疗。本文讨论技术与医疗流程,不构成医疗建议。