ARTICLE · 1227011
AI赋能酶发现再升级
摘 要
提高酶的有用属性仍然是一个昂贵且耗时的过程。扫描已知蛋白质序列数据库以寻找具有相似催化活性和增强属性的酶,是一种高效且有价值的方法。EnzymeMiner网络服务器已被证明是一个自动化、用户友好的工具,能够从提供的序列和必需残基中识别具有所需催化活性的酶。本研究中,团队推出 EnzymeMiner 2.0,它在继承前代版本原有功能的基础上,引入了几项关键改进:(i) 显著扩展了搜索的蛋白质空间;(ii) 利用最先进的计算工具,对发现的序列进行熔融温度、最适 pH、催化活性和效率以及聚集倾向的注释;(iii) 基于用户定义的目标或一组预定义场景,实现智能自动化的序列优先级排序和筛选。凭借所有这些增强功能,EnzymeMiner 2.0 旨在保持新型酶高效发现领域的领先解决方案之一。
介 绍
生物催化增强是科研和工业领域的关键技术。从蛋白质数据库里筛选出具备目标特性的天然酶,是获取高效生物催化剂的主流方案。目前蛋白序列搜索工具虽然不少,但能同时兼顾催化活性和酶学属性筛选的工具极少。FoldSeek依赖结构数据库,但结构相似不代表活性相似,还得人工筛选。常规序列库的序列多样性不够,宏基因组数据挖掘门槛又高。GeneSurfer、DeepMineLys等工具要么操作复杂,要么只适配单一酶家族。Selenzyme、REME的数据库体量小,更适合筛选稀有或非天然反应的酶。总之,易用、通用、带属性注释和智能筛选的酶挖掘工具非常稀缺。
2020年上线的EnzymeMiner已经完成了11700次运行任务,是主流的自动化酶挖掘工具。但它有三个缺陷:候选序列注释有限,没有智能筛选和优先级排序功能,也不支持宏基因组数据库搜索。
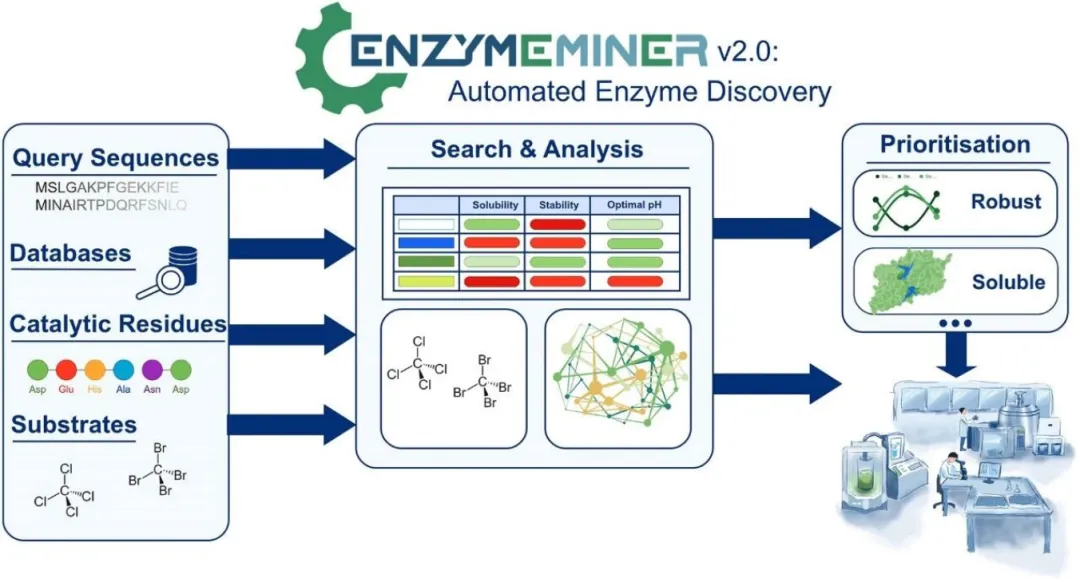
EnzymeMiner 2.0在保留原有流程逻辑的基础上完成了升级。它新增了MGnify宏基因组库搜索功能,整合了CataPro、TmProt、OphPred、AggreProt等工具,可以实现酶活性、解链温度、最适pH、聚集倾向的预测注释,还搭载了选择向导来实现智能筛选和排序。这使它成为高效新酶挖掘的领先解决方案。
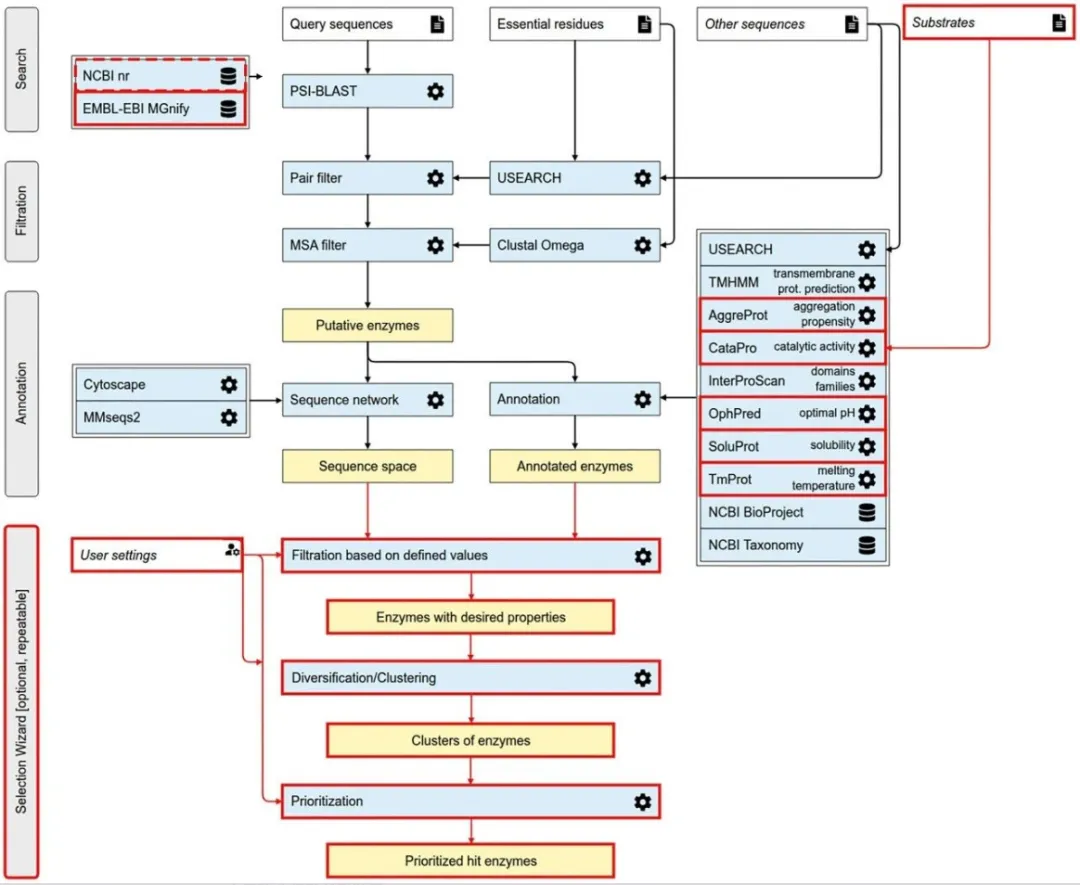
图 1. EnzymeMiner 2.0 工作流程示意图
工作流程
EnzymeMiner 2.0的工作流程分为搜索、过滤、注释三大步,筛选是可选步骤。整体运行时长通常为6到36小时。流程中深度融合了AI技术与蛋白质序列、功能数据,其中AI属性预测是连接序列与酶表型的核心模块。
搜索步骤
用户需要输入目标蛋白质序列(最多10条)和酶的关键功能残基,也可以补充输入已知同源序列与反应底物。系统基于用户选择的数据库,通过PSI-BLAST完成同源搜索,富集候选序列。
1.数据库配置:默认使用2025版的NCBI nr数据库,包含大约8.5亿条序列。也可以切换到2024年5月版的EMBL-EBI MGnify宏基因组数据库,它包含24亿条序列。总搜索空间达到32.5亿条。
2.搜索逻辑:沿用初代的同源搜索框架,基于用户查询序列,在目标数据库中匹配高同源性序列,完成候选酶的初步富集。
过滤步骤
对搜索获得的候选序列,通过双序列比对过滤和多序列比对过滤,验证关键功能残基的保守性,剔除无效序列:
1.双序列比对过滤:通过USEARCH把候选序列和用户输入的序列做两两比对,筛选出满足关键残基要求的序列,并完成聚类。
2.多序列比对过滤:对每一类聚类序列,用Clustal Omega构建多序列比对,从进化维度重新验证关键残基的存在,完成高精度过滤。
注释步骤
1.聚集倾向预测:用AggreProt预测单残基的聚集倾向,计算标准化的序列聚集评分。相对聚集评分的计算公式是:相对聚集评分=log₂(候选序列聚集分数/模板序列聚集分数)。
2.催化活性与效率预测:通过 CataPro 深度学习工具,针对用户输入底物预测催化周转数(kcat)与催化效率(kcat/KM),将对数尺度结果转换为绝对数值;
3.最适 pH 预测:用大语言模型工具OphPred,预测酶的最适反应pH。
4.解链温度预测:通过 TmProt 预测酶的解链温度,评估热稳定性;
5.可溶性预测:通过TmProt预测酶的解链温度,评估热稳定性。
6.辅助注释:通过TMHMM预测跨膜结构,用InterProScan注释结构域,用Cytoscape构建序列相似性网络,用NCBI Taxonomy完成物种分类注释。
所有预测结果都整合到目标选择表里,可以直接用于序列筛选、排序和可视化分析。预测结果都是近似估值,用于辅助候选序列的筛选。
筛选步骤
1.过滤:设置酶属性的阈值,剔除不符合要求的序列。
2.多样化聚类:基于属性相似性进行聚类,确保筛选出的序列覆盖最大的序列-属性空间。
3.优先级排序:根据用户设定的目标,选出最优的候选序列。
4.预设策略:提供了稳健型酶、可溶性酶、稳定型酶、嗜极酶、近同源酶、远同源酶这6种预设策略,也支持高级参数的自定义。
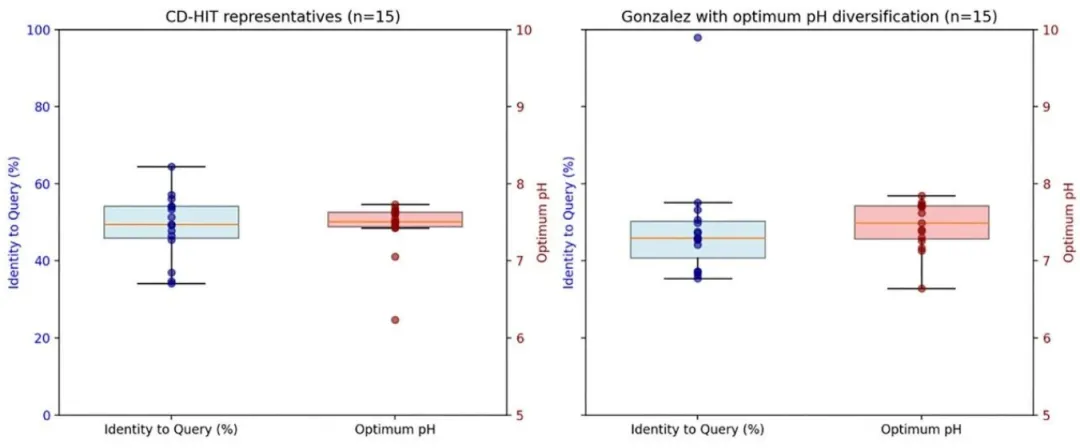
图 2. EnzymeMiner 1.0 与 2.0 多样化方案对比
网页服务器输入与输出
1.输入模式:提供两种输入方式,一种是基于Swiss-Prot注释序列的模式,输入酶学委员会编号就能自动选取序列和关键残基;另一种是自定义序列模式,手动输入FASTA格式的序列并定义关键残基,还支持高级设置来调整数据库和搜索参数。
2.输出结果:核心输出是目标选择表(包含11个工作表)和序列相似性网络可视化图谱,支持结果下载,任务完成后会发邮件通知。
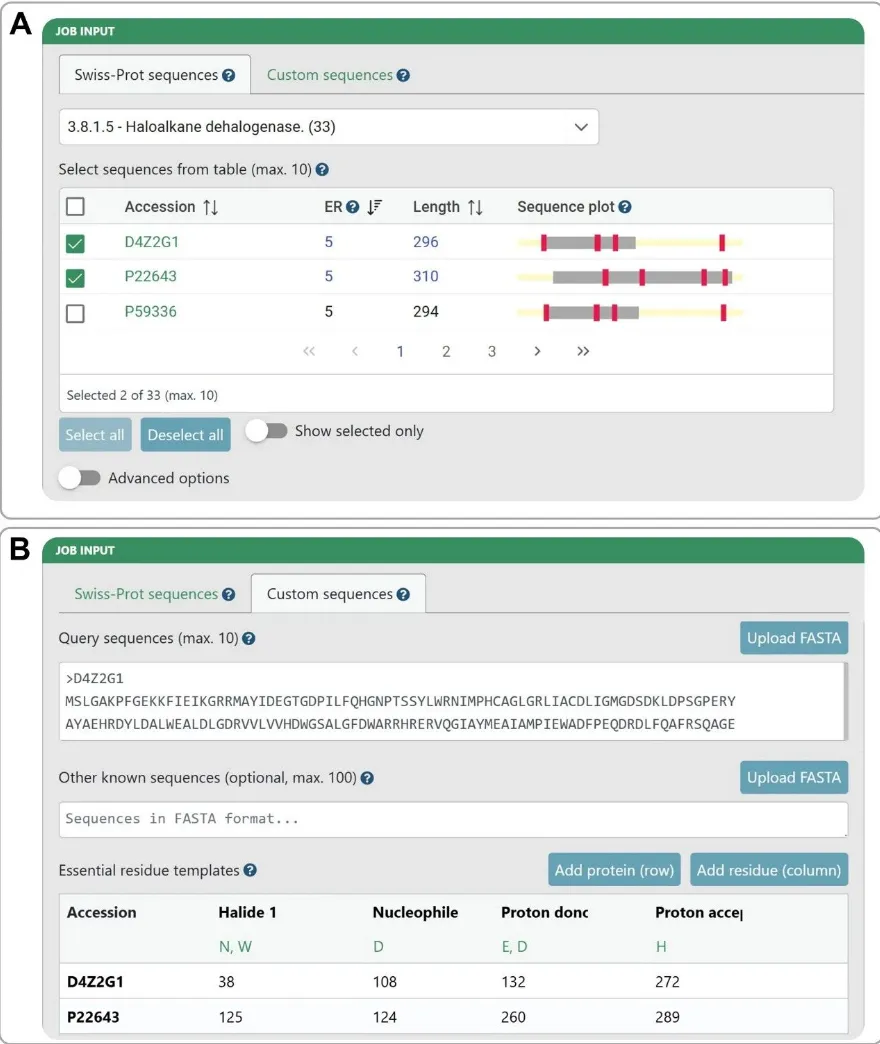
图 3. EnzymeMiner 2.0 输入选项
结果输出
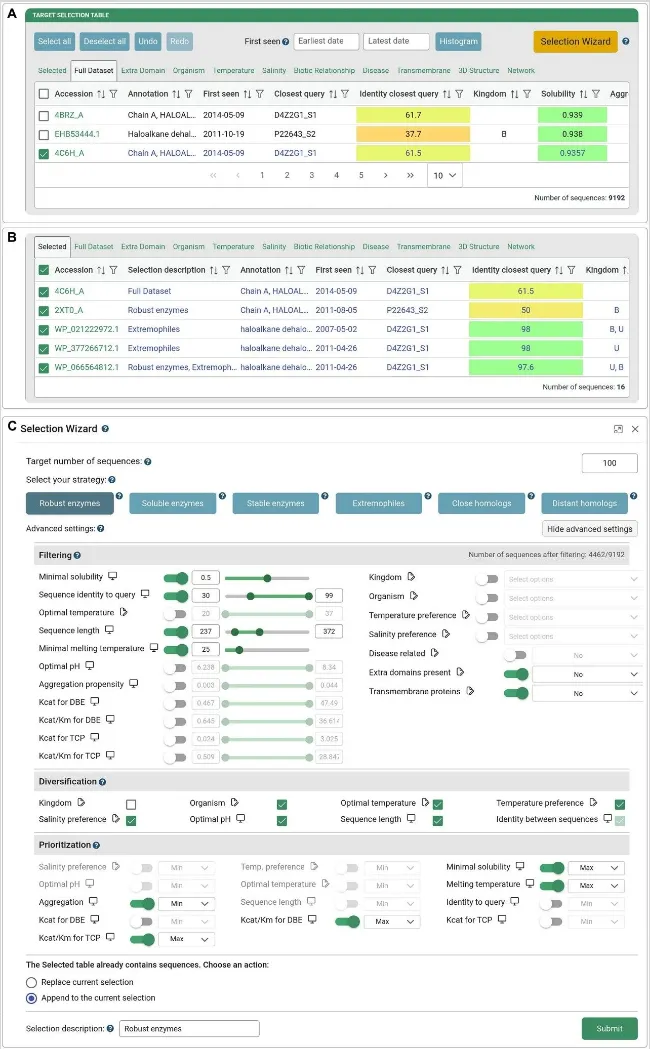
图 4. EnzymeMiner 2.0 结果页面
工具核心性能升级结果
1.序列搜索空间实现跨越式拓展
NCBI nr数据库从初代的3.6亿条更新到了8.5亿条,新增的MGnify宏基因组数据库有24亿条序列,总搜索空间达到32.5亿条。这是第一次实现传统数据库与宏基因组数据库联动搜索,解决了序列多样性不足的行业痛点。
2.AI多属性注释体系完成落地
整合AggreProt、CataPro、OphPred、TmProt、SoluProt这五个工具,实现了酶热稳定性、pH适应性、催化活性、可溶性、聚集倾向这五大核心属性的全自动预测。标准化聚集评分和催化参数数值转换,让注释信息可以直接用于酶性能评估,注释维度比初代明显提升。
3.智能筛选模块大幅提升筛选效率
Selection Wizard模拟了资深科研人员的筛选逻辑,把人工数天的筛选工作压缩到分钟级完成。6种预设策略覆盖了主流科研和工业场景,多样化聚类保证了序列多样性,优先级排序实现了靶向筛选,大大降低了实验验证的时间和金钱成本。
实际应用案例
1.案例1:环境修复用稳健型卤代烷脱卤酶挖掘
以LinB(D4Z2G1)和DhlA(P22643)为查询序列,输入1,2-二溴乙烷、1,2,3-三氯丙烷这两种污染物底物,在NCBI nr数据库里挖掘:
1)序列获取:获得9000多条候选卤代烷脱卤酶序列,比初代版本多了2.3倍,覆盖了多种细菌物种。
2)筛选效果:通过稳健型酶策略,剔除了带有跨膜结构或额外结构域的序列,结合AI预测的可溶性、热稳定性、催化效率,快速筛选出了适配生物修复的候选酶。
3)靶向优化:针对高毒性底物1,2,3-三氯丙烷,调整优先级规则,最大化它对这种底物的催化效率,同时最小化对1,2-二溴乙烷的活性,获得了选择性变体。序列相似性网络证实候选酶分布在不同的进化分支上,序列多样性充足。
4)预测准确性:回顾性分析显示,AI预测结果跟实验测定值高度吻合,符合工具原始文献的性能标准。
2.案例2:医药合成用新型氟化酶挖掘
天然氟化酶资源极度稀缺。2022年团队用EnzymeMiner 1.0只发现了16条候选序列。这次用同样的参数,通过2.0版本挖掘:
1)序列获取:获得44条独特的氟化酶序列,比初代研究结果多了2.8倍。
2)新序列发现:剔除已报道的序列后,得到31条全新的氟化酶候选序列,大幅扩充了全球已知的氟化酶资源库。
3)优先级排序:依托AI预测的催化效率、可溶性、解链温度,完成了新序列实验验证的优先级排序,为后续实验提供了精准指导。
优势与创新
1.EnzymeMiner 2.0的总搜索空间达到32.5亿条,比初代扩大了9倍。首次纳入了宏基因组资源,新酶发现能力提升了2.3到2.8倍。
2.AI驱动的多属性预测体系,实现了酶核心工业性能的全自动注释,预测准确性符合行业标准。
3.Selection Wizard智能筛选模块实现了人工筛选流程的自动化,兼顾了候选序列的靶向性和多样性。
4.两个应用案例证实,这个工具可以高效应用于环境修复、医药合成等领域的新酶挖掘,具有很高的科研和工业应用价值。
讨论与结论
EnzymeMiner 2.0是一个基于蛋白质序列和定义的必需残基,从蛋白质序列数据库中挖掘酶的网络工具。它不仅提供推定的命中序列,还提供由最先进工具预测的蛋白质属性注释,以及序列相似性网络。
EnzymeMiner 2.0支持在经典数据库和宏基因组数据库里搜索,并自动通过近年来发表的几种先进工具来注释蛋白质命中。它还引入了一个独特的、基于用户定义目标的智能自动化优先级排序和蛋白质候选选择功能,通过“选择向导”提供简单和高级设置。“选择向导”旨在通过智能、整合的方法,针对几种常见情况量身定制,重现用户传统上采用的手动选择策略,从而简化流程,减少候选选择所需的时间和手动工作。
目前的实现方式大大扩展了搜索的序列空间。不过它还可以通过纳入更多数据库(特别是宏基因组和基于结构的数据库)来进一步改进。目前这个工具不包含结构分析,尽管这类功能会很有用,因为蛋白质结构为功能和物理化学属性提供了重要的见解。出于这个原因,团队计划在下一版本的EnzymeMinder中加入结构属性的分析或预测,比如活性位点空腔、分子通道或分子对接,并利用AlphaFold数据库。未来的改进还可能包括添加更多可能的底物输入格式,比如PubChem CID或ChEBI ID。
近期会议推荐
点击热门课题
(点击会议名称查看文件)
【9月28-29日】线上直播 -特医食品从产品定义到商业化落地培训班
(10月28日- 29日)线上直播-2026药品质量授权人(QP)实操高级培训班
上海 【10月22-24日】 功能性宠物食品配方设计、工艺研究与功效评价
线上【10月15日-16日】从食品添加剂合规到标签切换落地培训班
济南(10月23-25日-)AI酶生物元件挖掘与实践改造培训
【国际营养师.公共营养师证书办理】就业前景好!国际营养师·公共营养师岗位能力培训报名来啦!特别是这些人记得看!
关注公众号 加微信了解更多内容 感谢帮忙转发
商务合作:13810405524(微信)