ARTICLE · 1227015
分页省的不是 KV 字节:vLLM 源码走读
上一篇我在 4090 上把 KV 字节与公式对到误差 0.0%,结论是显存账可以纯算。这篇去读 vLLM 0.26 的分页实现,因为有个数字对不上:同一张卡、同一个 7B,vLLM 启动日志报"GPU KV cache size: 106,432 tokens",而我按公式算的每 token 57,344 B 乘回去正好等于它报的 5.68 GiB。分页一个字节都没省。 那它到底省了什么,值不值 kernel 复杂度的代价?源码里有答案。
摘要:vLLM 0.26 实测 4090/7B:KV 5.68 GiB、8k 最大并发 12.99 倍——每 token 字节与公式逐位相同,省掉的是按最大长度的预留与每步重建缓存的拷贝,旧系统有效率仅 20.4%–38.2%。
TL;DR:
• 分页后每 token 仍是 2 × 层 × KV头 × head_dim × 字节= 57,344 B;5.68 GiB ÷ 106,432 token = 57,344 B,口径完全一致,字节没被省• 省的是预留:论文 profiling 显示传统系统只有 20.4%–38.2% 的 KV 显存真在存 token 状态 [1],其余是碎片与重复 • 块粒度残留的碎片上界是 block_size − 1 = 15个 token / 序列:8k 档 0.18%,100 token 档 12.0%——短序列才看得见• 容量直接换成并发:6,652 块 ÷ 512 块/请求 = 12.99 倍(源码算出,与日志一字不差);想在 8k 上开 16 路需要 7.0 GiB KV • 分页还买到第二样东西:块哈希 + 引用计数的跨请求共享,以及滑窗层窗口外块的即时归还
本文导读:一、字节没变,变的是什么 → 二、块的形状与容量公式 → 三、碎片账:cdiv 的上界 → 四、并发账:容量怎么换成路数 → 五、共享与淘汰 → 六、多组与对齐单位 → 七、和连续布局对账 → 八、边界与要点
一、字节没变,变的是什么
测量环境:单张 RTX 4090 24G,vLLM 0.26.0,torch 2.11.0+cu130,Qwen2.5-7B-Instruct fp16 [4],gpu_memory_utilization=0.9,max_model_len=8192,enforce_eager=True。
启动日志四行是关键:
Checkpoint size: 14.19 GiBAvailable KV cache memory: 5.68 GiBGPU KV cache size: 106,432 tokensMaximum concurrency for 8,192 tokens per request: 12.99x把它和上一篇的实测并排看:
权重那笔也对得上:vLLM 报 Checkpoint 14.19 GiB,我上一篇测的 memory_allocated 是 15.23 GB = 14.18 GiB。两个工具、两套口径,同一份权重。
所以分页改变的不是"存一个 token 要多少字节",而是**"这些字节以什么形状被分配、什么时候归还"**。
PagedAttention 论文的动机段说得很直白:为了把一条序列的 KV 放进连续空间,旧系统按请求的最大长度预分配一整块,而实际长度往往短得多;它的 profiling 显示,只有 20.4%–38.2% 的 KV 显存真正在存 token 状态 [1]。
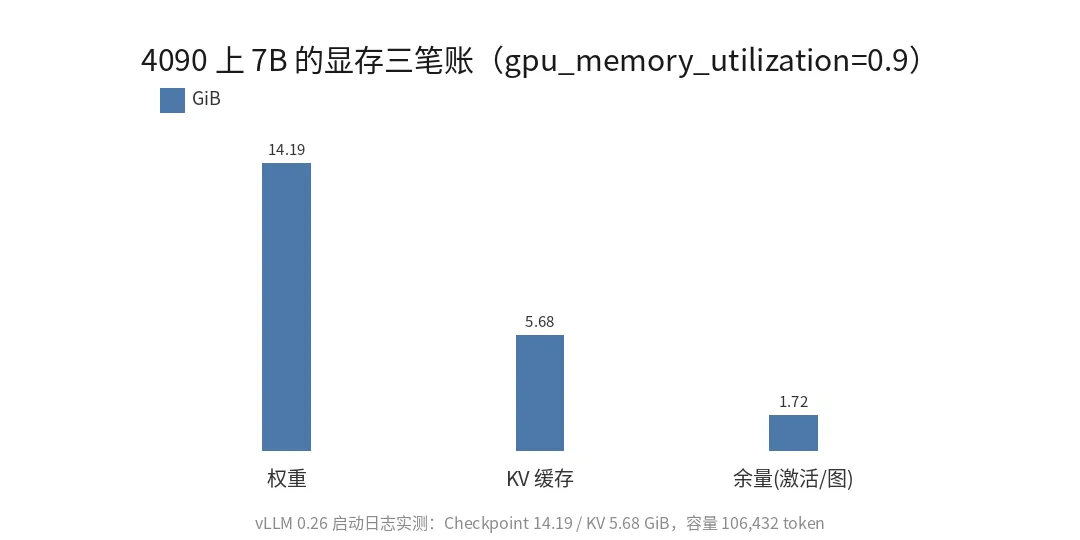
4090 上 7B 的显存三笔账:权重 14.19 / KV 5.68 / 余量 1.72 GiB
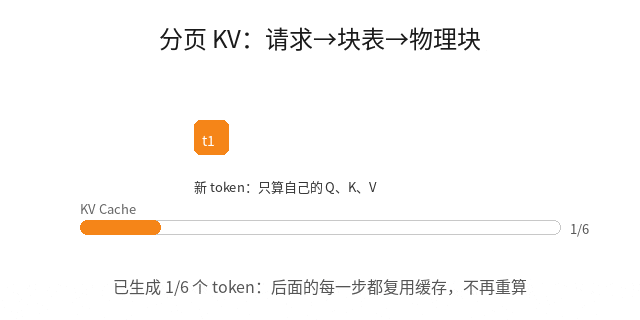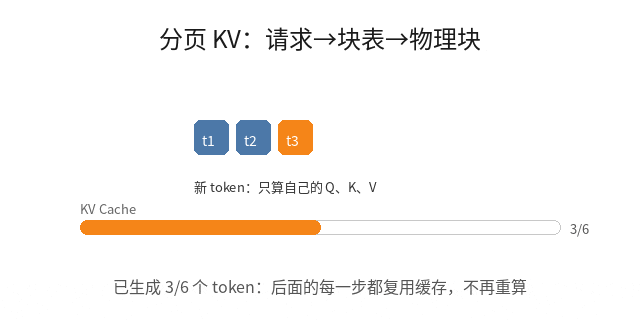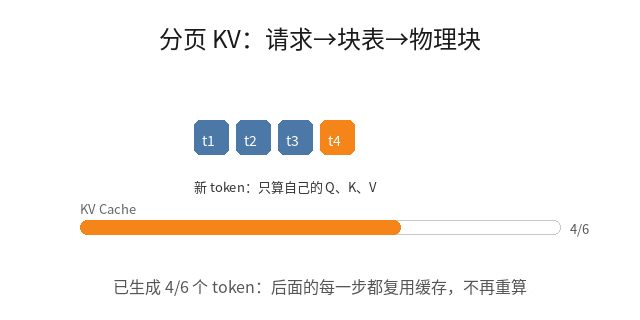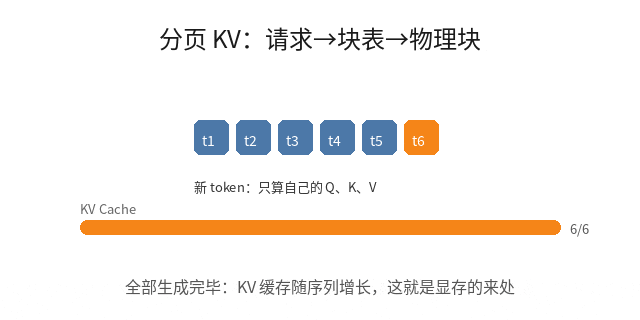
分页把请求映射到不相邻的物理块:块表按需分配,序列不必连续
二、块的形状:page_size 与 num_blocks
块大小是硬编码的默认值,vllm/config/cache.py:
class CacheConfig: DEFAULT_BLOCK_SIZE: ClassVar[int] = 16 # 一个块装 16 个 token每层每块的字节数由注意力结构决定(v1/kv_cache_interface.py 的 page_size_bytes,按形状 × dtype 求和):
page_size = 2 × block_size × KV头数 × head_dim × 字节数每层每块 = 2 × 16 × 4 × 128 × 2 = 32,768 B整块(28 层) = 32,768 × 28 = 917,504 B ≈ 0.875 MiB块数由剩余显存除出来,v1/core/kv_cache_utils.py:
def get_num_blocks(vllm_config, num_layers, available_memory, page_size) -> int: num_blocks = int(available_memory // page_size // num_layers) num_blocks = max(num_blocks, 0) return may_override_num_blocks(vllm_config, num_blocks)注意是整除。106,432 ÷ 16 = 6,652 块,6,652 × 917,504 = 6,103,236,608 B,而 available 是 5.68 GiB = 6,103,285,709 B——余下约 49 KB,不足一块,被整除直接丢掉。
这是分页账本上的第一笔浪费,量级 8×10⁻⁶,可以忽略;真正的大头在第三节。
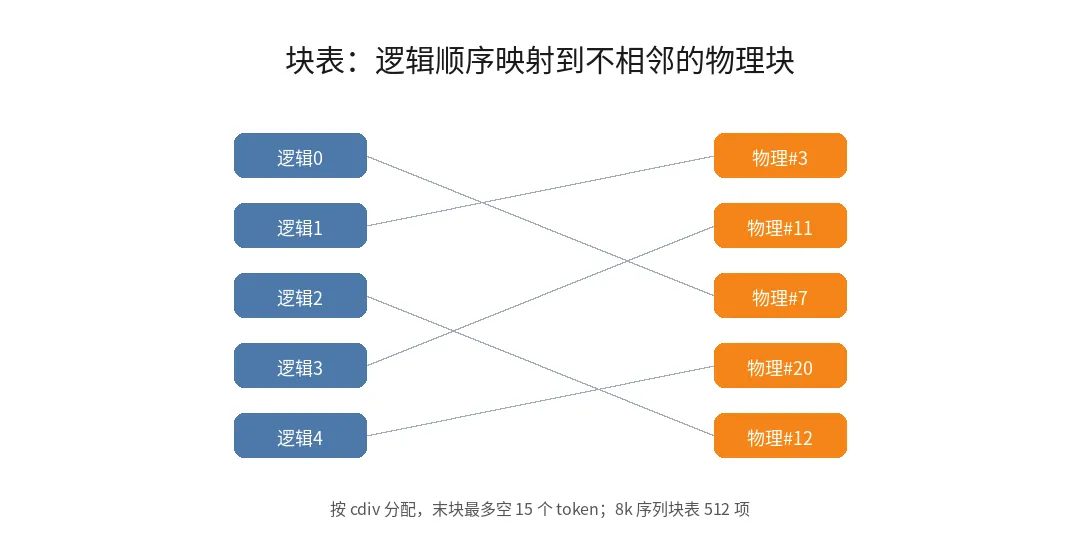
块表把一条序列的逻辑块号映射到不相邻的物理块,末块最多空 15 个 token
available_memory 也不是拍脑袋:vLLM 先跑一次 profile 前向测峰值激活,再用"总显存 × gpu_memory_utilization − 权重 − 峰值"倒推。
我这次 21.59 GiB 预算里,权重 14.19、KV 5.68,剩下 1.72 GiB 就是激活与 CUDA 上下文那一档。
KV 永远花的是别人挑剩的钱,这也是调 gpu_memory_utilization 会立刻改变并发上限的原因。
三、碎片账:cdiv 的上界
分配按块向上取整,v1/core/single_type_kv_cache_manager.py:
num_required_blocks = cdiv(num_tokens, self.block_size) # 行 169 / 351一条序列最多浪费 block_size − 1 个 token 的位置。按这个式子算各长度的浪费比例:
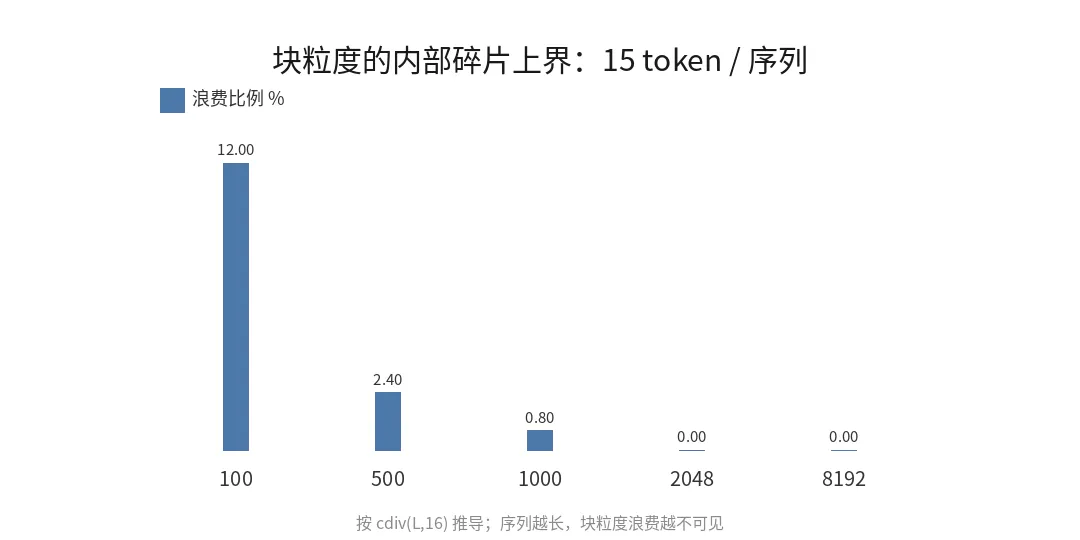
块粒度碎片上界随序列长度迅速消失:100 token 档 12%,2048 档起为 0
两点判断:
• 块粒度不是分页的主要收益来源。长上下文下它趋零;分页真正砍掉的是"按 max_length 预留"那一整块——旧系统给一条 200 token 的请求预留 2048 个位置,分页只给 13 块。 • 短请求多的服务才需要关心 block_size。流量集中在 100–300 token 时,16 的粒度吃掉 5%–12% 容量,这时调小块大小(换更细粒度、更多块表项)才有意义。我的取舍是:长文本与 Agent 场景不动默认值,短对话高并发才试 8。
块大小这个旋钮两头都有代价,同一把尺子量一下:
调细一半,短请求的碎片掉到三分之一,代价是 8k 序列的块表项翻倍——kernel 侧 gather 的索引量与块边界判断一起涨。
CacheConfig.block_size 只约束 gt=0,没有推荐区间,所以这题没有免费答案:**按你的长度分布选,别照抄默认值。
**
四、并发账:容量怎么换成路数
容量与并发的换算就三行(get_max_concurrency_for_kv_cache_config):
memory_per_block = groups[0].kv_cache_spec.page_size_bytes * num_layer_per_groupnum_block_per_request = cdiv(max_memory_usage_per_request, memory_per_block)max_concurrency = kv_cache_config.num_blocks / num_block_per_request代进实测:6,652 块 ÷ cdiv(8192, 16) = 6,652 / 512 = 12.99,与日志一字不差。
这条式子就是容量规划的全部:并发上限 = 总 token 容量 ÷ 每请求 token 数。
想开 16 路 8k,要 131,072 token 的 KV = 7.0 GiB,比现有 5.68 GiB 多 1.32 GiB——三条路:提 gpu_memory_utilization、砍 max_model_len、或者把 KV 量化。
第三条我实测了:同一张卡、同一份权重,只把 kv_cache_dtype 从默认换成 fp8:
Available KV cache memory: 5.68 GiBGPU KV cache size: 212,880 tokens (fp16 时是 106,432)Maximum concurrency for 8,192 tokens per request: 25.99x (fp16 时 12.99x)kv_cache_dtype=torch.float8_e4m3fn, arch=sm89预算一分没变,容量与时延上限精确翻倍(212,880 / 106,432 = 2.000)——因为分块公式里唯一变的量是每 token 字节减半。
同一套引擎再跑生成吞吐(32 请求 × 256 token、贪心):fp16 1761.6 tok/s、fp8 1699.7 tok/s(三轮离散度 0.0% / 0.3%)——容量翻倍要用 3.5% 的吞吐去换。
顺带纠正我上一版的猜测
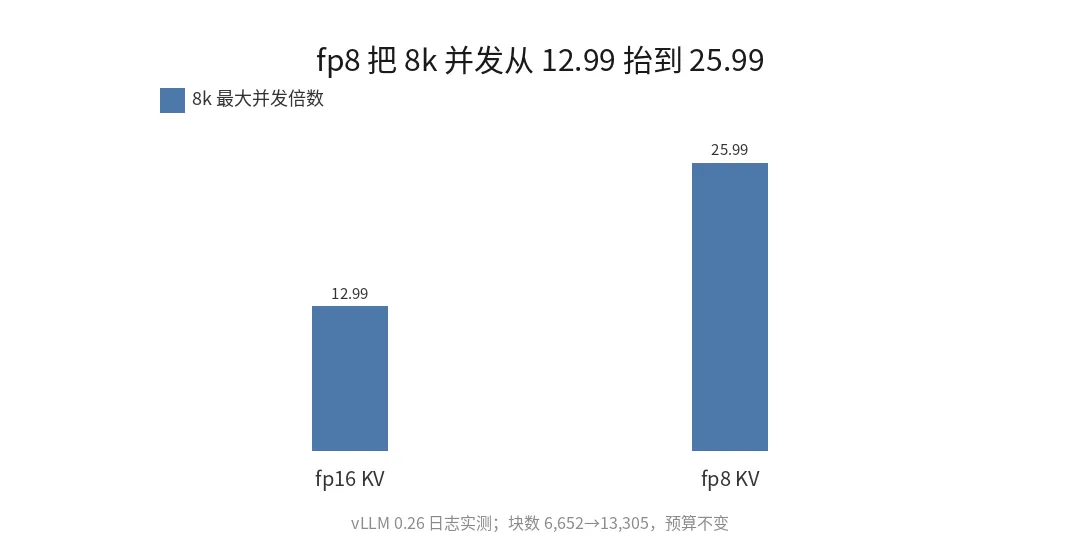
fp8 KV 把 8k 最大并发从 12.99 抬到 25.99 倍(实测):Ada(sm89)就能用 fp8 KV,不必等 Hopper。代价那一维我也量了(自己实现 fp8 量化-反量化,非引擎路径):40 题 gsm8k 上准确率 77.5% → 82.5%(40 题时 1 题就是 2.5 个百分点,属噪声),但同一位置量化前后的 KL 均值在 0.099–0.167 之间(三次运行;top-1 一致率摆动太大,不适合单点引用)——容量是白拿的,精度不是,只是任务级指标看不见。细节见《KV 压缩三条路》。
这和上一篇的 batch 实测正好接上:7B 上 batch 1→4 每 token 时延只涨 9%、吞吐 3.7 倍。带宽给了你摊薄的空间,块数给了你摊薄的上限——两个约束先撞哪个都白搭,容量算不出时延,时延也算不出容量。
五、共享与淘汰
分页的第二笔收益是共享,实现落在块哈希与引用计数上。
• 块哈希: v1/core/kv_cache_utils.py的hash_block_tokens(行 596)按"父块哈希 + 本块 token"递推,前缀相同的请求落到同一哈希上,命中即复用,不必重算 prefill。• 引用计数: v1/core/block_pool.py维护每块ref_cnt,touch()加引用、free()减引用;ref_cnt=0的块进 free list 但数据还在,此时它是"可淘汰的缓存",不是"已回收的内存"。下次分配时_maybe_evict_cached_block()才真把它踢出缓存。所以看 vLLM 的显存占用,"空闲块"并不等于"空"。• 滑窗层归还: SlidingWindowManager配remove_skipped_blocks()(行 819),窗口外的块直接释放——上一篇列的"缓存字节与序列长度脱钩"四种失效口径之一 [3],在这里是常态运行路径。• 混合布局:0.26 的 kv_cache_coordinator把不同类型(全注意力 / 滑窗 / 线性注意力)拆成多个 group 各自算块,get_uniform_page_size要求同组内页大小一致。不同层的 KV 形状可以完全不同:上一篇"逐层累加 numel"的口径仍然成立,但"层数 × KV 头数"要按组分别算。
这不是理论设定。举个手边的例子:Qwen3.5-4B 的 text_config 里 layer_types 是 32 层中每 4 层一个 full_attention(8 层全注意力 + 24 层线性注意力),head_dim=256、num_key_value_heads=4。
全注意力层要按 token 存 KV,线性注意力层存的是固定尺寸的递归状态(linear_conv_kernel_dim=4、16 个 key 头 × 128 维)——两者不可能共用一个 page 尺寸,所以它必然落进至少两个 group。
这时候上一篇那条 2 × 层数 × KV头 × head_dim 的公式只能套在 8 层上:套 32 层会把缓存高估 4 倍(131,072 vs 32,768 B/token)。
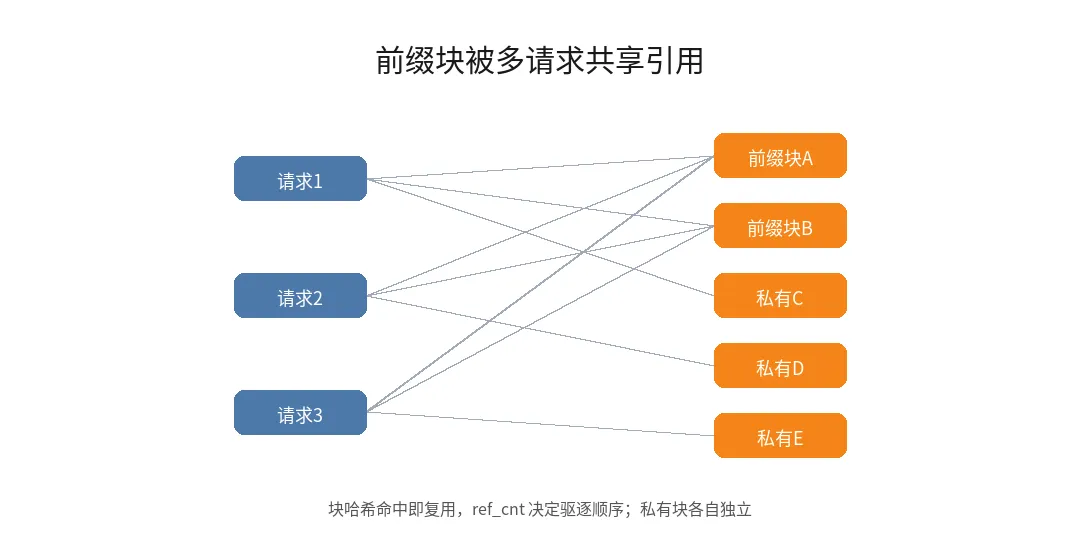
三条请求共享 A、B 两个前缀块,各自另加一个私有块;共享靠引用计数,驱逐也靠引用计数
代价也在这里。块不相邻,注意力 kernel 就得按块表间接寻址(gather),拿不到连续内存的顺序访问红利;共享又带来写时复制的判断分支。
论文把它明码标价:用 kernel 复杂度换 KV 内存效率,换来吞吐 2–4 倍 [1]。
我的读法是——这笔交易在 batch 大的时候才划算。单请求离线跑 7B,分页的收益基本只剩"不必 OOM",速度上未必赢过连续布局。
六、多组之后:对齐单位变成 LCM,命中粒度变成 GCD
一旦有了第二个 group,"块"就不再是一个数。0.26 在 v1/core/kv_cache_utils.py 的 resolve_block_hashes 里把这件事写得很清楚(docstring 原文摘要):
• scheduler_block_size:调度器的 token 对齐不变量。单组时 =block_size × dcp;多组时是各组有效块大小的 LCM;注意力组会被 decode 上下文并行(DCP)缩放,而 Mamba 组保留每卡完整状态、不被缩放• hash_block_size:Request.block_hashes的计算粒度。单组时等于调度块;多组时取prefix_match_unit覆盖值,否则取各组块大小的 GCD,并且要求每个组的块大小都能被它整除,否则直接报错:
# vllm/v1/core/kv_cache_utils.py:682if any(bs % hash_block_size != 0 for bs in group_block_sizes): raise ValueError(f"Invalid prefix_match_unit={hash_block_size}; ...")这两条对容量与命中率有实际后果,我的读法是:
1. 调度取整变粗。LCM 意味着调度器按更大的单位舍入 num_computed_tokens,混合模型里"块大小"这个直觉要换成"对齐单位"。2. 前缀命中粒度被最粗的那一组拖住。GCD 决定哈希链的步长:只要有一组的块尺寸不能被它整除就报错,而想让命中更细( prefix_match_unit调小),代价是哈希链变长、每 token 的元数据开销上升。3. 命中判定始终是整块:哈希按 hash_block_size递推(:699"Hashes are computed at hash_block_size granularity and chained"),续算起点是start_token_idx = len(request.block_hashes) * hash_block_size(:706)。差一个 token 都没得复用——这也是为什么把系统提示长度凑成块的整数倍,比想象中有用。
七、和连续布局对账:省的第二笔是拷贝
分页常被说成"省显存",但它在 HF transformers 那种连续布局上省的是另一样东西:每步重建缓存的拷贝。上一篇读过的实现是 transformers/cache_utils.py 里这一行:
# transformers 5.9.0, cache_utils.py:143self.keys = torch.cat([self.keys, key_states], dim=-2) # 每步新建一份cat 要分配一块新的连续张量,再把旧的整份搬过去。8k 上下文的 7B,单条序列整份 KV 是 469.76 MB,于是每生成一个 token 就复制一次 470 MB。
按上一篇实测的 859 GB/s 有效带宽算,这是 0.55 ms/步,占该档实测 decode 中位 19.65 ms 的 2.8%(推导,非直接测得)。
更要紧的是峰值——新旧两份同时存在,瞬时多要一份 KV。
分页不搬:新 token 写进当前块的下一个空槽,写满 16 个再挂一块。块表本身的开销可以算:8k 序列要 512 个块号,int32 存 2 KB,28 层合计 57 KB,对 470 MB 的 KV 是 0.012%——
间接寻址的成本在元数据上,不在内存上,真正的代价是 kernel 侧 gather 拿不到连续访问红利。
前缀复用能省多少,也能算。设系统提示 2,000 token、16 路并发共享同一前缀:
省下 KV = 2,000 × 57,344 B × 16 = 1.835 GB(占 5.68 GiB 预算的 30%)省下算力 = 2,000 token × 0.1105 ms/token = 221 ms 首 token 等待每 token 0.1105 ms 取自上一篇 7B 在 8k 档的 prefill 实测中位(905.14 ms ÷ 8,192)。
两笔账都指向同一件事:长系统提示 + 高并发是前缀缓存收益最大的场景,而单请求长文本几乎没有它的份——这类判断不必等压测,源码里的块数和实测的每 token 成本就够算。
八、边界与要点
版本必须钉住。我这边 vLLM 0.9.2 + torch 2.7.0 起不来(FileNotFoundError: 'ninja',编译依赖缺失),换 vLLM 0.26.0 + torch 2.11.0 才拿到上面那组日志。
跨版本读源码得出的结论不能混用:V1 的统一块池与 0.9.x 的块管理器已经不是同一套代码。
复现只要一条命令,脚本读引擎配置再按公式复算,两边对得上才算数:
python3 bench_paged_kv.py --model <本地权重目录> \ --gmu 0.9 --max-len 8192 --dtype float16 --out paged_kv.json# 输出:block_size / num_gpu_blocks / capacity_tokens / per_token_bytes /# kv_bytes_recomputed / max_concurrency_at_max_len / 碎片表覆盖窗口:机制起点是 PagedAttention 论文(2023),终点是 vLLM 0.26(2026)的实现现状;
未覆盖 TensorRT-LLM / SGLang 等其他引擎,也不涉及 PD 分离与多级缓存——那几块改变的正是"available_memory 从哪来"这一项,本文的容量算法在它们面前是下界。
本期要点:
• 分页不改每 token 字节:5.68 GiB ÷ 106,432 token = 57,344 B,与公式逐位一致 • 省的是预留与重复:论文 profiling 下旧系统仅 20.4%–38.2% 的 KV 显存在存状态 [1] • 块粒度残留碎片上界 15 token/序列,长上下文趋零,短请求高并发才需要动 block_size• 并发 = 容量 ÷ 每请求 token:12.99 倍由源码三行算出、与日志一致 • fp8 KV 实测:预算不变,容量 106,432 → 212,880 token(精确 2.00 倍),8k 并发 12.99 → 25.99 倍;Ada(sm89)即可用 • 块哈希 + ref_cnt换来前缀复用与滑窗归还,代价是 kernel 间接寻址;batch 越大越划算• 混合模型(如 8 层全注意力 + 24 层线性注意力)会拆成多个 group:调度对齐用 LCM、前缀命中粒度用 GCD,且命中始终要求整块 • 前缀命中是整块的:系统提示长度凑到块大小的整数倍,比调任何参数都直接 • 与连续布局对账: torch.cat每步复制 470 MB(8k/7B,推导 0.55 ms/步),分页不搬;块表元数据仅占 KV 的 0.012%• 前缀收益可算:2,000 token 系统提示 × 16 路 = 省 1.835 GB KV 与约 221 ms 首 token 等待
你服务里的 KV 实际存了多少状态?拿
GPU KV cache size除以max_model_len就是并发天花板——把算出的倍数和实际跑的 QPS 报在评论区,对一下差在哪一环。
关键引文
1. Kwon, W., et al. Efficient Memory Management for Large Language Model Serving with PagedAttention. arXiv:2309.06180, 2023. 2. Ainslie, J., et al. GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. arXiv:2305.13245, 2023. 3. Xiao, G., et al. Efficient Streaming Language Models with Attention Sinks. arXiv:2309.17453, 2023. 4. Yang, A., et al. Qwen2.5 Technical Report. arXiv:2412.15115, 2024.