ARTICLE · 1232238
52K+Star一款免费、开源的 AI 求职流水线,69 份定制简历换来 20 场面试和 1 份 offer
一个人的经历先讲。
作者是学地球物理的。 2025 年底岗位裁撤,他用 Claude Code 搭了这套东西,跑自己的求职。
69 份定制申请,20 场一面,1 份签下的合同。 2026 年 6 月入职做 AI 工程师。
项目叫 ai-job-search,61,964 star,MIT 协议。
01 三个命令撑起主线
它的形态是 Claude Code 的命令集,不是一个 App。
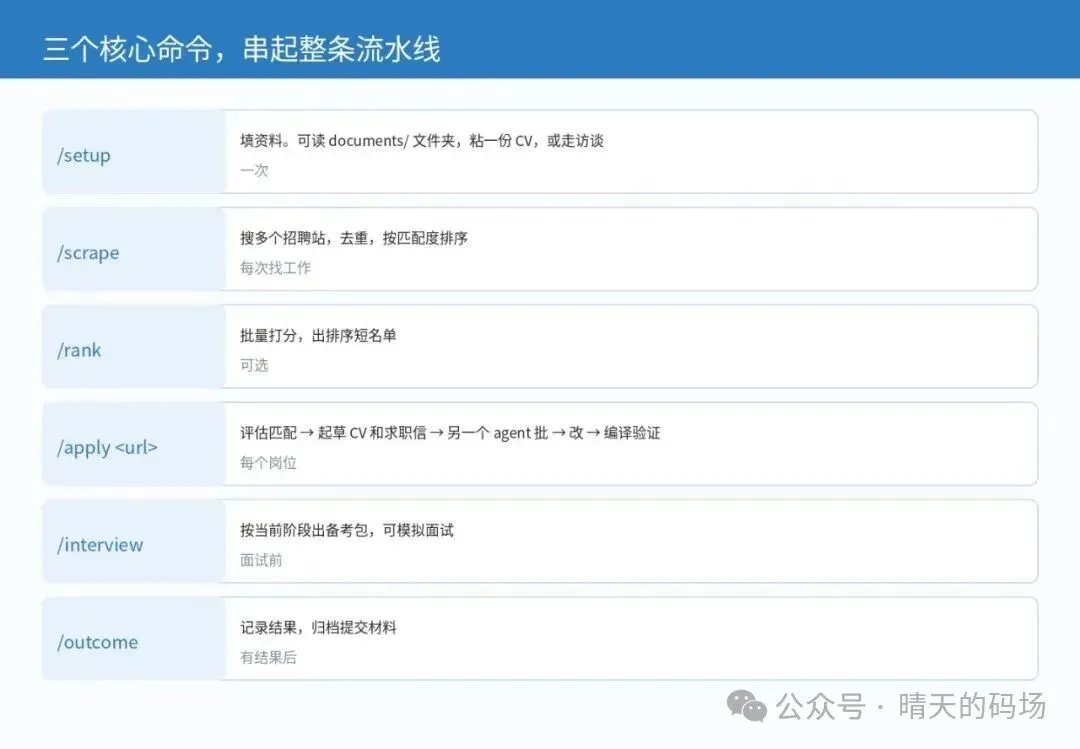
表 1 · 核心三件套
第一行有三种入口,这点挺实际。
有整理好的 `documents/` 文件夹就用文件夹;只有一份 PDF 就粘进去;什么都没有就走访谈问答。
README 说文件夹模式是幂等的,你陆续往里加材料,重复跑不会出问题。
这里要问一句,为什么不直接做个网页?
因为它要读你本地的简历、跑 LaTeX 编译,还要写文件。这些在浏览器里做不了,只能跑在本机。
项目的副标题就是这句话,the job search that runs on your machine。
02 /apply 内部有八步
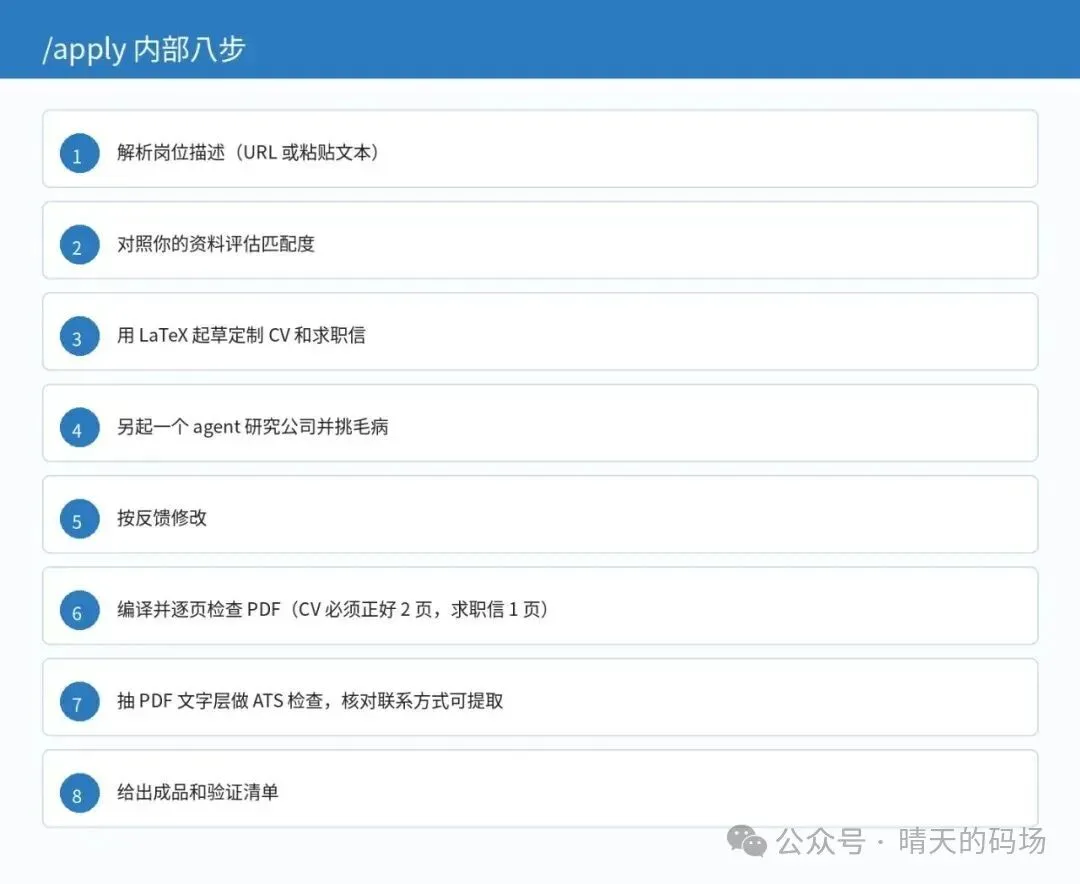
这是整个项目最重的一块,八步里有四步在验证。
表 2 · 八步流程
| 另起一个 agent 研究公司并挑毛病 | |
| 编译并逐页检查 PDF | |
| 抽 PDF 文字层做 ATS 检查 | |
第四行是「双人审稿」。
起草的 agent 写完,另起一个上下文干净的 agent 去研究这家公司,然后挑毛病。
为什么要换一个 agent?
因为同一个上下文里,模型会倾向于认可自己刚写的东西。换个干净的上下文,它才像一个真正的审稿人。
第六、七行是我觉得最硬的部分,单独讲。
03 它检查 PDF,不只检查 tex
这是它和其他简历模板最大的区别。
表 3 · 常见的 LaTeX 翻车
这三个问题在 `.tex` 里看不出来,只在编译后的 PDF 里出现。
它的做法是编译完逐页看。
CV 必须正好 2 页,不能有孤立的小标题。求职信必须正好 1 页,签名要在页内,字体要一致。
不达标就改 LaTeX,再编译,再检查。
这里要问一句,为什么卡这么死?
因为招聘方看到的是一份 PDF。你的 tex 写得再漂亮,导出多一页就是减分。
04 ATS 检查是最容易被忽略的一步
这一步大部分简历工具都不做。
表 4 · ATS 看到的是什么
第一行是 LaTeX 简历的经典坑。
用 `fontawesome5` 之类的图标字体,渲染正常,但文字层里是乱码。ATS 解析出来拿不到你的邮箱。
它的做法是抽 PDF 的文字层,按解析器的视角验一遍。
联系方式要以字面文本存在,不能有乱码字形,阅读顺序要正常。
然后拿岗位关键词去对覆盖率。
这里要问一句,关键词不够怎么办?
README 写了一条硬规则,你的资料里真有的关键词才加,真缺的就留着当缺口,不许硬塞。
这条规则挺重要。 一个能帮你造假的工具,迟早会害了你。
05 超页数时砍哪一行
细节说明作者想过,它按三档打分再砍。
表 5 · 三档打分再砍
砍总分最低的那一行,不从最老的经历开始砍。
README 举的例子是,一条老岗位的要点如果命中了岗位关键词,它会活下来,而一条新岗位但没命中关键词的要点先砍掉。
这里要问一句,为什么不用「保留最近三年」这种规则?
因为时间是代理指标,不是目标。招聘方关心的是相关性,不是你哪年做的。
06 还有十个命令
表 6 · 扩展命令
第三行有个细节。
`/outcome` 会把提交过的 CV、求职信和岗位原文归档到 `documents/applications/`。
这样面试前你还能看到对方当时读的那一版。
第九行也很克制。 `/gmail-sync` 读完只提议,不直接改。而且状态是「offer」时它不提议 `hired`,因为那是你的决定。
07 门槛和坑
这块得说清楚,不然会踩。
表 7 · 环境要求
| 没有免费额度 | |
第一行是最大的门槛。
这不是免费工具,它依赖 Claude Code 的订阅。
第四行有点烦。
CV 用 `lualatex` 编译,求职信用 `xelatex`,因为 `cover.cls` 需要 `fontspec`。两个引擎都得装。
更重要的一个坑在 README 的加粗警告里。
表 8 · 那个隐私警告
| 公共仓库的 fork 永远是公开的 | |
坑太容易踩了。
一般人看到「Fork it」就 fork 了,然后 `/setup` 一跑,你的完整履历和薪资期望就公开在 GitHub 上了。
README 专门写了这一段加粗警告,说明作者知道会有人中招。
它把求职做成了可重复的流程
说回开头那组数字,69 份申请、20 场一面、1 份 offer。转化率不算高,29% 的一面率,5% 的 offer 率。
但它胜在可重复。同一套流程跑 69 次,每次都在改 CV、改求职信、查 PDF、对关键词。
作者自己也说了,他跟面试官都坦白用过 AI。结果不但没减分,反而常引出一段真正的技术对话。
这可能比工具本身更值得记一下。
你有没有在求职时,为一份简历改到凌晨?
项目地址
https://github.com/MadsLorentzen/ai-job-search
许可
MIT。独立开源项目,与 Anthropic 无隶属或背书关系。
README 明确写了,这个项目没有关联加密货币、代币或付费赞助计划,声称有的都是诈骗。