ARTICLE · 1232535
AI 画的图,你敢直接放进汇报吗
QUOTE
你用 AI 出图的速度,可能一直在掩盖一个从没被验证过的假设——它下次还能画出一样的图吗?
—— wugenqiang
周三下午四点,月报截止前一小时。你打开 AI 工具,把上个月的销售数据丢进去,三分钟出了六张图,配色干净,标题齐全。你松了口气,粘贴,发送。
下周,老板问:「这个月华东区的环比为什么是负的?上月不是涨的吗?」
你把同样的数据、同样的问题,重新问了一遍 AI。
图变了。
同一份数据,同一个问题,间隔一周,两张图讲出了两个方向不一样的故事。你盯着屏幕,第一次意识到一个事:过去三个月你用 AI 出图的速度,可能一直在掩盖一个从没被验证过的假设——它下次还能画出一样的图吗?
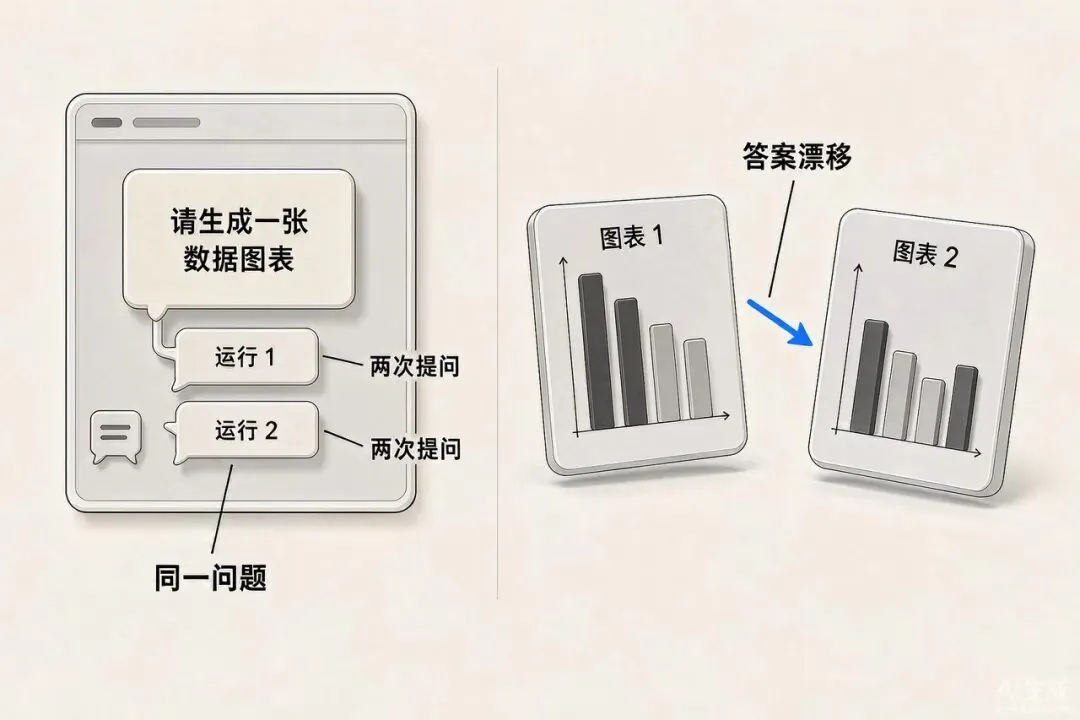
— 同一问题两次提问,答案漂移
「一次画对是手艺,次次画对才是工程。前者花多少钱都能买,后者只能靠流程建。」
本文看点
01
一组复现性实测数据
02
四步验收法可直接落地
03
哪些场景能放手、哪些不行
01
THE DATA
先看一组让人不舒服的实测数据
2026 年,InfiniSynapse 做了一轮 AI 可视化工具的横评。方法很直接:固定 24 个 prompts 组成测试集,覆盖从简单聚合到带比率、带分母的复杂查询,跑完一轮,记录两件事——图选对没有,以及逻辑能不能复现。
复现性的测法更狠:开一个全新会话,把同样的 24 个问题再问一遍,看能不能得到同样的图表逻辑。
结果分四档:
前三档是复现率,最后两列是同一轮横评里的选图准确率与人工修正负担。其中「选图准确」一列统计的是带比率、需要判断分母的困难档问题。
还有一组数字更扎心——修正负担:生成后需要人工改过才能分享的比例,Chat 类工具平均每个用户有 11 个 prompts 需要动刀,BI Copilot 是 6 个,数仓原生 7 个,AI 原生智能体 5 个。
翻译成工作语言:用 Chat 类工具出图,你每周有近一半的图要返工;而它返工的原因,往往不是画错了,是画得跟上次不一样。
02
WHY IT DRIFTS
为什么「一次画对」不等于「次次画得一样」
很多人把这个问题理解成「AI 不够聪明」。不是。这是两种完全不同的工作方式被混为一谈。
Demo 是手工艺,月报是流水线。
手工艺的特点是:这次做得好,就是好。流水线的特点是:第 100 次和第 1 次必须一模一样。你用三分钟出了一张惊艳的图,证明的是前者;而老板要的周报月报,要的是后者。
Chat 类工具为什么复现率低?拆开看有四层原因:
解析有自由度
你问「上个月各区销售额」,AI 要自己决定:上个月是自然月还是近 30 天?含不含退款?含不含测试订单?没有语义层约束时,这些决定每次都可能不同。同一个问题,被解析成两条不同的 SQL,图当然不一样。
上下文会污染
会话越长,历史里的旧定义、旧筛选条件越可能污染新问题。上周你问过「剔除大客户」,这次没提,AI 可能还记得。
版本在动
今天的图和下个月的图之间,隔着一轮你控制不了的更新。
定义无处存放
这是最根本的。Chat 工具的会话是易失的,你的口径活在聊天记录里,活在你的记忆里,唯独没有活在系统里。
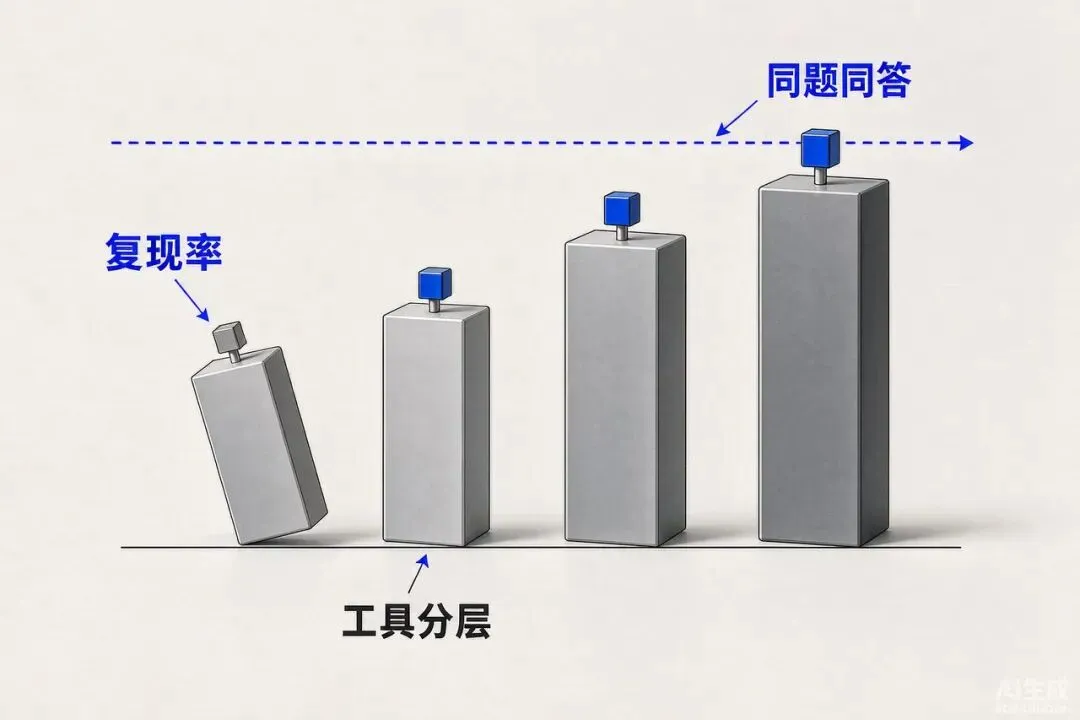
— 复现率随工具分层拉开差距
所以那 6/24 不是模型的耻辱,是架构的必然:当一个工具没有指标定义的存放处,复现就只能靠运气。
03
THE METHOD
四步验收法:让 AI 出图可以进月报
问题不是「要不要用 AI 出图」,而是「怎么验收」。下面四步,可以直接搬进你们的流程。
挑 20 到 50 个你们最常问的问题做成测试集,开两个全新会话分别跑一遍,逐条对比:图类型一样吗?口径一样吗?筛选条件一样吗?把「同题同答率」当成一个正式指标记录下来。低于 80% 的工具,不要放进任何周期性报表的流程里——它适合探索,不适合交付。这一步几乎零成本,却能挡掉后面所有的坑。
任何一张要发出去的图,都要能回答三个问题:分母是什么?时间窗是哪一段?排除了什么?比如「转化率 23%」必须写成「支付成功用户 ÷ 支付发起用户,2026 年 9 月自然月,剔除测试账号」。这三个要素不写在图上,读者就会替你编一个——而读者编的那个,通常和你想说的不一样。
AI 负责快,人负责准。正确的分工是:指标字典、维度定义、计算逻辑由人写死,存进语义层或指标平台;AI 只在受控的定义里做渲染和探索。工具可以换,定义不能丢。这也是 BI Copilot 和 AI 原生智能体复现率能到 22/24、23/24 的原因——它们的逻辑不飘,因为定义有地方放。
明确三件事:谁验收(建议不是做图的人)、抽检比例(首批 100%,稳定后降到 30%)、变更怎么记录(口径变更要有版本号和生效日期)。没有这一步,前三步都会在第二个忙月里悄悄失效。
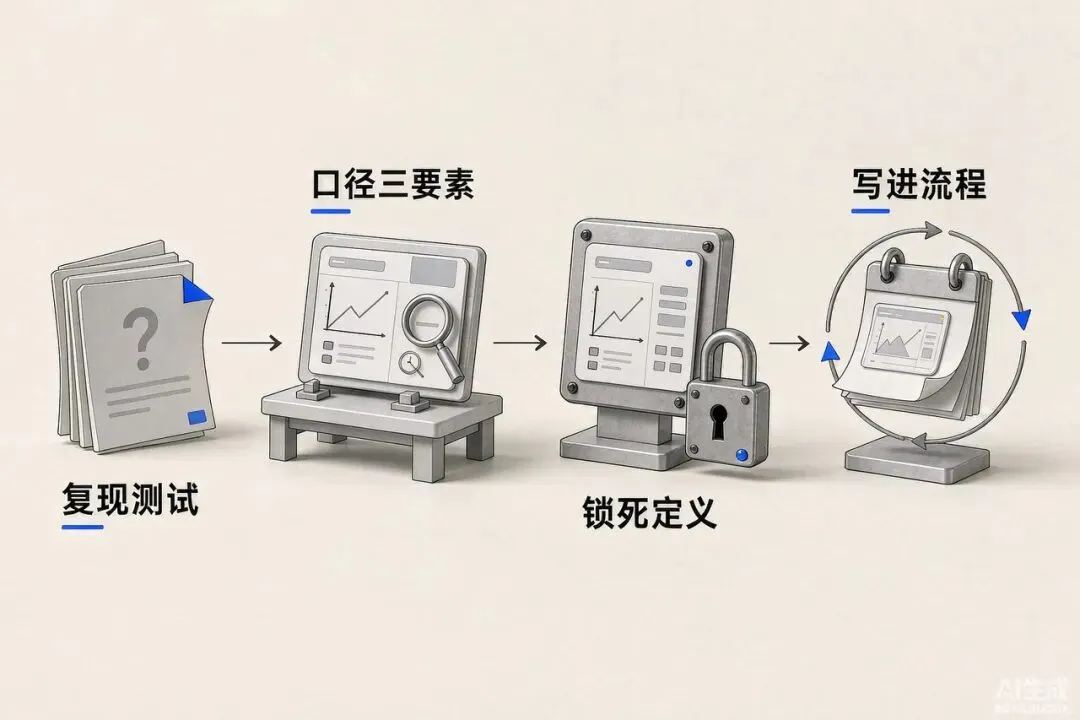
— 四步验收流水线
04
THE BOUNDARY
哪些场景可以放手,哪些不行
必须把边界说清楚,否则这篇文章就变成了因噎废食。
探索性分析,放心让 AI 跑
一次性问题、可丢弃的答案、「帮我看看这个数据有没有异常」——这时候追求的就是速度和直觉,复现性毫无意义。AI 在这段的提速是真实的,一个分析师一天的探索量可能翻三倍。
治理型报表,必须锁逻辑
凡是重复出现、要被用来做决策、要留档的材料——周报月报、经营分析会材料、董事会汇报、对外披露——适用的标准就不是「这次对不对」,而是「次次都一样,且每次都可解释」。这时候 Chat 类工具的角色是草稿机,不是交付机。
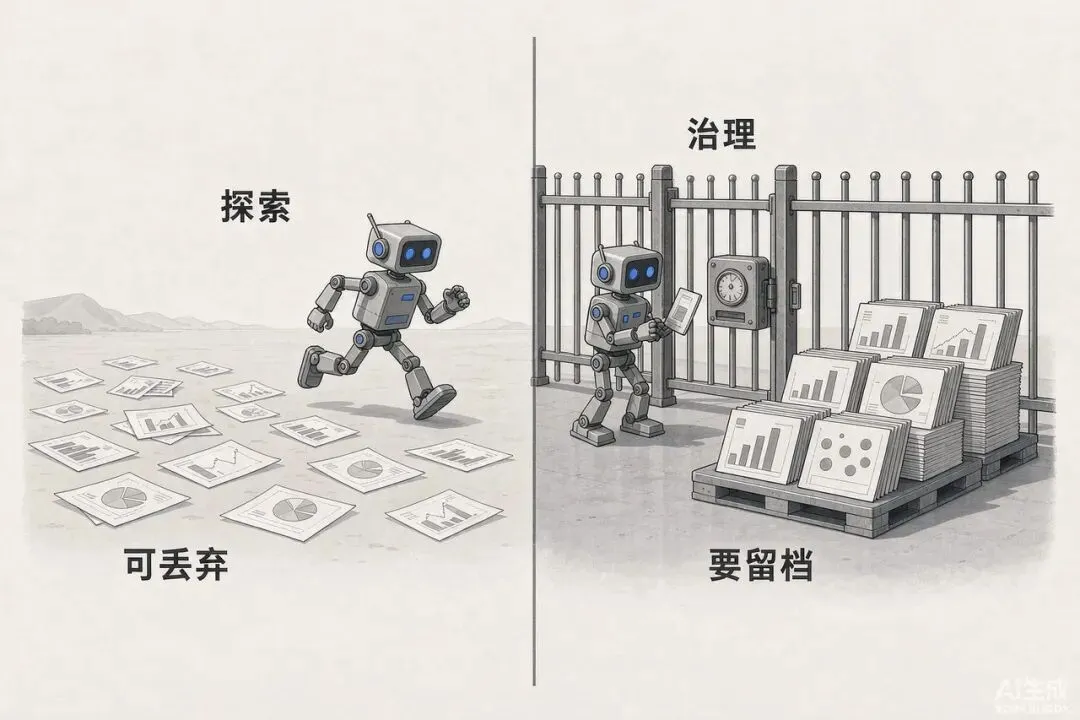
— 探索可放手,治理要上锁
一条简单的分界线:这张图的答案,会不会在三个月内被再次追问?会,就按流水线标准验收;不会,就按手工艺标准用。
05
PITFALLS
三个高频坑,按出现频率排
坑一
拿 demo 当验收。演示环境里问三个问题,图都很漂亮,就批预算。请务必记住那组数字——同一批 prompts 重跑,最差的工具只有 6/24 能复现。一周的 demo 证明不了任何事,30 天的同题重跑才能。
坑二
只查数不查口径。「AI 算的总数对不对」问的人很多,「这个总数的分母是什么」问的人很少。数字对了口径错了,是更危险的事——因为它看起来是对的。
坑三
换会话不换验收。新开一个对话窗口,等于换了一个新同事。你不会让一个新同事不看口径说明就直接出月报,也别让新会话这么干。
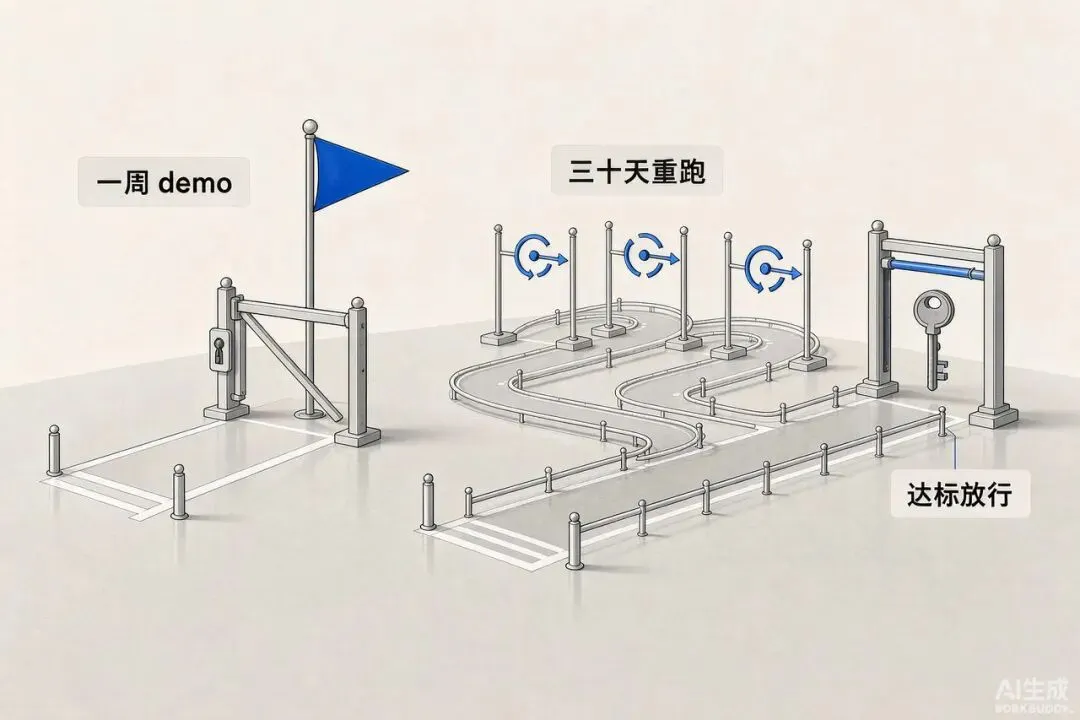
— 一周 demo 证明不了生产就绪
∞
THE END
别先问好不好看,先问还答不答得一样
说句公道话:AI 出图这件事本身没有错,错的是我们把「演示的能力」当成了「生产的能力」。
三分钟出一张图,是工具的能力;三个月里每周都出一张一样的图,是你的能力。前者花多少钱都能买,后者只能靠流程建。
下次再用 AI 出图,别先问「好不好看」。先问那句更硬的:同样的数据,同样的问题,下周再问一次,它还答得一样吗?
答不上来,就先别放进汇报。
一次性画对是手艺,次次画对才是工程。
本文数据来自 InfiniSynapse 2026 年 AI 数据可视化工具横评(24-prompt fixture)及公开案例整理,不构成任何工具采购建议。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。