ARTICLE · 1241189
软件测试的新瓶颈:AI 越会找 Bug,团队越容易发不了版
导语
现状一句:AI 代码审查现在能把旧代码里的边界问题成批翻出来。
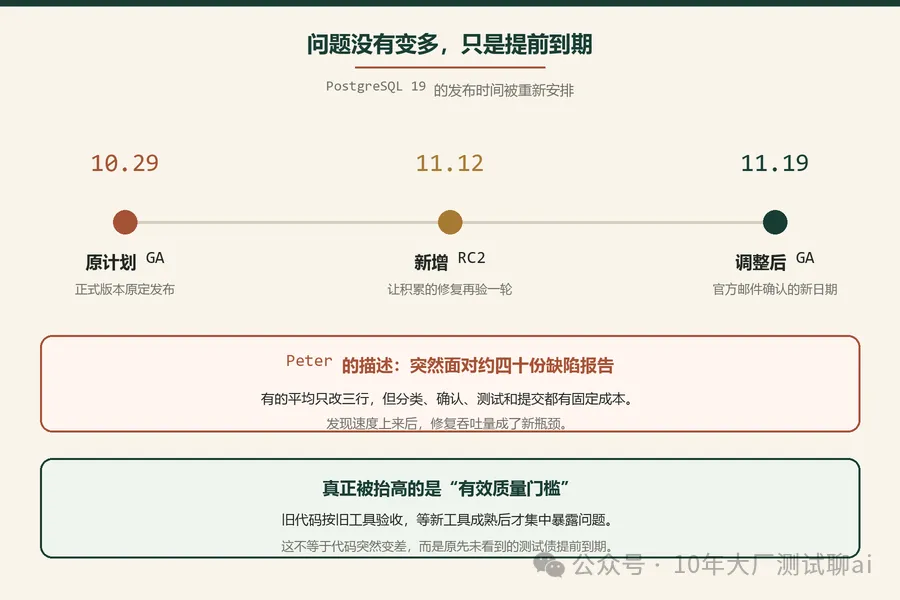
反常识一句:问题找得更全,发布时间反而可能更晚;PostgreSQL 19 就因此把正式发布日期调整到了 11 月 19 日。
收益一句:看完你能拿到一张缺陷四档分流表,判断哪些问题拦住版本、哪些登记后放行、哪些应该直接关闭。
结论先给:AI 让“发现问题”变便宜之后,测试团队真正稀缺的能力,是给缺陷定义发布边界。
一、AI 没把代码写坏,它把未来几年的测试债提前摊开了
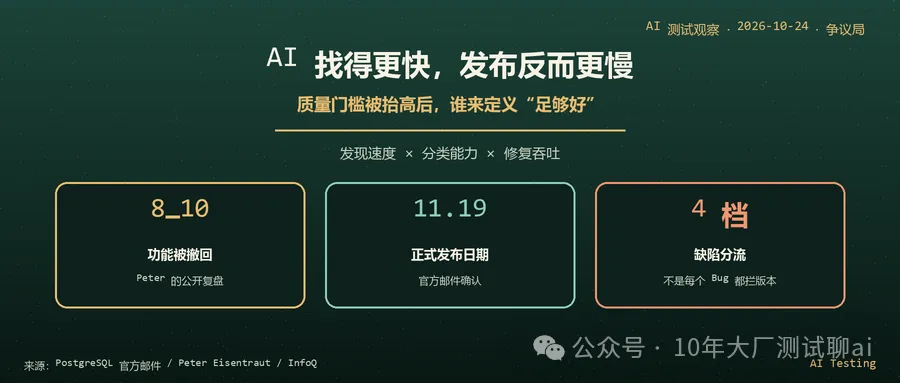
PostgreSQL 核心提交者 Peter Eisentraut 在 10 月 9 日的复盘里提到,Beta 之后约有 8–10 个重要功能被撤回。关键不是开发者突然开始用 AI 写劣质代码;相反,很多功能写于 LLM 辅助审查还不成熟的时期。
变化发生在验收端。AI 审查和模糊测试更快扫出边缘组合,其中一些原本可能在未来五年里逐个冒出来。Peter 举了一个直观场景:突然面对四十份左右缺陷报告,每个可能平均只改三行,但分类、确认、测试和提交都有固定成本,人很快就被流程耗光。
所以第一层变化不是代码质量变差,而是缺陷发现速度第一次明显超过修复吞吐量。
二、两派争的不是要不要修,而是谁定义“可以发布”
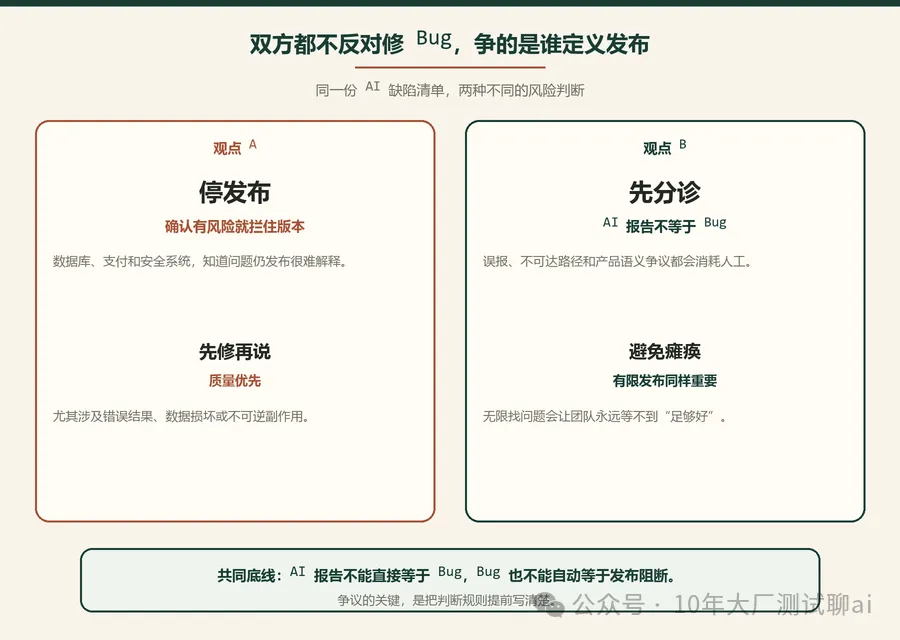
一派认为,已经确认的问题就该拦住版本。尤其数据库、支付和安全系统,知道风险还继续发布,责任很难解释。
另一派担心“无限找 Bug”会把项目拖进发布瘫痪。AI 能找到的边界似乎永远还有下一个;如果每个低概率问题都升级成阻断项,团队最后不是更稳,而是无法交付。InfoQ 的报道里还引述了开发者的经验:AI 报告需要结合完整系统上下文判断,误报会消耗大量人工。
这两派并非完全对立。共同点是:AI 报告不能直接等于 Bug,Bug 也不能自动等于发布阻断。
三、我的判断:先分四档,再讨论修到哪一版
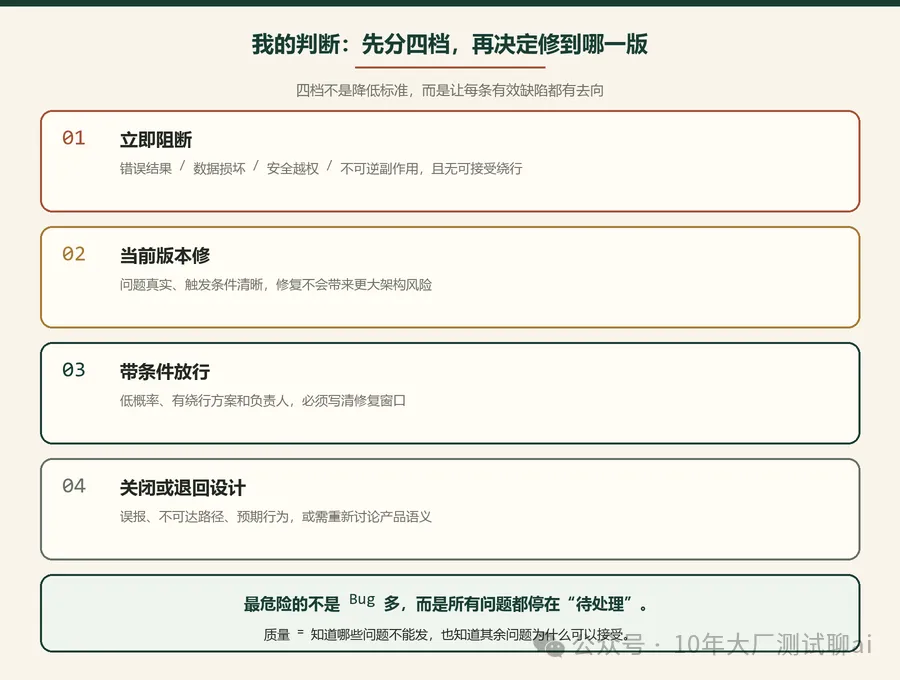
立即阻断:错误结果、数据损坏、安全越权或不可逆副作用,且没有可接受绕行方案; 当前版本修:问题真实、触发条件清晰,修复不会引入更大架构风险; 带条件放行:触发概率低、有明确绕行方案和负责人,必须给出修复窗口; 关闭或退回设计:误报、不可达路径、预期行为,或需要重新讨论产品语义。
这张表的重点不是给 AI 报告“降级”,而是让每条有效缺陷都有明确去向。最危险的状态不是 Bug 多,而是所有问题都停留在“待处理”里,既没有关闭理由,也没有发布责任。
四、测试团队该从“找多少”转向“漏掉什么决定”
以后看 AI 审查效果,别只统计报告数量。更值得追踪的是:有效报告率、平均分流时间、阻断项数量、延期总成本,以及每条已知问题是否写清触发条件和绕行方案。
质量也不是把所有已知 Bug 清零。更现实的定义是:团队知道哪些问题不能带着发布,也知道其余问题为什么可以接受。
结语:AI 把缺陷清单变长之后,测试人的价值不是替 AI 背锅修 Bug,而是建立一套能被团队共同执行的发布判断。
互动提问:如果 AI 发现一个真实但极难触发、只需改三行的问题,你会拦下本周发布,还是登记进下个版本?你站哪一边?