ARTICLE · 1260840
AI 基础设施技术栈选型
一句话点题:AI 基础设施选型不是把热门工具全接一遍,而是先看清你的稀缺资源是什么:模型能力、GPU、上下文、检索质量、成本,还是可控性。选型的核心不是工具名,而是用最少组件把 AI 系统的风险关进笼子里。
🧰 技术栈选型篇第 7 章 · 本章只练一件事
17 章 讲 AI 系统多了非确定性、上下文、Agentic 三个硬骨头;22 章 讲 AI 原生系统怎么设计。本章专门回答:这些系统背后的 AI 技术栈该怎么选,什么时候托管 API 就够,什么时候才值得下沉到模型网关、自建推理、GPU、评测平台。
开场:你到底在自建什么
一听 AI Infrastructure(AI 基础设施),很多人脑子里马上冒出:
GPU(图形处理器,训练/推理常用计算资源) 向量数据库 Agent 框架 模型网关 推理引擎 评测平台
但架构判断的第一步不是列清单,而是问:
你是真的在建基础设施,还是只是在做一个 AI 应用?
如果你只是做早期产品,MVP 阶段最合理的默认答案通常是:调用托管模型 API,加最小日志和成本监控,先把业务闭环跑通。只有当你遇到明确触发信号,比如成本失控、数据不能出域、延迟不达标、供应商单点不可接受、模型需要深度定制,才值得往下沉到网关、自建推理、GPU 池这些重型组件。
**架构智慧:**AI 基础设施不是越底层越高级。越底层,你拿回的控制权越多,同时也接走了成本、容量规划、故障恢复、安全隔离和团队运维能力的账单。
一、AI 栈的四层
一套生产级 AI 系统,可以先粗略拆成四层:
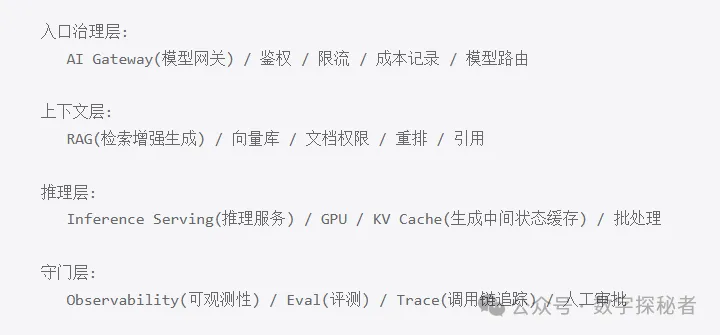
这四层不是一开始都要有。正确顺序是:先把不可省的风险看见,再补对应的层。
看不见成本,先补网关或用量日志。 检索质量决定答案上限,先补 RAG eval。 多个团队都在调模型,再补统一模型网关。 GPU 成本超过 API 成本,再考虑自建推理。 Agent 能执行副作用,必须补权限、人审和审计。
二、API 还是自建推理:这是成本账,不是面子账
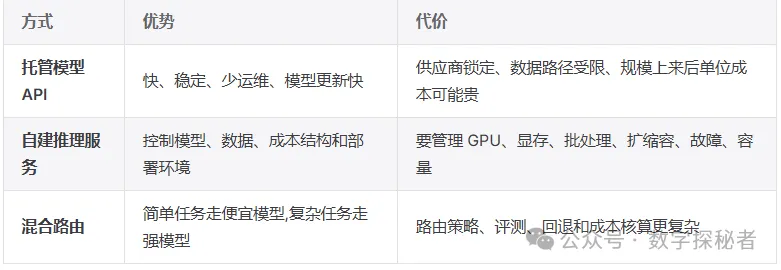
这个分叉不要问「哪个更先进」,要问四个问题:
数据能不能出域? 延迟目标托管 API 能不能满足? 调用量大到自建更便宜了吗? 团队会不会运营 GPU 服务?
四个问题里只中一个,通常还不足以上自建;同时命中两三个,才说明基础设施下沉有意义。
三、RAG、长上下文、微调:先分清你在补知识还是补行为
RAG、Long Context(长上下文)、Fine-tuning(微调)经常被混着比较,但它们解决的不是同一个问题:
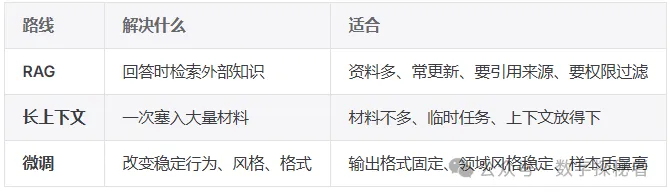
小白最容易犯的错是:检索没做好就怪模型笨,或者把本该用 RAG 解决的「知识更新」问题拿去微调。
**判断句:**知识用检索,行为才谈微调。要引用、要更新、要权限,优先把 RAG 做对。
四、Agent 框架:先工作流,再自主
Agent 框架看起来很强,但第一个问题仍然是 22 章 的判断:
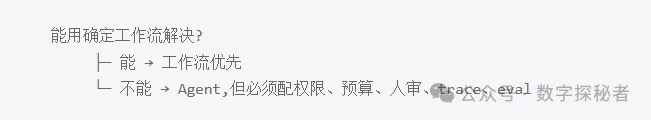
如果流程固定,例如「检索订单 → 判断是否符合退款规则 → 调退款接口 → 发通知」,不要急着上自主 Agent。工作流更可预测、可测试、可审计。只有当步骤开放、工具多、任务目标需要动态规划,Agent 才开始有意义。
Agent 选型要重点看:
工具权限能否分级? 是否支持人工审批? 是否能记录每一步 trace? 是否能限制预算和最大步数? 是否能做上下文压缩和任务恢复?
五、守门层不是锦上添花,是生产门槛
AI 系统和传统系统最大的不同,是输出不稳定、质量会漂移。上线后只看接口成功率不够,还要看:
prompt 和上下文是什么? 检索到了哪些片段? 模型调用成本多少? 工具调用有没有越权? 最终答案有没有引用、有没有胡编? 换模型或改提示后质量有没有退化?
这就是 25 章 eval 的价值。如果系统已经碰钱、碰用户数据、碰自动操作,eval 不是「以后再补」,而是架构的一部分。没有 eval,每次换模型、改提示、换检索策略,本质上都是闭眼上线。