|
GOOGLE SEO · AI 内容与排名 · 2026 年 10 月 用 AI 批量写产品页,
Google 官方到底怎么说的10 月 1 日那份指南改了三句话,网上却传出了三个新词。
这篇文章只做一件事:把官方原话和传言分开摆。 |
■ 本文的核对对象 ① Google 搜索中心《使用生成式 AI 内容的指南》(简体版,10 月 1 日更新) ② 搜索中心《文档更新日志》2026 年 10 月 1 日条目 ③ 《适用于 Google 网页搜索的垃圾内容政策》:滥用规模化内容、网站声誉政策 ④ 《搜索质量评估指南》公开版 4.6.5 与 4.6.6 节 |
|
最近一个月,做外贸独立站的人大概是听过这三句话的,而且听起来都挺吓人: |
|
这三句话里,没有一句能在 Google 官方渠道找到出处。但更麻烦的是:因为传言太响,很多人反而忽略了 10 月 1 日那份指南里真正改动过的内容——那一处改动,才是跟你明天要上线的产品页直接相关的。 |
|
先看官方自己的记录。搜索中心《文档更新日志》2026 年 10 月 1 日只列了一条,标题是「更新了关于使用生成式 AI 内容的指南」。条目里的「原因」一栏写得很朴素: |
更新日志 · 原因栏(英文原意) 「为了让我们的文档与我们在开发者大会上使用的宣讲口径保持一致。」 也就是说,这次更新的性质是文档对齐,不是新政策,也不是新算法。Google 没有把它描述成一次「行动」。 |
|
改动集中在指南的「注重准确性、质量和相关性」这一节。新增的是三句话,外加一句旧话的改写: |
|
把简体版官方原文完整抄在这里,你可以直接对照自己的流程: |
官方指南 · 简体版原文 「请注意,生成模型不会检索事实,而是根据其训练数据预测可能的字词序列。因此,生成式 AI 的输出可能包含不准确的信息(也称为幻觉)。在发布之前,务必手动核实并审核所有 AI 生成的内容,确保其准确性和可信度。」 「此审核也适用于元数据,例如 <title> 元素、元描述元素、结构化数据和图片的替代文本,这些元数据可能会显示在 Google 搜索结果中。」 |
|
这里有一个很多人没注意的细节:元数据被单独点名了。 以前那句话是「这包括元数据」,改成了「这项审核也适用于元数据」。别看只差几个字,性质完全不同:前者是列举范围,后者是把元数据并入「必须人工核实」的动作里。 翻译成执行动作就是四件事:标题、描述、结构化数据、图片 alt——这四项只要你用了 AI 生成,就得人工过一遍。外贸站最容易翻车的恰恰是结构化数据:型号、价格、库存、认证字段一旦是模型编的,你不仅可能拿到错误标记,还可能直接失去搜索功能的展示资格。 |
没变的部分同样重要:指南仍然写着生成式 AI「在研究某个主题以及为原创内容添加结构时特别有用」;仍然把「生成大量网页而未为用户增加价值」指向规模化内容滥用政策;仍然引用评分者指南 4.6.5 与 4.6.6;也仍然提醒一句——评分者指南「并非提升 Google 搜索排名的指南」,那些评分「并不会直接影响排名」。 |
|
|
|
左侧三条为网传说法,右侧为官方更新日志实际内容 |
传言一:「十月核心更新专打 AI 洗稿」 Google 官方从来没有发布过带这种措辞的公告。10 月 1 日的更新日志里,当天只列了这一条文档更新,条目说明写的是「纳入评分者指南信息」「与开发者大会宣讲口径保持一致」——没有一句提到算法行动,更没有提到「针对 AI 内容」。 更根本的一点:Google 面向站长的长期口径一直是「看目的是否为操纵排名,不看用什么工具生产」。2024 年 3 月的官方博客里就写着,长久以来的垃圾政策是——使用自动化手段(包括生成式 AI),如果主要目的是操纵搜索排名,那就是垃圾内容。这条原则到现在没变过,也不需要靠一个「十月特别行动」来成立。 |
|
传言二:「谷歌内部代号 Project Authentic」 这个名字在 Google 的官方渠道里检索不到:搜索中心文档、文档更新日志、官方博客、官方播客,都没有出现过它。它目前只出现在少数英文自媒体文章里,且这些文章彼此转述、没有一份能给出一手来源。 判断这类消息有个很朴素的办法:Google 真要推一项影响排名的机制,一定会落在官方博客或更新日志上,因为它需要站长照着改。只停留在自媒体里的「内部代号」,那就只是代号而已。 |
|
传言三:「有 Authenticity Authority 打分」 Google 从未发布过叫这个名字的排名信号。而且官方自己早就正面回应过这类说法——2024 年 3 月那篇《关于核心更新和新垃圾政策,网站创作者需要了解什么》的官方博客里,有一段问答是: |
|
官方博客原文(英文原意) 「有些第三方服务会提供网站的『声誉』或『权威』评分。这些分数与 Google 自己的任何信号都不对应,也不是来自 Google。」 换句话说:凡是你在工具里看到的「权威分」「真实度分」,都不是 Google 给的,也不要拿它去反推 Google 的算法。 |
|
|
把传言拿掉之后,剩下的才是真正会生效的东西。跟「AI 写的产品页」相关的,官方只有这三层,而且每一层都有公开文档: |
|
第一道闸口里那半句话,值得单独拎出来:「无论其制作方式如何」。 这句话的意思是,规模化内容滥用不区分人写的还是 AI 写的。你找十个外包一篇篇手写,照样可能踩;你用 AI 写十页但每页都有实测数据和图纸,也照样没事。把「AI」当成判定标准,从一开始就理解偏了。 第二道闸口对外贸站尤其现实。很多工厂站会把产品页外包给代运营或者白标内容商,页面挂在自己域名下。官方对「第三方内容」的定义很宽:站点用户、自由职业者、白标服务、非本站直接雇用的人员,全算。只要这批内容上你站的主要理由是「挂在你这儿能排得更好」,就已经落在政策的射程里了。 |
|
对独立站来说,AI 最合适的用法是搭骨架:把产品页该有的段落结构、行业通用说法、多语言初稿先铺出来。这一步能省掉大量时间,官方也明确说过 AI「在为原创内容添加结构时特别有用」。 真正决定这一页有没有价值的,是第二步——往骨架里填只有你才有的东西。这些内容的共同特点是:模型编不出来,而你随手就能拿到。 |
|
有一个很实用的自检动作:把页面上的公司名和型号名全部遮掉,再读一遍。 如果遮掉之后,这一页跟同行站上的页面读起来没什么区别,那它就正好落在官方 4.6.6 节描述的形态里——「几乎未经处理、几乎没有原创性、几乎没有附加值」。这不是 AI 的错,是你只做了第一步的错。 |
| 七步清单:AI 起草 → 人工补料 → 上线前自查 |
|
下面这份清单按时间顺序排,前面三步是生产,中间两步是核对,最后两步是上线把关。可以直接当成产品页的检查表用。 |
|
第 2 步那条「禁止它编参数」值得多说一句。这不是洁癖,是事故率问题:模型给一个看似合理的认证编号或者公差值,你如果不回原始单据核对,等到买家拿它去做验货标准,那就是商务纠纷,不是 SEO 问题了。官方这次把「务必手动核实」写进文档,针对的正是这种情形。 第 7 步的规模化自检,是外贸站最容易忽略的。一个人做三百个产品页,往往是一个模板套出来的,只在标题里换型号名。这种结构在官方垃圾政策的示例里被明确点名过——「创建许多网页,其中内容对读者几乎没有意义或完全没有意义,但包含搜索关键字」。多语言站同理:纯机器翻译、没有本地认证与本地交期信息的版本,官方示例里也把「通过翻译等自动转换方式生成大量页面」列了进去。 |
|
|
■ 一句话收尾 Google 这次没有给 AI 内容加任何新罪名。
它只是把一句老规矩写清楚了:
你发布的东西,得有人真的核过。 |
|
所以做外贸站的话,真正该做的动作其实很朴素:AI 用来省时间,人用来负责任。把实测参数、公差、包装、认证编号、装箱数据这些只有你有的东西填进去,然后把标题、描述、结构化数据、图片 alt 这四项人工过一遍。做完这两件事,你就既不在规模化滥用的射程里,也不在 4.6.6 节描述的形态里——至于网上那些新词,官方没说过,就当没发生过。 |
■ 本文引用的官方来源 1. Google 搜索中心《Google 搜索关于在网站上使用生成式 AI 内容的指南》(简体版),最后更新 2026-10-01 2. Google 搜索中心《文档更新日志》2026-10-01 条目:更新关于使用生成式 AI 内容的指南 3. Google 搜索中心《适用于 Google 网页搜索的垃圾内容政策》:滥用规模化内容、网站声誉政策 4. Google 搜索中心官方博客(2024 年 3 月)《关于 2024 年 3 月核心更新和新的垃圾内容政策,网站创作者需要了解什么》 5. Google《搜索质量评估指南》(Search Quality Raters Guidelines)公开版,4.6.5 与 4.6.6 节 本文不引用任何第三方「流量下跌百分比」类统计,所有结论均来自上述官方文档。 |
|
— 全文完 — |
 “一站到底”的杨士莪“动力与阻力”主题作文导写+素材举隅+范文示例+《人民日报》金句_专项复习_2024年_2024年高考语文作文热点新闻素材速记快用_资料_1-资料
 02句子扩写的秘诀-读后续写高分技能提升-8页_英语(2)_专项复习_2025年_2025年高考英语读后续写高分技能提升_资料
 02句子扩写的秘诀-8页_英语(2)_专项复习_2025年_2025年高考英语读后续写高分技能提升_资料
 05衔接和连贯的秘密(1)-读后续写高分技能提升-10页_英语(2)_专项复习_2025年_2025年高考英语读后续写高分技能提升_资料
 曹丕的“五官中郎将”,到底是多大的官_中小学精品资料(高清可打印)_古文化大全集628份高清资料整理版
 08解锁情感表达的七大密码-读后续写高分技能提升-11页_英语(2)_专项复习_2025年_2025年高考英语读后续写高分技能提升_资料
 07读后续写高频语法:so...that句式的妙用(教师版)-4页_英语(2)_专项复习_2025年_2025年高考英语读后续写高频语法突破(讲解+练习)
 07读后续写高频语法:so...that句式的妙用(学生版)-3页_英语(2)_专项复习_2025年_2025年高考英语读后续写高频语法突破(讲解+练习)_资料
 FUN学记|古代的仕途之路到底有多难_中小学精品资料(高清可打印)_古文化大全集628份高清资料整理版
 #必考考点#一年级语文#一年级下册#看图写话家长为孩子保存学习,用的到。
 专题02上海市静安区2026年高三一模语文作文导写与范文精析(对“AI接管人类社会是否值得期待”的认识和思考)(上海专用)2026年高考语文一模作文导写_专项复习_2026年-语文专项复习
 12修辞的力量(2)-11页_英语(2)_专项复习_2025年_2025年高考英语读后续写高分技能提升
 产品经理深入浅出第11课-产品需求文档(PRD)的写作方法(上_436套软件开发需求文档_VD516-软件开发需求文档_10各类系统软件开发需求_更新内容_产品需求文档案例(73份)
 020王菲最爱的Goyard包到底有什么来头?_X017-奢侈品鉴定教程最新合集_7、奢侈品普及课(音频+电子书)
 11修辞的力量(1)-10页_英语(2)_专项复习_2025年_2025年高考英语读后续写高分技能提升_资料
 网络热梗“真诚是唯一的必杀技”主题作文导写+相关素材+巧拟作文标题的方法-高考语文作文热点新闻素材速记快用_专项复习_2024年_2024年高考语文作文热点新闻素材速记快用_资料_1-资料
 (T8)高三第二次学业质量评价-语文作文“AI时代与人的创意”-_专项复习_2024年_2024年全国各地高考语文模拟卷作文导写讲练_资料_1-资料
 05衔接和连贯的秘密(1)-10页_英语(2)_专项复习_2025年_2025年高考英语读后续写高分技能提升
 023到底在哪里能淘到真正的古董奢侈品?_X017-奢侈品鉴定教程最新合集_7、奢侈品普及课(音频+电子书)
 第六单元写话:用多大的声音(素材积累)(统编版)_一年级语文上册(统编版)_单元写作能力提升_老课标
 第六单元写话:用多大的声音(技法+范文+素材)(统编版)_一年级语文上册(统编版)_单元写作能力提升_老课标
 第七单元写话:用多大的声音(范文点评)-(统编版·2024秋)_一年级语文上册(统编版)_单元写作能力提升_2024新课标
 第七单元写话:用多大的声音(教学设计)-(统编版·2024秋)_一年级语文上册(统编版)_单元写作能力提升_2024新课标
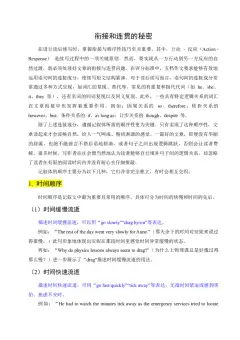 06衔接和连贯的秘密(2)-10页_英语(2)_专项复习_2025年_2025年高考英语读后续写高分技能提升_资料
 第七单元写话:用多大的声音(素材积累)-(统编版.2024秋)_一年级语文上册(统编版)_单元写作能力提升_2024新课标
 07故事冲突的七大法宝-10页_英语(2)_专项复习_2025年_2025年高考英语读后续写高分技能提升
 07倒装句的妙用-11页_英语(2)_专项复习_2025年_2025年高考英语读后续写提分技巧与训练_资料
 邀请面试话术:打电话叫人面试怎么说_2025春招题库汇总_银行题库-1_银行全套上岸资料_500套面试话术_02面试邀约话术
 4.用一只手征服“海上珠峰”的航海传奇独臂船长徐京坤+棋手用AI作弊+余华英被执行死刑+正视杨妞花带货+作文“看到别人与看清自己”_专项复习_2026年-语文专项复习_资料
 经典的产品需求文档-PRD-模板_436套软件开发需求文档_VD516-软件开发需求文档_10各类系统软件开发需求_更新内容_产品需求文档模版(13份)
 绳子到底有多长?_小学数学人教版1年级上册_8趣味故事_8趣味故事
 08解锁情感表达的七大密码-11页_英语(2)_专项复习_2025年_2025年高考英语读后续写高分技能提升_资料
 07故事冲突的七大法宝-10页_英语(2)_专项复习_2025年_2025年高考英语读后续写高分技能提升_资料
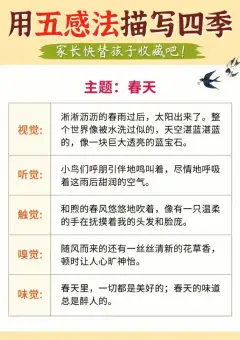 每日晨读(用五感法写四季)4页_三年级上下册资料_小学三年级学习资料-25年更新版_3-01、小学三年级语文上册_3-1-5、字贴、书写、晨读_每日晨读
 打电话面试怎么说打电话面试的话术有哪些_2025春招题库汇总_银行题库-1_银行全套上岸资料_500套面试话术_03电话面试话术
 董丽娜(全国首位视障播音硕士):“到祖国最需要的地方去!”导写+素材+议论文说理-高考语文作文热点新闻素材速记快用_专项复习_2024年_2024年高考语文作文热点新闻素材速记快用_资料
 6年级上 好文仿写小练笔 新 144页
 4年级上 好文仿写小练笔 新 160页
 3年级上 好文仿写小练笔 新 132页
 语文二上课内仿写句子小纸条27条14页仿写_2年级小红书最新热门资料
 2299二上语文1-8单元仿写句子单元汇总+仿写练习(38页)_1-6年级语文仿写_二年级上册语文仿写句子+练习(1)
 Taobao产品需求说明书(规格最全的PRD_436套软件开发需求文档_VD516-软件开发需求文档_10各类系统软件开发需求_更新内容_产品需求文档案例(73份)
 郑丽文大陆行:跨越海峡的握手,共绘统一的明天论“势”与“路”思辨作文导写_专项复习_2026年-语文专项复习_162026年高考语文作文热点新闻素材速记快用
 高考作文押题:AI领跑时代,人工智能爆火-(全国通用)_专项复习_2025年_2025年高考语文作文热点素材速递速用(全国通用)
 18“说”的门道:实用技巧大揭秘-9页_英语(2)_专项复习_2025年_2025年高考英语读后续写提分技巧与训练_资料
 专题02上海市静安区2026年高三一模语文作文导写与范文精析(对“AI接管人类社会是否值得期待”的认识和思考)(上海专用)_专项复习_2026年-语文专项复习
 5年级上 好文仿写小练笔 新 155页(1)
 二上语文1-8单元句子仿写汇总(13页)_1-6年级语文仿写_二年级上册语文仿写句子+练习(1)
 三上语文全册重点句子仿写(含答案23页)_1-6年级语文仿写_三年级上册语文仿写句子+练习(1)
 给李华写的11封信,考试直接用的英语作文模板#英语#英语作文#知识点总结#图文伙伴计划#抖音图文来了_中小学精品资料(高清可打印)_初中大全集高清资料整理版
 0910四上语文1-8单元句子仿写(20页)_1-6年级语文仿写_四年级上册语文句子仿写+练习(1)
 看拼音写词语墨熠教育官方旗舰店_一年级语文上册(统编版)_老课标资料_教学视频_第一套_009-试题试卷word版可下载打印_专项复习
 练习题——2年级看图写话专项练习多图版(30页)
 2297三上语文每日仿写句子小纸条(含答案12页12条)_1-6年级语文仿写_三年级上册语文仿写句子+练习(1)
 2025届高考作文押题:AI领跑时代,人工智能爆火-(全国通用)_专项复习_2025年_2025年高考语文作文热点素材速递速用(全国通用)_资料
 湖北恩施州市2026年高三二模语文作文导写与范文精析(“AI赋能中华文化传承”)(全国卷区通用)2026年高考语文二模作文导写_专项复习_2026年-语文专项复习_资料_2026版
 看拼音写词语专项练习墨熠教育官方旗舰店_一年级语文上册(统编版)_老课标资料_教学视频_第一套_009-试题试卷word版可下载打印_专项复习
 看图写话专项练习墨熠教育官方旗舰店_一年级语文上册(统编版)_老课标资料_教学视频_第一套_009-试题试卷word版可下载打印_专项复习
 QQ空间产品需求说明书模板-产品需求文档_436套软件开发需求文档_VD516-软件开发需求文档_10各类系统软件开发需求_更新内容_腾讯产品需求文档(5份)
 新版语文看拼音写词语扩词6年级下册25页含答案
 13词块增色训练-读后续写高分技能提升-14页_英语(2)_专项复习_2025年_2025年高考英语读后续写高分技能提升_资料
 01多维情绪表达法-读后续写高分技能提升-6页_英语(2)_专项复习_2025年_2025年高考英语读后续写高分技能提升_资料
 为什么十五运会不见奖牌榜?“每个拼搏的身影都值得喝彩,每份对体育的热爱都值得尊重”主题作文导写_专项复习_2026年-语文专项复习_162026年高考语文作文热点新闻素材速记快用
 14对话描写模型-读后续写高分技能提升-12页_英语(2)_专项复习_2025年_2025年高考英语读后续写高分技能提升_资料
 10读后续写高频语法:状语从句(教师版)-4页_英语(2)_专项复习_2025年_2025年高考英语读后续写高频语法突破(讲解+练习)
 10读后续写高频语法:状语从句(学生版)-2页_英语(2)_专项复习_2025年_2025年高考英语读后续写高频语法突破(讲解+练习)_资料
 09读后续写高频语法:定语从句(学生版)-2页_英语(2)_专项复习_2025年_2025年高考英语读后续写高频语法突破(讲解+练习)_资料
 房主任:我也能在上海上墙啦“个体与环境的关系”主题作文导写热点新闻素材-_专项复习_2026年-语文专项复习_162026年高考语文作文热点新闻素材速记快用
 看拼音写词语(作业本)墨熠教育官方旗舰店_一年级语文上册(统编版)_老课标资料_教学视频_第一套_009-试题试卷word版可下载打印_专项复习
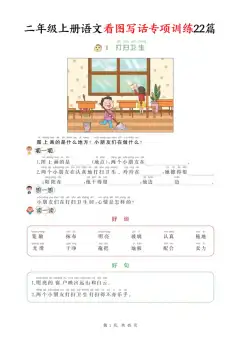 新版•2上语文《看图写话》专项训练45页_26秋小学语文《精选合集》_新版•2年级语文《精选合集》上册_新版•2上语文《看图写话》
 10读后续写高频语法:状语从句(教师版)-4页_英语(2)_专项复习_2025年_2025年高考英语读后续写高频语法突破(讲解+练习)_资料
 09读后续写高频语法:定语从句(教师版)-5页_英语(2)_专项复习_2025年_2025年高考英语读后续写高频语法突破(讲解+练习)_资料
 09五大细节描写驱动-读后续写高分技能提升-8页_英语(2)_专项复习_2025年_2025年高考英语读后续写高分技能提升_资料
 05读后续写高频语法:名词性从句(教师版)-5页_英语(2)_专项复习_2025年_2025年高考英语读后续写高频语法突破(讲解+练习)
 04读后续写高频语法:倒装句(教师版)-7页_英语(2)_专项复习_2025年_2025年高考英语读后续写高频语法突破(讲解+练习)
 04读后续写高频语法:倒装句(学生版)-3页_英语(2)_专项复习_2025年_2025年高考英语读后续写高频语法突破(讲解+练习)_资料
 03读后续写高频语法:非谓语动词havingdone(学生版)-2页_英语(2)_专项复习_2025年_2025年高考英语读后续写高频语法突破(讲解+练习)
 26法考三国法杨帆思维导图-“一镜到底”版_2026法考客观_众-H_00思维导图考点地图
 06读后续写高频语法:虚拟语气(教师版)-6页_英语(2)_专项复习_2025年_2025年高考英语读后续写高频语法突破(讲解+练习)
 06读后续写高频语法:虚拟语气(学生版)-3页_英语(2)_专项复习_2025年_2025年高考英语读后续写高频语法突破(讲解+练习)_资料