ARTICLE · 1272519
你以为文档切片只是“切断文本”?错!跨页断裂才是RAG召回失灵的隐形杀手!
我是老九,一个一直在一线折腾技术和AI的人。AI难的不是跑通Demo,而是上线以后。记录一个个真实小问题:出现了什么、怎么排查、原因在哪、怎么解决。欢迎关注我!
不要错过文章最后的总结图呦!
当前章节:第五章|知识库文件进去以后
当前小节:第二节|文档切片
本篇问题:跨页断裂
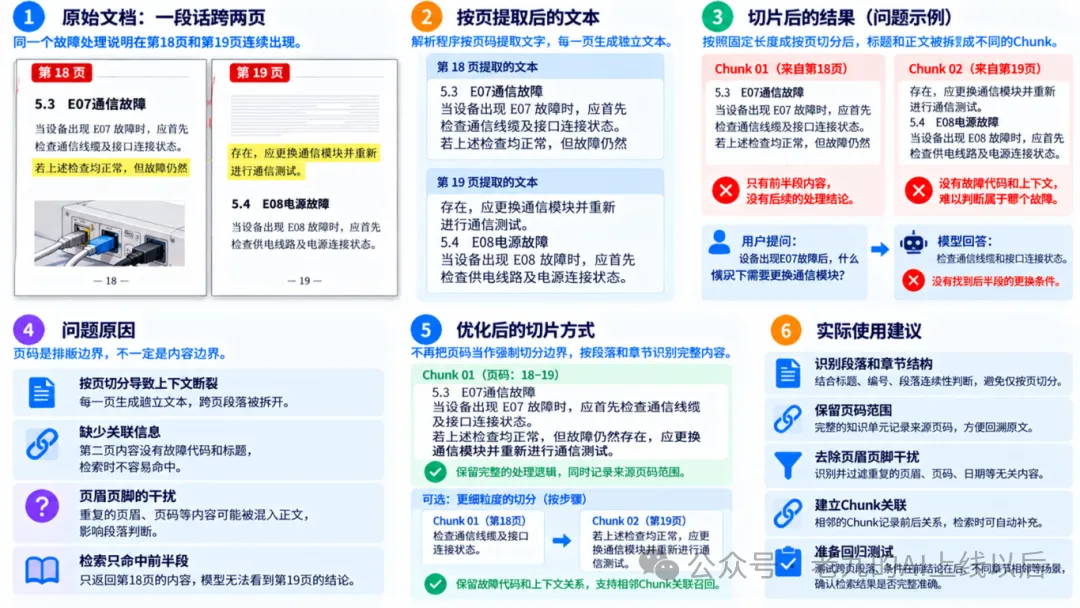
文档切片的最后一篇了,还是以例子开头吧,容易理解一些。知识库上传了设备维护手册,问:“设备出现E07故障后,什么情况下需要更换通信模块?”
AI回答:“检查通信线缆和接口连接状态。”
追问:“什么时候需要更换模块?”
AI说没有找到明确说明。
打开原始PDF,第18页最后一段写着检查通信线缆和接口连接状态,第19页开头写:“若上述检查均正常,但故障仍然存在,应更换通信模块并重新进行通信测试。”
答案就在下一页,为什么知识库只找到了前半段?
检查PDF解析结果发现:解析程序按页码提取文字,每页生成一份独立文本,切片程序又分别处理这些文本。
这样做容易保存页码,用户检索到内容后,也方便定位原文。
但PDF的分页位置,不一定是内容真正结束的位置。这里丢失的不是文字,而是跨页的上下文关系。
为了确认问题,先检查两个地方。一个是PDF解析结果,第18页和第19页的文字是否完整。另一个是切片结果,两个Chunk之间有没有保留关联。
不能因为内容跨页,就认定检索一定会失败。如果系统能同时召回两个Chunk,或者命中第一页后自动补充下一页的相关内容,模型仍然可能正确回答。要看的是,这次请求最终给模型提供了哪些内容。
尝试改动:不把每页当成必须结束的切片边界,先识别连续的段落和章节。
又有个问题简单把相邻两页拼起来,可能把两个不同故障混在一起。不能无条件合并相邻页面。
要结合标题变化、段落连续性、编号关系和版面结构判断。
这些规则也不是百分之百可靠,复杂文档仍然需要抽样验证。
还有更稳妥的方式:切片时保留完整内容,同时单独记录来源页码。
比如E07故障处理跨越第18页和第19页,可以把它作为一个知识单元,同时记录来源页码范围为18—19。
内容太长仍然可继续拆成多个Chunk,但要保留所属章节、顺序编号以及相邻片段的关联。检索命中其中一段后,根据需要补充前后内容。
实际项目还有个容易忽略的干扰:页眉和页脚。
例如每一页都有“设备维护手册”“第18页”“内部资料”等内容。解析程序直接把这些文字插进正文,原本连续的一句话中间就可能夹进页码和重复标题。切片程序可能误以为这里出现了新段落。
处理跨页问题时,检查页眉、页脚有没有混进正文。
对于固定模板的PDF,可以根据位置和重复特征识别这些内容,但不能简单删除页面顶部和底部的所有文字,以免误删真正的正文。
改完以后,我会专门准备几类测试。
第一类,故障处理步骤跨页,检查能否返回完整步骤。
第二类,条件在上一页、结论在下一页,检查能否正确关联。
第三类,两个不同章节恰好在相邻页面,检查是否错误合并。
第四类,跨页表格和带有重复页眉的文档,检查是否丢失表头或混入无关内容。
PDF的页码是排版边界,不一定是知识边界。
做知识库时,页码应该帮助我们定位答案,而不是成为强行切断答案的理由。
如果你读着还行,欢迎点赞收藏关注;如果有不同的观点,也欢迎大家留言讨论。