ARTICLE · 1273929
MinerU处理论文PDF,能省多少整理时间?
论文下载下来以后,真正花时间的常常不是“打开它”,而是把它变成后面能继续使用的材料:找到章节、摘出段落、整理到自己的笔记库里。重复整理步骤,才是这篇要解决的麻烦。
PDF 很适合保存原貌,却不总适合后续整理。复制出来的文本可能断行、错序;扫描件甚至没有可选中的文字。
MinerU 做的是文档解析:把 PDF 等文件转换成 Markdown 等结构化文本。它可以替你完成格式转换这一步,但解析不等于理解,不会替你判断论文观点、核实引文或形成文献综述。
我之前把 MinerU 用在本地文献整理流程里,负责把论文 PDF 转成 Markdown,再交给后续的归档和检索流程。它解决的是“文本怎么从 PDF 里出来”,研究判断仍然要回到论文原文。
在我的工作流里,AI 读转换后的 Markdown,比直接读取同一篇 PDF,输出质量会明显改善。Markdown 让 AI 读得更顺,它更容易按章节和段落读取内容,后续做摘要、提取论点或回答追问时也更顺。
这不是 MinerU 替 AI 提升了学术判断,而是先把输入整理得更适合阅读。遇到扫描质量差、公式复杂或解析顺序不对的页面,Markdown 也可能带着错误进入下一步,所以关键观点仍要回到 PDF 核对。
从 PDF 到可整理文本
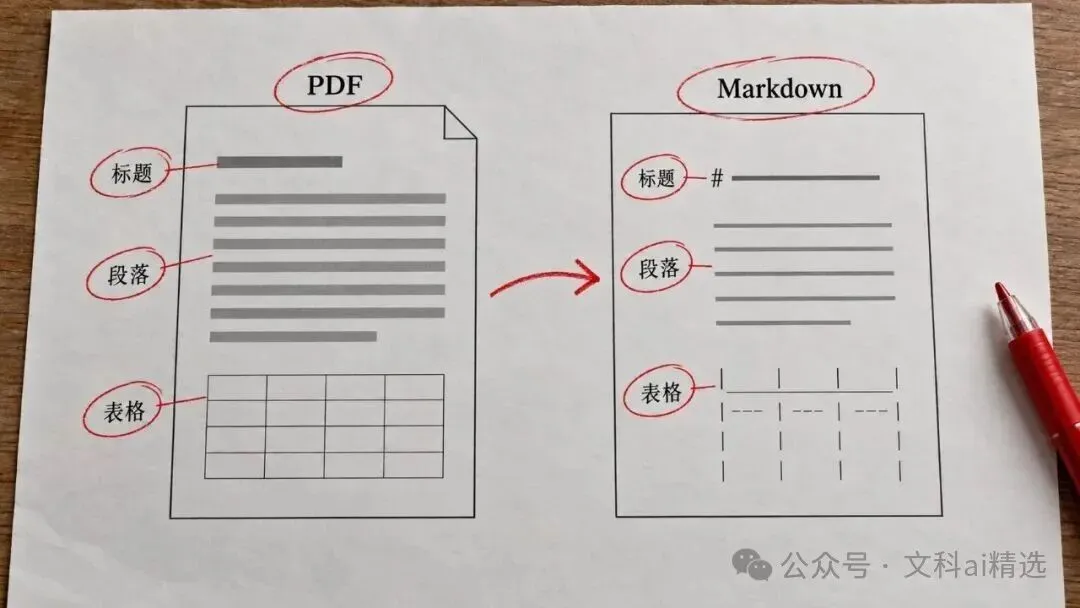
可以把 MinerU 想成一台“论文拆包器”。输入是一份 PDF,输出可以是 Markdown;它会尝试识别标题、段落、表格和图片等内容,并组织成可继续处理的文本副本。
这一步的价值,是把固定版面的文件转换成更方便搜索和编辑的 Markdown。例如,读完一篇论文后,可以把 Markdown 放进 Obsidian 等笔记库,再补上自己的主题标签、阅读笔记和文献管理信息。
但“转成 Markdown”不等于“自动读懂论文”。研究问题、理论框架、材料来源和作者论证,仍需要研究者自己判断。它不替你判断论文观点、核验引文或写综述。MinerU 输出的文本不应直接当成可靠引文来源。
官方仓库:https://github.com/opendatalab/MinerU
上手:先跑一篇
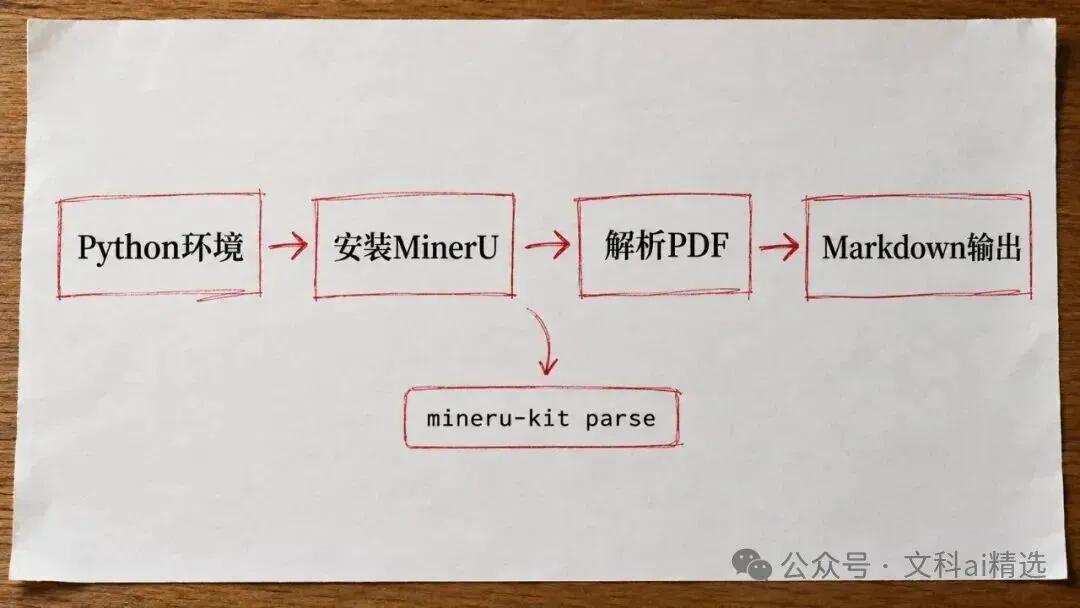
MinerU 4.0 官方快速开始文档建议新环境从 Python 3.12 起步,支持范围为 Python 3.10 到 3.14。下面用 uv 这个 Python 环境工具操作;如果电脑还没有 uv,先按官方安装说明准备好它。然后在 Windows PowerShell 里建一个独立环境:
uv venv --python 3.12 .venv .\.venv\Scripts\Activate.ps1 uv pip install -U "mineru>=4.0,<5"安装后,试着把一篇 PDF 转成 Markdown:
mineru-kit parse "论文.pdf" -o "论文.md" --tier standardstandard 是面向复杂版面和较高解析质量的档位。初次解析可能下载模型,实际耗时和硬件配置有关。官方文档也列出了不同运行引擎和设备要求,Python 版本符合范围,不代表所有 GPU 引擎都能直接运行。
如果 PDF 本身有文字层,快速预览可以选择 flash;扫描版 PDF 则需要OCR 模式和相应模型。只读取 PDF 文字层的命令不会自动识别扫描页。
还有一个容易忽略的区别:mineru-kit parse 适合直接导出文件,默认处理 PDF 全部页面;mineru parse 使用文档库,默认从前 10 页开始,长文档可按它返回的位置继续读。先用短论文试跑,确认输出目录和结果,再决定是否批量处理。
官方快速开始:https://opendatalab.github.io/MinerU/quick_start/
接进自己的文献库
一个稳妥的做法,是把不同材料分开放:
- 原文件
保留 PDF,作为后续查页码和核对引文的依据。 - 解析文本
保存 MinerU 输出的 Markdown,供搜索、摘录和编辑。 - 阅读记录
在 Obsidian 等笔记库里补主题、自己的摘要和待核页码。
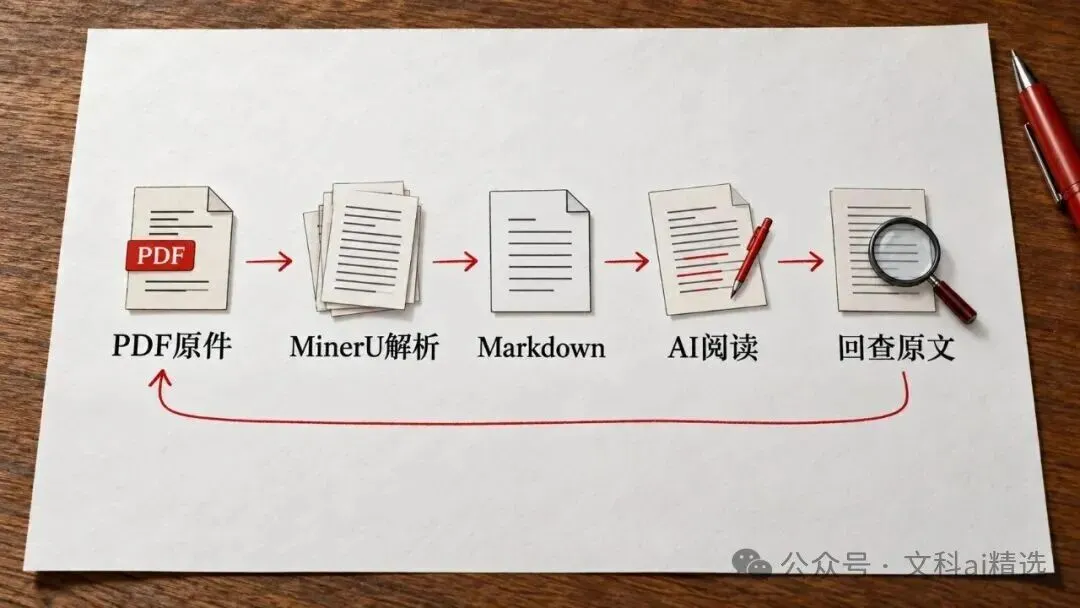
文件可以按“作者—年份—短标题”命名,再把 Markdown 放进对应的主题文件夹。PDF 存原件,Markdown 便于检索,两种材料各有用途。
原始 PDF 负责保存证据,Markdown 负责方便检索和继续整理。读到某个观点时,在笔记里写下自己的概括、主题标签和待核页码;准备引用前,再打开 PDF 对照原页。
如果你的流程后面还会用 AI 搜索笔记,也应把解析文本当作检索入口。检索命中后回到 PDF,核对上下文、页码和脚注。扫描件、双栏排版、复杂表格或公式,更要抽查对应页面。
本地解析与隐私边界
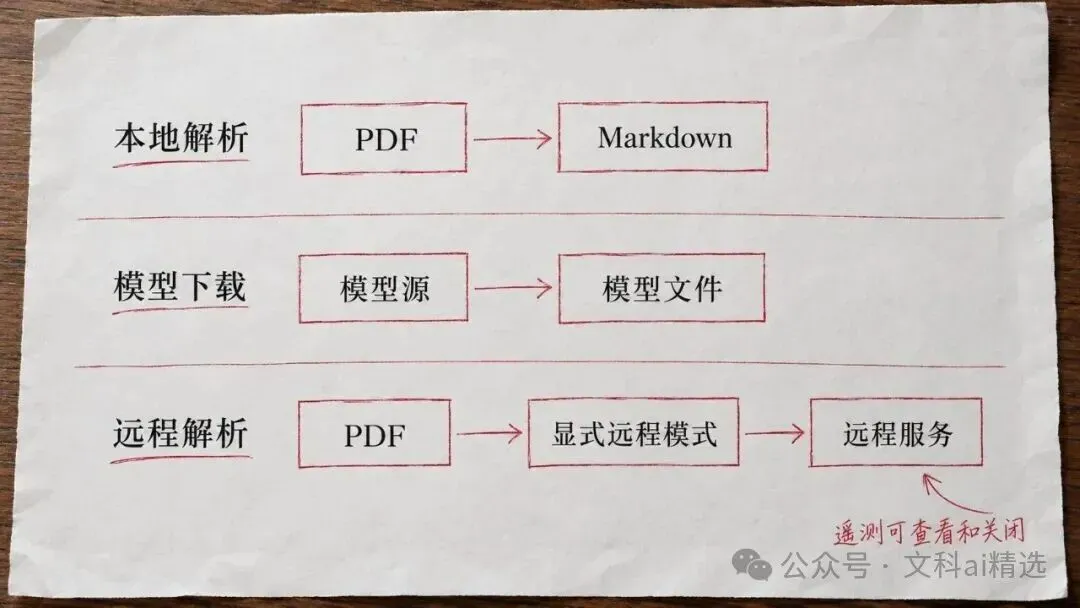
MinerU 官方文档说明,默认解析在本地进行;使用远程解析需要显式选择远程模式。首次安装或解析时,模型文件可能从模型源下载,这和把论文文件上传到远程解析服务是两件事。
项目也提供匿名使用与诊断遥测的查看和开关命令。如果你处理的是未公开论文、访谈材料或其他敏感文件,先阅读官方隐私说明,确认解析模式和遥测设置可单独查看和关闭,再决定是否使用。
“本地解析”说的是文档解析路径,不等于整个软件完全没有网络行为。对不适合联网的材料,保持本地解析,不要启用远程模式;同时保留原文件,避免把解析副本误当作唯一档案。先确认解析和遥测设置。
解析档位和运行方式:https://opendatalab.github.io/MinerU/usage/tiers/
它适合替你做哪一步
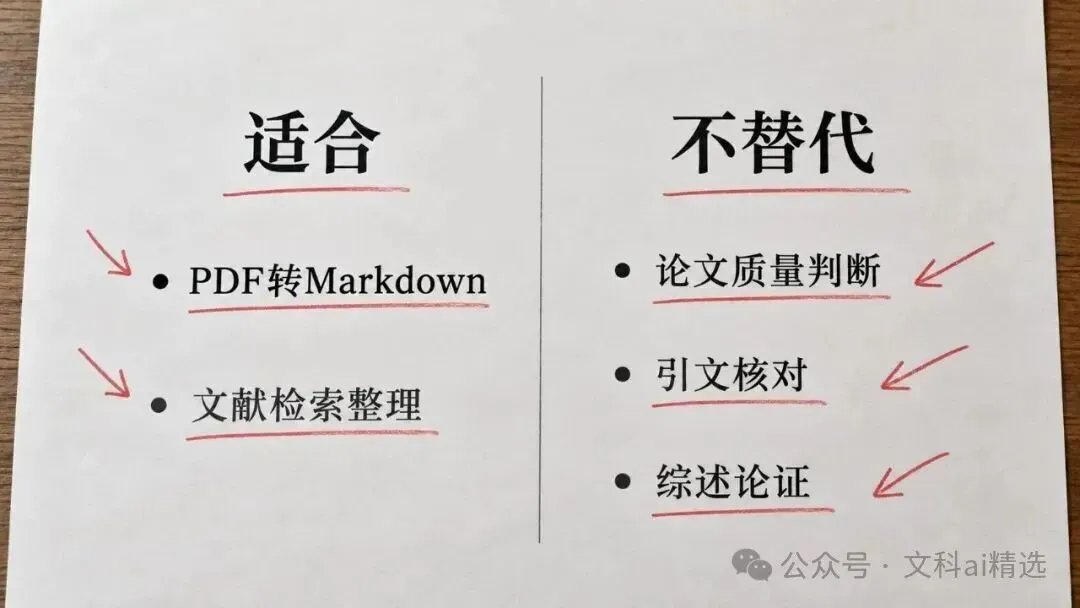
如果你手头有一批论文 PDF,想把内容转换成可搜索、可编辑的 Markdown,MinerU 值得放进文献整理流程里试一篇。它尤其适合承担文件格式转换这个重复步骤。
如果你的目标是自动判定论文质量、提取可信引文、直接写出综述,单靠 MinerU 还不够。解析结果要抽查,引用要回原文核对,个人笔记也需要你自己组织。研究判断归研究者。
目前官方 Releases 页面列出的最新版本为 MinerU 4.0.12,发布日期是 2026 年 10 月 11 日;本地安装时,应以仓库的快速开始和版本说明为准。官方许可证以 Apache 2.0 为基础,并附有额外条款,商用前建议读完仓库中的 LICENSE。
GitHub 仓库:https://github.com/opendatalab/MinerU
官方中文说明:https://github.com/opendatalab/MinerU/blob/master/README_zh-CN.md
快速开始:https://opendatalab.github.io/MinerU/quick_start/
版本发布:https://github.com/opendatalab/MinerU/releases
许可证:https://github.com/opendatalab/MinerU/blob/master/LICENSE.md
往期推荐:参考文献核查工具文章
https://mp.weixin.qq.com/s/ewBjmkkSH8KsR1i-nzyzlg
想要了解更多 AI 资讯?关注我,每天更新一个高质量 AI 项目。