ARTICLE · 1278998
AI 时代插件:Agent、MCP、工具调用、Wasm,当模型成了"调工具的人":AI 如何重写系统的契约与安全
18 讲"企业把插件市场搬进防火墙后",这一篇讲"AI 把'写插件的人'换成了'调工具的模型'"——契约的读者从编译器变成模型,安全边界被重写。
一、引子:当"调工具的人"不再是人
第 18 篇讲企业把插件市场搬进防火墙后,用私服、合规门禁、内部 catalog 去治理"人写的代码"。那个故事的潜台词是:插件仍然是人写、人审、人装的。
但 2023 到 2025 这两年,插件世界里"调工具的人"悄悄变了。
2023 年 3 月,OpenAI 发布 ChatGPT 插件,模型第一次能自己决定"调哪个 API、传什么参数"。2024 年 11 月,Anthropic 开源 Model Context Protocol(MCP),把"模型连工具"这件事标准化。到 2025 年底,MCP 已有上万个公开服务器、每月近亿次 SDK 下载,并被捐给 Linux 基金会。
一个 AI agent 不需要你写扩展点、注册清单、编译代码。它读一段自然语言描述,就知道怎么调你的 API、查你的数据库、发一封邮件。
这正是本文要回答的:AI 会如何改变插件系统? 我的判断是——插件系统的骨架没塌,但三件事被改写:契约的读者、隔离的边界、安全的假设。
二、核心问题:AI 会如何改变插件系统
把问题拆细,其实是三个子问题:
- 1.
契约变了谁在读? 传统插件的 manifest 是给编译器、给宿主框架读的;AI 插件的"工具描述"是给大模型读的。读者从机器变成模型,契约的表达方式就得从"机器可解析的 schema"扩展到"模型可理解的自然语言 + 结构化 schema"。
- 2.
隔离要兜住谁? 第 9 篇说过,隔离模型按信任级别选。AI 插件把"不可信"推到极致——不但代码不可信,连"调哪个工具、传什么参数"的决策者都是模型,而模型还可能被注入。
- 3.
安全假设还成立吗? 第 10 篇讲最小权限、签名、供应链。但 AI 插件引入了一种全新攻击面:攻击者不攻你的代码,而是攻模型对工具描述的理解。
这三个问题的答案,串起了本文的主线:AI 插件从"人写代码"转向"模型调工具",契约与安全因此比以往任何时候都更关键。
三、范式转移:从"人写代码"到"模型调工具"
3.1 传统插件闭环:人是作者,宿主加载代码
回顾第 3 篇的核心闭环:契约定义 → 清单声明 → 依赖解析 → 按需激活 → 隔离执行 → 生命周期回收 → 治理反馈。在这个闭环里,人是主角:开发者写代码、写 manifest、声明权限、发布到市场;宿主负责加载、隔离、回收。
契约的读者是编译器和宿主框架。manifest 里的 permissions、contributes、activationEvents 是机器可解析的。人和机器分工明确:人写意图,机器执行意图。
3.2 AI 插件闭环:模型读描述、做决策、收结果
AI 插件换了一个主角。闭环变成:
工具暴露描述(自然语言)+ 参数 schema(JSON Schema) → 模型读描述,判断"这件事该不该调这个工具" → 模型按 schema 填参数 → 宿主执行 → 结果回流进上下文 → 模型继续推理,可能再调下一个工具。
注意这个闭环里,决策者变成了模型的推理循环。宿主不再"按预定逻辑调用扩展点",而是把"是否调用、怎么调用"交给了 LLM。
这就是范式转移的本质:扩展点从"代码接口"变成了"模型可理解的能力声明";调用者从"宿主框架"变成了"模型的推理"。
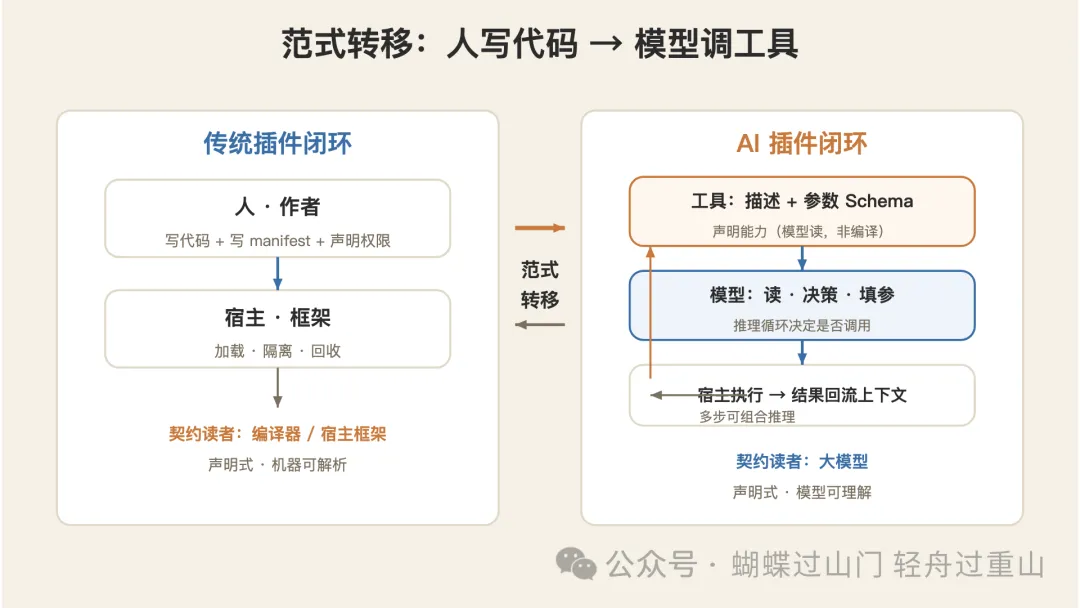
范式转移:人写代码 → 模型调工具
3.3 契约的读者变了,声明式思想没变
但请不要误读——这不是对插件思想的颠覆,而是它的延伸。
第 6 篇讲清单驱动的核心:声明与执行分离,是插件可治理的前提。AI 插件的"工具描述 + schema"同样是声明式的:你声明能力,模型决定何时用。只不过传统 manifest 是给静态分析器看的,工具描述是给一个会"理解语义"的读者看的。
同一个"稳定契约下安全组合独立部件"的定义(第 1 篇),依然成立。变化的是契约的表达介质和消费方式。
四、工具调用三要素:描述、Schema、回流
要理解 AI 插件,先抓住工具调用的三要素。这三件事,正好对应传统插件闭环里的"声明—调用—结果":
- 1.
描述(description):告诉模型"这个工具能干什么、什么时候该用它"。这是模型做决策的依据。描述写得歧义,模型就调错工具;描述里被塞了恶意指令,模型可能被执行它本不该做的事(这点第八章展开)。
- 2.
参数 schema(input schema):通常是 JSON Schema,约束模型填什么。它把"模型的自由发挥"框进结构化边界——这也是传统插件里"契约"的延续:无论读者是人还是模型,接口的形状必须被机器强制。
- 3.
结果回流:工具执行结果回到模型上下文,模型据此继续推理或再调工具。这一步让"调工具"不再是一次性函数调用,而是一个多步、可组合的推理过程。
三要素里藏着一条纪律:schema 是机器强制的,描述是模型解释的。前者保证结构正确,后者决定语义正确——而"语义正确"恰恰是 AI 插件最难治理的地方。
五、MCP 解剖:把"模型调工具"标准化
5.1 为什么需要 MCP
2023 年的 ChatGPT 插件其实已经在做"模型调工具"。但它的问题是:每一家、每个产品都自己写胶水代码——给 Slack 写一个连接器,给 GitHub 写一个,给内部数据库再写一个。集成脆弱、不可复用、跨模型跨厂商无法共享。
MCP 的 thesis 很简单:AI 助手需要一种标准方式连接世界的数据和工具。它把"连接器"标准化为一个客户端—服务器协议:一个 MCP server 暴露 tools、resources、prompts,任何 MCP client(你的 IDE、你的 agent 框架、你的聊天应用)都能调用,而不必知道底层实现。
业界给它的比喻是 "USB-C for AI"——一个统一接口,插上就能用。
5.2 架构:Host / Client / Server + JSON-RPC
MCP 采用客户端—服务器架构,三层角色:
- •
Host(宿主):运行 AI 应用的主体,比如 Claude Desktop、VS Code、Cursor。它管理一个或多个 Client,掌握全局上下文。
- •
Client(客户端):Host 内部为每个 Server 维护的一个连接,负责协议握手、消息路由。
- •
Server(服务器):暴露能力的独立进程/服务,向外提供 Tools(可执行的带 schema 的函数)、Resources(通过 URI 寻址的数据对象,如文件、数据库记录)、Prompts(可参数化的复用提示模板)。
传输层用 JSON-RPC 2.0:本地工具走 stdio(标准输入输出),远程服务器走 SSE over HTTP。这套设计刻意贴近开发者已有的心智——你会发现它和第 6、7 篇讲的"清单 + 注册表 + RPC"是同一套逻辑,只是把"人调用的 API"换成了"模型调用的工具"。
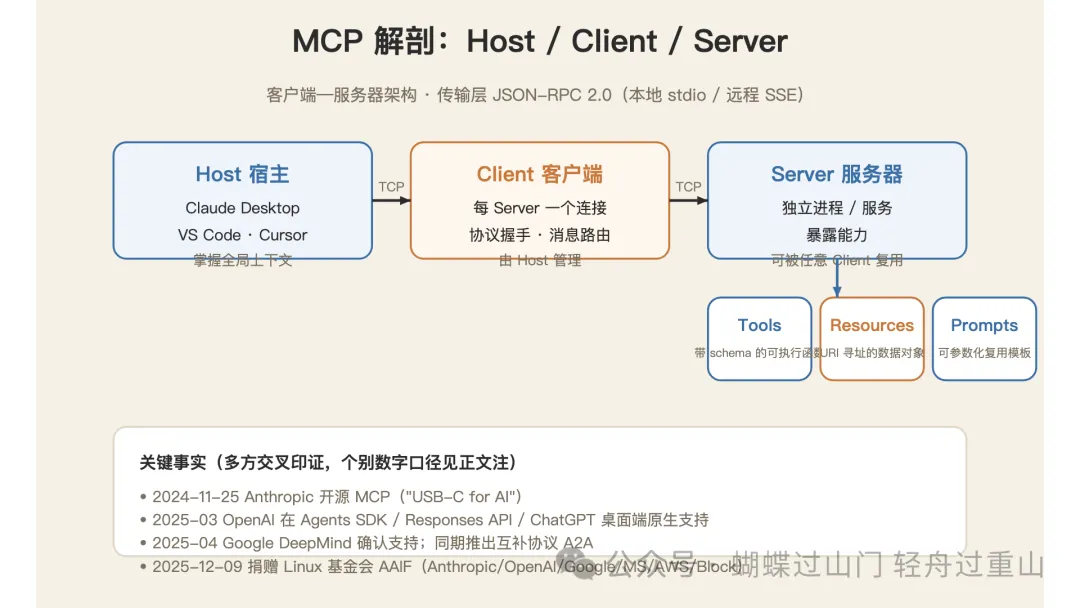
MCP 解剖:Host / Client / Server + JSON-RPC 传输
5.3 时间线:从 Anthropic 内部工具到行业底座
MCP 的扩散速度值得单独记一笔(多方来源交叉印证,个别数字口径见文末注):
- •
2024-11-25:Anthropic 正式开源 MCP。
- •
2025-03:OpenAI 宣布在 Agents SDK、Responses API、ChatGPT 桌面端原生支持 MCP(Sam Altman 原话"人们喜欢 MCP,我们很高兴在产品里加上")。作为直接竞品率先接纳,几乎宣告了生态胜负。
- •
2025-04:Google DeepMind 确认 Gemini 支持 MCP;同期 Google 推出自己的互补协议 A2A(见第六章)。
- •
2025 下半年:生态爆发——公开服务器从 2024-11 的约 10 个,到 2025 年中的数千、年底的超 10000 个;月 SDK 下载逼近 1 亿;300+ 客户端(编辑器、聊天应用、企业平台)。
- •
2025-12-09:Anthropic 将 MCP 捐给 Linux 基金会旗下的 Agentic AI Foundation(AAIF),共同创立者包括 Anthropic、OpenAI、Google、Microsoft、AWS、Block。这一步是关键的基础设施治理动作——它让企业采购和法务相信"这个协议不会被单一厂商抛弃或分叉"。
从一家公司的内部工具,到行业的"通用连接层",MCP 只用了十三个月。这个速度在基础设施标准里极罕见。
5.4 与 ChatGPT 插件的对照:同一念想的两次尝试
把 MCP 和 ChatGPT 插件放在一起看,会很有意思——它们想解决的是同一个问题(让模型调外部工具),但结局相反:
ai-plugin.json | ||
ChatGPT 插件被弃用的核心原因:每会话限 3 个插件限制了组合、插件商店是独立面板而非产品一等公民、GPTs 用无代码方式做了同样的事还更易构建。它的"插件"本质是 vendor-locked 的;而 MCP 把同样的能力抽象成厂商中立协议——自动化平台 Zapier、Make、Workato 在 2025 年纷纷接入 MCP,让自己的流程变成"任何兼容 agent 都能调的工具"。
结论:ChatGPT 插件是第一次尝试,MCP 是把那次尝试的"连接"念头抽出来做成公共标准的继任者。
六、协议版图:MCP、A2A 与插件三张网
理解了 MCP,再看更宽的协议版图,会看清三张网如何分工:
- •
传统插件系统(第 1–18 篇的主角):编译期契约 + 代码执行。依然是稳定底座——VS Code 扩展、Chrome 扩展、WordPress 插件,它们处理的是"把一段可信代码安全地装进宿主"。
- •
MCP:纵向(vertical),连接"模型 ↔ 工具/数据"。它解决的是 agent 如何调用外部能力,是"模型到工具的 USB-C"。
- •
A2A(Agent2Agent):横向(horizontal),连接"agent ↔ agent"。Google 于 2025-04 以 Apache-2.0 发布并移交 Linux 基金会,发布即有 50+ 企业伙伴(Atlassian、Salesforce、SAP、ServiceNow、Workday)。它的机制是 Agent Cards(机器可读的能力广告,放在
/.well-known/agent.json)、Task 对象(带生命周期状态)、Messages、Artifacts;传输用 JSON-RPC 2.0 over HTTP/S + SSE。
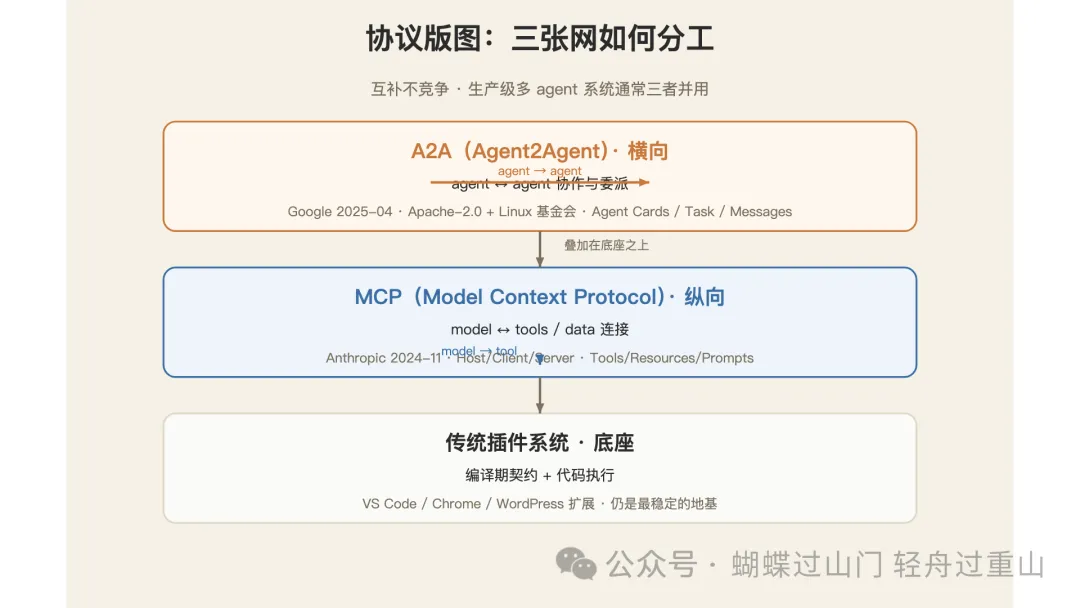
协议版图:MCP(纵向·模型到工具)、A2A(横向·agent 到 agent)、传统插件(底座)
三者的关系可以这样记:传统插件是地基,MCP 是"模型到工具的 USB-C",A2A 是"agent 之间的会议室"。它们不是替代关系——生产级多 agent 系统通常同时需要 MCP(每个 agent 自己连数据/工具)和 A2A(agent 之间委派任务)。一个有意思的隐喻:MCP 是车间里每个工人知道工具在哪、怎么用;A2A 是工人们坐进会议室,互相知道谁擅长什么、怎么协作。
需要提醒的是:协议管连接,不管内容质量。MCP 不管你的工具返回的数据是否过期、A2A 不管 agent 们是否基于一致的业务定义。上下文层(context layer)是两者共同的地基,也是企业真正该先建好的部分。
七、Wasm 组件模型:AI 推理的隔离运行时
范式转移带来一个尖锐问题:当"调工具的人"是模型,而模型可能出错或被骗,我们该怎么隔离那些被调的代码?这恰好接回第 9 篇的隔离模型。
7.1 为什么 Wasm 适合"不可信模型调不可信代码"
AI 插件里,被调的 server 常常就是第三方代码——它可能来自 npm、PyPI,或一个远程服务。宿主需要在不给它环境权限的前提下运行它。WebAssembly 的安全模型是 deny-by-default:模块启动时对宿主文件系统、网络、环境变量零权限,宿主在实例化时显式授予。模块无法做 syscall,内存线性隔离,即便有缓冲区溢出也跳不到宿主代码。
更妙的几个属性:冷启动微秒到毫秒级(远快于容器 100ms–1s)、体积 KB–MB、跨架构(x86/ARM/RISC-V 一份字节码通吃)、高密度(一个进程可承载数千模块)。这些让它成为"按请求加载第三方插件"的理想运行时。
7.2 WASI 0.2 Component Model:粒度能力
单有 Wasm 只定义了计算,不定义系统交互。WASI(WebAssembly System Interface)补上这一环。WASI 0.2(Preview 2) 建立在 Component Model 之上,用 WIT(WebAssembly Interface Types) 描述模块与宿主之间的类型化接口——组件之间可以传递富结构(record、variant、list),而不是裸指针。
关键在安全粒度:WASI 0.2 不再给"整个文件系统"权限,而是授予"某个特定目录、只读";不再给"整个网络",而是"到某个特定主机的 TCP socket"。这种最小权限的能力授予,正好对应第 10 篇讲的"能力声明"。它让宿主可以用最小权限跑不可信插件——这正是 AI 场景下"模型可能调错工具、工具本身也可能不可信"的双重风险所需要的。
7.3 运行时不信任何人:Wasmtime / WasmEdge / Spin / Workers
几个主流运行时各有侧重:
- •
Wasmtime(Bytecode Alliance 参考实现,~3ms 冷启动,15MB 内存):生产级多租户基础设施首选,AWS Lambda、Fastly、Azure 都在用。
- •
WasmEdge(CNCF Sandbox):优化边缘与 AI 推理,带 WASI-NN(神经网络推理接口),适合把小模型打包成组件在边缘跑。
- •
Fermyon Spin:serverless Wasm 框架;2025-12 Akamai 收购 Fermyon,Spin 3.0 进了 CNCF Sandbox,边缘实测 7500 万请求/秒、亚毫秒冷启动。
- •
Cloudflare Workers:用 V8 Isolates 在同一进程里跑数千隔离单元,隔离由运行时代码生成强制,并刻意削弱本地时钟测量以防御时序侧信道。
对 AI 插件而言,Wasm 组件模型提供了一层"既快又牢"的沙箱:模型可以频繁地、动态地加载第三方工具代码,而宿主不必把整个机器托付出去。它把第 9 篇的隔离模型,推进到了"不可信模型调不可信代码"这一最严苛的信任层级。
八、新安全面:当"调工具的人"会被骗
前面讲的是机会,这一节讲代价——也是 AI 插件最容易被轻视、却最致命的部分。
8.1 根因:所有输入都进了同一个上下文
传统安全的默认假设是:用户输入是数据,代码和配置是受信任的指令。但 LLM 把所有东西——工具描述、文件内容、API 响应、用户指令——都放进同一个 context window,并且模型会把它们一视同仁地当作"指令"来理解。
这意味着攻击面从"聊天框"爆炸式扩展到整个工具生态:一个 Slack 消息、一张网页、一封邮件、一份文档,都可能藏着让模型去调某个危险工具的指令。Simon Willison 在 2025 年 4 月就指出,MCP 的架构把经典的提示注入(prompt injection)问题,以大得多的爆炸半径重新打开了。
8.2 三类攻击:工具投毒 / Rug pull / 混淆副手
围绕 MCP,安全研究(Invariant Labs、Trail of Bits、Cloud Security Alliance 等,2025)归纳出几类架构级而非实现级的攻击:
- •
工具投毒(tool poisoning):把恶意指令嵌进工具的描述字段或参数定义——这段文本模型会读,但人类在审批安装时通常看不到全文。模型把它当成权威指令,于是去读凭据文件、外泄数据。Invariant Labs 在 2025-03 给出概念验证:让模型先读并外泄用户的 MCP 配置文件(含服务器凭据),再执行本来的操作。更隐蔽的是跨工具污染 / 工具影子(tool shadowing):多个 server 连到同一 agent 时,恶意 server 注册一个与可信工具同名的工具,悄悄拦截调用。
- •
Rug pull(拉地毯):MCP server 被允许在会话之间静默修改自己的工具定义。它可以在你审批时呈现无害能力,之后某次会话偷偷换成恶意定义,而不触发重新授权。
- •
混淆副手(Confused Deputy):被攻陷的 server 获取并重放 agent 为企业服务合法获取的 OAuth token,把 agent 的授权变成令牌窃取机制。
还有一类实现级但影响巨大的漏洞:CVE-2025-6514(mcp-remote,CVSS 9.6,2025 年披露),恶意服务器在 OAuth 流程里返回一个 crafted 的 authorization_endpoint,被原样传给操作系统执行——本质是几十年的命令注入老 bug,只是换到了"开发者连不可信 MCP server"这个新上下文里触发 RCE。
8.3 数字与案例:66% 的服务器有安全问题
这不是理论风险。2025 年的几项扫描触目惊心:
- •
AgentSeal 扫描 1808 个在线 MCP 服务器,66% 存在安全发现——这是快速膨胀、基本未经审计的软件品类的真实写照。
- •
Invariant Labs 的概念验证里,一个带约 14000 星标的 GitHub MCP server 被恶意 issue 注入:开发者让 agent 审阅公开 issue,agent 遵循隐藏指令,从用户私有仓库扒数据,再通过开公开 PR 泄露出去——无需窃取凭据,因为 agent 本来就有权限。
- •
"三要素规则"是设计审查里最有用的判断:一次 agent 被利用,需要同时具备——(1)能读私有数据、(2)摄入了攻击者控制的不可信输入、(3)有能外传的出站通道。三者去掉任意一个,攻击链就断。GitHub 那次致命,正是因为一个 token 能触达所有仓库。
防御手段并不新(最小权限、工具 allowlist、版本 pin、把工具输出当不可信数据 sanitize、不可逆动作加 human-in-the-loop 确认、全量审计日志),难的是把这些纪律应用到"默认信任一切"的 agent 系统里。零信任,在这里不是口号,而是架构前提。
九、十项检查清单:AI 插件与 Agent 工具治理
把上面的教训收敛成一份可落地的清单(与第 10、13 篇的安全/可观测性清单呼应):
- 1.
契约双轨:工具的"机器强制 schema"和"模型读的描述"分开审计——描述里不允许藏指令。
- 2.
描述即攻击面:把工具描述、参数定义当作不可信输入扫描,检测隐藏指令(tool metadata scanning)。
- 3.
版本钉死(pin):MCP server 像依赖一样管理,对 rug pull 做哈希级变更告警。
- 4.
最小权限 per session:每个 agent 会话的 token 只够当前任务用,不要组织级常驻凭据。
- 5.
出站闸门:开 PR、发邮件、出站 HTTP、写共享存储等"越界动作"强制 human-in-the-loop 确认。
- 6.
隔离执行:第三方工具代码默认跑在 Wasm/容器沙箱里,deny-by-default 授予能力。
- 7.
输出 sanitize:工具返回结果当作不可信数据,防止间接提示注入穿透到下一次工具调用。
- 8.
审计日志:记 agent 实际做了什么(工具调用序列),而不只是用户问了什么。
- 9.
内部注册表:只用经审计、签名的 server 白名单,而非随意
npx装一个未审查的包。 - 10.
异常监测:对工具调用模式做行为异常检测,识别被注入后的越权调用。
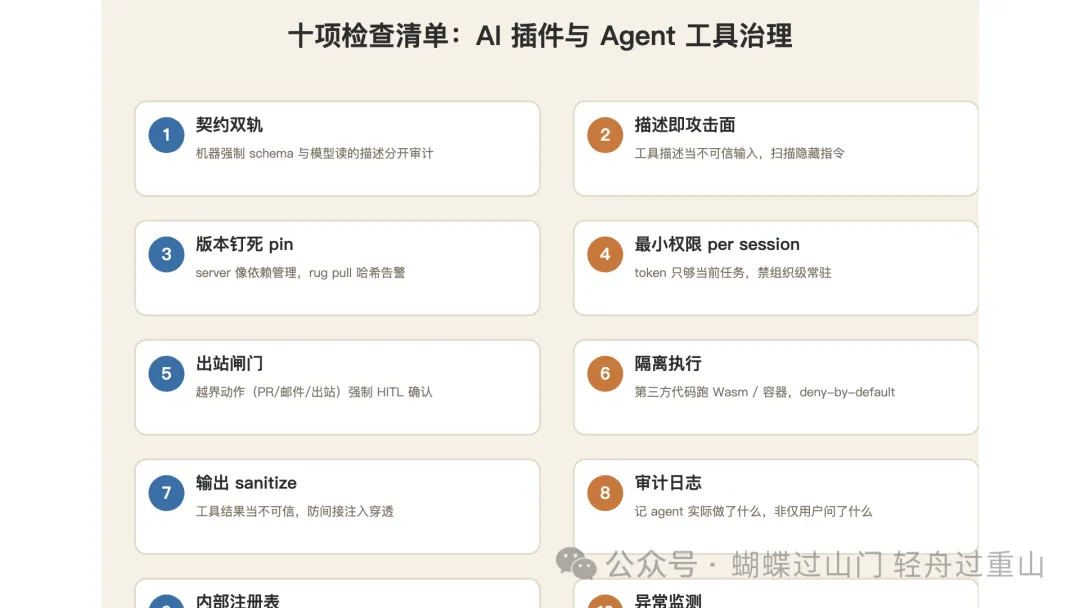
十项检查清单:AI 插件与 Agent 工具治理
十、衔接 20:设计一个同时容纳"人写"和"模型调"的插件系统
第 20 篇会是这个系列的收口——从 0 到 1 设计一个优秀插件系统的方法论。而 19 篇留下的核心命题正好喂给它:
未来的插件系统,几乎必然要同时容纳两类消费者——人写的扩展和模型调的工具。这意味着设计者必须回答:
- •
契约层要不要同时表达"机器可解析 schema"和"模型可理解的描述"?
- •
隔离模型要不要为"不可信模型调不可信代码"预留最严苛的信任层级(Wasm 组件模型)?
- •
安全模型要不要从一开始就假设"调用决策者可能被注入",把零信任做成默认?
可以说,AI 没有推翻插件系统,它把插件系统第 1 篇就立下的那句话推到了极致——"在稳定契约下安全组合独立部件"。只是现在,"独立部件"可能是模型,"稳定契约"既要机器强制、也要模型理解,"安全组合"则要多兜住一层"决策者本身可能被骗"。
配图
- •
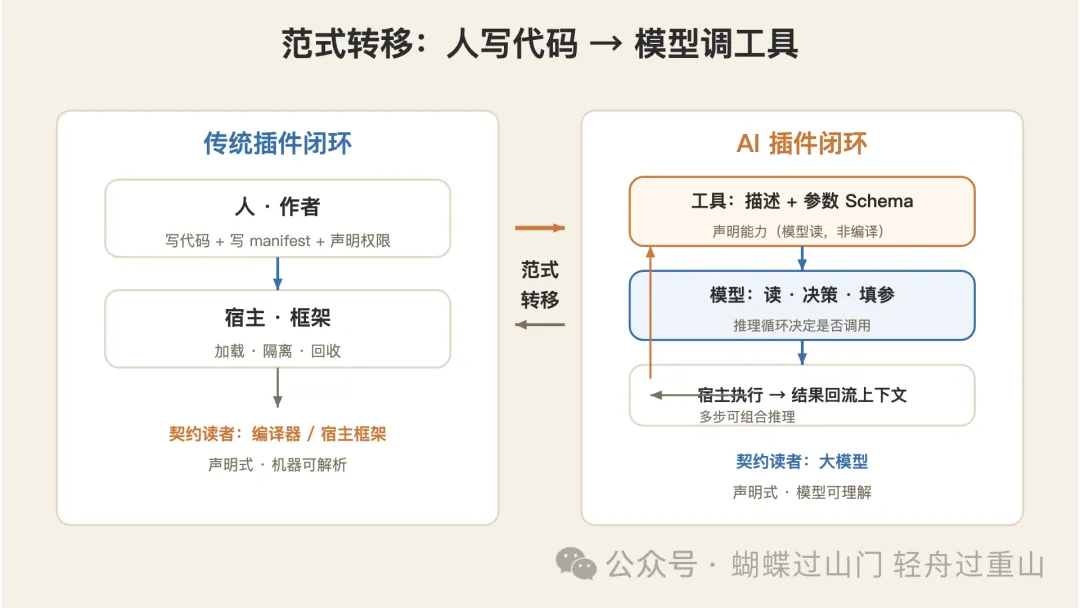
paradigm-shift.svg:左"人写代码·宿主加载"闭环 vs 右"模型读描述·做决策·收结果"闭环的对照。
- •
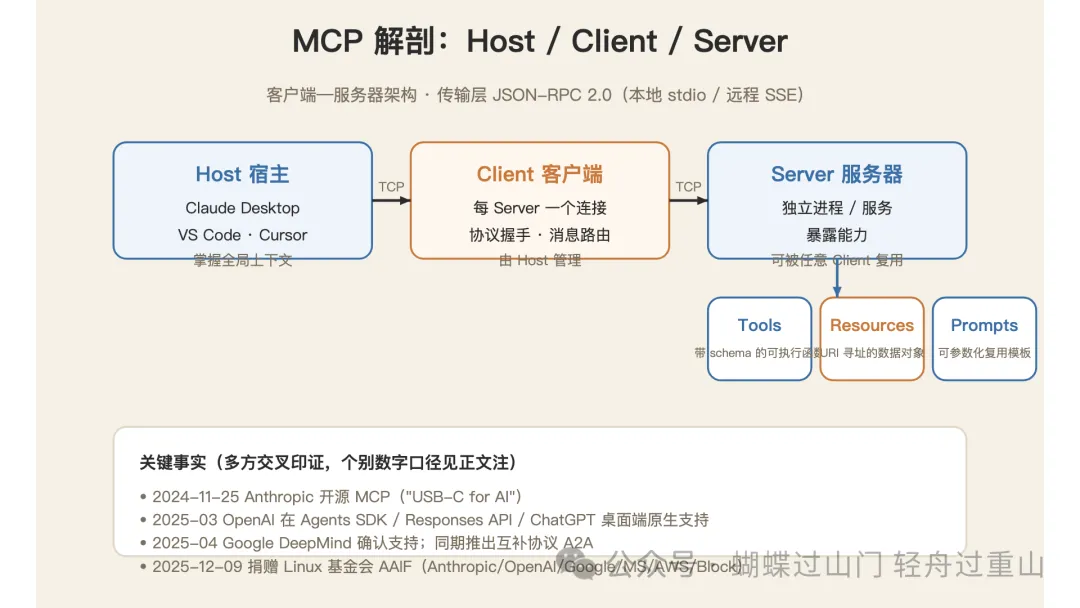
mcp-anatomy.svg:Host → Client → Server 三层 + JSON-RPC 传输,Server 暴露 Tools/Resources/Prompts。
- •
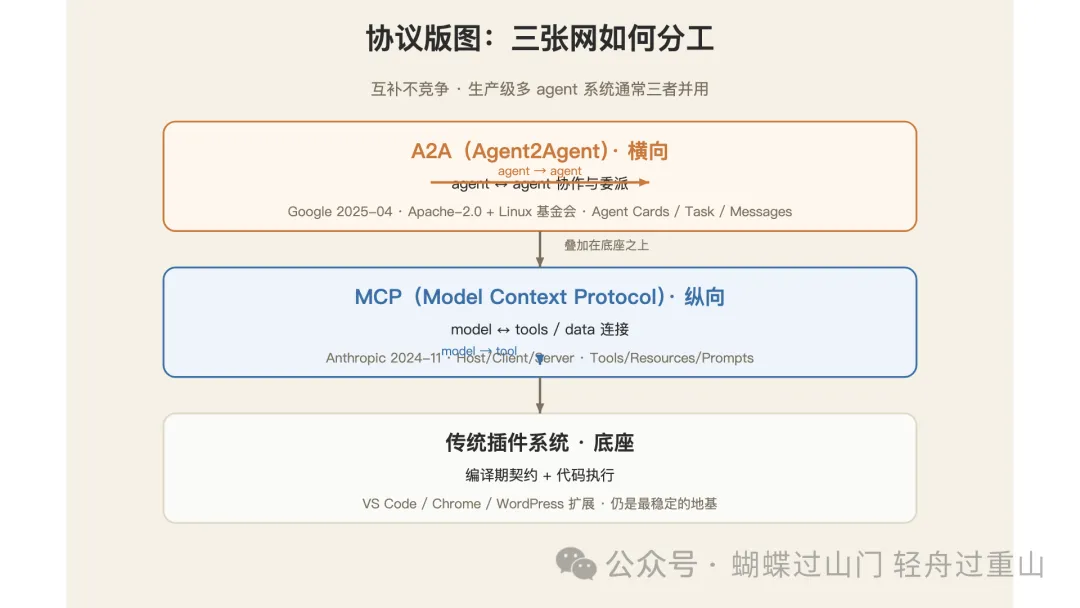
protocol-map.svg:三层架构——传统插件(底座)、MCP(纵向 model→tools)、A2A(横向 agent→agent)的位置关系。
- •
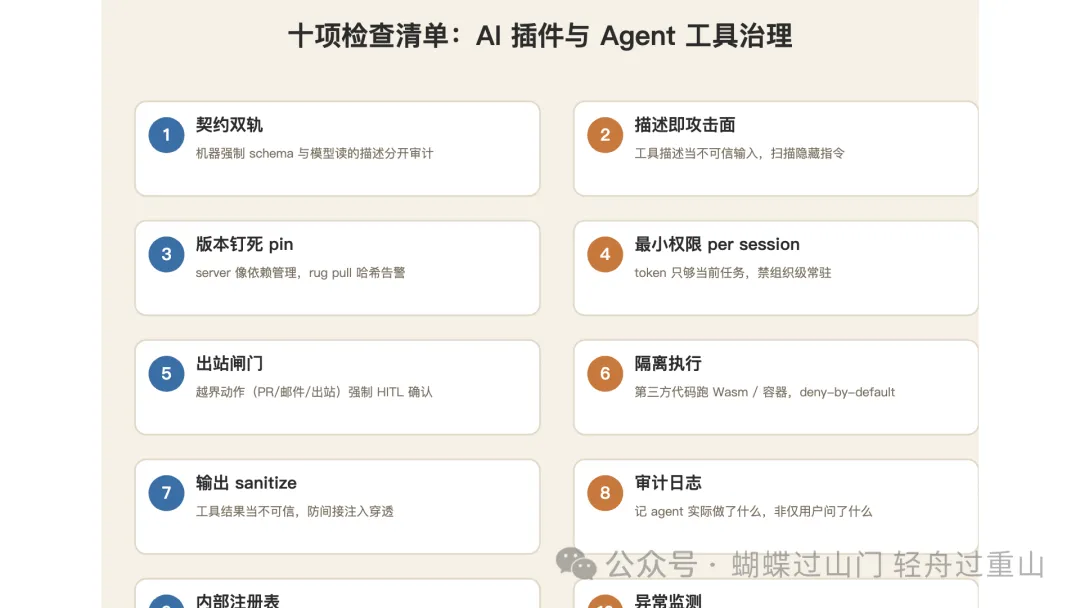
ai-plugin-checklist.svg:上文十项检查清单的卡片式可视化。