ARTICLE · 1278999
AI 写的测试用例没法用?问题出在你那 8 个字上
Prompt 技巧学了一堆,用例还是不能用?
同样八个字,有人拿到表
有人拿到一堆废话
6 个失效现场 · 九要素模板 · 可直接抄的 Prompt
AI 测试实战笔记
📦 3 Parts + Conclusion
👉 滑动
PART 01
失效现场
6 个坑逐个拆
PART 02
九要素改造
8 个字到能交付
PART 03
沉淀成资产
经验写进文件
PART ///
写在最后
一套表达系统
差距不在模型,在你交出去的信息量
同样八个字,有人拿到表格,有人拿到废话
先讲一个很常见的画面。午休前十分钟,你打开对话框,敲下八个字:帮我生成测试用例。
AI 回了你一千多字。标题工整,条目清晰,语气专业。你读完,长舒一口气——然后一条都提不进缺陷系统。
因为里面全是「验证登录功能是否正常」「检查异常情况是否有提示」这种话。它没错,它只是一句都不能用。
同一时间,隔壁工位的同事也只敲了几行字,拿回来的却是一张带编号、带步骤、带风险等级、还能看出覆盖了哪条测试规则的表格,改改项目名就能评审。
差别不在模型,甚至不在会不会写 Prompt。差别在于:你把「你脑子里的测试标准」一起交出去了吗?
01
PART
AI 不是不会测,是没人告诉它「什么样算测完了」
DIAGNOSIS · 先说结论
先把三句最高频的无效 Prompt 摆出来,看看它们长得像不像你:
帮我生成测试用例
帮我分析这个 Bug
帮我写测试报告
这三句话有个共同点:只有任务,没有标准。它们只说清楚了「我要什么产物」,完全没说「按什么标准判断这个产物合格」。
这中间隔着的,是一整套你在工作里攒了三五年、从没写下来过的东西:
系统是干什么的,核心链路是哪几条
哪些模块出问题会赔钱,哪些只是难看
团队踩过哪些坑,上线前必须再摸一遍
用例要写成什么样,才算能交付
这些东西,AI 一条都没有。更麻烦的是——它不会反问你。
一个新来的同事听到「测一下登录」,大概率会追问:是 Web 还是 App?验证码登录还是第三方?重点看功能还是安全?但 AI 不会。它拿到模糊指令后的默认动作是:直接编一个看起来很像那么回事的答案给你。
它不报错,不卡住,给你一份格式完美、语句通顺、但完全没有测试价值的东西。这才是 Prompt 失效最危险的地方——它伪装成了成功。
写测试 Prompt 的本质,是把测试脑一次性外包出去
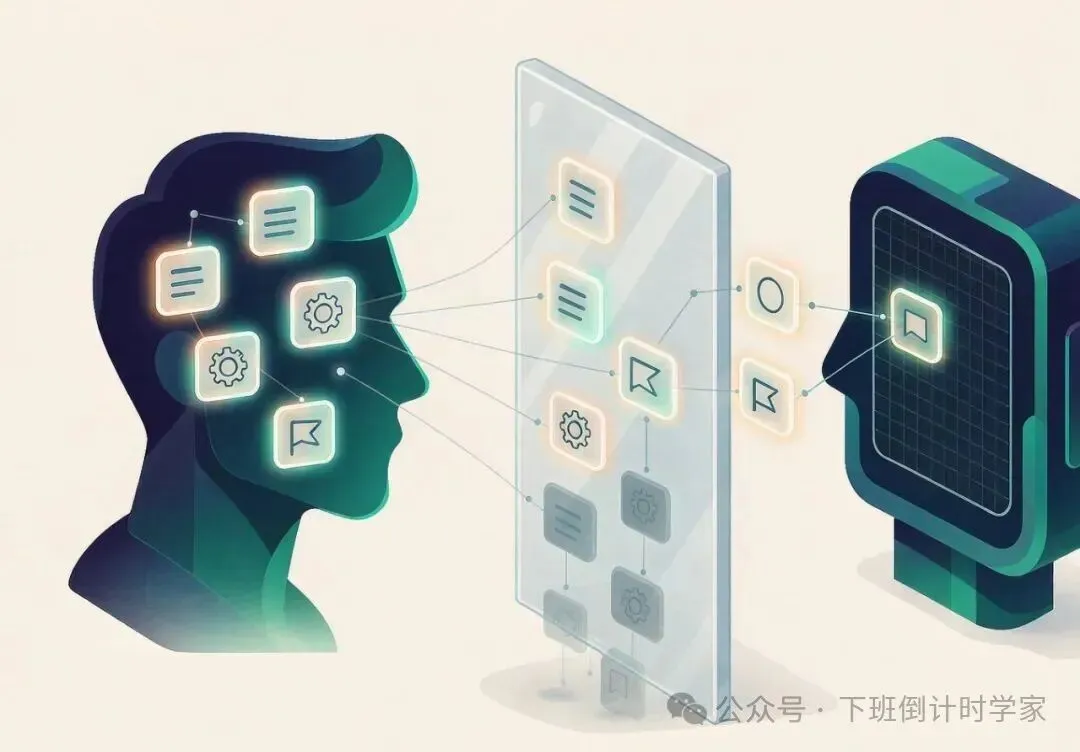
AI 与测试工程师之间的信息差:大部分经验没穿过去
02
PART
六个失效现场:从「说不清」到「记不住」
SIX GAPS · 照着改
下面六个坑,是测试场景下 Prompt 失效最集中的六个位置。每一个都按现场、盲区、改法、可抄的话四步拆开,你可以照着改自己手头的那条。
动手前建议先建一张对比记录表 outputs/prompt-compare.md,每改一类,就把「改前 Prompt、改后 Prompt、输出差异」记一行。一天之后回看,你会非常直观地看到差距。
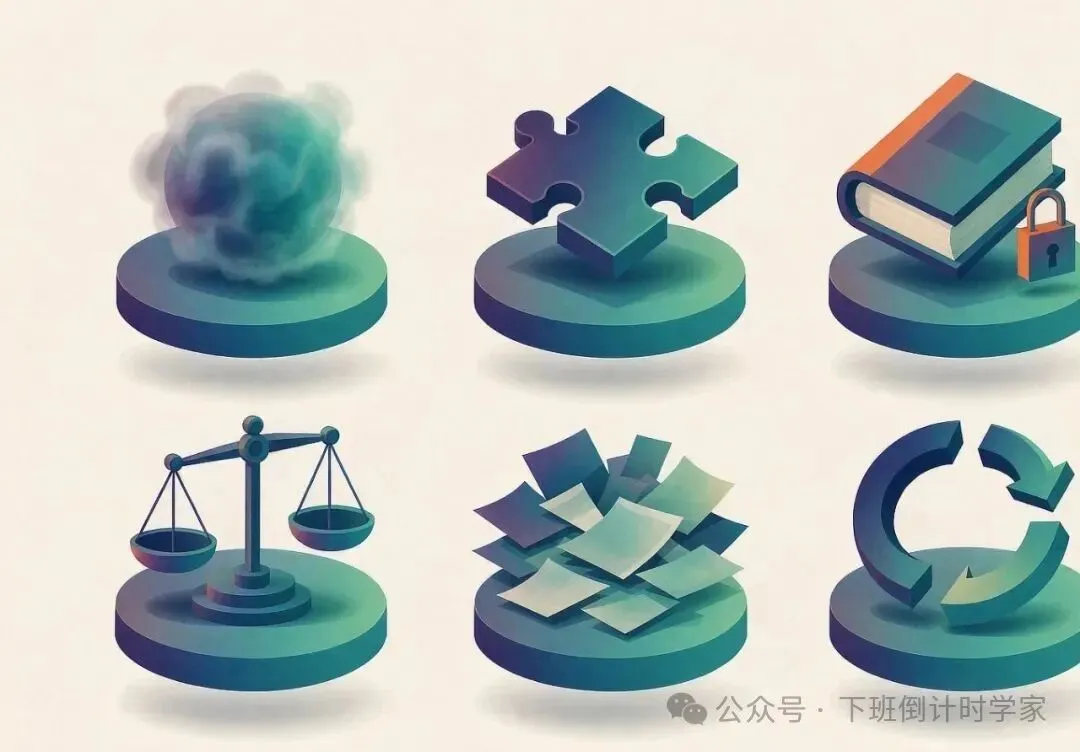
测试 Prompt 六大失效现场全景
指令模糊:你的「登录」和我的「登录」不是一回事
失效现场只有一句话:
帮我测试登录功能
AI 的盲区:Web 还是 App?账号密码、手机号验证码,还是第三方 OAuth?重点测功能、测兼容,还是测安全?在你眼里「登录」是一个明确的功能点,在 AI 眼里它是一道没有边界的开放题。没有边界的开放题,只能得到放之四海皆准的废话。
改法:把「动词 + 名词」升级成「谁 + 在哪 + 用什么方式 + 重点看什么」。四个格子填满,边界就出来了。
可以直接抄:
请针对【电商 App】的手机号验证码登录生成测试用例。
重点覆盖:Token 过期、异地登录、验证码频控、
多端登录、弱网、登录态失效。
没有上下文:AI 不知道你的系统长什么样
「帮我分析订单 Bug」——AI 的盲区是:这是 B2C 电商、外卖,还是金融?订单后面挂着的是库存、支付、优惠券、MQ 里的哪几串?这次迭代到底改了什么?
不知道系统长什么样,AI 只能按「通用订单」来分析,而通用订单恰好是你业务里最不重要的那部分。改法是固定三段式:业务背景、本次改动、要按什么维度切。
【业务】B2C 电商,订单关联库存、支付、优惠券
【现象】{粘贴 Bug 描述}
【本次改动】订单取消接口新增部分退款
请分析影响模块,并区分「库存 / 资金 / 券」三类风险
最后那句「区分三类风险」是关键。你不指定切分维度,AI 就按它自己舒服的方式切,而那个方式通常跟你的排查路径对不上。
没有测试规则:你脑子里的「必测清单」,AI 一条都没有
这是六条里最容易被忽略、也最值钱的一条。你之所以是资深测试,不是因为你比 AI 会写句子,而是因为你脑子里有一张清单:幂等、重复提交、事务回滚、库存一致性、券状态、MQ 重复消费——这些词你不用想就能列出来。AI 没有这张清单,而且它不会自己长出来。
改法:把清单写成文件,然后在 Prompt 里 @ 引用它。先写规则文件:
必测:幂等、重复提交、事务回滚、库存一致、
券状态、MQ 重复消费
存成 rules/支付测试规则.md,之后每次写 Prompt:
@rules/支付测试规则.md
需求:用户可用优惠券完成微信支付。
按规则库生成用例,每条标注覆盖了哪条规则。
注意最后半句——「每条标注覆盖了哪条规则」。这句话把 AI 从「生成者」变成了「执行者」,也让漏测在评审时一眼可见。
没有业务优先级:AI 把力气平均分了
不加约束的时候,AI 会把「支付金额算错了」和「按钮文案有点长」当成同等重要的问题来处理。于是你的用例里,一半是 P0 的资金安全,另一半是 P2 的展示细节。
改法:明确说清什么是 P0,以及什么要降级。
支付属于核心交易链路,请优先覆盖:
资金安全、订单一致性、库存一致性、幂等、事务回滚。
UI 类问题优先级 P2 及以下。
做完这一步,可以做个小实验:对比加与不加优先级约束时,输出里 P0 用例的数量变化。这个数字通常比任何说服都有力。
没有输出结构:你让 AI 自由发挥,它就给你散文
AI 的默认输出形态是散文。散文适合阅读,不适合执行。你要的是能直接进用例管理系统、能直接分派给执行人的结构。改法很简单:把表头直接写进 Prompt。
请严格按以下 Markdown 表格输出,不要大段散文:
| 编号 | 模块 | 场景 | 步骤 | 预期 | 风险等级 | 关联规则 |
Bug 分析场景可以换成这七个字段:
问题现象 / 可能原因 / 影响范围 / 推荐日志 /
推荐 SQL / 回归建议 / 风险等级
给字段这件事的成本几乎为零,但它决定了你拿到的是「一份需要重排版的草稿」,还是「一份可以直接评审的交付物」。
没有历史经验:你踩过的坑,AI 会再带你踩一遍
线上事故是团队最贵的资产,但大多数团队把它留在了两个地方:故障复盘文档的角落,和几个老同事的记忆里。两者 AI 都够不着。
改法:把事故写成资产文件,写的时候只要求三件事——现象、根因、回归要点。
- 库存超卖(2024-Q3)
- 重复支付(2024-Q4)
- MQ 重复消费(2025-Q1)
- 优惠券重复核销(2025-Q2)
存成 assets/历史Bug-订单.md,写 Prompt 时 @ 上,并要求输出标注关联了哪条历史项。这一步的意义不只是「让 AI 多测几条」,而是把个人经验变成团队可复用的资产——老同事休假了,清单还在。
03
PART
一次完整改造:从 8 个字到九要素
NINE ELEMENTS · 端到端示范
上面六条是分点练习,这一节把它们拼起来,做一次完整的端到端改造。改造对象是最经典的那句:
帮我生成订单测试用例
第一步:把九要素逐项填进模板文件
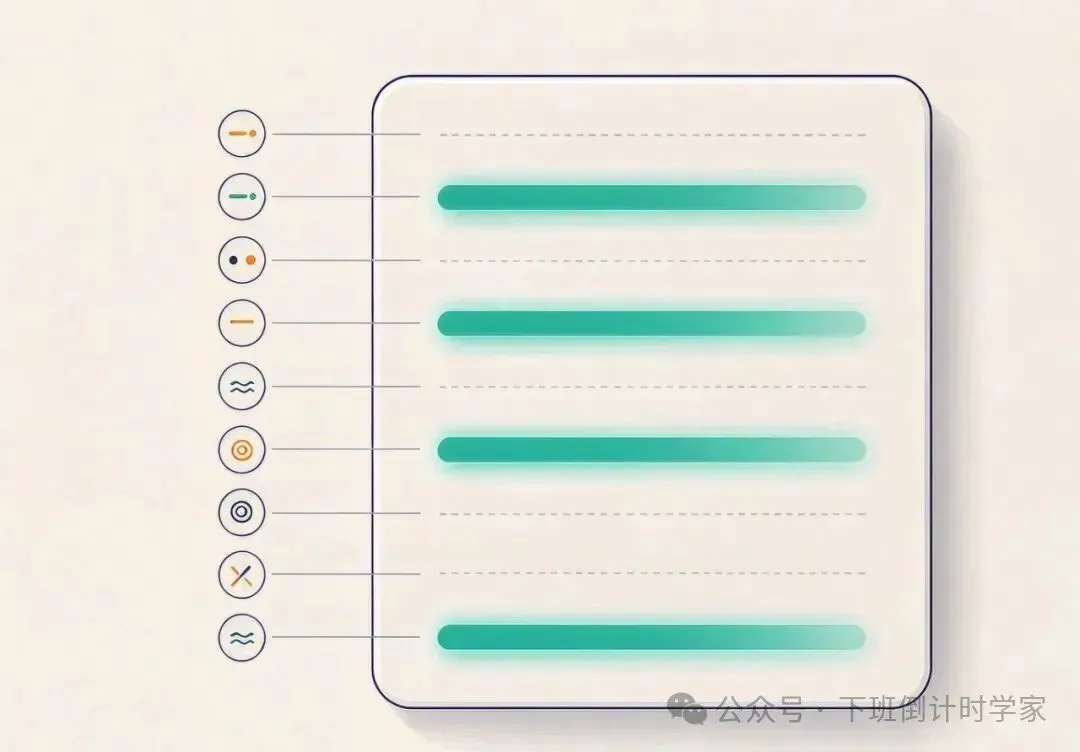
专业测试 Prompt 的九要素结构
第二步:组装成一条可以直接发出去的 Prompt
你是一名高级电商订单测试工程师。
【业务背景】B2C 电商,订单关联库存、支付、优惠券、MQ。
【测试目标】订单取消支持「部分退款」新逻辑。
【测试规则】@rules/订单测试规则.md
【历史经验】@assets/历史Bug-订单.md
【重点风险】状态机、库存回滚、退款金额、券返还、MQ 一致性
【输出结构】Markdown 表格:编号、模块、场景、步骤、预期、风险等级、关联规则
【限制】至少覆盖全部 P0 风险点;不要泛泛的 UI 描述
请生成测试用例,并附回归建议清单。
第三步:用四条标准验收
输出是结构化表格,不是大段散文;
出现了幂等、库存、事务、MQ 这类事故型用例,而不只有正向流程;
用例里引用了你写的规则或历史 Bug 条目;
每条都带 P0、P1、P2 风险等级。
四条全中,这次改造才算完成。任何一条没中,回去补对应的那一格。
04
PART
别只改一句话,把经验沉淀成文件
ASSETS · 可复用
单次改造能让一条 Prompt 变好,但下次你还是得从头想一遍。真正拉开差距的是把一次性的填空,变成可复用的资产。
建议建一个专门的练习目录,结构可以直接照抄:
prompt-lab/
├── templates/ # Prompt 模板(九要素填空版)
├── rules/ # 测试规则库
├── assets/ # 历史 Bug、业务优先级
├── outputs/ # 练习产出、对比记录
└── README.md # 说明本仓库用途
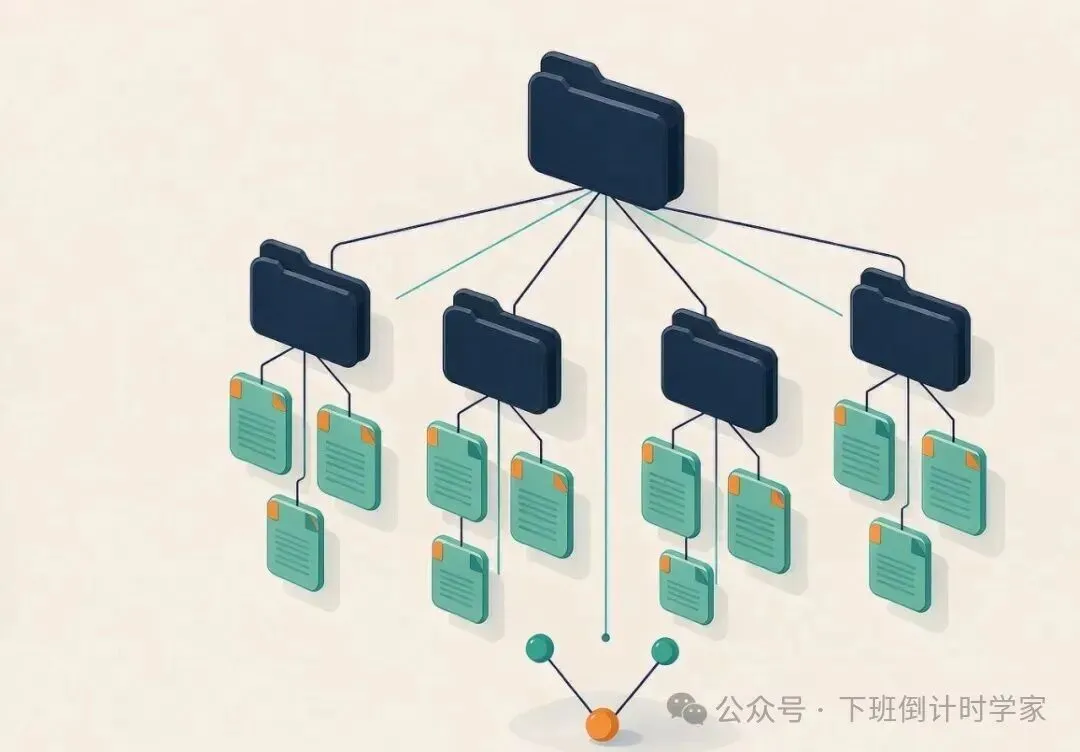
把一次性的 Prompt 填空,沉淀成团队的资产树
四类文件,每类只需要写这么多就够了:
这个目录可以整包提交 Git。三个月后你再回头看,会发现它比任何一篇 Prompt 技巧文章都值钱——因为它记的是你们团队的判断,不是通用套路。
05
PART
发出去之前,勾一遍这 6 项
CHECKLIST · 速查清单
最后给一张速查清单。贴在显示器边上,或者存进备忘录,每次发 Prompt 前扫一遍,全勾再回车:
☐ 角色 + 业务背景写清楚了吗
☐ 测试目标具体吗(不是「帮我测一下」)
☐ @ 引用了规则库 / 历史 Bug 资产吗
☐ 写明了业务优先级吗(P0 是资金还是一致性)
☐ 规定了输出格式吗(表格还是固定小节)
☐ 要求标注「覆盖了哪条规则 / 历史项」了吗
✦ 一个容易被忽略的细节
六条里最容易被跳过的通常是第三条和第六条——而这两条恰恰是决定输出「像 AI 写的」还是「像资深测试写的」的分界线。
///
LAST
写在最后
SUMMARY · 一套表达系统
回到开头那八个字。大多数测试 Prompt 没用,不是因为话太少,而是因为该交代的六件事,一件都没交代:
指令模糊 + 缺上下文 + 无规则
+ 无业务约束 + 无输出结构 + 无历史经验
反过来看,专业 Prompt 的本质也就清楚了——把测试经验翻译成 AI 能理解的语言。它不是一句话,不是一句咒语,而是一套表达系统:你有角色定位、有业务背景、有规则库、有优先级、有输出规范、有历史教训。
这六样东西你本来就有,只是以前只存在于你的脑子里。现在要做的,只是把它们写下来。
写下来,AI 才接得住。
我是下班倒计时学家,热衷于分享 AI 时代的测试实战干货。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING