ARTICLE · 1281409
LibChecker:免 root 的安卓成分分析工具
先说个很常见的场景。
你手机上有款 App 更新了,安装包从 80MB 涨到 110MB,应用商店只写了「修复已知问题」。你怀疑它塞了什么新的广告 SDK,但又没法验证——总不能在手机上装个抓包工具盯三天。
这个问题其实有解,而且比想象中简单。Android 的安装包就是一个 ZIP,里面的东西是明码标价的:哪些原生库、哪些组件、哪些权限、用了哪家推送、哪家统计、哪家支付。你不 root 也能看,因为系统本来就把这些信息摊开在 PackageManager 里。
难的地方不在于「能不能读到」,在于「读到了之后,你怎么知道那个 libapp.so 到底是什么」。
这篇要讲的 LibChecker 就是干这个的。一个 Kotlin 写的 Android 应用,Apache-2.0 授权,支持从 Android 7 一路到 17。它做的事用一句话说完:把任意一个 App 的成分摊开,并告诉你每一味成分是靠什么证据认出来的。
一、一份成分表,到底写着什么
打开它,第一屏是你手机上所有 App 的列表,每一项后面挂着几个小标签。那些标签就是它认出来的 SDK。
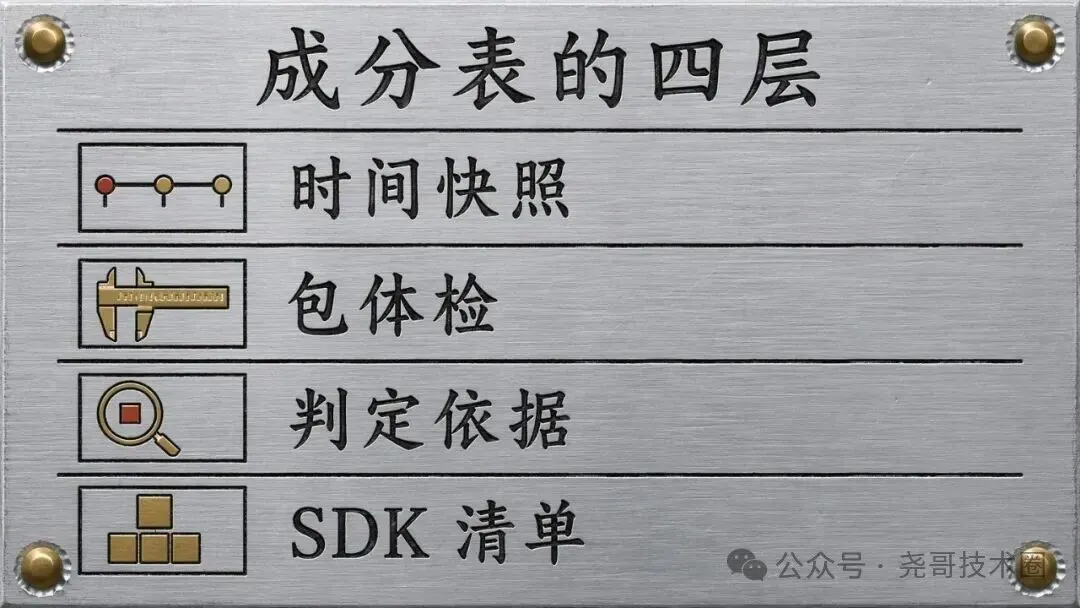
点进任意一个 App,你看到的是分层的信息。
第一层是「这个 App 用了什么」。 第三方 SDK 的清单,按类别分:推送、统计、崩溃上报、广告、支付、地图、登录、分享、音视频、热更新、加固。每一类下面是具体的库名和它所属的厂商。
第二层是「凭什么这么认」。 这是它跟「列个文件名」的工具最大的区别。点开任何一个 SDK,你能看到判定依据:是因为包里有一个叫 libflutter.so 的原生库,还是因为 DEX 里出现了 io.flutter.FlutterInjector 这个类,还是因为清单里声明了某个专属权限,或者某个组件的 intent action。
第三层是这个包本身的体检数据。 分架构列出的原生库清单(arm64-v8a 有哪些、armeabi-v7a 有哪些)、每个 .so 的位数、是不是多架构包、有没有 16KB 页对齐、符号表是不是被剥掉了。签名用了哪几版方案。清单里声明的组件、权限、元数据。包体积怎么分的——DEX 占多少、资源占多少、原生库占多少。
第四层是时间。 它可以给当前状态拍一份快照,过几天再拍一份,然后告诉你这两天里哪个 App 多了个库、少了权限、体积涨了多少。
第三层里有个东西容易被忽略:权限。
大多数人看权限只看「有没有要通讯录」,但权限其实是反推 SDK 的一条硬线索。一个 App 突然要「读取已安装应用列表」,十有八九是接了归因或者风控;出现 com.xxx.push.permission.MESSAGE 这种带厂商前缀的自定义权限,那家推送必然在里面;出现精确闹钟相关的权限,多半有定时任务或者推送保活。
这类证据比文件名可靠,因为权限是清单里声明的、系统在装包时校验过的、写进 PackageInfo 的。它不像 .so 那样能被改名,也不像类名那样能被混淆。
所以它的匹配面里,「权限」和「元数据」是两把好用的钥匙——尤其对那些不带原生库、类名又被混淆过的国内 SDK。
这套东西的技术栈没什么花巧:Kotlin、XML 布局配 ViewBinding、Koin 做依赖注入、Room 存本地数据,没有用 Compose。规则库放在一个单独的仓库里维护,客户端只负责读。
有意思的是它跟规则库的分工。客户端不知道「什么是 Flutter」,它只知道「怎么去包里找证据」;规则库不知道「怎么解 ZIP」,它只知道「Flutter 的证据是这几条」。中间用一个 SQLite 表接上。
这个分工决定了后面几节要讲的所有难题。
二、认错一个库,比不认更糟
现在回到那个 libapp.so。
Flutter 编译出来的 AOT 产物默认就叫这个名字。所以你在一个 App 的 lib/arm64-v8a/ 目录里看到 libapp.so,第一反应是「这是 Flutter」。
问题是,这个推断在两种情况下都会翻车。
一种是别人的产物也叫这个名字。libapp.so、libmain.so 这种名字太泛了——「app」、「main」,谁都能用。libmain.so 尤其典型:几乎所有的 C/C++ 程序入口都叫 main,编译成动态库时产物常被顺手命名为 libmain.so。Unity 是它的使用者之一,但绝不是唯一。
另一种是真的 Flutter 却不叫这个名字。产物名是可以在构建脚本里改的,改了之后只按文件名匹配就会漏。
LibChecker 的处理方式藏在 RulesRepository.kt 里。它把四个名字单独拎出来,列进一个「需要二次验证」的集合:
这四个(组)名字的共同点,是都可能被别人用,或者都可能被改成别的样子。所以规则命中之后不算完,还要回去找配对证据。
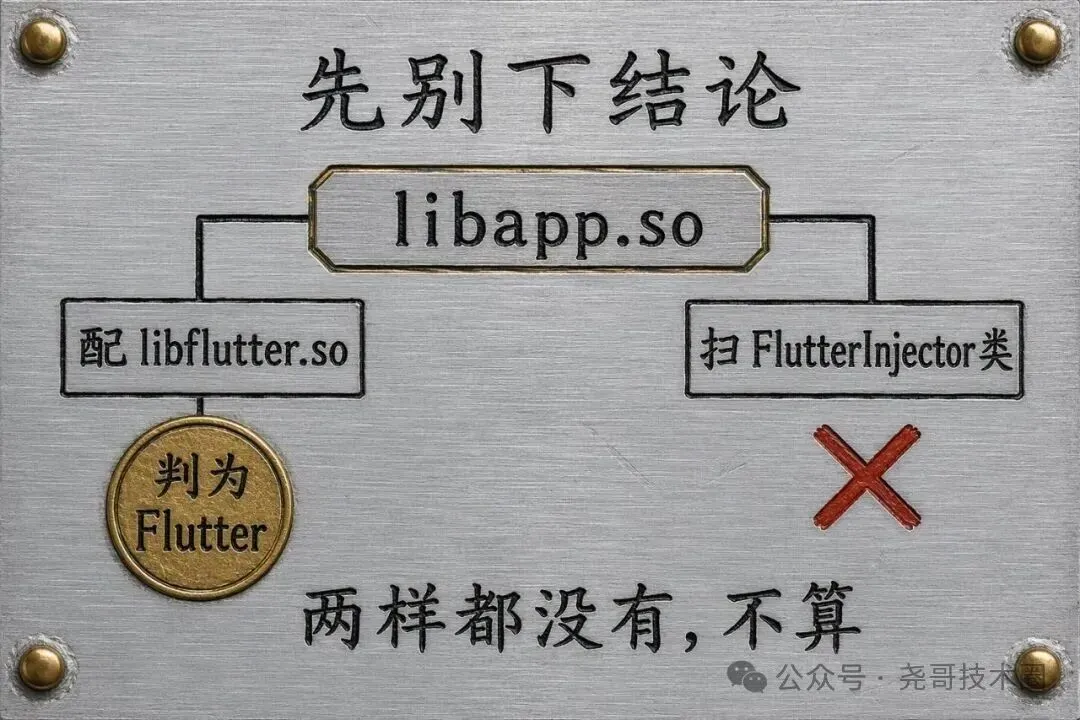
Flutter 的配对证据是两样之一。 要么包里同时有 libflutter.so(引擎本体),要么 DEX 里能扫到 io.flutter.FlutterInjector 这个类。前者覆盖常规情况,后者给「引擎以别的方式进包」兜底。两样都没有,这条规则就作废。
Unity 的配对证据只有一个:libunity.so。 没有它,单独一个 libmain.so 一律判定为假。这一条比 Flutter 更严格——因为 libmain.so 这个名字被误用的概率高得多。
360 加固的证据在类名里。 见到 libjiagu*.so 之后,还要去 DEX 里找 com.qihoo.util.* 或 com.tianyu.util.*。找不到就说明这个包可能只是留了个壳,或者用了别家的加固却抄了这个文件名。
梆梆加固的证据同理,对应的是 com.secneo.apkwrapper.*。
代码里的取舍很明确:验证不过,就把这条规则的结果置空。
一行 takeIf,把「宁可漏报,不可误报」写死了。
这个取向值得多说一句。做识别类工具的人都知道,误报和漏报是一对反向指标,你不可能同时把两个都做到零。多数工具会选「宁可多报」——反正多列一个库不痛不痒,少列一个才叫 bug。
LibChecker 反过来了。原因很简单:这个工具的输出是被当证据用的。 你拿着它去找产品经理说「这个版本多了个广告 SDK」,如果它认错了,你说的话就是错的,一次就够毁掉信任。漏报顶多是「这次没看出来」,误报是「你在胡说」。
顺便说,验证的代价不便宜。去 DEX 里扫类名意味着要解压 classes.dex、读字符串池、逐个比对前缀——一个几十兆的包,这一趟能跑好几秒。所以这段验证被限定成「只在命中这四个名字时触发」,一次最多查一组,而且整段跑在 IO 线程上。
这里还有个技术选择值得说:为什么是去 DEX 里扫类名,而不是查清单?
因为类名根本不在清单里。AndroidManifest.xml 里出现的是 Activity、Service、Receiver、Provider 这四类组件的完整类名,以及权限和元数据。com.qihoo.util.* 这种加固框架的内部类,io.flutter.FlutterInjector 这种运行时类,一个都不会出现在清单里。它们只在 DEX 的类定义表里。
要拿到它们,就得读 DEX 的头部,从 string_ids 段把类名字符串一张张读出来。而这个项目里专门写了一个流式扫描器干这件事:它不构造任何类对象,只按给定的前缀模式一路过滤下去,命中就返回。
为什么不直接用现成的 DEX 解析库把所有类都加载出来?因为内存。一个装了十几个 SDK 的 App,DEX 里的类动辄几万个,全建出来是几十兆的堆占用——在手机上这不是「慢一点」,是「可能被系统杀掉」。
流式扫描的代价是只能做前缀匹配,不能做复杂查询。但对「这个包里有不有某个前缀的类」这个问题,前缀匹配正好够。
三、十个匹配面,一条优先级链
要认几千个 SDK,光靠原生库名字不够。
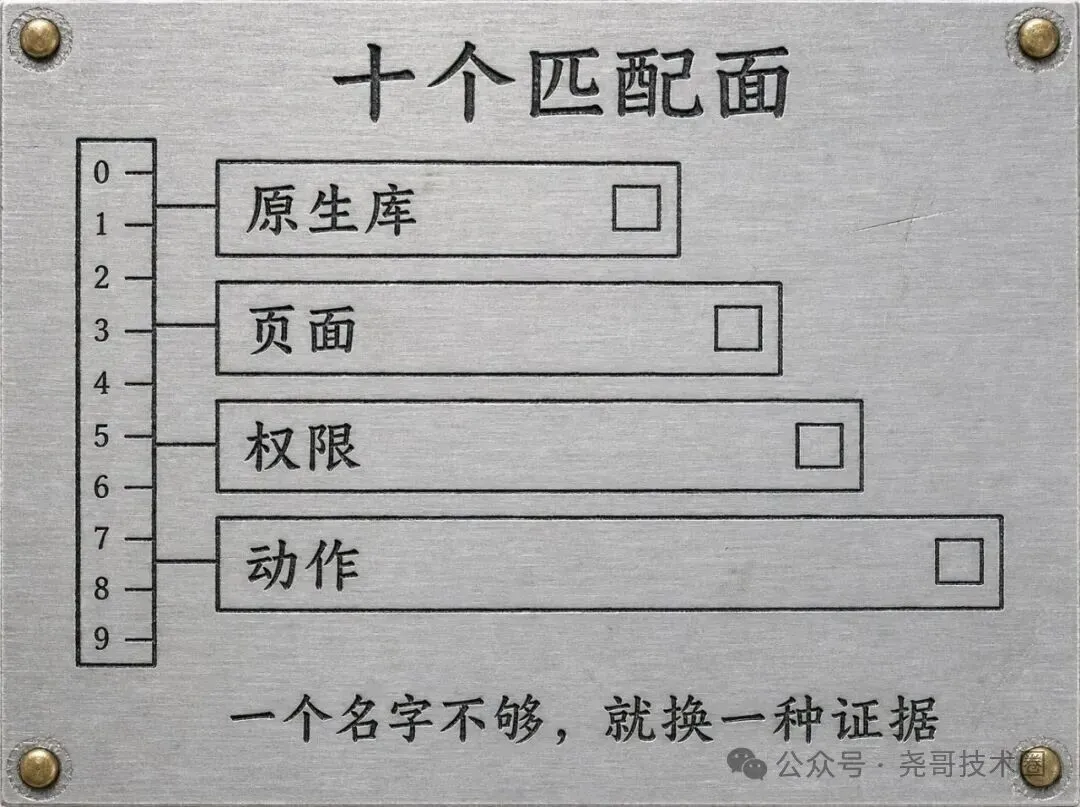
有的 SDK 压根不带原生库——纯 Java 实现,包里只有一个 .so 都没有。有的只留下一个 Activity(各种「一键登录」都是这个形态)。有的只留一个权限(推送、地图、定位)。有的只在清单的 <meta-data> 里写一个渠道号或 appid。有的只留一个 intent action(分享回调、支付回调)。还有一整类,靠的是「这个包跟另一个包用同一个 shared UID 或同一个签名」——同一家厂商的 App 集群都长这样。
所以规则表里的「匹配面」有十种。仓库文档里给了一张表,编号 0 到 9:
libflutter.so | ||
.so 的静态库 | ||
com.xxx.push.permission.MESSAGE | ||
每条规则的形状是固定的:名字、类型、匹配模式(精确或正则)、优先级、显示名、图标、有没有详情页。
匹配的顺序也定死了。先把整张表的精确匹配试一遍——包括那些正则规则的字面量字符串(这是历史兼容行为,不能改)。没中,再按「优先级、编号」的顺序跑正则,第一个整串匹配上的赢。
这里有两个细节值得留意。
第一,不做大小写折叠,也不做 Unicode 归一化。LibFlutter.so 和 libflutter.so 是两个不同的东西,全角和半角也不等价。听起来很严格,但这是为了三端一致——下一节就讲为什么。
第二,优先级数字小的先跑。 这意味着一家厂商的通用规则可以排在前面、具体规则排在后面,也意味着规则作者要为一个数值负责。规则仓库把这件事写进了契约文档,包括「已发布的版本不可覆盖,回滚要用更高版本号重建旧内容」这种发布纪律。
「精确优先」这条顺序里还埋着一个历史包袱。那些用正则写的规则,它们自己的字面量也会先被当成精确值去比一遍。这是老版本的行为,契约里明确写着要保留。
为什么要保留这种看起来多余的行为?因为顺序会影响结果。假设有两条规则:一条正则 com.example.*,一条精确 com.example.crash。如果只跑正则、按优先级取第一个中的,那 com.example.crash 这个名字可能被前面那条宽泛的正则先抓走,报出一个错的名字。先让所有精确值过一遍,就是为了不让宽规则抢走本该属于窄规则的匹配。
第三,同一个名字不能在同一个匹配面下挂两条规则。 规则编译时会拒绝重复的「类型 + 名字」组合。
这一条比看上去重要。规则库是几百人陆陆续续贡献的,同一个 SDK 被两个人各写一条,是必然会发生的事。如果允许重复,运行时就变成「谁优先级高谁赢」,结果取决于你手里那份规则库的版本——同一台手机,同一个 App,昨天报 A 家,今天更新完规则报 B 家。这种不确定性对「当证据用」的工具是致命的。
所以他们在数据层的入口就把这件事掐死了:宁可在编译时报错,也不让运行时去猜。
现在这张表里,原生库是条目最多的一类,往后依次是 Activity、Service、Provider、Receiver、Intent action。静态库只有一条。
那个「一」不是笔误,我留到第九节讲——它恰好说明这个工具能力的边界在哪。
四、同一套正则,要在三处跑出同一个答案
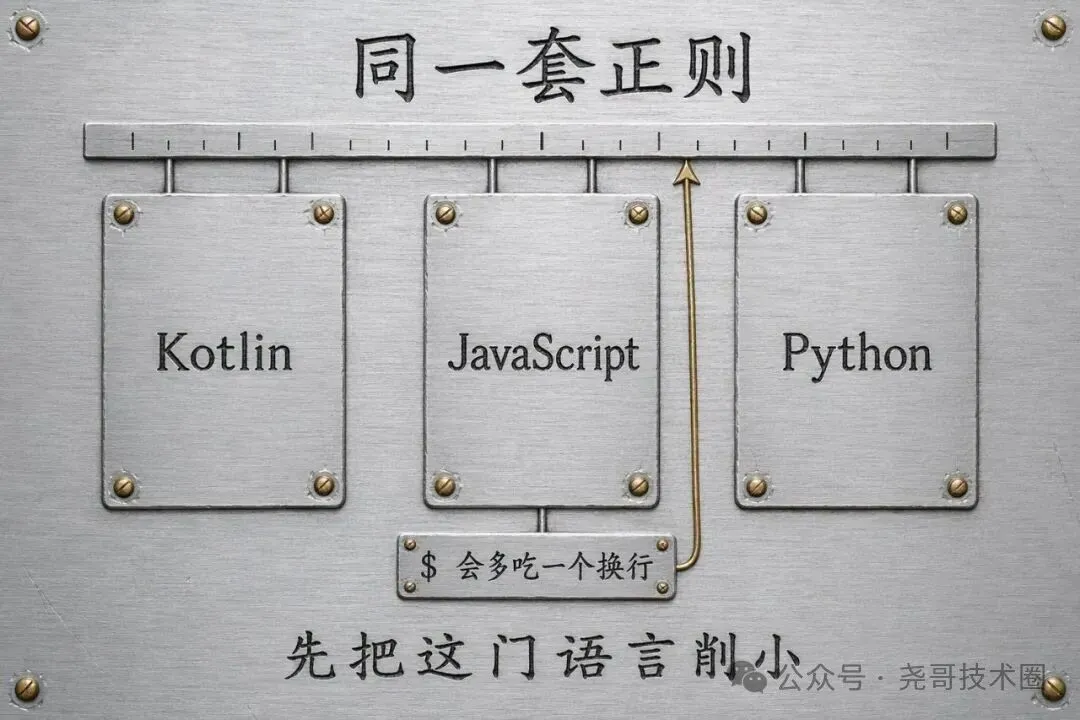
这套规则有三个消费方:Android 客户端用 Kotlin,浏览器 WebUI 用 JavaScript,规则仓库的编译与检查工具用 Python。
同一套规则,要在这三处给出同一个答案。
听起来是「写个正则还不简单」,实际上这里有个经典的坑。三种语言判断「整串匹配」的方式根本不一样:
Python 有 re.fullmatch,天生就是整串匹配。Java 的 Pattern.matcher(name).matches()也是整串匹配。JavaScript 没有 fullmatch。只能自己拼 ^(?:pattern)$,而 JS 里的$会容忍结尾的一个换行。
最后这一条是真会出事的:"libflutter.so\n" 在 JS 里会匹配成功,在 Java 里会失败。于是文档里写明了补偿办法——JS 那边除了跑正则,还要额外校验「匹配到的字符串长度等于输入长度」。
但这个补丁只解决了 $ 一个问题。还有一堆别的差异:\d 在 Python 默认匹配 Unicode 数字,Java 只匹配 ASCII;点号在不同的方言里对换行符的处理各不相同;\w 在三种语言里的取值范围三个样。
LibChecker 的解法不是打补丁,是把语言削小。
规则里能用的正则,被限制成这么一个子集:字面量、转义标点、点号、ASCII 字符范围、取反字符类、捕获与非捕获组、或、? * + {m,n}、^ 和 $。
就这些。禁止环视、禁止反向引用、禁止 flags、禁止 Unicode 属性、禁止占有量词、禁止非 BMP 字面量。
然后给每个可能歧义的地方钉死语义:\d 只算 ASCII 数字(Python 那边编译时加 re.ASCII);点号在所有运行时都必须排除五种字符——LF、CR、U+0085、U+2028、U+2029。
剩下的一致性靠测试保证。仓库里带了一套共享的匹配样本,覆盖或、转义、Unicode 字面量、精确匹配的优先级、以及排序。三端跑同一套样本,答案必须一样。
我觉得这是整个项目最像「工程」的一段。多数人遇到跨语言行为差异,做法是写个注释说「注意这里 X 语言行为不同」,然后等下一个踩坑的人。他们做的是先定义一门只保留交集的小语言,再让三端都实现它。
代价是规则作者不能用环视、不能反向引用。写复杂匹配会别扭。但规则库的匹配对象本来就是「文件名」「类名」「权限名」这种结构简单的字符串,用不上花活。
五、远程下发的规则,只能填表不能动手
到这里出现一个新问题。
客户端要能认几千个 SDK,规则必须能更新——总不能让用户每出一个新 SDK 就重新下载安装包。所以规则从服务器下发。
那问题就来了:服务器下发的东西,在客户端有多大的权限?
这是个真问题。历史上太多工具在这栽过:规则文件里塞一段脚本,客户端 eval 一下,方便是真方便,出了事就是远程代码执行。
LibChecker 的答案是一条清晰的分界:规则是数据,不是程序。
最典型的是「SDK 详情」那套机制。有些 SDK 你想知道的不只是「有没有」,还想知道它的 appid、版本号、渠道号——这些信息藏在包里某个特定文件的某几个字节里。让规则能「读那个文件、按这个规则抓」,是最省事的做法。
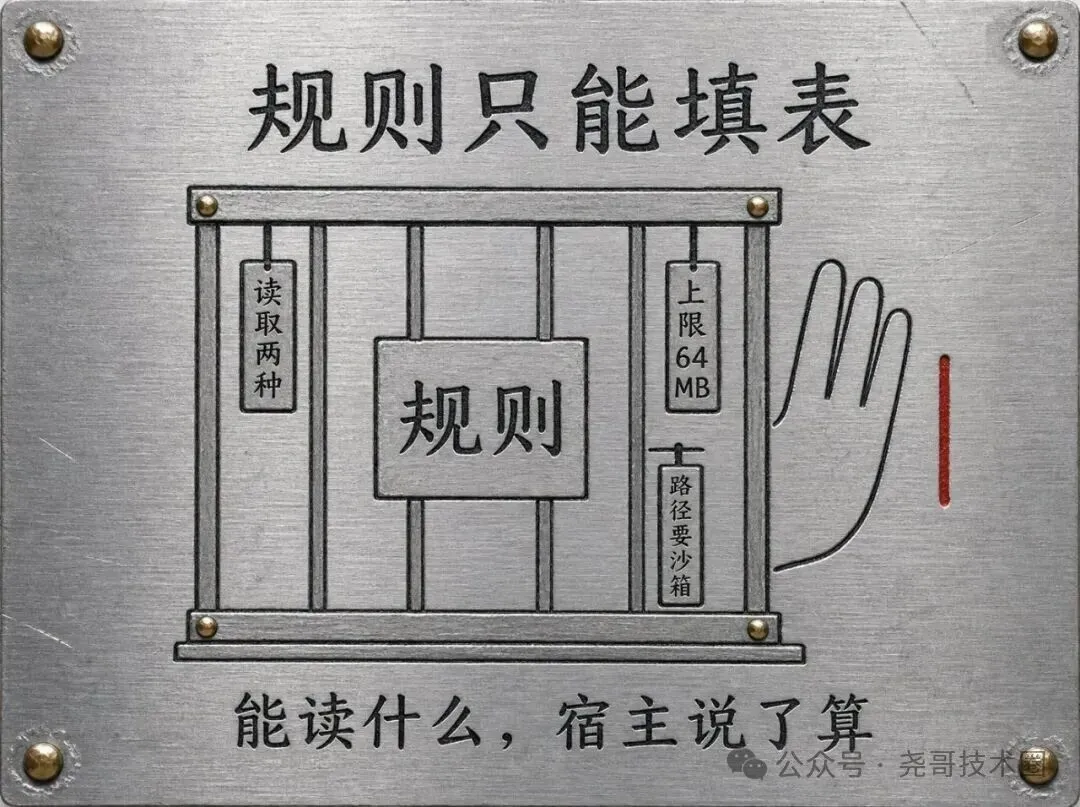
他们把这套能力关进了一个白名单笼子,笼子的每根栏杆都可数:
来源只有一种算子。 规则唯一能指定的是 package_file——从当前分析的那个包里取文件。不能指定系统路径,不能读别的 App 的数据。
读取算子只有两种。ascii_strings(把文件当 ASCII 字符串流读出来)和 file_sha256(算整个文件的哈希)。没有「执行」,没有「解析」,没有「按偏移读任意字节」。
抓取类型只有五种。sha1、semver、semver_channel、prefixed_semver、sha256。你想抓版本号?只能用这五种里挑一种,不能自己写解析逻辑。
额度硬顶。 单文件上限 64MB,总上限 128MB;一次分析最多 8 条探测;每条探测最多 16 个包内路径;每条探测最多 8 个抓取;每个抓取最多返回 16 个结果。
路径要过沙箱。 必须落在 sdk-details/ 前缀下,不许绝对路径,不许 ..。文件名不能带斜杠和反斜杠。
连输出字段名都要过正则。 必须是 ^[a-z0-9][a-z0-9_-]{0,63}$——防止拿一个奇怪的名字往别处注。
这套校验不是「加载时顺手检一下」,是一份独立的两百来行校验器,每一个 return false 都对应一种被拒的可能。校验不通过的定义文件直接不加载。
还有一种能力叫「查表」,也关在同一个笼子里。
有些 SDK 从包里抓出来的只是一个 id——一串数字或者一串哈希。要把这个 id 变成人话(比如「这是某某广告位的编号」),得去服务器查。
这套机制同样受限制:查询的输入必须是前面某一步抓到的输出(不能凭空造一个值去查);路径模板里最多一个占位符,且不能和索引路径同时使用;一次分析最多 8 个查询,每个查询最多 4 次请求、最多取 50 条、最多映射 16 个输出字段。
最关键的一条在这儿:要查的那个值来自你手机上的包,它是用户数据。
所以项目约定里那句「本地采集的指纹永远不要放进请求 URL 或日志」,说的就是这条链路。查表可以,但查的时候得想清楚什么东西出了设备、什么东西留在本地。他们选择把索引下下来、把值在本地匹配,而不是把值传上去。
这是一个在「功能好用」和「用户安全」之间反复妥协的地方,也是这类工具最难守住的地方——你今天为了查一个 appid 把值传上去,明天就能为了查一个版本号把整个清单传上去,后天这个口子就关不上了。
图表规则更直白。 图表页那些「多少个 App 支持 16KB 页」「多少 App 用了某个推送」的统计,也是声明式规则驱动的。规则仓库的贡献指南第一段就把话说死了:规则不能执行脚本或任意代码;遍历 APK、DEX、manifest 和原生文件的能力始终在宿主手里;规则只能使用宿主已经实现的证据和算子。
连图标都管。 每个库的图标是 SVG,从服务器下来。SVG 是能带脚本和外部引用的,所以他们给 SVG 也定了白名单:只放行 svg、g、path、defs、clipPath、linearGradient、radialGradient、stop 七种元素,只允许本地的 url(#id) 引用。禁脚本、禁事件、禁样式表、禁外部 URL、禁 href、禁实体、禁 DTD、禁递归引用。单文件 256KiB 上限,4096 个元素上限,嵌套深度 32 层上限。
还有一条我特别在意,写在给 AI 编码助手的项目约定里:按稳定路径拉指纹索引,在本地匹配;本地采集的指纹,永远不要放进请求 URL 或日志。
这句话解决的是一个很容易被忽略的隐私漏洞。指纹是「这个 App 的特征」,本地算出来之后如果拼进 URL 去服务器查名字,等于把你手机上装了什么告诉了服务器。他们的做法是:索引下到本地,匹配在本地做,一个字节都不出去。
规则库坏了也不会连累你。 启动时的逻辑是这样的:先拿内置的基线版本;再把下载过的包按数据版本从高到低排;逐个试——先验证包完整,验证不过就修复重装,还不过就跳过;激活失败的同样跳过,用前一个;全部失败就用内置。整个恢复流程有个 2 秒的节流,防止数据库损坏时连环重建。
这套设计的重心不在「能不能更新」,在「更新失败的时候,用户不该感觉到」。
六、不下载整个包,也能看成分
前面讲的都是「包已经在手机上」的情况。但很多时候包不在——你想看的是应用商店里那个还没装的、或者一个几百兆的游戏。
这就需要一个不下载整个文件也能看成分的办法。
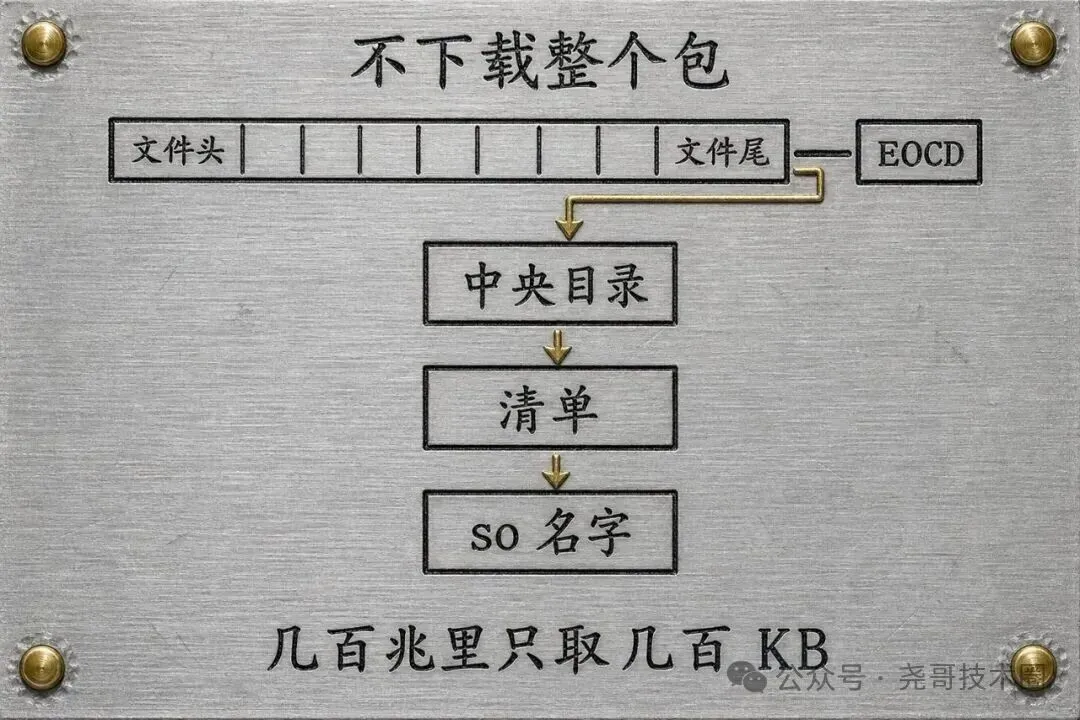
ZIP 的结构天生支持这件事。文件尾部有一段叫 EOCD(End of Central Directory)的记录,里面写着中央目录的偏移和大小;中央目录里,每个条目都有自己的名字、压缩方式、压缩后大小和本地头偏移。
所以只要三步:取尾部、读目录、按需取条目。
LibChecker 的实现比这三步严谨一些,因为它要对付真实世界里的畸形包。
第一步是探路。 先发一个请求拿 Content-Length,同时看服务器认不认 Range。不认就退回全量下载——这不是失败路径,是正常分支。
第二步是找 EOCD。 从尾部一段字节里从后往前扫签名,而且不能见到签名就算数:还要读签名后面那个「注释长度」字段,验证「签名位置 + 固定长度 + 注释长度」正好等于文件末尾。不校验这一步,一个恰好包含这段字节的注释就能把你骗到错误偏移上。
第三步是处理 ZIP64。 如果 EOCD 里的条目数、目录大小或目录偏移撞到了 32 位的上限值,说明这是个 ZIP64 包——大游戏基本都是。这时候要再往前读 20 字节的 locator,从里面拿到 ZIP64 EOCD 的绝对偏移,再跳过去读那个记录。偏移是绝对的,而手上的缓冲区是相对的,中间要做一次换算。
第四步才是真取东西。 按中央目录算出来的偏移,只把 AndroidManifest.xml 那一条的数据拉回来,用 Inflater 解开,交给清单解析器。
这四步里,最费事的其实是「为什么不能用现成的 ZIP 库」。
Java 生态里的 ZIP 实现基本都假设「文件就在本地」。它们要么一次性把整个文件读进内存建索引,要么要求你给一个可以随机访问的 File。而这里的场景是:文件在几百公里外的服务器上,你能做的只有「给我第 X 字节到第 Y 字节」。
所以中央目录得自己解析。这也是为什么项目里有一个专门读 ZIP 数据偏移的组件:它先自己扫 EOCD、自己算中央目录位置、自己按条目名找偏移;只有在自研路径失败时才退回 Apache 的实现兜底。
代价是要自己处理一堆边角:ZIP64 的 locator、注释长度校验、目录条目被截断、压缩方式不是 DEFLATE 的条目。这些在正常包里一辈子遇不上,在畸形的包里全都会遇上。
至于原生库,连数据都不用取。中央目录里每个条目的名字就在目录里,扫一遍名字就知道有哪些 ABI 目录、每个目录下有哪些 .so。一个 3GB 的游戏,这一步是几百 KB 的流量。
这套东西不只是给「分享链接」用的。它同时是配套那个 Telegram 机器人的原理:你把一个 APK 下载链接丢给机器人,它用 Range 请求只取清单和目录,几秒钟回你一张成分报告。
而上限也很清楚——它只能看目录和清单。清单之外的东西(DEX 里的类名、.so 的真实内容、资源文件)它一概不碰。所以链接预览给出的成分,比装完之后分析要浅一层。这个取舍是故意的:为了快,就得少看。
七、提前一年发现 16KB 页没适配
这一段是我认为它最有前瞻性的功能。
2025 年开始,Android 支持 16KB 内存页。到 Android 16,某些设备上这就是硬性要求。而绝大多数现成的 .so 是按 4KB 页对齐编译的,装到 16KB 页的设备上,加载器直接失败——用户看到的是「应用停止运行」,开发者看到的是一堆看不懂的链接错误。
这类问题最难受的地方是它有延迟。你今天发版,用户里用新系统的人还是少数,报上来的崩溃稀稀拉拉,很容易被当成机型兼容问题放过去。等到新系统普及,一次性炸开,那时候再回头改构建参数、重新验证所有第三方 SDK 的 .so,就来不及了。
而且它已经不是一个「以后再说」的兼容项了。应用商店把 16KB 页支持列进了上架要求,新提交和更新都要过这一关。也就是说,这个检查对开发者来说是「上架前的必答题」,不是「优化项」。
对普通用户,它的意义更直接一点:你手机上那些还没适配的 App,换新手机之后大概率会闪退。 而厂商只会告诉你「请联系开发者」。提前知道哪些 App 有这个问题,比事后骂街有用。
更麻烦的是,这件事你自己改不了。你自己的代码你能重编译,但一个 App 里往往有十几家第三方 SDK 的 .so,每一家都得单独出新版本。这就是为什么越早发现越好——你不是在等自己,你是在等上游。
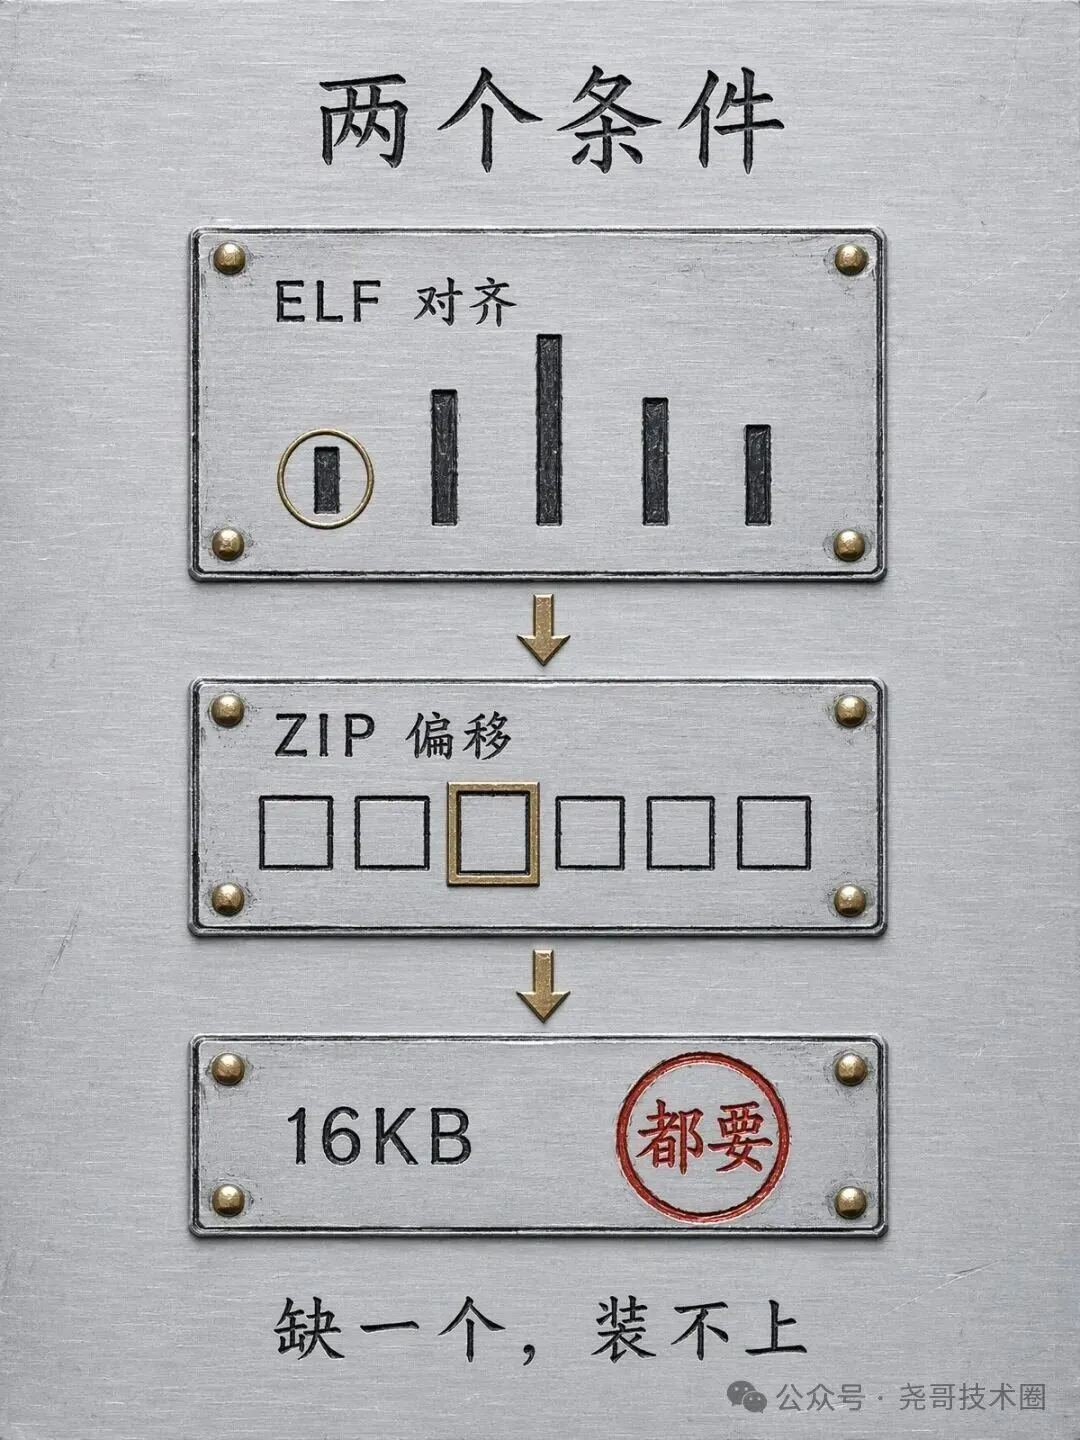
LibChecker 把这个检查做成了两个条件,缺一不可:
条件一是 ELF 自己的对齐。 解析 .so 的程序头,找出所有 PT_LOAD 类型的段,取它们 p_align 的最小值。这个值必须是 16KB 的整数倍。为什么取最小?因为加载器按段映射,最松的那个段决定了整体能不能装下。
条件二是它在 ZIP 里的位置。 如果这个 .so 在 APK 里是 STORED(不压缩)存的,那它的数据偏移也必须按 16KB 对齐。因为安装时是直接把 ZIP 里那一段内存映射进去的,偏移没对齐,加载器就得额外拷贝一次——性能损失,某些情况下还会失败。
两个条件只满足第一个的,它会明确标出「ZIP 对齐只有 4KB」,而不是简单打个叉。这个区分很重要:一个是编译参数的问题,一个是打包参数的问题,改的地方完全不一样。
顺便说签名。它也自己判签名方案,不依赖系统 API:V1 看 META-INF 里有没有签名文件,V2/V3/V3.1/V3.2 是自己去读 APK Signing Block 里的块 ID,V4 看旁边有没有 .idsig 旁挂文件。
为什么不问系统?因为系统只报它实现的那几版。你在 Android 9 上问,它压根不知道 V3.1 是什么。要跨版本给出同一个答案,就得自己读文件。
八、它还会记住变化
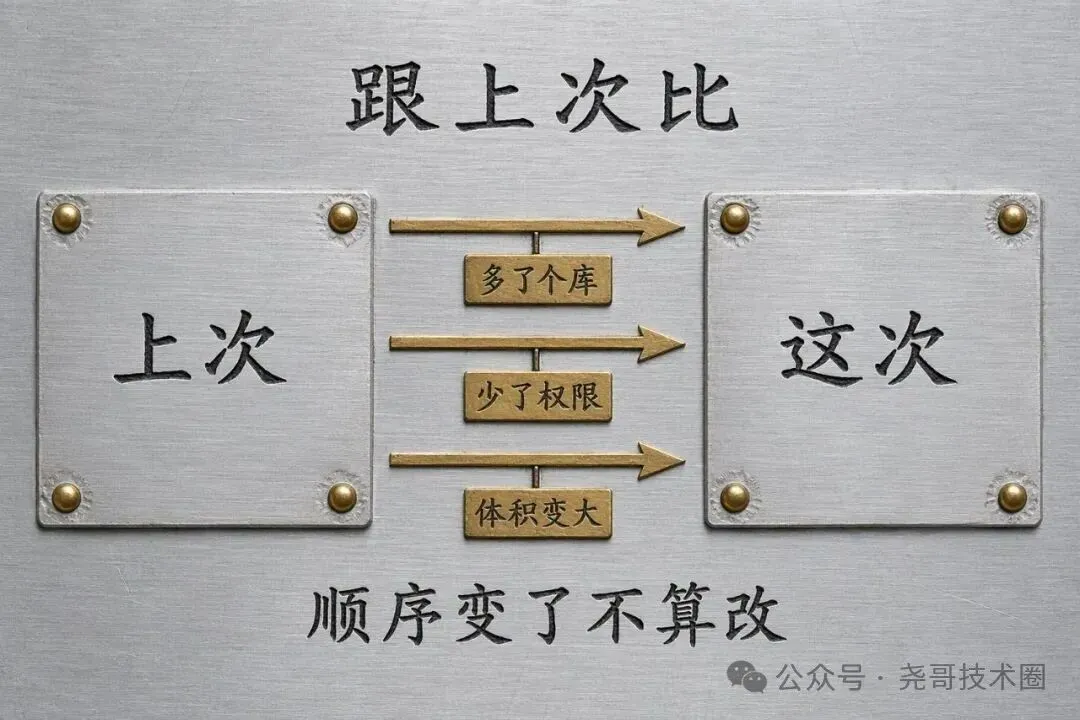
单次的成分表只能回答「现在是什么」。真正有用的问题是「跟上次比,多了什么」。
所以它有个快照功能。拍一次快照,就是把当前所有 App 的成分完整存一份到本地数据库;拍两次,就能比。
比较的粒度比我预想的细。它把每一个维度都拆成「旧值 / 新值」的一对,覆盖的范围包括:应用名、版本名、版本号、ABI、targetSdk、compileSdk、minSdk、原生库清单、Service、Activity、Receiver、Provider、权限、清单元数据、包体积、DEX 信息、资源体积、资源条目、以及归档状态。
结果按四种变化归类:新增、删除、修改、移动。「移动」单独算一类,因为列表顺序变了但内容没变,这种情况不该被当成「这个 App 更新了」。
从 2.5.2 起,快照还会额外记两样东西:系统的 Build ID 和安全补丁级别。
这两样看着跟 App 无关,但它们解决了一个很实际的排查困境:同一个 App,同一个版本,在不同系统版本上行为不一样。以前你只能怀疑「是不是系统的问题」,现在能直接看到「哦,我升级系统那天它就不对劲了」。
快照可以导出、可以备份、可以恢复,也可以在 WebUI 里打开做可视化对比。导出的文件是自包含的,不依赖服务器。
九、也有它看不见的地方
讲到这里得说清楚它的边界。这一段是这个工具真正的诚实之处。
第一,它只能看静态证据。 一个 App 里到底有没有埋点、埋了几家、有没有在传数据——它回答不了。它只能告诉你「接了哪家的 SDK」。SDK 接进来不用,或者运行时从服务器下发的配置决定用不用,这些都在它的视野之外。动态加载的 DEX 它看不见,云端下发的组件配置它也看不见。
第二,静态库基本认不出来。 前面说静态库规则只有一条,就是这个原因。静态库在链接时被合进了最终的 .so,没有独立的文件名,剩下的只有符号表——而符号表还能被 strip 掉。要认它只能靠特征字符串扫描,误报率极高。这个项目选择了基本不做,只留了一条规则占位。
这是行业难题,不是这个项目偷懒。同样的困境,那些做组件识别的商业产品也解决不了。
第三,规则库永远滞后。 新 SDK 出来,得有人写规则、提样本、过审、发版,然后你才认得出来。中间这段时间,你会看到「未知库」。那不是 bug,是规则还没写到。
这一点其实决定了这类工具的真实体验:它好不好用,八成取决于规则库的维护速度,两成才取决于代码质量。而规则库的维护是纯人力活,靠社区一条一条补。所以它把规则仓库单独拆出来、把贡献流程写成文档、把每条规则必须带正反例写进契约,都不是洁癖——是在降低「补一条规则」的门槛。
第四,最准的那部分数据要额外授权。 DEX 的优化状态(哪些类被 AOT 编译了、用的是哪种编译器过滤规则),最准的来源是 dumpsys package,而这需要 Shizuku 授权。没授权也能拿到,走的是隐藏 API DexFile.getDexFileOptimizationInfo,但结果不如前者完整。这是一条明确的降级链,界面上会告诉你当前用的是哪条。
第五,两个版本的差别。 项目分 foss 和 market 两个 flavor。foss 是干净的,没有任何 Google/Firebase 相关的东西,F-Droid 上架的就是这个;market 带崩溃上报。同一个代码库,构建时按 flavor 选源集。
第六,多语言只到两档。 规则的显示名有中文和英文,其他语种回退到英文,英文缺失再回退到原始标签。它不机器翻译库名——这是对的,机器翻译出来的「某 Push 服务」还不如原文。
十、结语
回到开头那 30MB。
现在你有办法回答这个问题了:拍一份快照,更新,再拍一份,看 diff。多出来的那个库叫什么、属于哪家、是靠哪个文件认出来的,都在那儿。
但我更想说的不是这个功能。
这几年我们习惯了「装个工具看看」,看内存、看流量、看电池。这类工具的价值很容易被低估,因为它们不产出东西,只提供判断。而判断这件事,最怕的就是不准。
LibChecker 让我觉得值得写,是因为它在很多别人会含糊过去的地方做了明确选择:
它宁可漏报也不误报,为此愿意多花几秒去 DEX 里扫类名。它宁可让规则作者少写几种正则,也要保证三个语言的运行结果一模一样。它宁可把远程规则的能力削到只能读两个算子,也不给「规则里跑脚本」留口子。它宁可只支持两种语言的标签,也不机器翻译库名。
这些选择单独看都是「少做了一点」。合起来看,是同一件事:这个工具的每一个输出,都得能被追溯到一条具体证据上。
在一个「AI 什么都能编」的年份里,这种克制反而稀缺。
参考
项目地址: https://github.com/LibChecker/LibChecker— Apache-2.0,Google Play 与 F-Droid 都能装规则仓库: https://github.com/LibChecker/LibChecker-Rules— 匹配规则与数据契约都在这里浏览器版: https://lc.absinthe.life— 本地解析,不上传文件隐私说明: https://github.com/LibChecker/LibChecker/blob/master/PRIVACY.md— 数据边界的原话