ARTICLE · 1281408
担心 AI 读书时乱编?把 PDF 拆成章节再问
实测记录
担心 AI 读书时乱编?把 PDF 拆成章节再问
拿一本中文开源书实测:章节拆得准,答案能回查到章和式号,页码和书里的例子还得自己翻原书。
担心 AI 读书时乱编、答案查不到出处?把细节摊开看。
我在 OpenCode 里装了一个开源工具 book-to-skill,模型用 deepseek-v4.1-flash,拿 Datawhale 的《机器学习公式详解》试了一遍。这本南瓜书是 CC BY-NC-SA 4.0 的中文开源书,文字版 PDF,196 页,公式很密。要回答的问题只有一个,它把书转成 Skill 之后,还能不能用来查东西。
01它把一本 196 页的书拆成了什么?
一句命令就转完了。
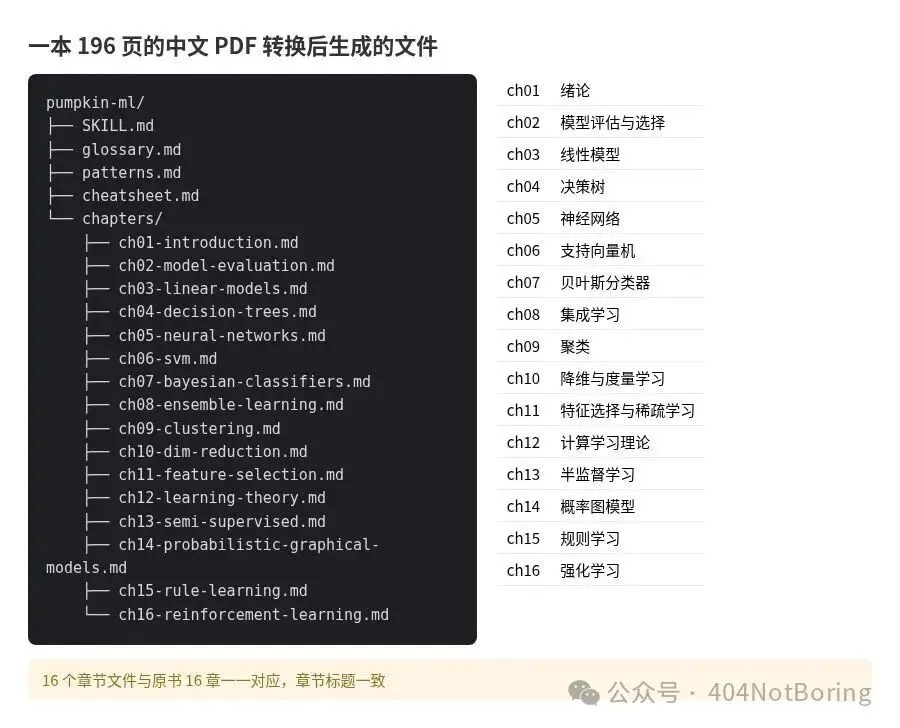
产出是一个 Skill 文件夹,里面有 SKILL.md 当总纲和章节索引,还有 glossary.md 术语表、patterns.md、cheatsheet.md 速查表,以及 chapters/ 下 16 个章节文件。原书 16 章,生成 16 个文件,标题和目录一一对应,从绪论到强化学习,一章没落。
数量对得上不代表内容对得上。提取走的是 pdftotext,公式在纯文本里会被打散,生成的章节文件里那些公式是模型按标准写法重新整理的,它自己在报告里写了,要逐字核对请回查原书。
02问它问题,答案能对上原书吗?
拿 5 个问题做回查,要求写出章节、小节、式子编号和 PDF 页码,再逐条翻原 PDF 核对。每次提问,Agent 只打开相关的那一个章节文件,有时再搜一下术语表和速查表,没有读整本书。
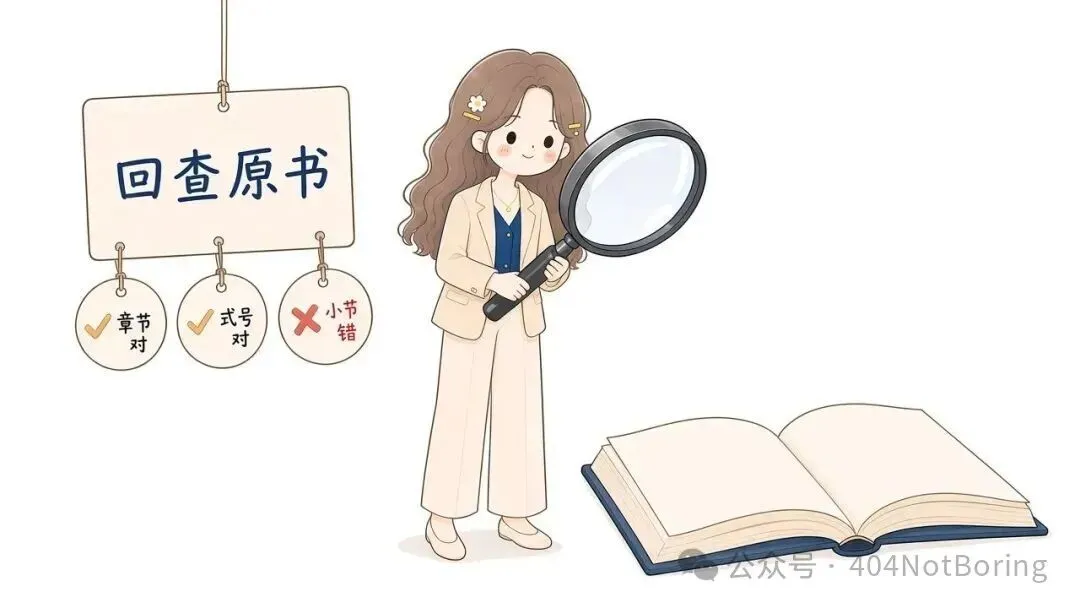
章节号这一项,5 题里有 4 道书里能找到的题,章节都对。第 5 题问这本书怎么讲 Transformer 注意力机制,书里根本没有,它直接回答 16 章不含这个主题,没有编。式子编号也对得上,决策树、AdaBoost、软间隔几道题给的式号,在原书里都能找到对应推导。
小节号出错了。软间隔那题它写 6.3 节,原书 6.3 是核函数,软间隔在 6.4 节。
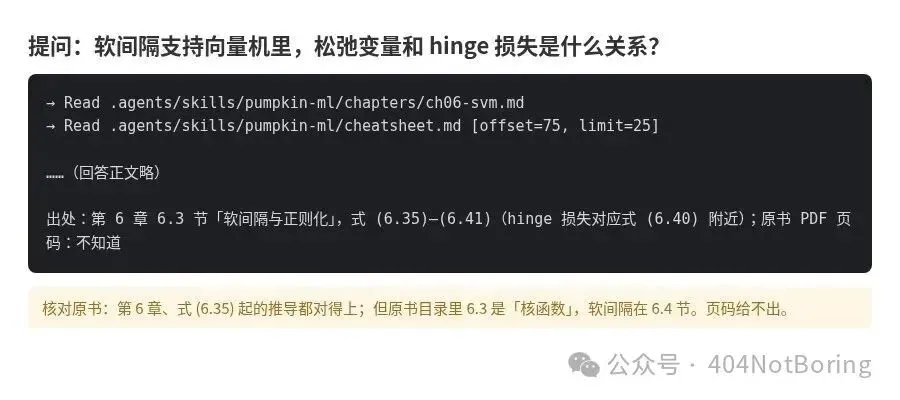
页码这一项,5 题全部回答不知道。生成的文件里本来就没带页码,回溯只能到章和式号,到不了页。
03它会漏掉什么?
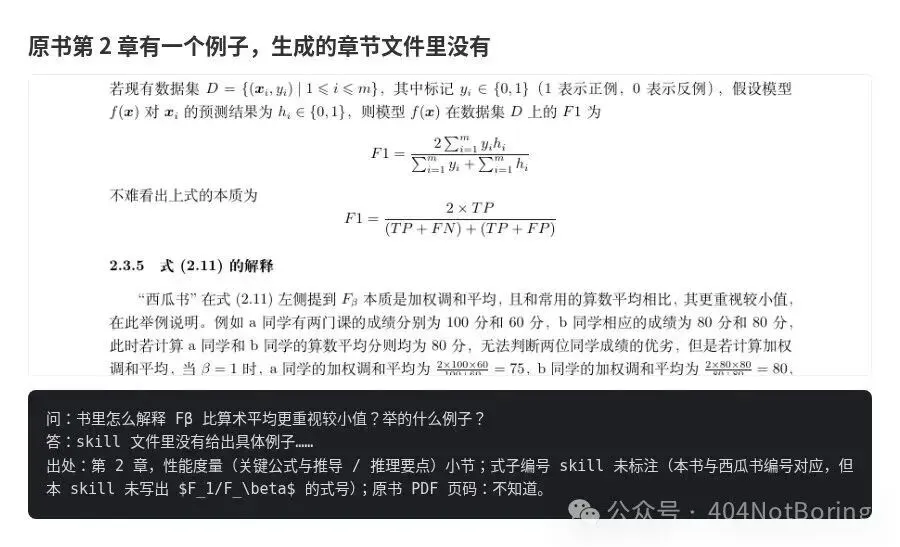
最明显的是例子。我问 Fβ 为什么更重视较小值、书里举了什么例子,它说 skill 文件里没有例子。原书第 2 章 2.3.5 节明明有,a 同学两门课 100 分和 60 分,b 同学 80 分和 80 分,算术平均都是 80,加权调和平均 a 是 75、b 是 80。生成章节时这个例子被压缩掉了。
还有一处是补进去的。信息增益那题,「信息增益偏好取值多的属性」这句话南瓜书第 4 章原文里没有,是模型从西瓜书常识补的。结论没错,但不出自这本书。
所以这个工具适合拿来做检索入口,章节结构和式号够你定位,原文细节还得回查原书。受版权保护的书生成的 skill 只自己用,不要公开。内容会发给所选模型,未发表稿件和学生信息别放进去。工具本身免费开源,运行时调用的模型按各自官方页面计费,以官方页面为准。扫描版 PDF、多篇论文合成一个 Skill 这些用法,这次没有测。
YING
高校青年教师 · 每天学一点 AI、用一点 AI
愿你我都成为发光发热之人!