ARTICLE · 1281602
AI读钼靶十年总账:多查出29%的癌、省下44%的阅片,为什么专家仍不敢让它“单飞”
前沿文献深度解读 · 影像与筛查
AI读钼靶十年总账:多查出29%的癌、省下44%的阅片,为什么专家仍不敢让它“单飞”
2015—2025年,AI乳腺筛查从概念走到了随机试验。这篇纳入24项研究的系统综述与荟萃分析,替整个领域算了一笔冷静的总账。
Diagnostics 202624项研究 · 十年证据系统综述+荟萃
痛点 01
影像科的日常:筛查量年年涨,阅片医师数量不涨。乳腺筛查要做双人双读,一个下午上百份钼靶;而另一头,是致密型乳腺里最容易漏掉的病灶。AI被寄予厚望——但“希望它行”和“证明它行”,隔着十万八千里。
痛点 02
更深的顾虑在政策侧:一旦AI进入国家筛查计划,“漏诊一例”就是头条新闻。单中心AUC再漂亮,也回答不了“放到人群里会发生什么”。2026年,Diagnostics刊出一篇覆盖2015—2025年的系统综述与荟萃分析(24项研究,CC BY开放获取),把十年证据摊开算账。
1十年总账:三笔收入,两笔负债
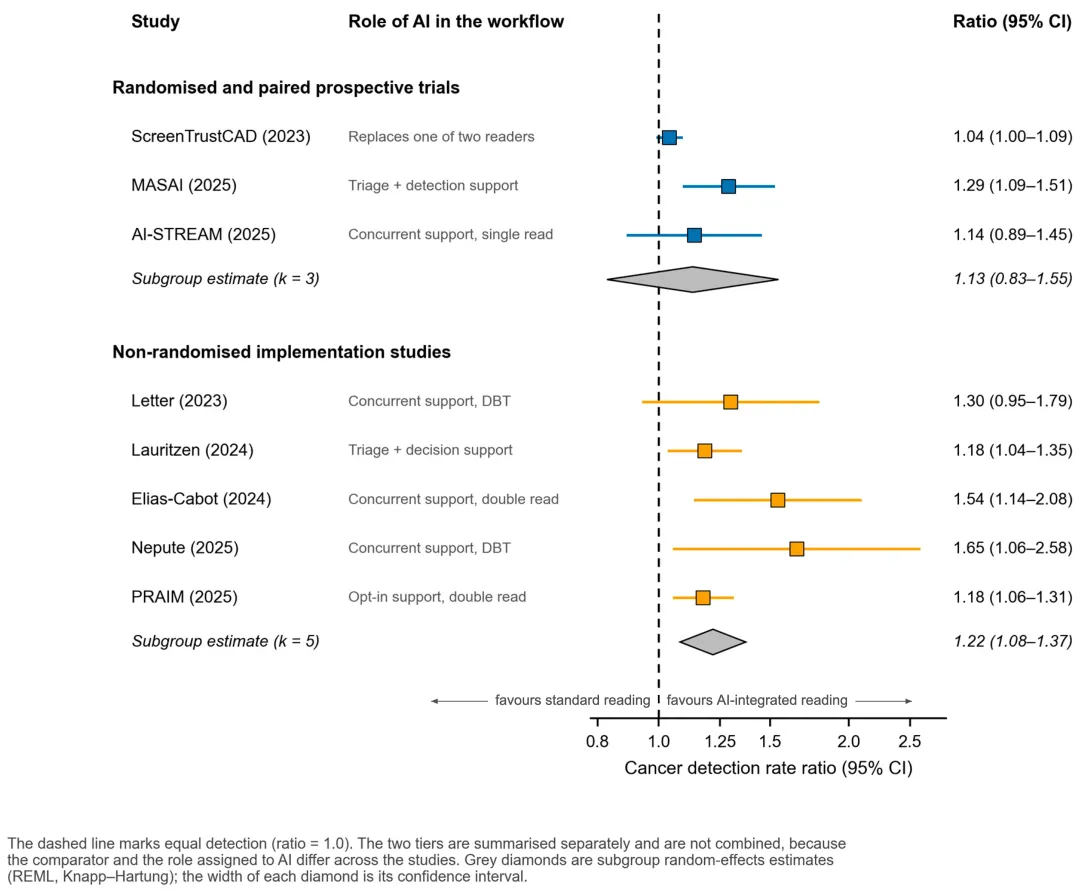
AUC 0.890 独立读片汇总鉴别力(预测区间0.73—0.96) | +29% MASAI随机试验癌症检出率(6.4 vs 5.0/千人次) | −44% MASAI筛查阅片工作量且假阳性未增加 |
但“负债栏”同样醒目:各研究间异质性极高(召回率比较的I²高达90.9%),汇总AUC的预测区间宽达0.73—0.96——换算成大白话:换一家医院、换一个版本,AI的表现可能判若两机。综述的结论因此非常克制:AI适合做分诊与第二读者,不适合自主替代。
图1
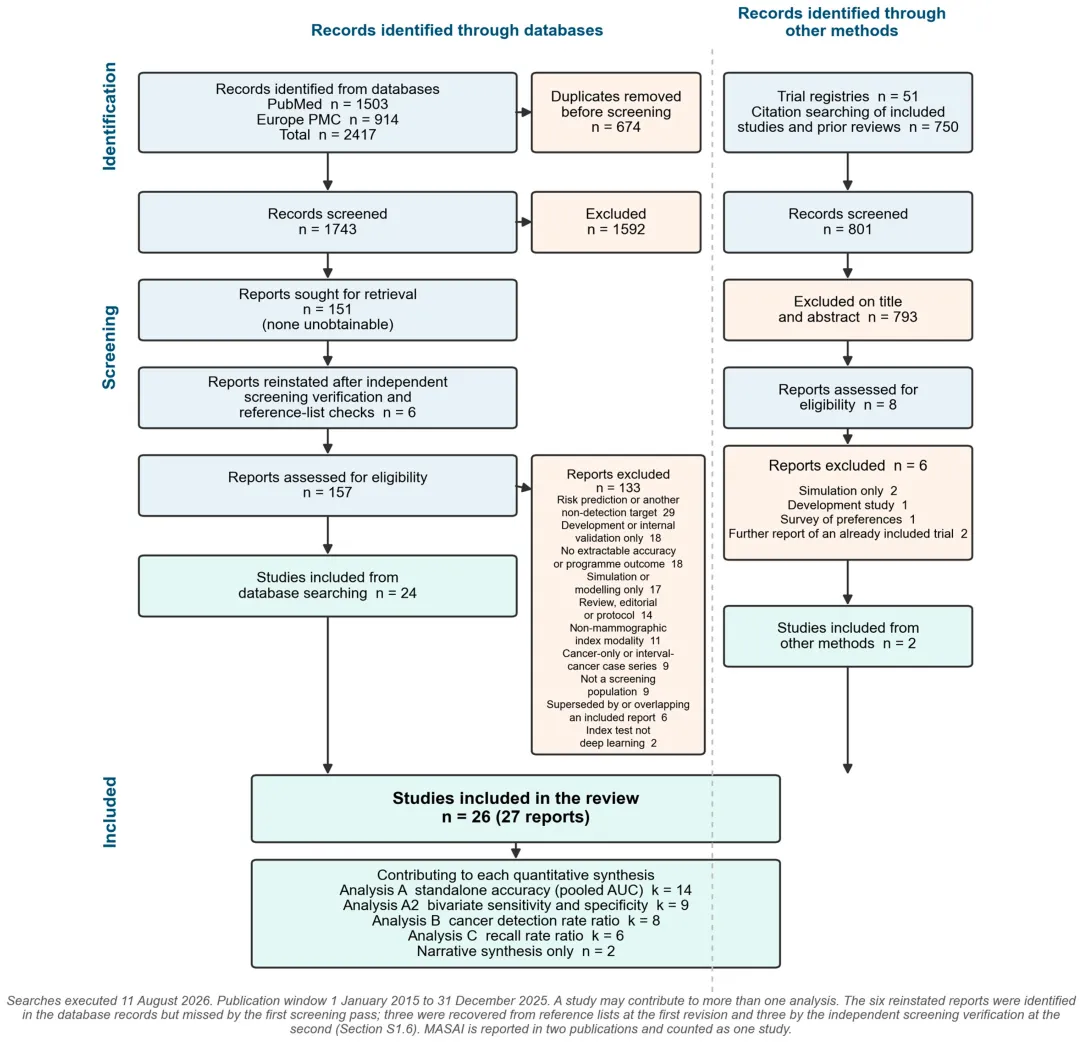
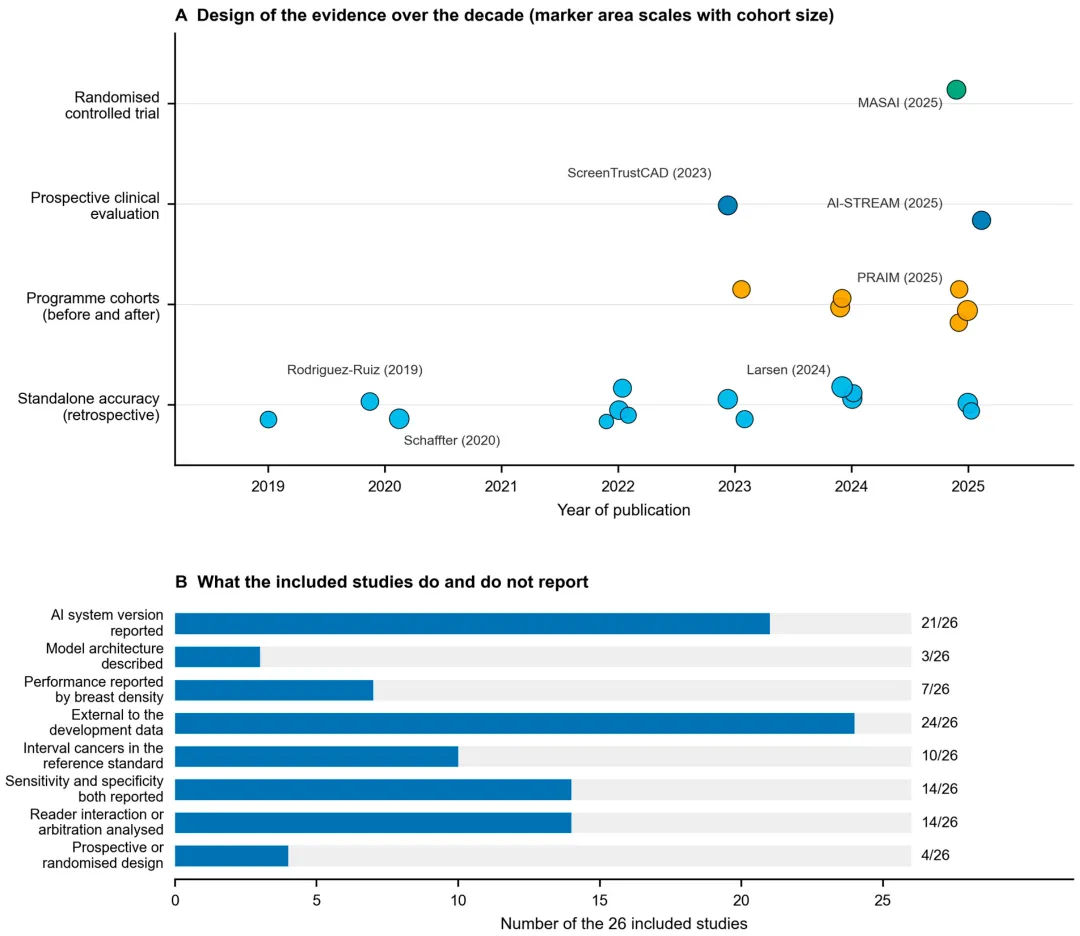
图2
原文图3 · 检出率与召回率汇总
2新在哪:从“能不能”到“放在哪”
第一,分层算法本身。综述把证据切成“随机/配对前瞻”与“非随机”两层分别汇总,不混煮——这正是过去AI影像综述最大的坑。第二,把“部署模式”当研究对象:分诊(AI先筛、人复筛)、第二读者、读者替代——三种模式的证据强度完全不同,现有数据只支撑前两种。第三,给异质性正名:阈值怎么选、人群密度构成、版本迭代,都是性能漂移的来源——报告里没有这些,AUC就只是数字。
| 部署模式 | 现有证据 | 适用判断 |
|---|---|---|
3科研真问题与中国场景
①“模拟好”不等于“人群好”:十年证据里真正进入随机评估的仍是少数,多数研究停留在回顾队列。②经济学模型继承了准确性输入的不确定性——综述明确提醒:凡是宣称“AI筛查省钱”的模型,其输入正是这篇综述揭示的高异质性数据。③中国场景的特殊性:我国筛查以超声为主、钼靶补充,放射医师缺口大、“两癌筛查”持续扩面——AI在我国乳腺筛查中的最优部署模式(超声AI?钼靶AI?多模态?)尚未有中国版MASAI来回答,这正是本土研究最大的空白。
把MASAI的细节摊开看,还有两处常被转述遗漏的信息:其一,它改的是"双人双读"里的一读——AI先读、一名放射科医师复读,而非"AI独立上班";其二,在检出率提高29%的同时,召回率与假阳性并未显著上升,间期癌率也未见劣化——"多查出的癌"目前看是真收益,不是"多叫回来复查"的数字游戏。这个设计上的克制,恰恰是它敢于写进指南讨论的底气。
方法学上,这篇综述给所有做AI影像研究的人上了一课:为什么必须分层汇总?因为随机试验与非随机研究的偏倚方向完全不同;为什么必须报告阈值如何预定?因为同一模型换个操作点,敏感度与特异度可以此消彼长;为什么必须登记版本号?因为厂商的一次迭代就可能让去年发表的结论过期。这些" boring"的细节,正是把AI研究从"工程演示"推向"临床证据"的分水岭。对中国研究者,还差最后一块拼图:一个中国版的MASAI——在超声为主、钼靶补充的筛查体系里,AI应当放在哪一环、以哪种模式、用什么终点证明自己,这是未来几年最值得投入的研究设计题。
落地之前,还有两笔账要先算清。
一是召回管理:检出率提高29%意味着每千次筛查多召回一批人做加压与穿刺,活检容量、结果沟通与假阳性带来的心理成本,都要提前列入实施评估—— MASAI的经验是假阳性未显著增加,但这建立在"AI替换一读、人医保留一读"的保守结构上,任何更激进的结构都没有同等证据。
二是支付与责任:筛查AI按次收费还是按年授权、版本升级是否需要重新验证、漏诊个案的责任如何在厂商与读片医师之间划分,这些条款将决定它进入公共卫生项目后的真实形态。对我国"两癌筛查"扩面的时间窗而言,与其急于采购某一款产品,不如先把"评估基座"搭起来——一个本地化的连续筛查队列、一套盲法评估流程、一份可复核的版本档案,有了这三样,任何厂商的任何模型来了,都能在三两个月内给出可信的本土成绩单;没有这三样,采购就只能是"相信演示"。


最后给读者一个自检清单:看到任何"AI筛查准确率超过医生"的标题,先问三件事——用的是回顾队列还是前瞻试验?操作阈值是预先设定还是事后挑选?报告的是检出率还是患者结局?三问答不上来,那个百分比就还只是广告。十年总账教给我们的,与其说是"AI行或不行",不如说是"怎么判断它行不行"——这种判断力,比任何单一结论都更值得带回家。
“
AI读片十年的答卷不是“取代医生”,而是把医生的时间,还给了最需要人眼的那部分片子。
边界①综述纳入以欧美筛查项目为主,中国致密乳腺人群外推需验证。
边界②“+29%检出”来自MASAI一项RCT,非全部研究汇总;间期癌率等长期安全性数据仍有限。
边界③AI版本迭代快,本文结论对应2015—2025年证据窗口。
文献来源:
Ciurescu S, Buciu V, Ilaș DG, Pârvănescu R, Șerban D. Ten Years of AI in Screening Mammography: Systematic Review and Meta-Analysis (2015–2025). Diagnostics. 2026;16(18):3045. DOI: 10.3390/diagnostics16183045.(CC BY)
核心对照:Hernström V, et al. MASAI试验. Lancet Digit Health. 2025;7(3):e175-e183.