ARTICLE · 1289770
让AI读PDF,别漏掉表格和图片
CP炼丹心得 · AI工作观察
文件传上去了,还要确认模型看到什么。带着页码、单位、表头和脚注读报告,结论才方便核对。
假设你把一份业务月报交给 AI,让它总结“收入变化”。报告里有曲线、表格和脚注:一张表按万元计,另一张按元计,脚注又说明某区域没有纳入比较。回答即使读起来顺畅,也可能把这些条件拼错。
读文件时,先确认输入链路保留了什么,再检查结论对应哪一页。文件成功上传,只说明传输完成;内容是否进入模型、表格是否读准,仍有各自的检查步骤。
观察 / 01
先确认它看到了什么
以 OpenAI Responses API 的文件输入为例,官方文档说明:支持视觉的模型处理 PDF 时,会把提取的文字和页面图像一起送入上下文;同一入口处理非 PDF 文档时,提取路径有所不同,嵌入图表未必会被保留。[1]
这条说明有明确的产品、接口和模型条件,不能推广成“所有聊天工具都能完整看懂文件”。使用具体产品前,查它的文件支持说明;若图表是判断依据,先确认页面图像或相关图片确实被处理。
观察 / 02
把问题缩到页码和单元格
与其只问“总结这份报告”,可以先问:“请找出收入变化所在页,列出表名、统计期间、单位和对应原文;缺少的项目标成未找到。”这是建议的核对流程,不能保证任何模型都按要求给出正确答案。
拿到定位后,再把需要的行列写清。例如比较的是同一地区、同一业务范围的两个月,还是累计值与单月值?要求先抄出参与比较的单元格,再做解释,能让错误更早暴露,也方便你回到文件复查。
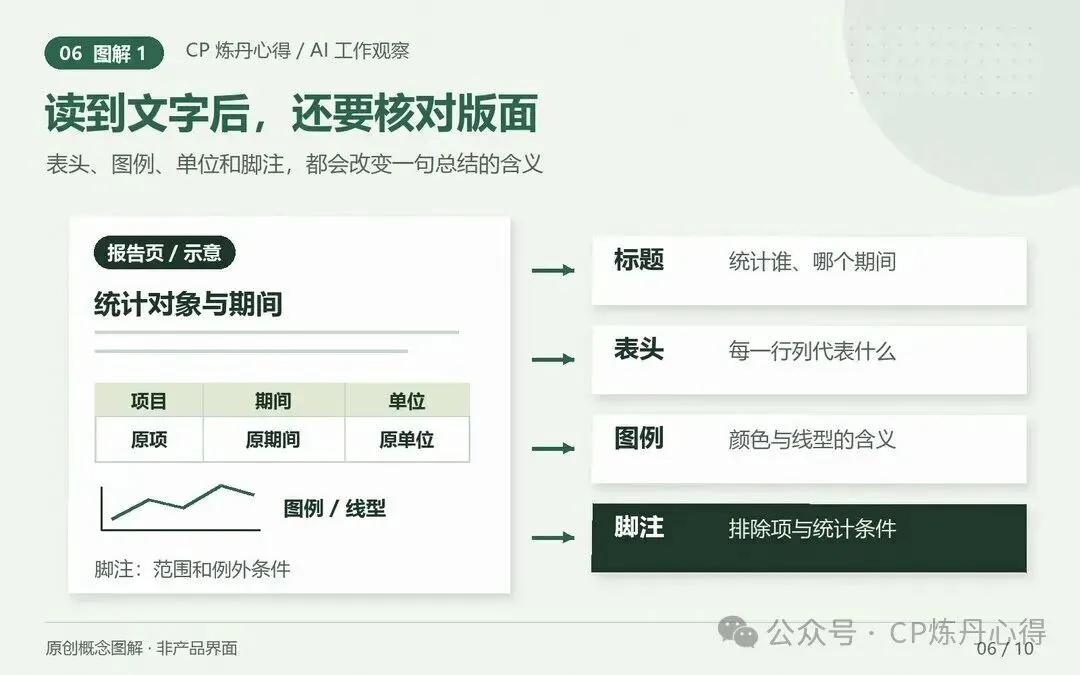
图 01|读到文字后,还要逐层核对版面信息。
观察 / 03
表头和脚注,值得单独看
OpenAI 的视觉文档列出了小字、旋转图像和部分图表样式的识别限制;模型也可能生成错误描述。[2] 因此,图里文字细小、折线颜色相近、虚实线区分关键时,需要单独放大或提供更清楚的页面。
检查时按固定顺序走:标题说明统计对象,表头说明行列含义,单位说明量级,脚注说明例外。对合并单元格、跨页表和图片里的标注尤其谨慎。仍看不清的地方保留疑问,不让一句完整的总结掩盖输入的不完整。
观察 / 04
把计算和解释分开复核
当结论依赖加总、比例或增减幅度时,先把原始数值、单位和公式单独列出来。用表格工具或计算器重新计算,再判断文字解释是否成立。这个步骤是编辑建议;它解决的是核对过程,不会自动修复读错的数据。
最后留一条可回溯的记录:“结论—页码—表格位置—原始数值—限定条件”。如果文件后来换了版本,记录也要跟着更新。无法确认的页码、模糊的图例或缺失的附注,应明确标记,暂时退出确定结论。也可以保留关键页的截图,与提取结果并排查看;截图用于核对具体位置,不能代替整份文件的背景条件。交给同事时,把未确认项目与已经核对的项目分别写清,减少后续误用。
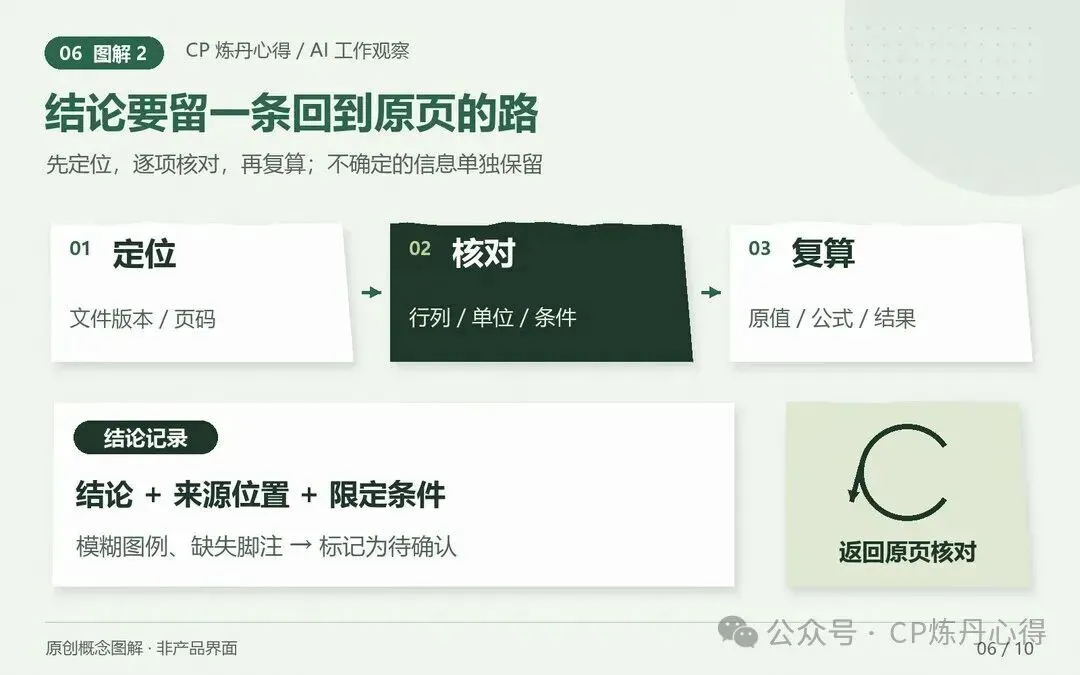
图 02|从原页到结论,留下可以返回的路径。
先核对一页,再扩大到整份文件
我的判断是,AI 读报告最有价值的起点,是帮助定位和整理证据。需要据此继续办事时,证据链还得保留下来。
下一次上传 PDF,先挑一张关键表,只核对页码、行列、单位和脚注。把这一页弄清楚,再扩大到整份文件。
动手前的小检查
01 输入:当前产品和模型是否处理了关键页面图像或图表?
02 证据:结论是否带有可回看的页码、行列与限定条件?
03 数值:单位、统计期间、原始数字和计算结果是否逐项复核?
资料来源
[1] OpenAI|File inputs — OpenAI API查阅于2026-10-21https://developers.openai.com/api/docs/guides/file-inputs
[2] OpenAI|Images and vision — Limitations查阅于2026-10-21https://developers.openai.com/api/docs/guides/images-vision
封面为AI生成,正文图解为原创示意。