ARTICLE · 1290076
普通电脑跑AI大模型,在AI台账助手这种知识库场合效果如何?麒麟统信能跑吗?不同电脑配置实测
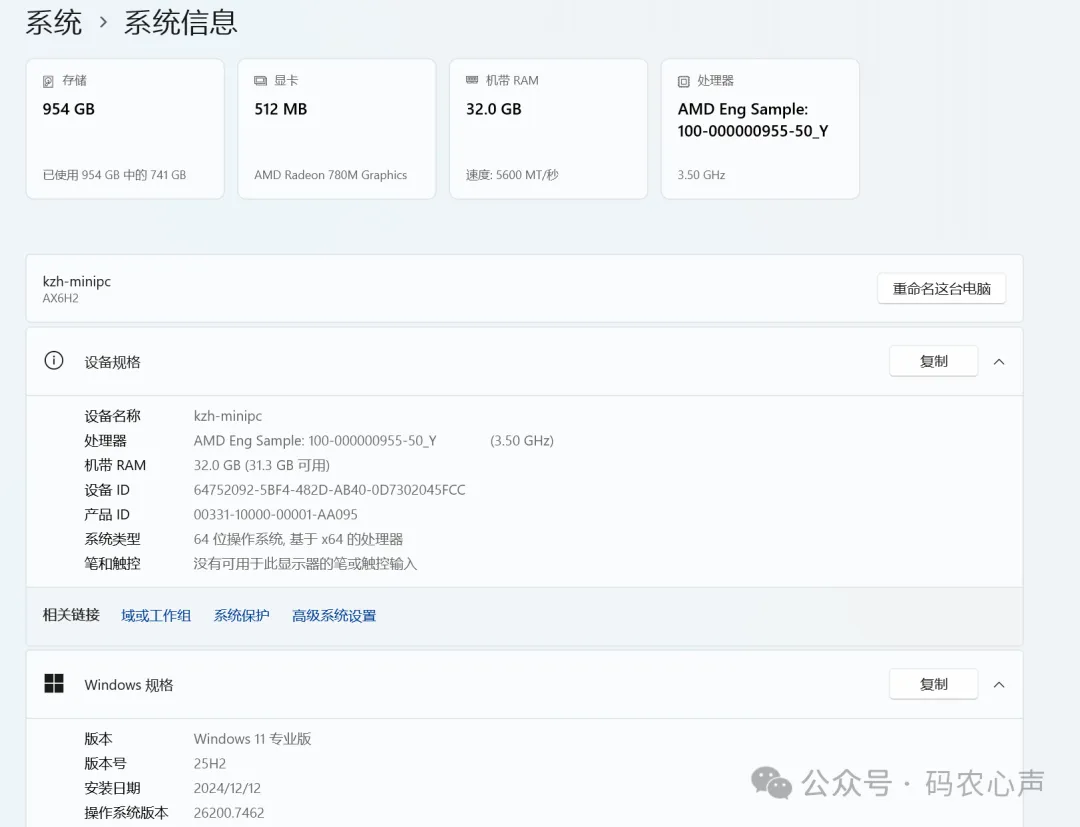
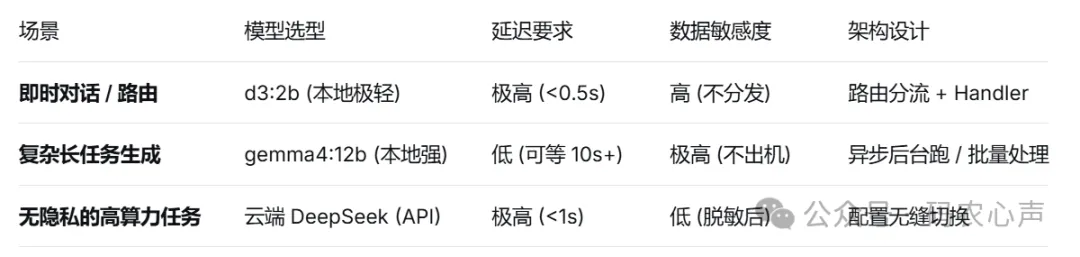
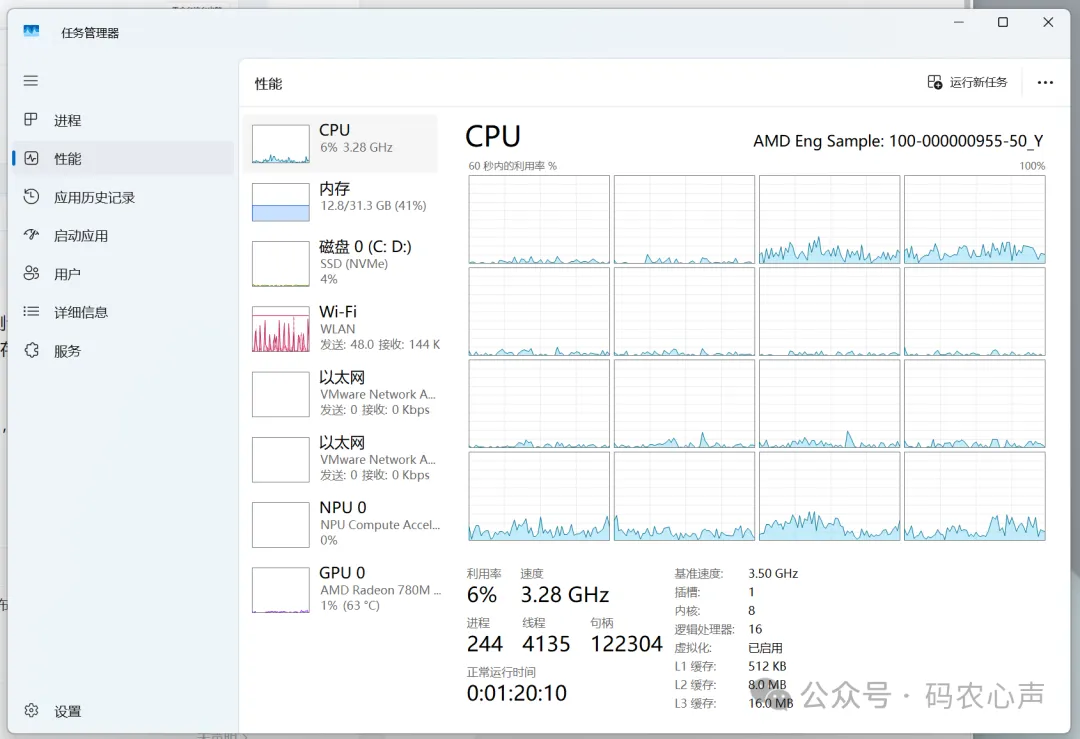
双模型常驻后,本地跑是完全可用的——轻量决策秒级响应,主模型生成类任务 15 秒左右一次,代价仅 4.26GB 内存;瓶颈不在内存(32G 富余)而在核显算力,速度约为云端的 1/14,换来的是数据不出机。
第二台电脑,村委会使用的intel办公电脑。一样的windows11系统,配置如下图:
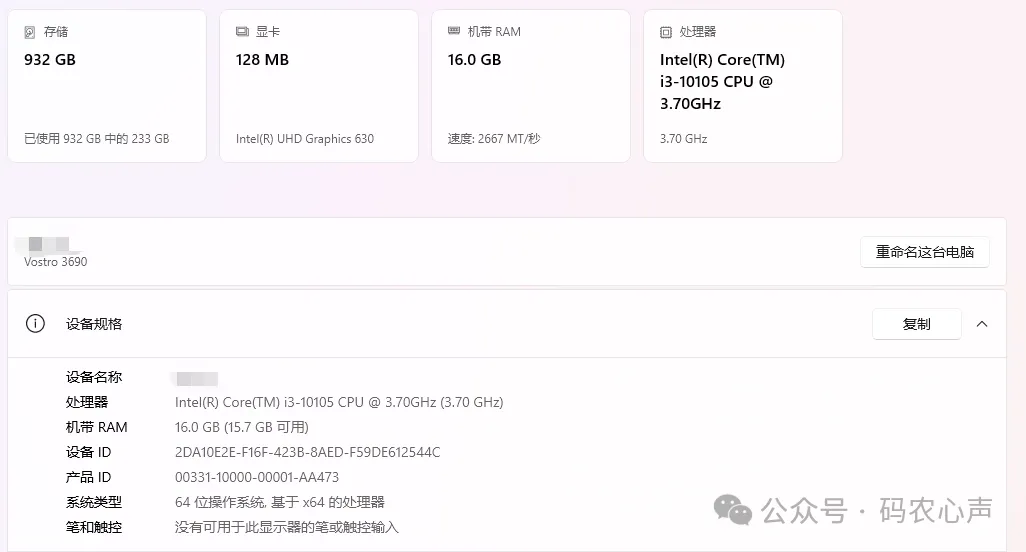
可以看到是因特尔廉价的i3低端处理器,内存为16G,intel集成显卡,这配置是政府采购时的入门办公配置。
安装模型时,下拉选择中等配置的gemma4,双击启动时也会显示日志:
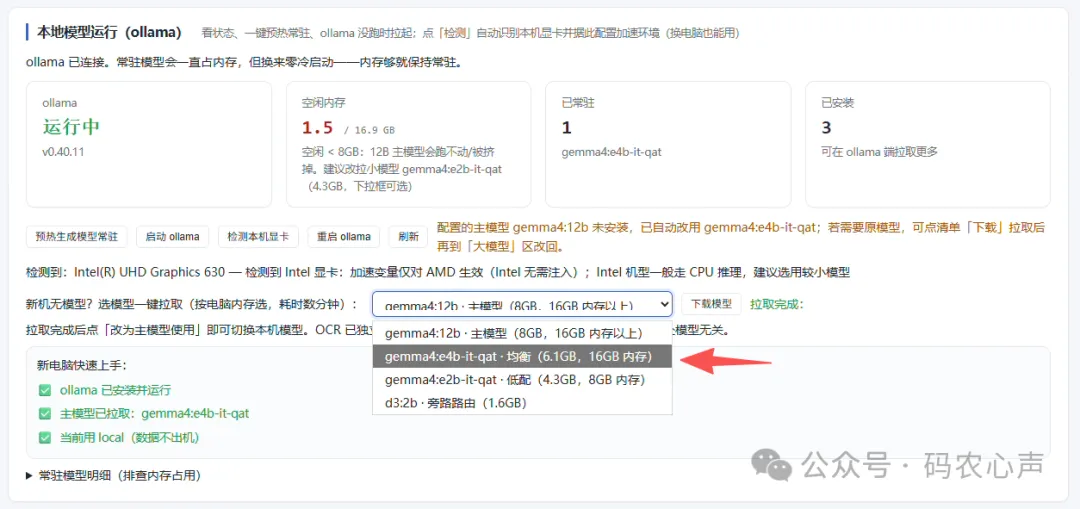
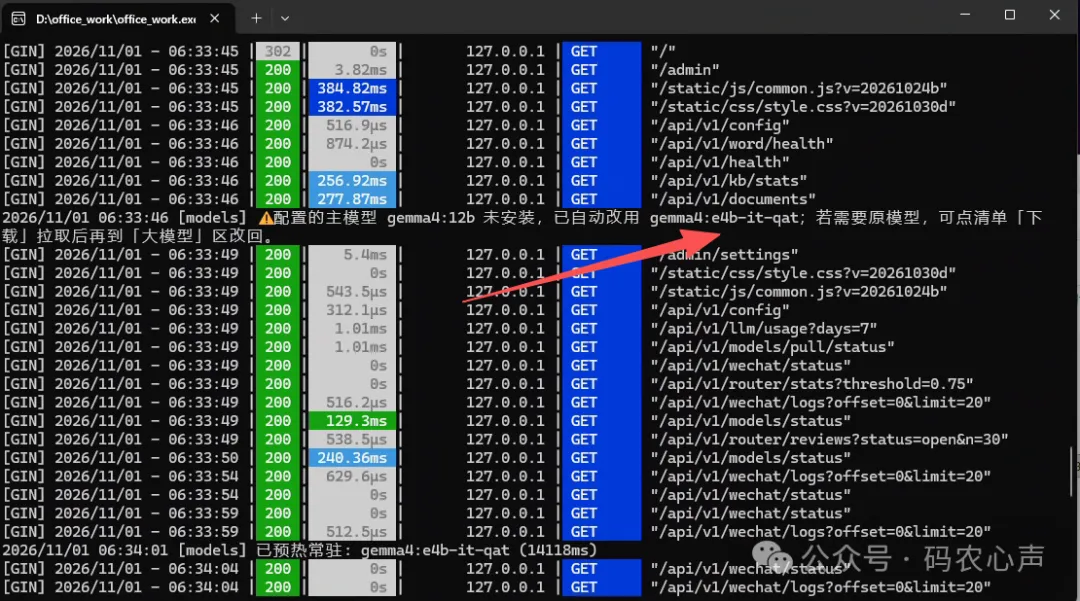
点击预热模型,等电脑把两个模型都加载到内存中,成功后如下图:
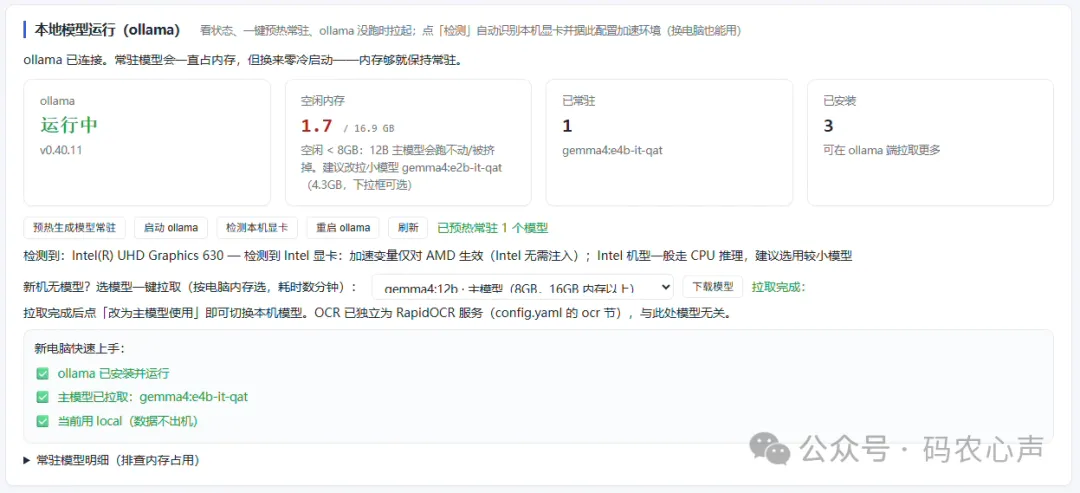
可以看到,两个模型加载到内存后,电脑还剩下1.7G内存了。
我用63个word文档,针对本机量化模型易错点的压力维度实际测试下来,数据如下:
财务精度:E3-王xx收入、E4-谢xx收入——小数 + 千分位逗号(9,535.8),并改进评分为数值比较(去千分位、保留小数、容差 0.005)脏文本鲁棒性:E5——多余空白、断行、错别字("慢病")多步推理:Q4 跨年对比收入、Q5 按条件筛选成员闲聊护栏:D4(应判闲聊不调工具)更多工具决策:D5-生成Word、D6-记录字段结果(16 用例 × 3 轮,多数投票)指标 本机 gemma4:12b 云端 DeepSeek准确率 15/16 (93.8%) 13/16 (81.2%)平均耗时 14501 ms/次 1045 ms/次(快 14 倍)平均 token 601488
抽取 + 问答(10 用例)两模型全过,包括财务精度——本机连 9,535.8 的千分位逗号都精确复述,脏文本、多步推理也不输deepseek云端。
测试时发现的唯一差异,发送任务“生成word”,本地和云端的差别:
本机要求用户先选择word模板、云端先列出模板列表。这是用例表述有歧义("根据这个模板生成"),模型倾向先探明上下文,不是准确率差距。
看来,在知识库这种简单场合,云端模型和本地小模型,结构化抽取/事实问答等价,本机在数据不出机的前提下不输云端,只是本地模型运算速度慢,和deepseek云端速度差距明显!
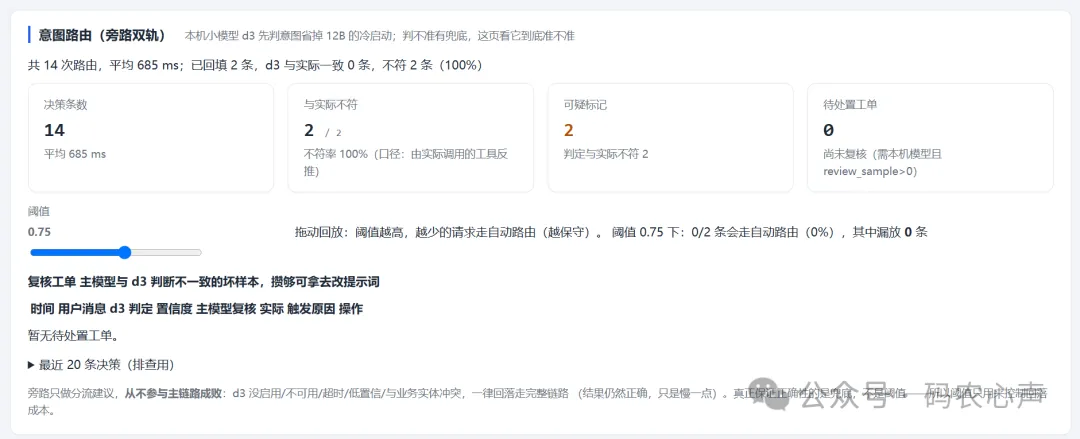
不过,平常的搜索查询、入库存储,都是用d3决策模型,响应速度在2秒以内,为了合规和充分利用现有资源,大概还是可以接受的。
还有网友问到,国产机麒麟统信能否运行?答案是可以!
程序用go语言写的,支持跨平台编译,windows、Linux和macos都支持。麒麟统信系统实际是Linux内核,编译成linux的二进制即可运行。
普通电脑受硬件限制,内存太小的,或者古董机如早淘汰的windows7系统,那是只能升级电脑了,目前主流的电脑,还是可以运行的。
不知大家有什么更好的方案,欢迎在留言区分享,目前内存太贵了,电脑普遍涨价,地方财政紧张,充分利用现有电脑才是唯一选择。