ARTICLE · 1292705
PDF 里明明有图,AI 为什么说没看到?
一份公开报告,正文介绍市场变化,旁边的图给出了不同年份的对比。你想借助 AI 看懂这张图,它却回答:“材料中没有提供相关数据。”
图就在那儿。再强调一次“请仔细阅读附件”,问题也未必能解决。
这里先举的是一种可能遇到的情形,并非本号实测。遇到它时,值得排查的第一件事是:你眼前这一页,和 AI 实际拿到的内容,可能并不一样。
同一个 PDF,材料可能不同
在阅读器里,文字、照片和图表都铺在同一页上,很容易让人觉得,上传文件就是把整页交了出去。
但从文件处理的角度看,一段可以直接提取的文字,和一张带着文字的图片,是两种输入。
有的 PDF 从文档软件直接导出,保留了文字;有的是扫描页,文字只是图像里的笔画;还有的扫描件做过文字识别,在图像之外附了一层可以搜索、复制的文字。PDF 工具 pypdf 的技术文档区分了这些情况,也提醒:识别出来的文字可能有错。
所以,在阅读器里试着选中并复制一小段,可以帮助你了解文件,但不能据此断定 AI 已经读到了什么。能复制正文,也不代表旁边图表的信息同样能被提取。
比如,提取结果里留下了“图三:各年度变化”,却没有曲线、图例和坐标。这时,模型可能拿到了图的名字,却没拿到足以解释它的内容。
反过来,扫描页不能直接复制文字,也不等于 AI 一定不能读。关键还要看工具如何处理它。
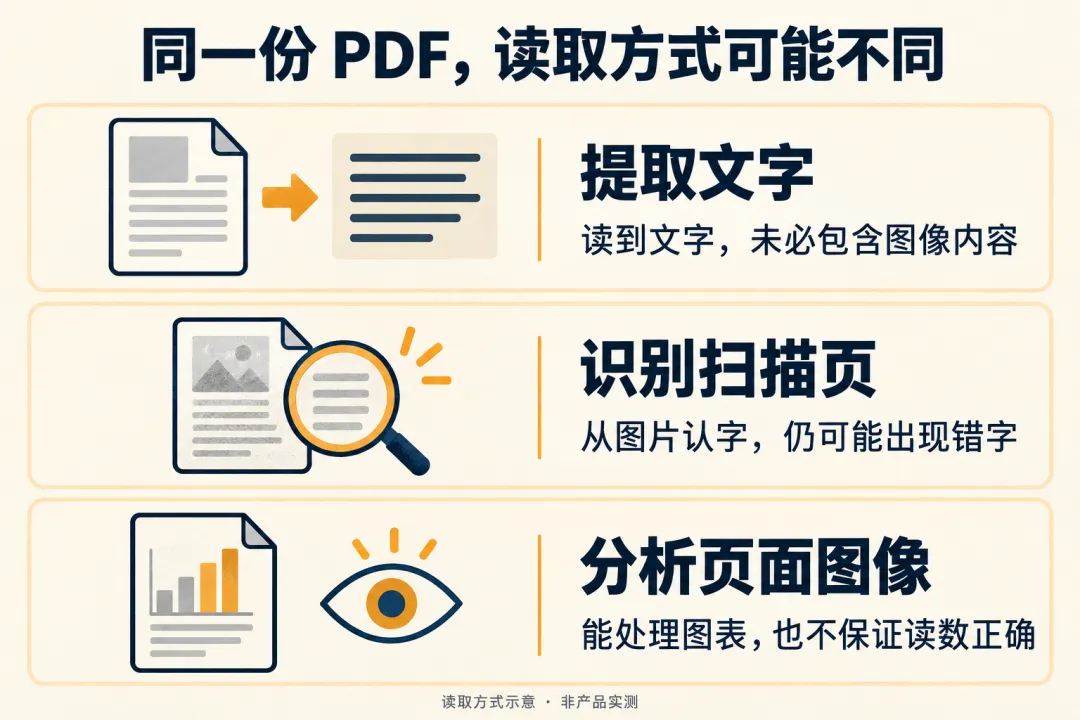
AI 生成示意图,非产品实测。
“支持上传”和“能看图表”,中间还有一步
文件进入工具以后,需要经过处理,再交给模型。只取出文字,或者把页面图像一并交过去,会带来不同的信息范围。
这不是说现在的 AI 都看不了 PDF 图表。
Anthropic 的PDF 接口文档明确说明,其处理过程会把每页转成图像,同时提取文字,一起供模型分析。Google 的Gemini 接口文档也说明,PDF 可以通过视觉方式处理图像、图表和表格。
这些文档证明的是相应接口具备怎样的处理方式。它们不能替你证明,手边某个聊天产品、知识库或第三方应用,此刻也按同样方式处理了附件。即使使用相同模型,应用交给它的材料仍可能不同。
因此,“我支持 PDF”只回答了文件能不能进入这一类流程。对于那张图,你还需要知道:它有没有进入本次可读取的内容。
不过,AI 没答出来,也不能直接判成“图没传进去”。页码没对齐、页面太模糊、问题没有指向目标图,或者模型理解出了错,都可能影响回答。先缩小问题,才有机会区分这些情况。
把“总结全文”暂时换成“找到这一张图”
如果目的就是看懂报告里的某张图,不妨从那一页开始,而不是先要一份全文摘要。
先确认页码。封面和目录会让阅读器显示的页数与正文印刷页码不同;给 AI 时,可以同时写上阅读器页码、印刷页码和图题。
接着,问一个不需要行业知识就能核对的问题。例如:
请定位这张图,写出图题、横轴和纵轴分别表示什么,以及图例中的类别。无法读取的部分直接说明,暂时不要解释趋势。
这一步要看的是回答能否对应原图,而不是它有没有说“已阅读”。图题可能出现在正文中,仅仅复述图题还不足以说明它看到了图;坐标和图例更有助于判断。
若回答仍对不上,可以在工具支持图片输入、且材料允许上传的前提下,把相关页面单独提供。保留图题、坐标、图例和脚注,别只截中间那条曲线。
如果单页图像能读,而整份 PDF 里定位不到,它提示你回头检查文档的处理方式或定位过程;这仍不是对某个技术原因的完整证明。
如果单页也读不清,就换清晰版本,或者只使用能确认的信息。不断要求它“再认真一点”,不会凭空补回模糊的小字。
输入补齐以后,再决定让它做什么
看到了图,还不等于准确读出了每个数。
只想了解图在比较什么,可以请 AI 解释坐标、分组和变化方向;要把数字填进另一张表,最好寻找报告附带的数据表或其他可核对的数据来源。曲线没有标注精确数值时,就不要把目测位置包装成精确数据。
也不必为每份 PDF 都走一遍复杂流程。主要是连续文字、任务只是找某个定义时,先做文字检索就很合适。任务依赖图表,才需要确认视觉内容;扫描页文字缺失,再考虑文字识别或清晰页面输入。选择处理方式,应当跟着问题走。
对读公开报告的人来说,这会改变一个很小的起手动作:不急着把提示词写得更长,先确认解答所需的那部分材料有没有到位。
下次上传带图的 PDF,可以先挑一张与你的问题有关的图,请 AI 说清它画了什么。那份全文总结,等这一页接上以后再要。