ARTICLE · 1296440
AI 编码工具的 Harness 构建指南:从权限沙箱到子 Agent 与 Skills
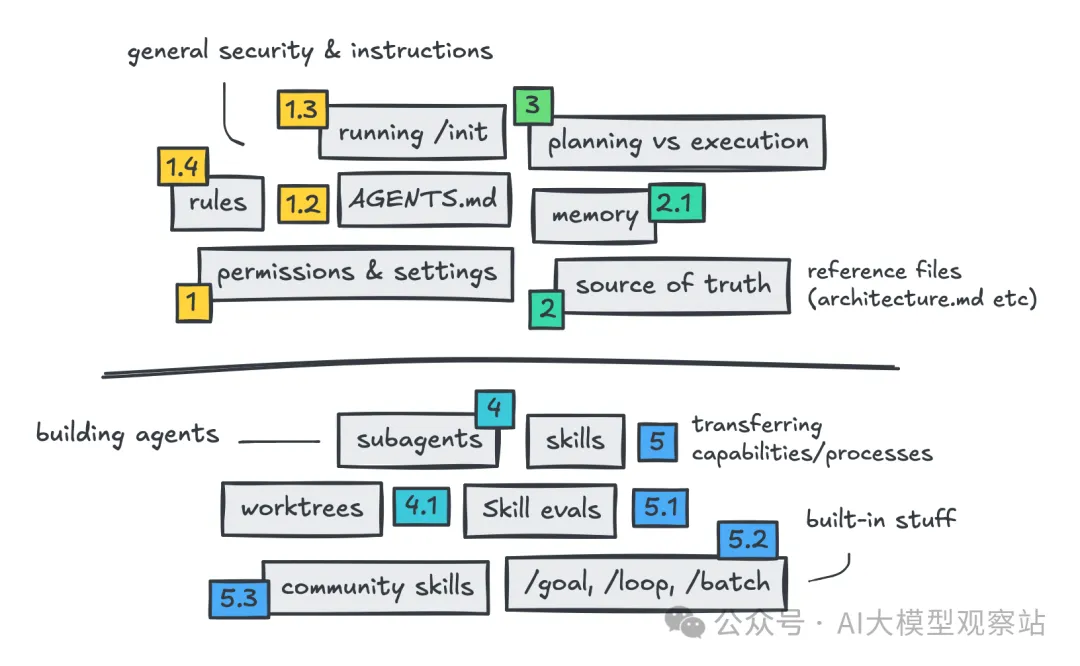
人们正在围绕这些 AI 编码工具构建完整的工作流和系统,这通常被称为扩展 harness。
有些人把它讲得比实际情况更复杂,但其中确实有相当多的知识需要了解。
因此,我认为有必要介绍一些基础内容,例如设置权限与沙箱、编写 AGENTS.md 文件、配置规则与项目的单一事实来源,以及深入了解记忆机制的工作原理。
此外,还会介绍如何构建和运行子 Agent 与 Skills、如何组合它们,以及如何评估它们。
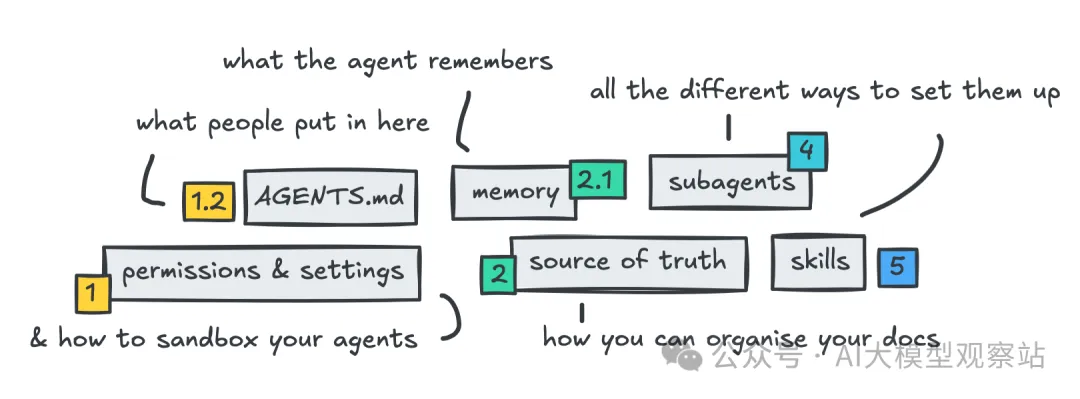
我还会分享一些大型项目的链接,并解析 /loop、/goal 和 /batch 等常见的内置 Skills 与命令。
这绝对是一篇操作指南(同时使用 Codex 和 Claude Code)。但我也会做很多其他事情,例如梳理相关研究、比较不同方法、分享我自己的失败经历,以及质疑其中一些做法是否真的能提升性能。
我会按级别拆分这篇文章,所以你可以跳过已经掌握的内容。由于本文已经很长,我会把一些更偏中级的主题留到以后再讲。
Level 1.0:权限与沙箱
YOLO 模式还是安全模式,取决于你希望这些 Agent 能够访问什么。对于 Claude Code,你需要调整 settings.json 文件;对于 Codex,则需要指定 config.toml 文件。
当你开始使用这些工具并授予访问权限时,你授予的并不只是项目文件夹的访问权限;默认情况下,它可以读取你计算机上的任何位置。
你需要明确规定这些工具可以在什么范围内移动,以及允许读取和编辑哪些内容。这样做很重要,原因之一是你可能不希望这些工具读取 .env 文件或本地密钥。
这些都是基础内容,但如果你刚开始使用,我在这里整理了一份适用于 Claude Code 和 Codex 的样板设置与配置文档。
不过,我们先介绍一下 Claude Code 的工作模式。通常包括 Edit、Ask 和 Auto。目前主要使用的是 Auto,它会执行通过自动安全检查批准的操作(我认为是通过一个分类器完成的)。
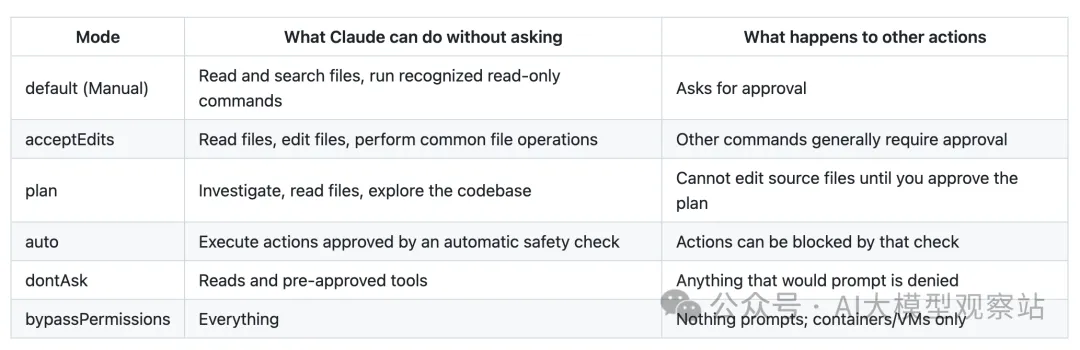
对于 Auto 和 Edit,你仍然需要配置 settings.json 文件,定义具体的 allow、ask 和 deny 列表。你可以在 ~/.claude/settings.json 中创建全局配置,也可以在 .claude/settings.json. 中创建仅适用于项目的配置。
你可以在这里设置通用权限和沙箱。权限决定 Claude 可以执行哪些操作以及使用哪些工具,而沙箱则确保已获准的命令不会越出项目本身的范围。
{
  "permissions": {
    "defaultMode": "acceptEdits",
    "blockReadsOutsideWorkingDirectories": true,
    "allow": [
      "Bash(git add *)",
      "Bash(git commit *)"
    ],
    "ask": [
      "Bash(git push *)",
    ],
    "deny": [
      "Read(//**/.env)",
      ...
    ]
  },
  "sandbox": {
    "enabled": true,
    "failIfUnavailable": true,
    "allowUnsandboxedCommands": false,
    "filesystem": {
      "denyRead": [
        "~/**/.env",
        ...
      ],
      "denyWrite": [
        "~/**/.env",
        ...
      ]
    }
  }
}
启用后,沙箱会拒绝写入,但默认仍允许从任何位置读取,因此它可以导航到任何需要的位置。这就是为什么你可以设置 denyRead 规则。
所以,是的,这意味着如果你没有启用沙箱,我认为它默认就是关闭的。没有人会替你配置这些内容。因此,如果你想确保 Agent 不会触碰某些东西,请务必在开始工作前创建这个文件。
我不想让这篇文章变得过于杂乱,所以完整的 JSON 样板可以在这里找到。
对于 Codex,你需要设置另一个名为 config.toml 的文件。一个全局配置会应用于所有本地 Codex 项目:~/.codex/config.toml
default_permissions = "my-workspace"
approval_policy = "on-request"

[permissions.my-workspace]
extends = ":workspace"

[permissions.my-workspace.filesystem]
":root" = "deny"
":minimal" = "read"
glob_scan_max_depth = 6
"~/.ssh" = "deny"
"~/.aws" = "deny"

...
你也可以在这里找到带注释的完整样板设置。
对于 Claude Code,我们可以为 git commit 和 add 等特定命令指定许可。对于 Codex,我们要么整体允许 git,要么让它在执行前询问(这是默认行为)。
[permissions.my-workspace.filesystem.":workspace_roots"]
".git" = "write"
我总是让 Agent 提交它们完成的工作,这是回退有问题改动的最佳方式。因此,对我来说,我通常希望它能够 add 和 commit,但不能在我不知情的情况下 push 或回退。
为这两个工具都配置完成后,请记得先测试你的配置,再认为配置已经成功。
虽然有人认为这只是基础防护(防止意外泄漏),但它并不总能保护你免受 prompt injection 和其他恶意行为的影响。
此外,它拥有的权限越少,导航过程就越麻烦,这也是这些工具不会预先配置太多限制的原因。
我还应该指出,这些 config 和 settings 文件中可以设置更多内容,例如默认模型、期望的写作风格,以及稍后会讲到的与 Agent 和 Skills 相关的其他设置。
总之,请记得阅读我分享的仓库,了解如何配置 settings 和 configs。确保 Agent 不会触碰你不希望它触碰的内容,是你自己的责任;这些保护并不是开箱即用的。
如果你有更多信息,或者认为我应该调整某些内容,请务必留言。
Level 1.1:主 AGENTS.md
主 AGENTS.md 文件是可选的,但它应该保持简短,用于帮助 Agent 熟悉项目,同时通过引用指向其他更大型的文档。
对于不熟悉主 AGENTS.md 文件的人来说,使用这些 Agent 开发时,通常会有一个始终加载到上下文中的小型主文件。它应该包含帮助 Agent 在项目中正确工作的指令。
现在,你只需要在项目中创建一个同时供 Codex 和 Claude Code 使用的 AGENTS.md 文件即可。该文件应少于 200 行,因为文件越长,占用的上下文越多,Agent 遵循它的可靠性也就越低。
project/
│
├── AGENTS.md # always loaded
├── CLAUDE.md # now optional
我们在这些文档中放置的内容,主要是重要命令、在项目中的工作方式、特殊约定、关键系统所在位置,以及通常不会变化的事项。
对于原则、架构和设计等信息,你应该使用其他文件,并在这里引用它们;稍后我会详细介绍(因此,这个文件更像一个索引)。
下面是我曾经开发过的一款 iOS 应用的 AGENTS.md 文件片段。
# Project instructions

## What this project is
[...] iOS app.

## Commands
- Dev on device: `nvm use 22 && npx expo start --dev-client`
- Rebuild the dev client `nvm use 22 && eas build --profile development --platform ios`
- Typecheck: `nvm use 22 && npx tsc --noEmit`
- Widget/Live Activity layouts: `npm run check:widget` after ANY edit to `src/widgets/`
- Dependency health: `npm run doctor` (expo-doctor).
- Release: `eas build --platform ios --profile production --clear-cache` → TestFlight.

## Important
- Package versions are pinned to a known-good SDK 55 baseline (an iOS 26 crash traced to dependency
drift - `docs/PACKAGE-BASELINE-SDK55.md` has the story and the rollback). Dependency changes go
through the user first.

## How we work in this repo
- Changes land one at a time: build it → typecheck → commit with a what+why message → the user
verifies on device → next change.
- Every distinct change gets its own commit, and notable ones get a `docs/CHANGELOG.md` entry the same day
— `git log` + the changelog read as the story of the app, which is what makes rollbacks surgical.
- change architecture (agreed with the user FIRST - structural
calls are never made unilaterally) → update the implementation → update `docs/ARCHITECTURE.md` → verify
- The standing rules the loop protects (state ownership, local-first, the invariants) live in `docs/PRINCIPLES.md` - check a planned
change against it before building.
- Docs hygiene rides on every commit (a post-commit hook in `.claude/settings.json` injects the
routed checklist - act on it in the same turn). [...]
- Comment budget: lean. Default is no comment - naming and structure carry the what. Comment only a
constraint the code can't show (a native/timing race, an ordering requirement, a standing invariant),

## Project documentation
- `docs/PRINCIPLES.md` - how we build and the rules we don't break (state ownership, local-first,
  invariants, how to approach a new problem).
- `docs/ARCHITECTURE.md` - canonical current-state: screens, stores, proxy API, media identity,
  persistence, canvas patterns.
- `docs/BUGS.md` - the bug register with statuses.
- `docs/CHANGELOG.md` - dated log, newest first; notable changes get an entry.
- `docs/PENDING-FIXES.md` - agreed-but-unbuilt fixes, priority index on top. Check it before touching
  the code an entry names; a shipped fix leaves this file in the same commit.

[...]
我还会写明希望它如何提交工作、应该在哪里记录较大的视觉变更、在哪里报告 bug,以及如何验证工作。也就是说,基本上是在说明我希望它如何处理这个项目。
关键在于,你不应该教 Agent 如何进行正确的软件工程;这个文件应该更多地围绕与你的项目和工作方式直接相关的指令展开。
我上面分享的文件可能并没有遵循最佳约定,它只是我为一个较大型项目编写的文件。
Stride 在 2026 年 9 月对 7,370 个公开 GitHub 仓库进行的分析提供了一些有用证据。他们发现,73.5% 的文件提到了测试、构建或 lint 命令,39.3% 提到了安全或密钥,10.6% 明确禁止泄露密钥。
文件中位数约为 819 个单词、105 行。
他们分析的 AGENTS.md 文件中,提到了测试指令(55.7%)、代码风格和约定(54.3%)、项目结构(54.3%)、Git 和 pull request 流程(47.6%),以及命令(44.0%)。
有趣的是,并不是所有人都使用相同的结构,而且人们通常编写的内容,也不一定与研究建议他们编写的内容一致。
我的 Agent 在这里收集了更多研究,如果你想进一步阅读,可以查看。
不过,本质上还是要让这个文件保持简短,并在使用过程中逐步添加内容。应尽可能精简,同时确保 Agent 在每次会话中都知道如何熟悉和定位项目。
Level 1.2:在项目上运行 /init
值得介绍一下 Claude Code 中的 /init。它会为遗留项目生成一个起始版 CLAUDE.md 文件,但结果可能比预期更混乱。
Claude Code 的 /init 会检查现有仓库,然后为你创建一个初始指令文件。现在它还增加了交互式功能,可以为你推荐 Skills 和 hooks。
如果在已经包含 CLAUDE.md 的项目中再次运行,它会建议具体修改,而不是重新创建文件。
我曾在自己构建过的一个最混乱的项目上尝试过,结果相当糟糕。也许在更整洁的项目上运行会更好。
但坦白说,大多数软件都很混乱。大部分事实都存在于某个人的脑海里,人们只是知道这个文件与另一个文件相连,而那个文件又与其他文件相连;不过,他们也是在与项目和团队合作一段时间后,才在脑海中建立起这种因果模型的。
Agent 会试图跳过这个过程,而这样做会让它有些地方判断正确,有些地方判断错误。不要把这种矛盾记录进文档非常重要,因为之后 Agent 首先就会依据这些文档行动,而你会因为它总是失败却找不到原因而抓狂。
理想情况下,你的事实来源应该经过自己的审核。如果你完全没有能力审核,那还不如不要让 Agent 构建一个质量平庸的版本。
相关研究对此也相当批判。
苏黎世的一篇论文——今年 2 月发布的 Evaluating AGENTS.md——研究了一些问题,例如概述经常重复代码库中已经存在的信息,从而造成冗余。
此外,/init 无法发现仓库中没有体现的产品决策和领域理解。
对于一个干净的项目,只要你有耐心审核它写出的信息,还是值得一试的,因为存在相互矛盾的文档时,很难与 AI Agent 协作。
Level 1.3:如何使用 Rules
如果你希望 Agent 在处理特定文件时加载特定指令,就需要设置 Rules。在这方面,Codex 和 Claude Code 的结构略有不同。
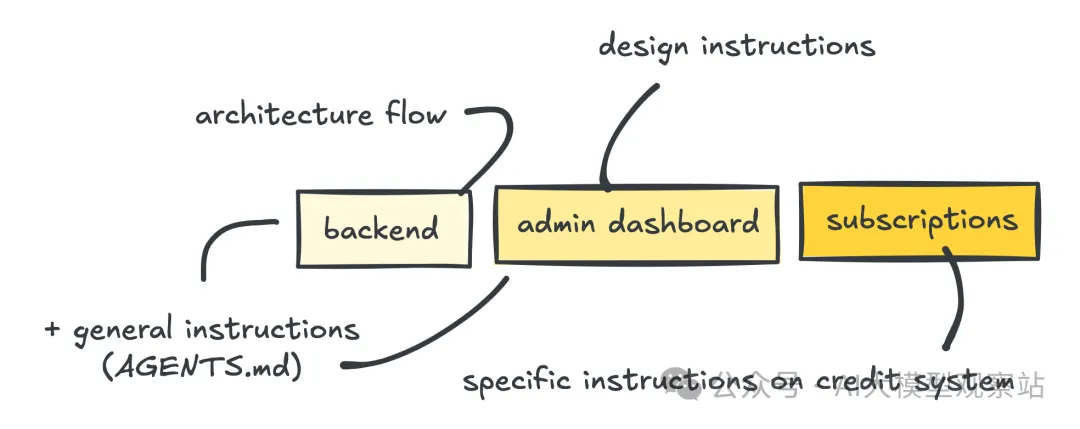
假设你的项目不断增长,一个仓库中包含 frontend、backend 和 billing system,并且每个部分都应该使用不同的工作指令。
这意味着只有处理特定路径时,才应该注入相应上下文。要在 Claude Code 中做到这一点,可以把特定指令文件放在 .claude/rules/ 下。
project/
│
├── AGENTS.md # always loaded
├── CLAUDE.md # now optional
├── .claude/
│   ├── rules/ # specific instructions (Claude)
│       ├── subscriptions.md
│       ├── billing-system.md
│       └── backend.md
然后,每个文件都通过 paths 字段设置 Markdown 规则。
---
paths:
  - "src/subscriptions/**/*.ts"
---

When working on subscriptions remember the rules (whatever they are)
与这里介绍的其他内容一样,你仍然需要进行测试,确保规则会被正确触发。你可以直接让 Agent 读取一个文件,然后询问它相关规则。
对于 Codex,如果你想实现这一点,会稍微麻烦一些:你需要在每个希望规则生效的文件夹中设置一个 AGENTS.md 文件。
project/
│
├── AGENTS.md # always loaded
├── CLAUDE.md # now optional
├── .claude/
│   ├── rules/ # specific instructions (Claude)
│   │  ├── subscriptions.md
│   │  └── audio-pipeline.md
│   └── settings.json
├── .codex/
│   └── config.toml
├── src/
│   ├── audio/
│       ├── AGENTS.md # specific instructions (Codex)
│       └── script.ts
也就是说,如果你希望为 /audio 文件夹注入特定指令,就要在那里放置该文件。
不过存在一个限制:从项目根目录启动 Codex,并不能保证 Agent 之后编辑 src/audio/generation.ts 时,会自动注入 src/audio/AGENTS.md。
我还没有在 Codex 上试过这一点,所以你需要自行测试。也许可以尝试设置 AGENTS.override.md,看看是否有帮助,但在该文件夹中工作时,它会覆盖主 AGENTS.md 文件。
不过,在你马上采用这种方式前,我需要提醒一点:随着文档不断增加,不同 Agent 之间出现配置漂移和过期指令的可能性也会提高。这可能成为一个非常严重的故障模式。
Agent 可能会遵循某条 CLAUDE.md 指令,而该指令引用的是已经不存在的组件或架构。最终结果看起来像是 hallucination,但实际上 Agent 只是在遵循提供给它的上下文。
有一些较小的项目正在处理这个问题,例如 Stemma(用于维护不同编码 Agent 之间的共享指令)和 config-drift-checker(用于理解每个已配置的编码 Agent 可以加载什么、为什么会包含这些内容,以及重复上下文可能产生多少成本)。
至于我自己,我会使用 hooks 清理文档,但让 Agent 如此专注于清理会消耗 token。因此,大家可以根据自己的情况选择。
所以,Rules 可以分离只应针对特定文件夹和路径注入的上下文,从而确保 Agent 在处理项目的特定部分时遵循相应规则。但不断增加文档,也会让清理过期信息变得更加困难。
Level 2:项目的事实来源
你的 docs 文件夹应该存放更长的文档,包括原则、领域模型、架构和决策等知识。这是一种让知识跨多个会话和多名协作者持久保存的方式。
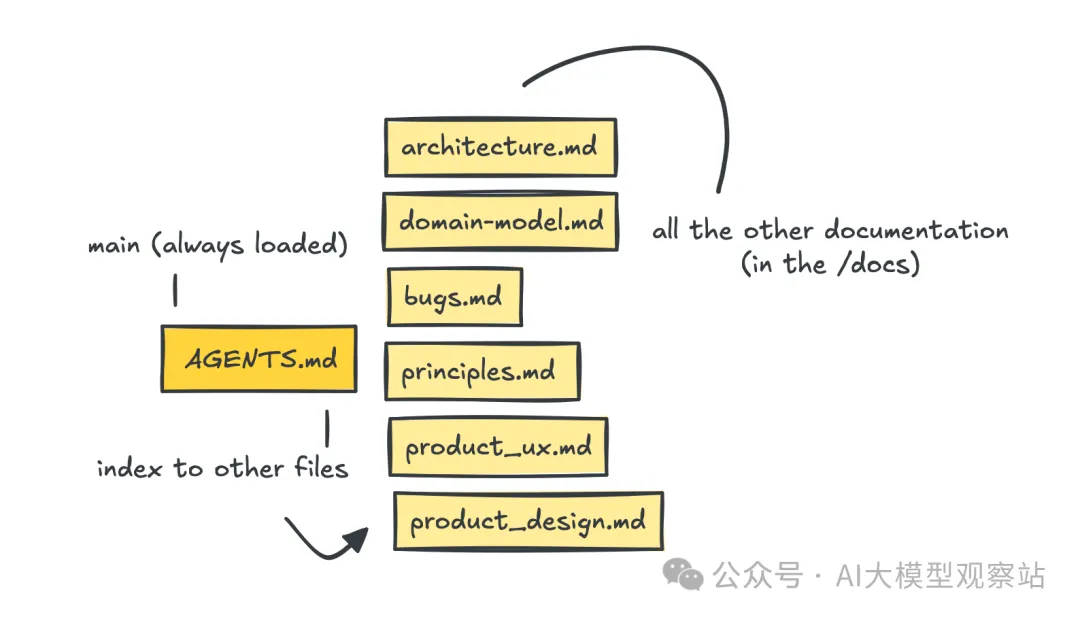
Codex 和 Claude Code 会共享这个文件夹,因此它们都知道应该去哪里查找信息。
事实来源与 Memory 不同(我会在下一节介绍 Memory),因为这个文件夹保存的信息不仅供某个 Agent 使用,而是供项目中的所有协作者使用。
下面是一个整洁的事实来源结构示例。
project/
│
├── AGENTS.md (always loaded)
├── docs/ (loaded on-demand)
│   ├── product.md
│   ├── domain-model.md
│   ├── architecture.md
│   ├── PRINCIPLES.md
│   ├── BUGS.md
│   ├── CHANGELOG.md
│   ├── PENDING-FIXES.md
│   │
│   └── decisions/
│   │   └── 001-character-voice-model.md
│   └── legacy/
│       └── handoff-activity-island-failure-11-11-2026.md
你在这里放什么,取决于项目以及所需的信息量。
我的 Agent 总喜欢把所有东西都塞进这个文件夹,所以我通常得不到上面那样整洁的结构,而是会得到下面这样的东西。
project/
│
└── docs/
    ├── legacy/
    ├── 2026-09-22-apple-subscriptions-integ...
    ├── ACCOUNT_SUPPORT_API.md
    ├── ARCHITECTURE.md
    ├── BUGS.md
    ├── CHANGELOG.md
    ├── CLEANUP.md
    ├── HANDOFF-REPORT-BLOCKED-VIDEO.md
    ├── LIVE-ACTIVITY.md
    ├── local-cache-and-project-load.md
    ├── PACKAGE-BASELINE-SDK55.md
    ├── PENDING-FIXES.md
    ├── POSTMORTEM-LOADING-2026-09-22...
    ├── PRINCIPLES.md
    ├── SKETCH-SYNC.md
    ├── SUBSCRIPTIONS_API.md
    └── VIDEO_ROUTER_DIRECTOR.md
对于某些项目,我会进行清理,并强制它把旧文档移入 legacy 文件夹。
请确保在前面介绍的 AGENTS.md 文件中列出正确的文档。它应该引用你放在 docs 文件夹中的最重要文件,例如架构、领域模型和原则。
# AGENTS.md

[...]

## Project documentation
- `docs/PRINCIPLES.md` - how we build and the rules we don't break (state ownership, local-first,
  invariants, how to approach a new problem).
- `docs/ARCHITECTURE.md` - canonical current-state: screens, stores, proxy API, media identity,
  persistence, canvas patterns.
- `docs/BUGS.md` - the bug register with statuses.
- `docs/CHANGELOG.md` - dated log, newest first; notable changes get an entry.
- `docs/PENDING-FIXES.md` - agreed-but-unbuilt fixes, priority index on top. Check it before touching
  the code an entry names; a shipped fix leaves this file in the same commit.
请记住,AGENTS.md 文件应该充当事实来源的索引。
你还可以尝试在 AGENTS.md 文件中添加如何组织 docs 的指令。我在几个新项目中尝试过这种方法,这样就不会产生那么多杂乱内容。
有些人还会把事实与决策历史分开存放在 docs 中,确保记录 Architecture Decision Records(ADR)。我觉得这很有意思。
project/
│
├── docs/
│   │
│   └── decisions (ADRs)/
│   │   ├── 001-character-voice-model.md
│   │   └── 002-server-entitlements.md
假设你有一个项目,其中一部分内容应该保存在服务器上,而另一部分应该保留在本地。你过去已经和 Agent 一起做出了这些决策,并编写了架构文档来反映它们。
然而,后来某个 Agent 认为把内容保存在本地似乎更高效。架构文档会告诉它不要这么做,而决策记录则会解释原因。
# decisions/002-server-entitlements.md
Status: Accepted
## Decision
Keep subscription entitlements server-authoritative.
## Reasons
- Notifications may arrive out of order.
- Users can have multiple devices.
- Event processing must be idempotent.
## Rejected alternative
Client-maintained credit balances with periodic synchronization.
你可以回溯这些记录,而不必翻查旧会话、Memory 或散落在各处的文档。
对于某些项目,这些决策只存在于我的脑海中,这意味着我可能会因为一遍又一遍地解释同一件事而筋疲力尽,每次都得重新深入问题。保留决策轨迹以及事情为什么以这种方式运作,可能有助于缓解健忘问题。
如果你想确保 Agent 获取了正确信息,并且查找了正确的位置,可以测试 Agent 是否发现了这些文档。可以看看一些独立项目,例如 trigger_tree,它通过跟踪 Agent 发现了哪些本地项目文档来工作。
在结束这一节前,再强调一下之前提过的问题:文档可能会过时。如果这些 Agent 不断添加包含新信息、且彼此矛盾的文档,就会引发问题。
Level 2.1:记忆如何工作
我过去写过有关构建记忆系统的文章,但 Claude Code 的工作方式略有不同,它会把信息写入 .md 文件。主记忆文件很小,而引用文件会随着项目增长而增加。
就像 AGENTS.md 文件和 docs 文件夹一样,主记忆文件也充当索引,并且应该小于 200 行或 25 KB。
主文档随后会引用其他文档以提供更详细的信息。你可以导航到 ~/.claude/projects/<project>/memory/ 找到它们,结构应该类似下面这样:
~/.claude/projects/<project>/memory/
├── MEMORY.md
├── user_role.md
├── feedback_testing.md
└── ...
对于引用文件,Claude 会在认为有需要时读取它们。也可能存在一个负责加载引用文件的分类器(但尚未证实)。
如果项目较小,通常只有一个 MEMORY.md 文件,不会引用太多其他文件。
它与 AGENTS.md 文件的区别在于,这些文件由 Agent 自行写入和更新。你可以使用 /memory 检查它们,并在需要时进行编辑。
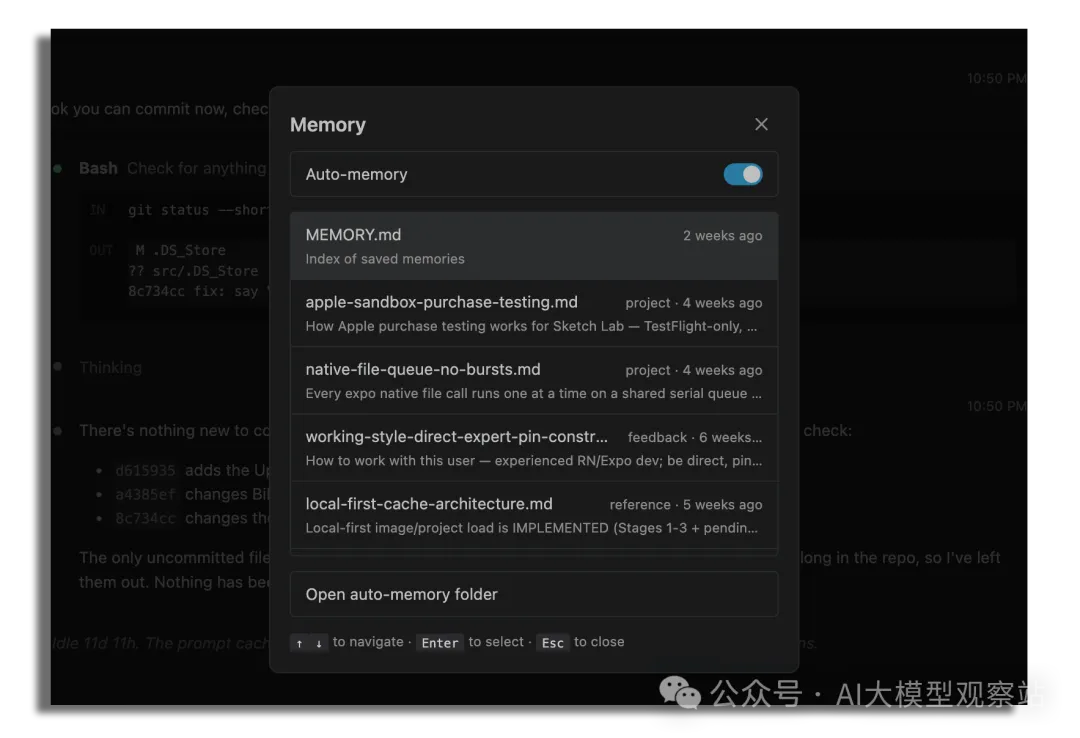
上面展示的是我为一款规模相当大的 iOS 应用留下的混乱内容。它有 36 个引用文件,其中很多信息已经过时。
它本应保存四类记忆:你偏好的工作方式、你对它做出的纠正、从仓库本身无法明显看出的进行中工作或决策,以及相关信息在仓库之外的位置。
你可以看到它们被分类为 project、feedback、reference 等类型。
如果我分析这个项目中的这些文档,大部分内容都与如何和我协作有关,之后是架构规则和不变量、可复用的诊断,以及对其他文件的引用**(**backend API、Expo 配置、代码库地图)。
很多文件都已经过时,而且很久没有编辑过。
我能找到一个 codebase-map.md,其中描述的是 3 月份的应用,现在已经不再相关;一个 designs.md 文件仍然使用 Claude 自行生成的错误信息;还有一个名为 openai_tool_calling.md 的文件,它适用于一个 voice agent,而这个 Agent 在项目第一周就已经被移除了。
所以,这里以及一般文档中一个有趣的主题是:信息可能是错的,而且会一直错下去。
问题不只是 Claude 可能忘记某些事情。它也可能记住错误的信息,在多个会话中持续保留这个错误,然后把它作为未来工作的基础。你会把这种现象体验为健忘。
Session 1 → Claude concludes that the client owns a particular piece of state, even though the server actually owns it. You correct it.
Session 2 → The memory is loaded again, so Claude starts from the incorrect assumption. You correct it, but the old note isn't necessarily replaced.
Session 3 → The amnesia is back again and you have to keep correcting it.
这只是一个需要留意的问题;当你发现它时,希望你能比我处理得更好。
有许多从业者构建的记忆系统,试图用不同方式解决这个问题。
我发现了 Dejavu,它试图阻止过期信息继续影响 Agent;Friday 使用带版本的事实,以便替换先前的决策;Beacon 则试图阻止每次对话中的所有内容——包括 Agent 的错误结论——自动变成永久知识。
需要牢记的关键一点是:并非 Agent 学到的所有内容都应该成为永久事实,也不是每个以前保存的事实都应该永远有效。
对于 Codex,我没有掌握太多关于其记忆系统的信息,也没有进行同等程度的研究。如果你做过相关研究,请留言。
Level 3:与 Agent 一起规划任务
规划意味着共同决定如何处理一个问题,不过也有人认为,规划的意义在于促使 Agent 在问题上停留更长时间,而不是立刻开始动手。
要让 Agent 进行规划,只需使用 /plan 模式。
/plan figure out how to add subscription upgrades without
changing how existing subscriptions work.
关键在于,即便 Agent 的实现能力很强,它仍然可能对自己正在解决的问题做出糟糕决策。
你不能只说下面这样一句话,就期待它能够读懂你的想法。
Add the ability to upgrade a subscription in my iOS app.
你仍然需要回答一些问题:订阅有哪些,应该如何运作?某些功能是否应该设为付费功能,如果是,应该如何实现?如果用户获得了额度,未使用的额度怎么办?降级时会发生什么?升级时又会发生什么?
学会如何与 Agent 一起做好规划需要时间,因为你既不希望说得过于具体,又需要足够具体,让它理解你的意图。
也就是说,对 Agent 说“找出所有边缘情况”没有什么用,你只会得到多到让人不知所措的信息。但如果你问:“如果用户生成了视频但生成失败,我们打算如何确保返还这些额度?”那么你就可以决定具体应该怎么做。
我们可以参考 Anthropic 在 2026 年 6 月进行的一项研究。该研究分析了 400,000 个 Claude Code 会话,发现人类贡献了约 70% 的规划决策(构建什么、采用哪种方法、什么算完成),但只贡献了约 20% 的执行决策(修改哪些文件、编写什么代码、运行哪些命令)。
规划正是 Agent 目前还无法可靠独立完成的部分,通常包括系统架构、项目领域知识、优先级排序等。
他们发现,对任务具备更高专业水平的人更容易成功,而且在 Agent 遇到问题时,更善于恢复。这里的专业知识未必是编码知识,也可以是结果层面的专业知识、产品专业知识等。
例如,理解对账规则的会计师可以非常有效地构建会计软件。对儿童应用 UX 有深入了解的人,也会更擅长构建儿童应用。
我认为,任务层级越高,Agent 所需要的判断能力就越多。
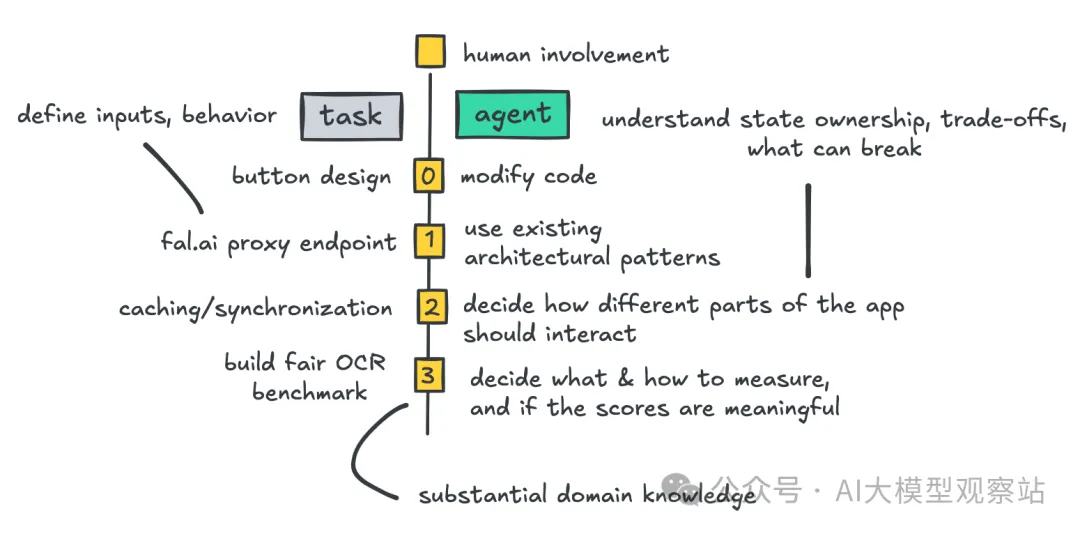
不过,随着时间推移,这种情况可能会发生变化,一些工作可能会上移到新的抽象层级。
这里还应该提到一篇 2026 年 9 月的论文:An Empirical Study of Harness Design for Coding Agents。
他们发现,对于能力较弱的模型,规划可以显著提高成功率。而对于更强的模型,规划通常能减少无效工作和成本,但对准确率影响不大,有时甚至会降低准确率。
OpenAI 和 Anthropic 在 2026 年也都曾警告,不要使用过于复杂的指令、冗长的规划流程,也不要强迫 Agent 遵循它们实际上并不需要的步骤。
因此,不要为了规划而规划。应该在有具体理由时使用规划,例如需要调查不熟悉的代码、解释领域知识、比较不同架构方案、协调复杂变更,或者确定如何验证某项工作。
Level 4:如何构建子 Agent
子 Agent 是拥有自己上下文的 Agent(通常如此)。你可以把它理解为从主 Agent 分支出去,处理一个独立任务。它们通常拥有自己的指令和工具,也可以接收指定的 Skills。
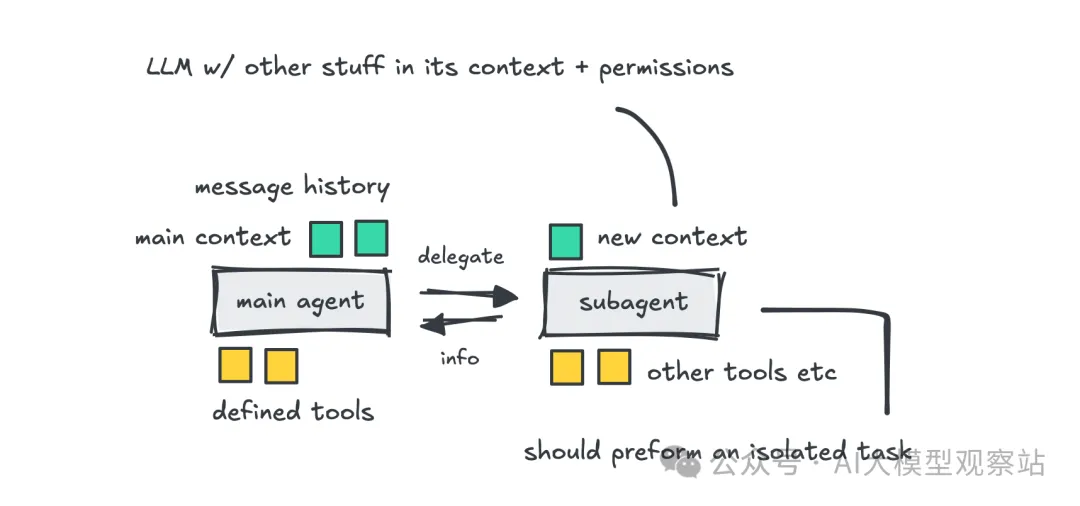
你可以让主 Agent 自行生成 Agent,也可以使用 explore、plan、general-purpose 等内置 Agent,或者构建自己的自定义 Agent 定义。
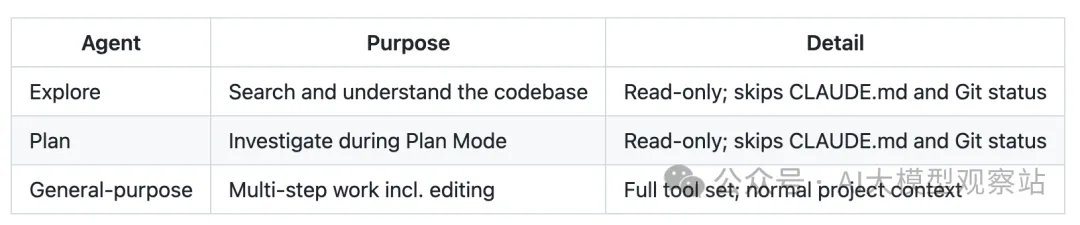
如果你想创建自己的 Agent,需要为 Claude Code 创建 Markdown 文件,为 Codex 创建 toml 文件。
这两个工具存放自定义 Agent 的位置不同,不过我猜它们未来会想办法统一或协调这种差异。
your-project/
├── .claude/
│   └── agents/
│       └── ux-reviewer.md
└── .codex/
    └── agents/
        └── ux-reviewer.toml

~/.claude/
└── agents/
~/.codex/
└── agents/
对于 Claude Code,你至少需要在文件中指定 name 和 description,同时说明 Agent 应该做什么。
---
name: ux-reviewer
description: Review implemented UI for product and UX problems
model: sonnet
effort: high
tools: Read, Grep, Glob, Agent
maxTurns: 12
---
Review the implemented UI against the product model
and the approved requirements.
Find concrete behavior or UX problems.
Return file references and describe the impact.
Do not edit the implementation.
配置中可以添加的内容相当多,我已经把它们全部整理在这里。
例如,上面有 tools,它决定 Agent 可以使用什么。这个 Agent 可以把其他 Agent 作为工具调用,也可以使用 read、grep 和 glob。
如果想进一步限定子 Agent 可用的工具,例如希望 Agent 能使用 git,但不能使用所有 git 命令,就需要在 settings.json 文件中指定。
 .claude/settings.json
{
  "permissions": {
    "allow": ["Bash(git add *)", "Bash(git commit *)", "Bash(npm test)"],
    "deny":  ["Bash(git push *)", "Bash(git merge *)", "Bash(rm *)"]
  }
显然,要让它生效,你还需要先在 tools 中允许 Bash。还要记住,在 settings.json 中设置会让它应用于所有位置。
回到子 Agent 的配置,你还可以设置 omitClaudeMd,从子 Agent 的上下文中移除 CLAUDE.md 文件(或 AGENTS.md 文件)。我读到有人通过这种方法将 Agent 的 token 使用量降低了 88%,但你应该自行尝试。
此外,也值得说明 subagent、subtask 和 fork 之间的区别。
普通 subagent 通常拥有全新的上下文和被委派的任务。subtask 则会获得整个对话的副本,然后把结果返回对话。fork 应该从主 Agent 分离为一个独立的后台会话,之后你可以返回该会话或向它发送消息。
subtask 可能有优势,因为它会共享父级的 prompt cache。对于使用相同上下文的任务,这会比新启动一个 worker 更便宜。
请记住,对于这两个工具,你都可以用自然语言描述自己想要的 Agent,并让编码助手创建相应的配置文件,不需要自己手动完成。
在 Codex 中设置 Agent 的方式有所不同。
name = "ux_reviewer"
description = "Review implemented UI for product and UX problems"
model = "gpt-6-luna"
model_reasoning_effort = "high"
developer_instructions = """
Review the implemented UI against the product
model and approved requirements.
Use the verify-product-ui Skill when applicable.
Return concrete findings with file references.
Do not modify code.
"""
仓库中的这里提供了更多信息。例如,Codex 没有 tools allowlist。自定义 Agent 会继承父会话的工具、沙箱、审批设置、MCP servers 和 Skills。
还记得我们之前为权限创建的 config.toml 吗?对于 Codex,你需要调整项目文件夹中的这个文件。
[agents] # apply to every spawned agent
enabled = true                              # false turns multi-agent off
max_depth = 2                               # nesting; root = 0, default 1
max_concurrent_threads_per_session = 8      # legacy alias: max_threads
default_subagent_model = "gpt-6-luna"
default_subagent_reasoning_effort = "medium"
interrupt_message = true                    # record a model-visible note when an agent turn is interrupted
不过,Codex Agent 文件可以关闭一些功能。
name = "docs_lookup"
description = "Answers questions from documentation only"
model = "gpt-6-luna"
model_reasoning_effort = "low"
developer_instructions = """
Answer from the docs. Do not run commands or edit files.
"""

[features]
shell_tool = false
request_permissions_tool = false
如果你需要更多信息,请使用我放在这里的研究汇总文档。
至于哪些工作能从独立上下文或并行执行中受益,可以是大型代码库调查(需要干净上下文)、针对不同模型查阅多份文档(运行并行子 Agent 收集文档),以及审查实现(可以从独立上下文中受益)等。
例如,假设你发现了一个 bug:生成的媒体被附加到了错误的草图上(我知道这有点缺少上下文)。追踪它需要查看二十个文件、跨服务检查 ID,而且存在多种可能原因。子 Agent 可以负责探索,然后返回文件位置和证据。
我曾经让它们收集实现不同模型所需的文档,并允许主 Agent 自行生成这些子 Agent,但效果并不好。
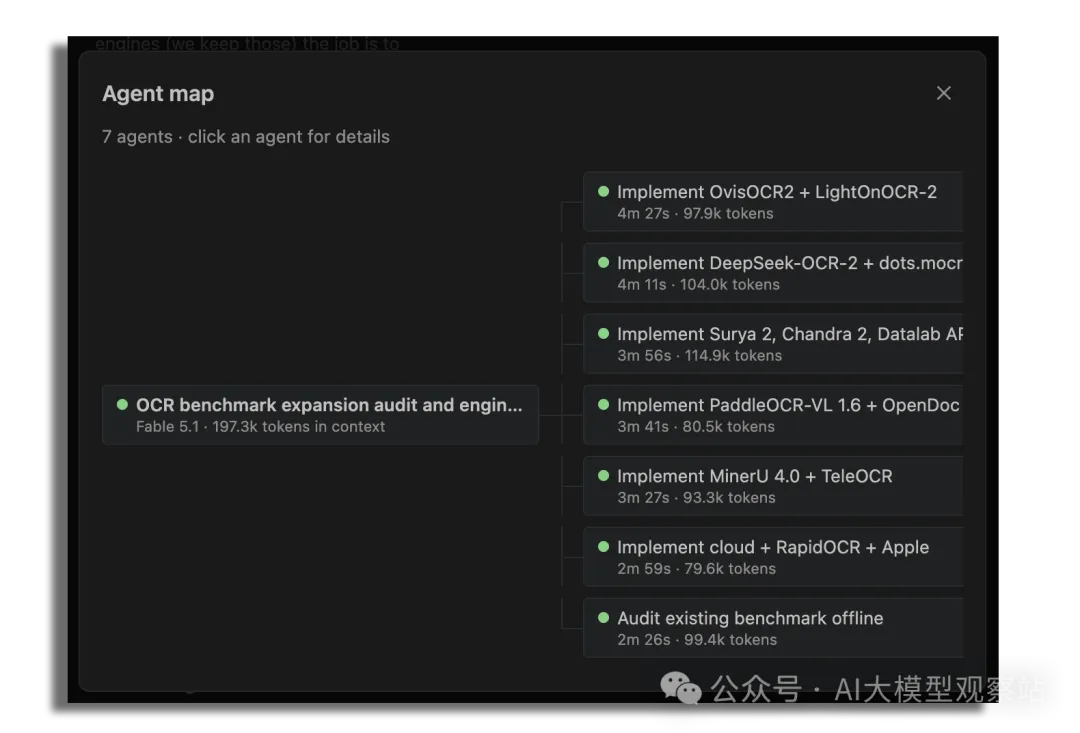
如果我无法亲自明确指定它们,有时它们会把时间花在无用的事情上,浪费大量 token(上面可以看到究竟浪费了多少)。
那么我们需要注意什么?最明显的是 token 成本。Worker 可能会遗漏信息,尤其是在主 Agent 把任务委派给另一个 Agent 时。还可能出现重复工作和更多 token 浪费。更多工作并不一定意味着更高效的工作。
在结束之前,还值得提到 Claude Code 中的 Agent Teams 和 Ultracode(动态工作流),目前它们仍处于实验阶段。
子 Agent 与 Agent Teams 的区别在于,Agent Teams 允许 worker 之间进行更直接的通信。
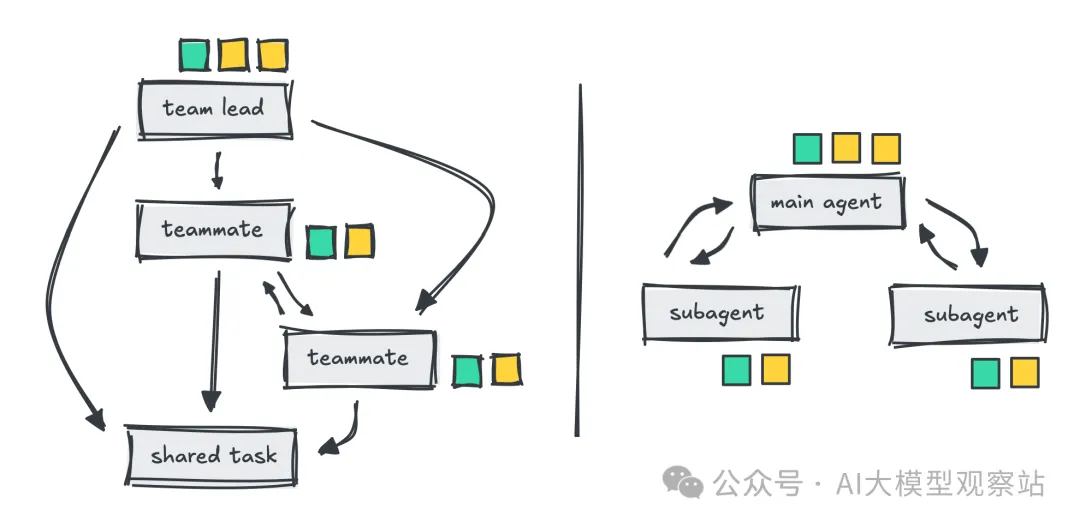
截至 2026 年 10 月,Claude Code Agent Teams 仍然是实验功能,并且默认关闭,但你可以在 settings.json 文件中启用。
{
  "env": {
    "CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS": "1"
  }
}
然后,你可以直接让 Claude 创建一个团队,而不是仅仅要求它并行运行子 Agent。
这个功能仍然存在一些已知限制,包括恢复 team member、共享任务状态和清理方面的问题。
另一方面,Ultracode 是一种通过生成的 JavaScript 脚本自动编排并行子 Agent 的方式。
Claude 不再逐个手动向子 Agent 委派任务,而是生成一个脚本,控制运行哪些 Agent 以及如何合并它们的结果(不过我还没有尝试过,因此暂时无法对它进行猛烈批评)。
你可以直接在设置或代码编辑器中启用它。
该脚本在一个独立 runtime 中执行,位于 Claude 主对话上下文之外。与普通的并行子 Agent 不同,这种工作流还可以用程序化方式管理循环、条件分支、验证轮次和重试。
因此,当任务需要干净上下文或真正的并行工作时,子 Agent 会非常有用。在 Claude Code 和 Codex 中,都可以对它们进行大量配置。不过,它们会消耗 token,而且如果委派失败,整个任务也可能失败。
接下来快速介绍一下 worktree,因为在使用多个子 Agent 时,这也很相关。
Level 4.1:Worktree(面向 vibe coder)
我们来介绍一下 git,以及如何在仓库中使用 worktree 分离工作。重点是如何让多个 Agent 同时处理同一个代码库,以及 Claude Code 可以如何提供帮助。
Git worktree 早在 AI 编码 Agent 出现前就已经存在。只是现在人们开始让多个 Agent 同时编写代码,它才变得更加有趣。
对初学者来说,git 是一种让同一个项目的多个副本保持同步的方法。每个副本都可以独立变化,而 Git 可以把这些改动重新合并在一起,并在两个副本修改了相同内容时提醒你。开发团队通常就是通过这种方式共同处理项目。
Git worktree 是一种维护多个活跃开发环境的方式。
假设你的计算机上有一个代码库副本,你希望隔离开发一个较大的功能,同时保留当前副本用于较小的修复。此时,你可以创建另一个使用新 branch 的 worktree。它会复制工作文件、共享 Git 数据库,并维护自己的 checkout 状态。
Your computer
├── project/
│   ├── Code files (your-branch)
│   └── .git/  ← Shared Git repository
│
├── project-new-design/ - new worktree
    └── Code files (feature/new-design - new branch)
两者一开始拥有相同的已提交代码,但后续改动彼此独立。你现在可以继续分别处理它们。
你可以定期检查 main,并在继续工作时把其中的改动合并到新的独立状态中;如果有人要求推送较小的改动,你也可以在本地切换 branch。
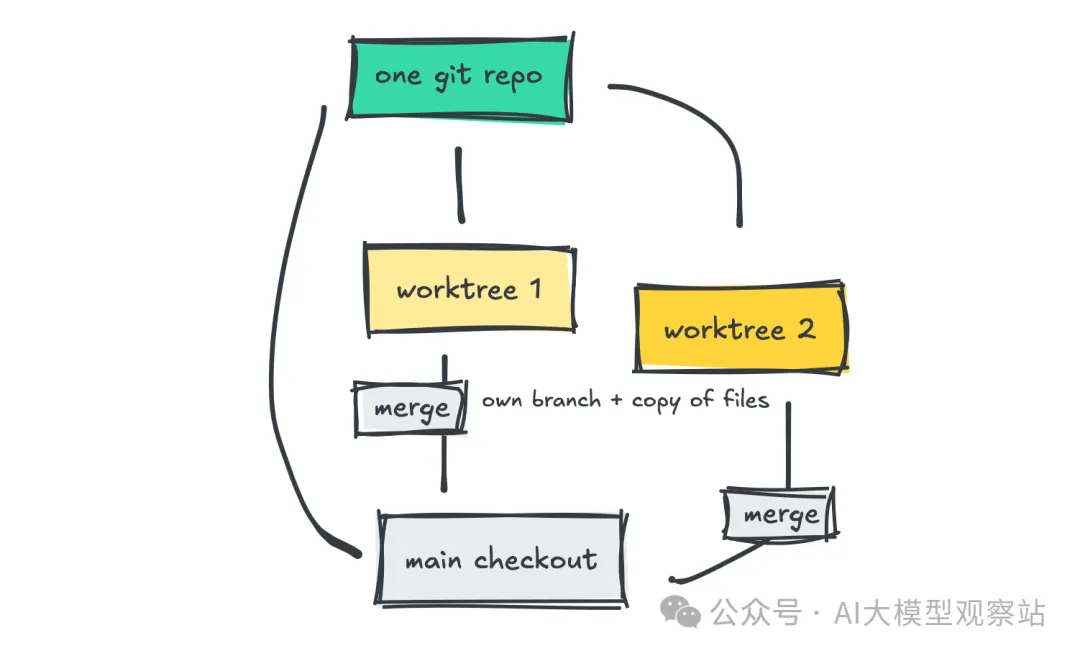
主要优势不只是 worktree 更整洁。它们是由同一个 git 仓库管理的多个工作目录,而不是多个需要你自行同步的 git 仓库。
我之所以介绍这些,是因为在 Claude Code 中创建子 Agent 时,可以选择设置新的 worktree:isolation: worktree。
---
name: builder
description: Implements independent features
model: opus
effort: high
tools: Read, Grep, Glob, Edit, Write, Bash
isolation: worktree
maxTurns: 30
---

You are responsible for implementing a delegated feature.
当这个 Agent 进行构建时,它会在独立 worktree 中工作。完成后,它会返回报告,而它的改动会保留在该 worktree 的一个 branch 上,直到你或主 Agent 将其合并进来。
这很有意思,因为你可以让多个 Agent 并发修改同一个项目,同时让每个 Agent 的文件改动在集成之前彼此分离。
一个会话可以调查 bug,另一个会话实现功能,还有一个会话尝试架构变更。
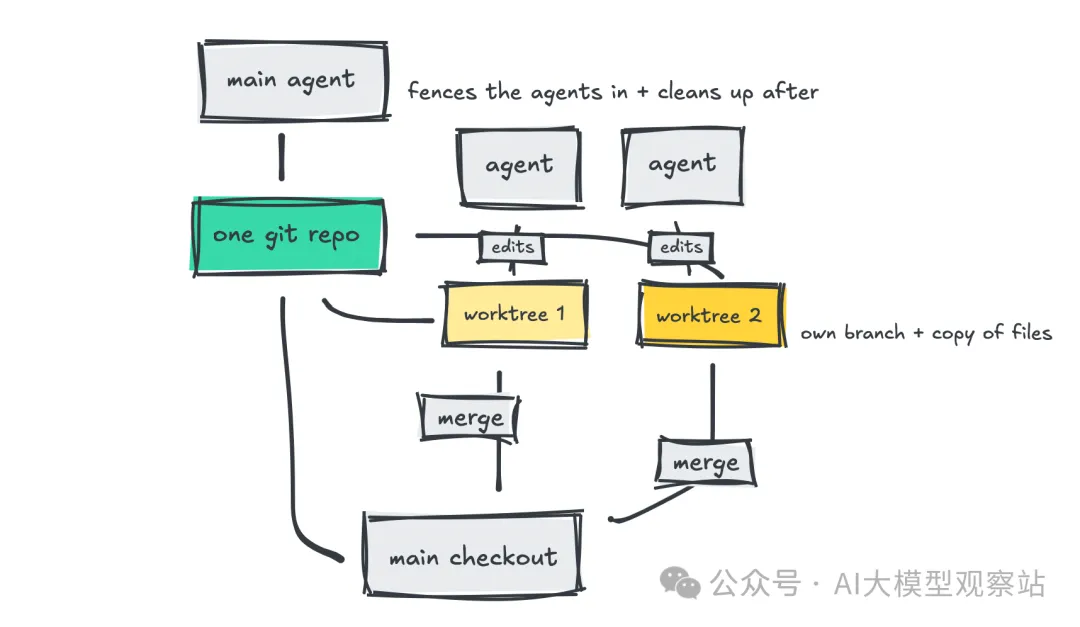
当 Claude Code 替你完成这些工作时,即使底层使用的是 git worktree,它也会决定 worktree 的位置、限制 Agent 的范围,并在完成后进行清理。
要让 Claude 这样做,你可以直接提出要求,也可以像上面那样在 Agent 定义中指定。
需要注意的是,使用 worktree 仍然可能出现问题。即使 Agent 处理的是不同功能,也不意味着它们的实现一定兼容,仍然可能发生冲突。此外,它们的代码可能顺利合并,却引入 bug。
我还应该提到语义冲突。
假设 Agent A 在一个文件中更改了函数的返回类型,而 Agent B 在另一个文件中编写的代码仍然依赖旧类型。由于改动位于不同文件中,它们可能可以正常合并,但运行时会出问题。你需要通过编译、测试、代码审查或其他验证方式来发现这类问题。
还要记住,每个 worktree 的文件仍然会占用磁盘空间。
因此,同时使用多个 Agent 时,了解 worktree 很有帮助。Claude 可以协助你设置和管理整个过程,但它并不是完全不会失败。
Level 5:如何构建 Skills
Skill 是描述如何完成某件事情的蓝图。它可以包含指令、引用、脚本、测试和 evals,然后交给 Agent 执行。我会介绍 Skill 中应该包含什么、如何配置,以及相关研究得出了什么结论。
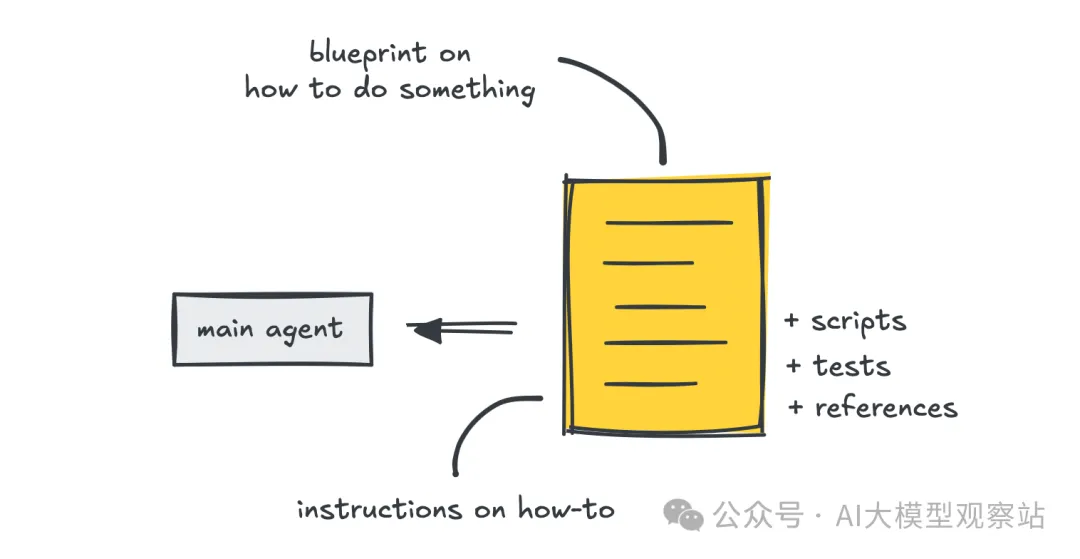
与 Agent 不同,Skill 描述的是做什么以及如何做,而 Agent 关注的是由谁来执行以及具备哪些能力。
因此,如果你需要在独立上下文中运行任务,应该使用子 Agent;如果你想记录一种可重复执行任务的方法,则应该创建 Skill。
重点不是教 Agent 如何进行软件工程,而是教它一个具体流程以及一些不明显的注意事项,这样你就不必每次都重新解释。
反过来也一样:如果其他人已经找到了某个流程,你可以把他们的 Skill 引入自己的工作流,而不必从头构建。
举几个例子:与其告诉 Agent“始终做出好的 UI”,不如记录一个具体的 UI 审查流程,让它遍历应用并收集证据。与其说“处理数据库时要小心”,不如记录一个带脚本和引用的工作流,用于执行经过验证的 migration 和 rollback。
如果 Agent 能验证自己的工作,就更容易让它完全独立工作。因此,Anthropic 报告称,产品验证 Skills 在内部对 Claude 输出质量产生了最明显的可测量影响。一个例子是在浏览器中运行注册和结账流程。
那么,Skill 中理想情况下应该放什么?你可以先定义一个 Markdown 文件,其中包含名称、描述和工作流步骤。
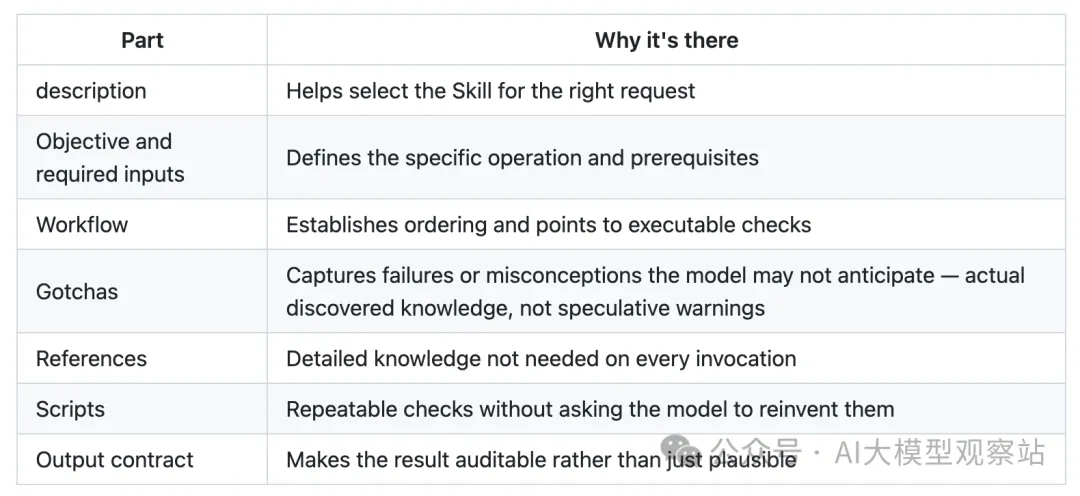
第一步中的描述很重要,因为它会用于发现机制。它决定了 Skill 是否会被选中。
如果一个 database-migration Skill 的描述是“用于数据库、查询、模型或持久化”,它可能会在几乎任何数据库任务中触发。明确提到 schema migration 和 rollout 的描述会有用得多。
至于主指令文件中应该写什么,一个观察结果是:Skill 最有价值的部分似乎是 gotchas 章节,也就是那些并不明显、而且来自真实失败经验的内容。
如果查看 Anthropic 提供的例子,其中包括内部库的意外行为、具有误导性的标识符,以及表面上显示成功但下游实际失败的部署命令。
然后,你可以进一步添加脚本,处理可重复的机械性操作。例如,如果 Agent 反复重新编写 Python 代码来比较数据库 schema,Skill 就可以包含一个已经验证过的 compare_schema.py 脚本。
这些也可以是获取和清洗数据的脚本,或执行流程所需的其他脚本。
理想情况下,Skill 最终应该提供流程和工具,而由模型决定如何将其应用于当前任务。
至于如何同时为 Claude Code 和 Codex 组织 Skills,你需要在两个位置指定它们。
project/
├── .claude/
│   └── skills/
│       └── inference-engineer/  # the real folder
│           ├── SKILL.md
│           ├── references/
│           ├── scripts/
│           ├── tests/
│           └── evals/ # Claude-only, Codex never reads it
└── .agents/
    └── skills/
        └── inference-engineer → ../../.claude/skills/inference-engineer  # symlink
主描述文件是 SKILL.md,你可以在其中放置名称、描述、配置和主指令,而主指令应该引用其他所有内容。
一旦 Skill 正文被加载,它的指令就会在之后的每条新消息中继续保留在上下文里。因此,Anthropic 建议让主文件保持简洁,不超过 500 行;进一步的指令和工作流可以放在 /reference 文件夹中。
正如之前提到的,对于从 API 获取数据之类的代码,可以放在 /scripts 文件夹中。使用 /tests 文件夹存放测试代码是否正常工作的脚本。下一节会介绍 /evals 文件夹,它可以包含用于测试 Skill 行为是否正确的问题。
所以,scripts/ 包含可执行辅助程序,tests/ 验证这些辅助程序,而 evals/ 测试使用该 Skill 的 Agent 是否表现正确。
当你像这样在 Claude 和 Codex 之间共享 Skills 时,请记住它们的能力存在一些差异。
至于如何使用 Claude Code 创建 Skills,你可以手动完成,也可以直接调用 /skill-creator.
/plugin install skill-creator@claude-plugins-official
如果手动创建,则设置 /skills 文件夹,并自行创建 SKILL.md 文件。
---
name: stats-api
description: >
  Investigate statistics using the internal API, including
  following relationships between summary and detail results.
when_to_use: >
  Use for investigations requiring statistics to be traced
  through multiple API responses.
---

Instructions
1. do this
2. then this
Note: this is important too.
Skill 的 header 中可以添加很多配置,我已经把它们全部收集在这里。不过,我们来快速介绍其中一些。
首先,你可以设置希望 Skill 如何被发现。默认情况下,Claude 应该能够发现它,但如果设置了 disable-model-invocation: true,就不会自动发现和调用。
当你希望 Skill 接受特定输入(例如某个标识符)时,也可以添加参数。下面是一个示例。
---
name: investigate-stat
description: Investigate a statistics record through the internal API
argument-hint: "[stat-id]"
arguments:
  - stat_id
disable-model-invocation: true
user-invocable: true
---

Investigate statistics record $stat_id.
Follow the documented drill-down workflow in /references/drill-down.md.
Use the script scripts/get_data.py to get API data, validate in tests/validate_data.py
Report the records and evidence used.
由于这里设置了 disable-model-invocation: true,这个 Skill 应该只能由我调用。运行时,我可以设置要使用的 stat_id。
/investigate-stat id-123
如果需要,你甚至可以添加更多参数。
---
name: investigate-stat
description: Investigate a statistics record through the internal API
argument-hint: "[workflow] [topic] [period]"
arguments:
  - workflow
  - topic
  - period
---

Requested workflow: $workflow
Topic (optional): $topic
Period (optional): $period
If a value is omitted, use the documented default when one
exists, or determine whether clarification is necessary.
然后可以用不同方式调用它。
/stats-api keyword "artificial intelligence" 30d
/stats-api trending
/stats-api content "renewable energy"
我很喜欢添加参数的想法,因为我能想到很多自动化流程可以利用它。
接下来看看 tools。你可以为 Skill 指定允许和禁止的工具。
---
name: inspect-project
description: Investigate project files and report findings
allowed-tools:
  - Read
  - Grep
  - Glob
disallowed-tools:
  - Write
  - Edit
---
请记住,如果 Agent 仍然可以使用不受限制的 Bash 命令,仅禁止 Write 和 Edit 并不能建立完整的只读环境。
注意:Anthropic 还支持细粒度权限,例如 Bash(git status *)。
至于所有这些工具分别意味着什么,可以查看[这个表格](http://Anthropic also supports granular permissions, such as Bash(git status *).)了解更多信息。
对于 Claude Code,我们还可以指定 context:fork。这样不会把 Skill 加载到主 Agent 的上下文,而是使用另一个全新的上下文来运行 Skill。
下面的示例使用前面提到的内置 explore Agent 来运行 Skill。
---
name: review-api
description: Independently investigate an API issue
model: sonnet
effort: high
context: fork
agent: Explore
background: false
---

Investigate the API issue supplied in $ARGUMENTS.
Read relevant code and documentation.
Return findings with evidence.
Do not modify files.
这会让一个子 Agent(内置的 Explore Agent)运行该 Skill。
设置 background: false 后,主 Agent 必须等待子 Agent 使用该 Skill 完成任务。
我们甚至可以让 Skill 只在特定路径上激活(类似前面定义的 Rules)。
例如,假设我们创建了一个 Skill,用来辅助修改订阅实现。我们只希望 Agent 处理与订阅有关的脚本时调用它。你可以在 header 中定义路径。
# SKILL.md
---
name: subscription-review
description: Review changes to the subscription and credit system
paths:
  - "src/payments/**/*.ts"
  - "src/subscriptions/**/*.ts"
---
当 Agent 处理这些路径下的文件时,该 Skill 就会被调用。
还有更多功能,例如在 Skill 中定义 hooks,不过我会等到测试和验证部分再介绍。如果需要进一步研究,请阅读这份文档。
我们也快速介绍一下 Codex。这里同样可以使用内置的 creator。
$skill-creator
它支持创建或更新 Skill。
Codex 在结构和文件方面与 Claude 有一些差异。
.agents/skills/review-schema-migration/
├── SKILL.md              # name, description and instructions
├── agents/
│   └── openai.yaml       # display information, invocation policy and external tool dependencies
├── scripts/              # supporting resources
├── references/
└── assets/
区别在于可选的 agents/openai.yaml 文件,你可以在其中设置配置,例如显示名称、图标、默认 prompt、是否允许隐式调用,以及工具。下面是这个文件的一个示例。
interface:
  display_name: "Stats API Guide"
  short_description: "Investigate statistics using the Safron API"
  icon_small: "./assets/stats-small.svg"
  icon_large: "./assets/stats-large.png"
  brand_color: "#3B82F6"
  default_prompt: "Use this skill to investigate a tech trends"

policy:
  allow_implicit_invocation: true

dependencies:
  tools:
    - type: "mcp"
      value: "techStats"
      description: "Safron MCP server"
      transport: "streamable_http"
      url: "https://example.com/mcp"
Codex 是否需要这个文件?不需要。基础 Codex Skill 只需要 SKILL.md,所以这个文件是可选的。
你还可以在 Codex 的通用 config.toml 文件中添加一些配置。要减少或增加可用 Skills 目录的 token 预算,可以设置 max_context_tokens。如果需要,也可以禁用 Skills。
[skills]
max_context_tokens = 6000

[[skills.config]]
path = "/Users/me/projects/my-app/.agents/skills/old-api/SKILL.md"
enabled = false
[[skills.config]]
path = "/Users/me/projects/my-app/.agents/skills/stats-api/SKILL.md"
enabled = true
对于 Codex 的 SKILL.md 文件,与 Claude 一样,需要设置名称、描述和指令。
---
name: review-schema-migration
description: Review schema migrations for breaking changes
  and deployment risks. Use when creating or reviewing
  a database schema migration.
---
# Instructions
1. Do this first
2. Do this after
3. Do this last
我可能还应该加入一些自己的例子。除了几个验证流程以外,我并不擅长创建大量 Skills。不过,我确实有一个 inference-engineer 附加 Skill,可以分享其中的一些片段。
---
name: modal-inference-engineer
description: Researches, builds, reviews, tunes, and benchmarks efficient GPU inference services on Modal. Use for adding or changing a model, choosing prompts and input splitting, establishing image/token/output limits, selecting GPUs and inference engines, implementing in-container batching, configuring warm replicas and autoscaling, or calculating defensible latency, throughput, and cost per result.
---

# Modal Inference Engineer

Treat the model, preprocessing, inference engine, GPU, batching, and traffic shape as one system. Establish correctness on representative inputs before optimizing throughput.

## Load the relevant references

- For every new model or model-version change, read [model-research.md](references/model-research.md).
- For Modal implementation, batching, GPU selection, or metrics, read [modal-architecture.md](references/modal-architecture.md).
- When working on Qwen3-VL, DeepSeek-OCR, GLM-OCR, MinerU, Marker, or PaddleOCR-VL, also read [ocr-benchmark-case-study.md](references/ocr-benchmark-case-study.md). Treat its numbers as a pinned case study, not universal defaults.

## Follow this workflow

### 1. Research and write a model contract

Use current primary sources: the model author's model card/repository and the selected engine's official support documentation. Use papers for architecture details, not as a substitute for the released inference recipe. Record URLs and access date.

Before implementation, produce a compact contract containing:

| Field | Required finding |
|---|---|
| Artifact | Exact model ID, revision, license, trust-remote-code requirement |
| Task boundary | Whole document, page, crop/element, or multi-stage pipeline |
| Inputs | Supported formats, image count, PDF/multipage behavior, resolution policy |
| Prompt | Exact task prompt, chat template, special tokens, thinking/reasoning flags |
| Context | Hard total context, visual-token/pixel limits, prompt allowance, output cap |
| Output | Text/Markdown/JSON contract, stop behavior, repetition controls |
| Backend | Supported engine and version, required processors/plugins, sync/async API |
| Numeric mode | Supported dtype/quantization and hardware restrictions |
| Batching | Native batch API, continuous batching, dynamic batching, or neither |
| Resources | Weight memory, KV-cache/intermediate memory, CPU/RAM, likely GPU candidates |

If a required fact is undocumented, say so and design a probe. Never invent a prompt or token limit by analogy with a similarly named model.

### 3. Decide whether to split the input

...

### 4. Choose one batching owner

...

### 5. Select the GPU

...

### 6. Build the Modal container

...
它表现尚可,但总是忽略工作流中的某些部分,例如选择正确的 GPU,所以我不得不强制它遵循流程。这个 Skill 是我在运行小型和中型模型经历多次失败后,与一个 Agent 一起创建的。
不过,这个 Skill 能帮助我使用更小的 OCR 模型在一秒内处理图像。如果没有它,Claude 可能会让延迟增加 6–10 倍(不过它仍然很新,所以还需要继续改进)。
那么研究怎么说?我查看了 SWE-Skills-Bench,你也应该看看。它使用 Claude Code 和 Claude Haiku 4.5,对约 565 个仓库级任务和 49 个公开软件工程 Skills 进行了测试。
他们的发现非常有意思:49 个 Skills 中,有 39 个没有改变通过率,7 个提高了通过率,而 3 个降低了通过率。
我们大概可以说,外面存在大量冗余 Skills;仅仅使用了 Skill,并不能说明你变得更高效。
此外,他们还发现了三个有害的 Skill:springboot-tdd(−10.0 个百分点)、linkerd-patterns(−9.1 个百分点)和 django-patterns(−9.1 个百分点)。
例如,在 Linkerd 案例中,没有 Skill 时,Agent 使用了正确的 API 版本;加入 Skill 后,它复制了一个较旧的 API 版本,还添加了一个无关资源。
真正有帮助的 Skill 包括 risk-metrics-calculation,其成功率从 70% 提高到 100%,同时减少了 34.8% 的 token 使用量。tdd-workflow 的表现也不错,使用后成功率从 21.4% 提高到 28.6%,但 token 使用量增加了 78.6%。
我进一步研究了 SkillsBench,想看看哪些领域中的哪些 Skills 确实改善了任务表现。
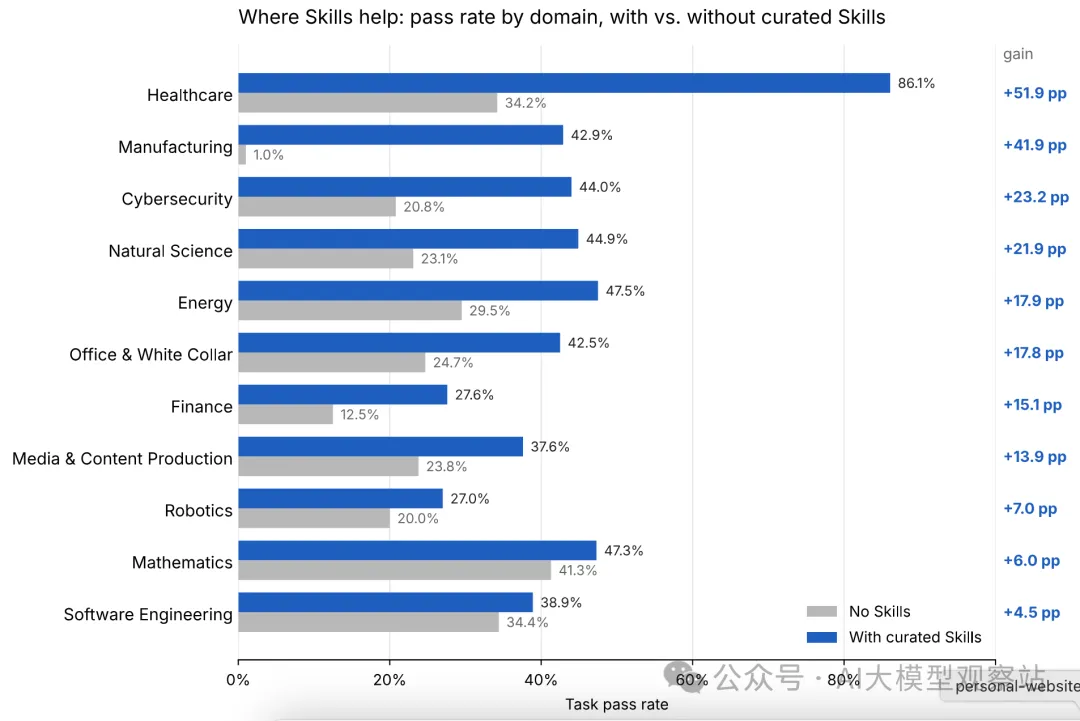
医疗、制造和网络安全领域使用专家 Skills 后都获得了明显提升,而软件工程领域的提升最小。
因此,那些需要专业领域流程、且基础模型不太熟悉的任务,更有可能从额外知识中获益。
不过,也请查看他们 7 月份发布的最新研究,链接在这里。在 7 月的研究中,最强模型在 SWE 任务上提升了约 10 个百分点,而不是只有 4.5 个百分点,但我认为两者使用了不同的测量方式。
这也引出了如何评估 Skills。
Level 5.1:评估 Skills(Claude Code)
Skill 被触发,并不等于 Skill 有效,这也是 evals 现在开始受到重视的原因。我们快速介绍一下如何在 Claude Code 中使用 Skill Creator plugin 完成评估。
你可以测试几件事情,例如 Skill 对正确的任务是否可发现,以及 Skill 本身是否真的带来了收益。
要测试实际性能,需要在全新会话中分别运行启用 Skill 和不启用 Skill 的测试。自 2026 年 3 月以来,Anthropic(即 Claude Code)提供了专门用于评估这种差异的 skill-creator,下面来看看它如何工作。
如果已经安装 Skill Creator,就不需要自行编写任何测试。它可以提出测试 prompt、正面和负面触发示例,以及预期结果。
Evaluate the stats-api Skill using Skill Creator. Review the cases and expected behavior with me, then run fresh evaluations with and without the Skill. Grade the actual results, and show the output comparison, failures and token costs.
然后你需要审核这些内容,尤其是涉及你的领域知识时。
首先创建的文件是 evals.json,其中包含任务 prompt 和预期输出。它会与其他内容一起放在 Skill 文件夹中。
stats-api/
├── SKILL.md
├── references/
├── scripts/
├── tests/
└── evals/
    ├── evals.json # talking about this one
它应该类似下面这样。
{
  "skill_name": "stats-api",
  "evals": [
    {
      "id": 1,
      "prompt": "Investigate why keyword traffic for 'renewable energy' dropped last month.",
      "expected_output": "A traced investigation across the summary and detail endpoints, with the records and evidence used.",
      "files": []
    }
  ]
}
如果测试需要输入文件,例如 Agent 应该使用的数据集,该文件应放入 evals/files/。
└── evals/
    ├── evals.json
    └── files/
        └── sample_dataset.json
对于每个测试用例,它会同时启动两个子 Agent:一个使用 Skill,另一个不使用。两者接收相同的 prompt,并从干净的上下文开始。
如果你是在改进一个已经存在的 Skill,baseline 就是旧版本。它会在编辑前创建 Skill 快照,并基于该快照运行 baseline。
之后,你会看到一个 /workspace 文件夹出现。它是位于 Skill 旁边的独立文件夹,因此运行输出不会进入 Skill 本身,并且会在运行过程中创建。
stats-api/
stats-api-workspace/              # created now
└── iteration-1/
    └── keyword-drop/             # one folder per test case, named after what it tests
        ├── eval_metadata.json    # the prompt + expectations for this case
        ├── with_skill/
        │   └── outputs/          # what the agent produced
        └── without_skill/
            └── outputs/
每次运行结束后,它会保存 token 数量和耗时。当所有运行完成后,一个 grader Agent 会读取每份输出、检查每项预期,并把结果保存在输出旁边。
结构应该类似下面这样。
stats-api-workspace/
└── iteration-1/
    ├── keyword-drop/
    │   ├── eval_metadata.json
    │   ├── with_skill/
    │   │   ├── outputs/
    │   │   ├── timing.json       # tokens, duration
    │   │   └── grading.json      # each expectation: text, passed, evidence
    │   └── without_skill/
    │       ├── outputs/
    │       ├── timing.json
    │       └── grading.json
    ├── benchmark.json            # pass rate, time, tokens with vs without
    └── benchmark.md
根据你的反馈,它会重写 Skill,然后可以把所有测试用例重新运行到 iteration-2/,依此类推。
上面描述的第一个 eval 是测试 Skill 是否真的有帮助,但正如之前提到的,你还可以测试它是否会在正确的场景中被选中。
这会使用一个单独文件,Skill Creator 创建 Skill 后应该会主动建议创建它。该文件名为 eval_set.json。
[
  { "query": "Investigate why keyword traffic for 'renewable energy' dropped last month.", "should_trigger": true },
  { "query": "Fix the failing unit test in api_client.py.", "should_trigger": false }
]
当它在后台运行优化循环时,会对每个 query 尝试三次,以获得可靠的触发率;然后让 Claude 根据失败情况提出更好的描述,并重新测试。
我应该进一步测试这个过程,向你展示它实际是什么样子,因为我喜欢 benchmark,也喜欢数据(现在正在进行一个更大型的 OCR 评估)。
总之,现在你不应该只是创建 Skill,还应该尝试评估它。使用 Claude 的能力,你可以测试 Skill 的可发现性以及 Skill 本身的性能。
接下来介绍一些流行的内置 Skills 和命令,这篇入门文章也必须涵盖它们。
Level 5.2:/loop、/goal 和 /batch
这些工具开箱即用地提供了许多内置 Skills 和命令,我至少想介绍其中三个值得了解的功能。下面会介绍如何调度任务、让 Agent 专注于目标,以及使用并行子 Agent 运行脚本。
首先是 /loop。它是一个 Skill,用于调度在本地 Claude Code 会话中运行的周期性工作(对技术人员来说,本质上就是普通的 cron job)。
你可以像这样调度一个 prompt:/loop 5m check the deploy;也可以让 Agent 自行选择间隔和迭代方式:/loop check CI and address any new review comments;或者只运行 /loop。
如果只运行 /loop,应该定义一个 loop.md 文件,并把 prompt 写在其中。
动态选择间隔这点很有意思。Claude 会评估观察到的情况,并选择何时再次运行,间隔在 1 分钟到 1 小时之间,然后根据发现的内容重复这个过程。
需要理解的是,Claude 只会在每次迭代之后获取信息,这并不是持续的自主推理。
你也可以把 Skill 与 loop 结合使用,只要 Claude 被允许自行调用该 Skill。例如:/loop 20m /review-pr 1234 或 /loop 30m /slack-feedback。
我前面还提到了 .claude/loop.md 文件,你可以在其中设置默认维护工作流。当你调用 /loop 而不提供自定义 prompt 时,Claude 会使用这个文件。
# .claude/loop.md
Check the pull request associated with the current branch.
Use the review-pr Skill to inspect new review comments and failing CI checks.
Address actionable issues and verify changes.
If there is nothing new, report that no action is needed.
Do not push changes without authorization.
一个明显的限制是,loop 需要一个持续运行的 Claude Code 会话,而且会在七天后过期。作为替代,你可以通过 /schedule 使用云端版本。
每次定时执行都会启动一个新的云端会话、克隆选定的 GitHub 仓库,并可以调用已提交到该仓库中的 Skills。
区别在于每次都会使用全新会话,而且不能每 5 分钟运行一次(我认为最短间隔是一小时)。
云端任务还可以响应 GitHub 事件或 API 调用,这可能比反复检查是否发生了某件事情更有用。
显然,/loop 并不等于 loop engineering。要做到后者,你需要建立独立验证、可靠的进度跟踪和良好的停止条件,因此这个话题要留到以后再讲。
接下来是 /goal,它非常值得了解。它更像一个内置命令,而不是 Skill。运行 /goal 与运行 /plan 不同:它不关注如何做,而是关注结果或目标。
如果你使用过 Agent,就会知道它们可能仍然记得最初目标,却越来越沉迷于解决错误的问题。你提出需求后,它理解了你想要什么,但之后会偏离方向,去做你不希望它做的事情。有点像钻进兔子洞。
我在自己的笔记中把这种现象称为目标层级坍塌(某个下级任务逐渐取代了更高层级目标),但不确定研究领域是否使用相同术语。
不过,理解这个问题有助于理解 /goal 实际能够改善什么。它应该帮助 Agent 专注于特定目标,而不是偏离主题。
要运行 /goal(Claude Code 和 Codex 都支持),你应该定义可观察的成功标准、约束和停止条件。
/goal Reduce p95 checkout latency below 120 ms on the checkout benchmark while keeping the correctness suite green.
我曾经尝试过命令 /goal examine this AI benchmark and establish if it is fair,然后让计算机一直运行。它运行了 5 个小时,最终钻进了兔子洞。
这是一个糟糕的 goal prompt。它太宽泛了,无法定义“公平”是什么意思,也无法判断我所认为的“公平”应该如何排序。
所以,越具体越好,而且较小的任务显然更理想。
至于它如何工作:每轮结束后,一个较小的模型会评估条件是已经满足、尚未满足,还是不可能满足。之后,Claude 或 Codex 可以在没有新的人类 prompt 的情况下继续工作。
因此,它是一种执行控制机制,但不能独立保证目标确实已经实现。它会判断对话中已经呈现的证据;如果 Agent 说了不真实的内容,评估器不会自动发现。
所以,这在很大程度上取决于是否提供了可信证据。请务必了解 reward hacking;如果你想进一步学习,也可以阅读《SpecBench: Measuring Reward Hacking in Long-Horizon Coding Agents》。
如果加入某种确定性验证,效果应该会有所改善。
最后,我想介绍 /batch,它是一个 Skill。它用于大规模并行执行,并结合了前面介绍过的子 Agent 和 worktree。
文档中的示例是代码迁移。
/batch migrate src/ from JavaScript to TypeScript
根据文档,这个工作流应该把工作拆分成 5 到 30 个独立单元,并展示计划。然后,它会针对每个单元,在隔离的 worktree 中生成一个后台子 Agent。每个子 Agent 实现自己的单元、运行测试并发布改动。
如果 worker 对文件的所有权可以清晰分离,这会很有用,但它们仍然可能做出彼此矛盾的选择(正如 worktree 一节中提到的)。
我还没有试过 /batch,但我认为它很好地展示了如何混合使用 Skill、子 Agent 和 worktree。不过,对于这个用例,如果迁移中的各部分高度耦合,那么即使文件看起来足够独立,可以采用这种方法,顺序实现可能仍然更容易。
接下来看看社区 Skills、人们如何评价它们、最流行的内容,以及在哪里可以找到它们。
Level 5.3:社区 Skills
Skill 的概念去年才出现,但现在已经围绕 Claude Code、Codex 和其他编码 Agent 形成了相当庞大的生态系统。我会介绍如何找到最流行的 Skills,也会讨论它们是否有帮助,以及其中涉及的风险。
如果你正在开发一个编码项目,可以寻找一个 Skill 来提供帮助。
例如,如果你正在开发 iOS 应用,就需要为 Agent 提供某种验证自身工作的方法(这一点非常重要)。你可以查看 XcodeBuildMCP 及其 Skill。
如果你在设计 iOS 应用的 Activity Island 时遇到困难,可以试试这个 ActivityKit Skill。补充一点背景:我们构建它时,Claude Fable 在这方面遇到了很大困难。我当时不知道存在相应 Skill,所以实现花费了不少时间。
如今,这个 Skills 生态系统已经相当庞大。Vercel 在 2026 年 9 月 25 日发布的报告中指出,截至 2026 年 8 月,registry 中有 100 万个 Skills,记录的安装次数达到 2.8 亿次。
不过,安装活动高度集中:所有安装中有 62% 来自排名前 0.04% 的 Skills(375 个),另有 32% 来自排名前 1.16% 的 Skills。据报道,该数据集中近一半的 Skills 只被安装过一次。
你可以查看 skills.sh 上的排行榜,并测试其中一些 Skills。
至于在哪里寻找 Skills,可以查看 Anthropic 的官方 Skills、ComposioHQ 的合集,以及 VoltAgent 的合集:这里、这里和这里。
从一些 Reddit 讨论中可以得到一个有用的观察:许多开发者仍然通过 GitHub 和 Reddit 发现 Skills,而不是通过 marketplace。
至于值得查看的社区 Skills,可以看看 mattpocock/skills 和 emilkowalski/skills。
我本该对 Skills 更着迷一些,但一直没有这样的需求。我通常只在需要某个东西时才去寻找,所以测试过的 Skills 并不多。
我知道的包括 JuliusBrussee/caveman(应该可以减少不必要的响应)、DietrichGebert/ponytail(应该可以防止生成不必要的代码),以及 obra/superpowers。
不过,我听到的关于 superpowers 的评价褒贬不一。有人认为,额外流程消耗了过多 token,而且重复了较新模型已经具备的能力。
那么,缺点是什么?
前面已经提到,仅仅存在一个 Skill,并不意味着它会表现良好。此外,随着模型能力提高,社区 Skills 可能会变得冗余。你已经看到了前面的研究:软件工程领域的提升最小。这些模型独立工作时本来就表现得相当不错。
安装量和 GitHub star 数也不是有效性指标。还记得我之前提到的 SWE-Skills-Bench 研究吗?他们使用的 Skills 都非常流行,但其中大多数并没有真正改变结果,有时甚至比完全不使用 Skill 更差。
不过,最大的问题与安全有关,因为安装 Skill 等同于安装不受信任的指令和代码。这并不是一个假设性问题。
我们可以看看来自 Snyk 和 Nvidia 的两项研究。Snyk 检查了 3,984 个 Skills,发现其中 76 个具有恶意行为,而 13.4% 至少包含一个 critical 级别的安全问题。
Nvidia 分析了 31,132 个 Skills,发现 5.2% 存在恶意意图迹象,26.1% 包含漏洞。他们检查了 prompt injection、数据外泄和不安全依赖等问题。
因此,在安装任何内容前,请先查看 Snyk Skill Inspector 和 NVIDIA SkillSpector。
文章已经很长了,就在这里收尾吧。
这篇文章最终比我预想的长得多。
我仍然需要介绍如何编写测试、设置 hooks、更多关于 evals 的内容、MCP 与工具、compaction、handoff、更多关于 goal 和应对上下文限制的内容、loop engineering,以及如何理解 token 都花在了哪里。
所以,如果你也希望我发布第二部分,请点赞、评论并关注,我会在几周后发布。
至于如何正确使用这些工具,当有人说自己已经完全掌握时,不要轻信。我们所有人都在边做边学。但如果你确实要听取建议,请听那些真正构建过可用软件的人。