ARTICLE · 1302722
给AI气候模型出一张“不能作弊”的考卷:ClimateBench v2.0详解
导语
过去几年,AI天气预报模型迅速进入业务运行,越来越多团队开始尝试用AI模拟几十年尺度的气候。问题随之而来:一个AI模型能不能用来回答“2050年某地会变暖多少、降水会怎么变”?靠什么判断?[1]
2026年10月3日,来自斯克里普斯海洋研究所、NASA戈达德空间研究所、美国国家大气研究中心、英国气象局、谷歌、英伟达、艾伦人工智能研究所等机构的30多位研究者在arXiv上发布预印本ClimateBench v2.0,提出一套同时适用于物理模型、数据驱动模型和混合模型的气候模型评测协议。论文由加州大学圣迭戈分校的Duncan Watson-Parris牵头,作者还包括Gavin Schmidt、Tapio Schneider、Chris Bretherton、Veronika Eyring等气候模拟领域的知名学者。该文尚未经过同行评议。[2]
一、从v1到v2:考的不再是“模仿”
2022年发表的ClimateBench v1.0针对的是“模拟器”:机器学习模型学习一个地球系统模式的输入输出关系,给定二氧化碳、甲烷和气溶胶的排放或浓度,预测年平均的温度、日较差和降水分布。它的意义在于让统计学家和机器学习研究者方便地进入这一领域。[3]
但v2的作者指出,模拟器只能在“母模型”的范围内插值,既无法纠正母模型的偏差,也无法外推到母模型没有模拟过的气候。新一代AI模型直接学习观测和再分析数据,自己生成气候,评测的标准答案就必须换成真实观测。[2]
论文抓住了一个时间窗口:CMIP6的历史模拟截止到2014年,2015年以来的十年观测,既没有被CMIP6模型拿来调参,也可以要求AI模型不用于训练。这十年就成了天然的“考场”。[2]
二、考什么:一个具体的问题
v2把核心任务定得很具体:在一条合理的排放路径(SSP2-4.5)下,2050年相对1995—2014年,区域气温和降水会变化多少?[2]
参评模型需要按统一的强迫数据运行一组标准实验,包括工业化前控制试验、历史试验、二氧化碳浓度突增4倍试验、大气模式比较试验和古气候试验;每个实验至少3个集合成员,最好10个;输出统一插值到约1°的网格。数据驱动模型的训练数据必须截止到2014年。[2]
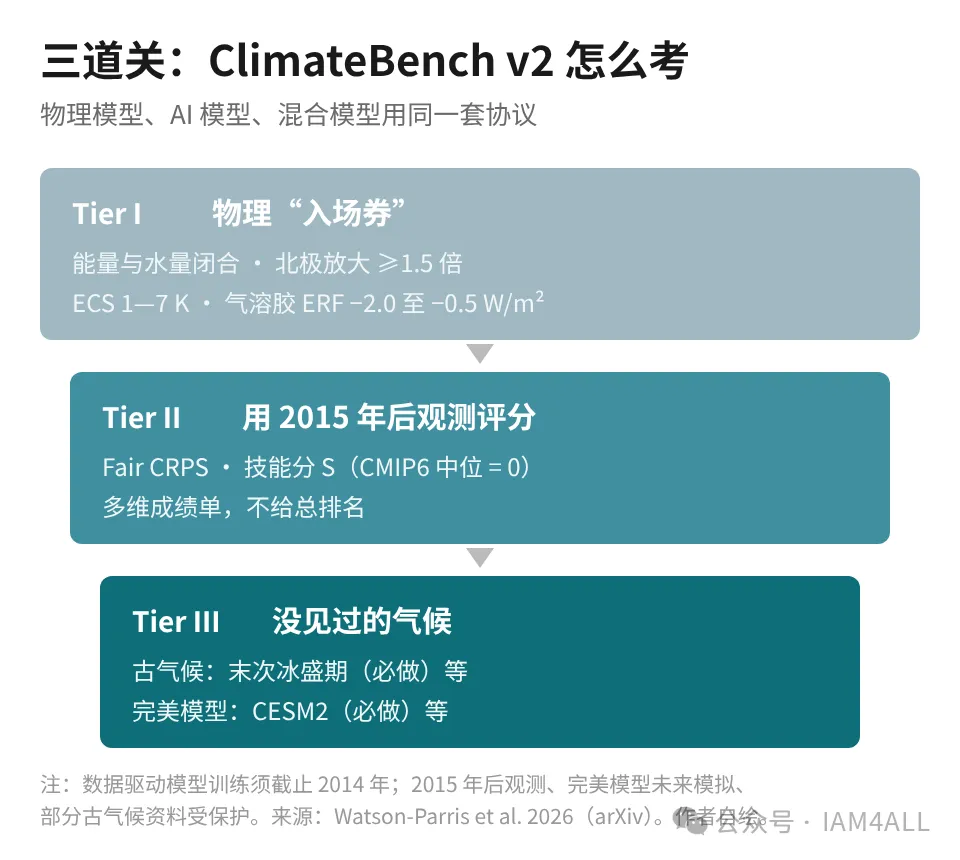
图1 ClimateBench v2 的三道关
三、第一关:物理“入场券”
第一层(Tier I)是入门门槛,检查模型是否满足基本的物理规律。例如:工业化前控制试验中,大气顶能量收支不能有明显漂移;地表水量收支要基本闭合;北极增暖至少是全球平均的1.5倍;陆地增暖要快于海洋;平衡气候敏感度(ECS)要在1—7 K之间;2015年气溶胶的有效辐射强迫要在−2.0至−0.5 W/m²之间;ENSO要有2—7年的周期和合理的遥相关。[2]
这些门槛设得很宽。以ECS为例,IPCC第六次评估报告的“很可能”范围是2.0—5.0 K,而入门门槛是1—7 K,目的是筛掉明显不物理的模型,而不是替代后续评分。[2]
一个有意思的发现是,现有的CMIP6模型本身也不容易“交齐作业”:在作者检查的60个CMIP6模型中,只有7个提供了全部所需的输出。[2]
四、第二关:用2015年后的观测打分
第二层(Tier II)是核心评分。2015年之后的所有观测都只用于测试,包括HadCRUT5、GISTEMP、Berkeley Earth等温度数据集,GPCP、IMERG等降水数据集,以及CERES的大气顶辐射数据。[2]
评分采用概率指标“公平连续分级概率评分”(Fair CRPS),衡量的不只是平均值准不准,还包括集合预报给出的不确定性范围是否合理。结果以“技能分”S表示:S=0代表与CMIP6中位模型相当,S=1代表完美,负值代表比中位模型差。论文还设置了两个基准:一是1985—2014年的气候态(相当于“什么都不预测”),二是用两层能量平衡模型加CMIP6平均空间型的“模式缩放”模拟器。[2]
作者用24个CMIP6模型做了示例评分。在2米气温上,各模型的S值从−2.6到+0.7不等;气候态基准约为−1.5至−1.8;而简单的模式缩放基准约为+0.3至+0.4,好于CMIP6中位模型。这说明,在全球变暖主导的指标上,复杂并不必然意味着更准。[2]
另一个发现值得关注:所有CMIP6模型都把2015—2024年地球能量失衡的增幅低估了约一半。这与2025年发表在《AGU Advances》上的一项研究一致:卫星观测显示,地球能量失衡的增长速度接近模式预期的两倍。[2,4,5]
论文刻意不给出单一的总排名,而是给出按变量划分的“成绩单”,并把样本外和样本内的结果分开标注。作者的考虑是,不同用户关心的变量不同,单一排名容易误导。[2]
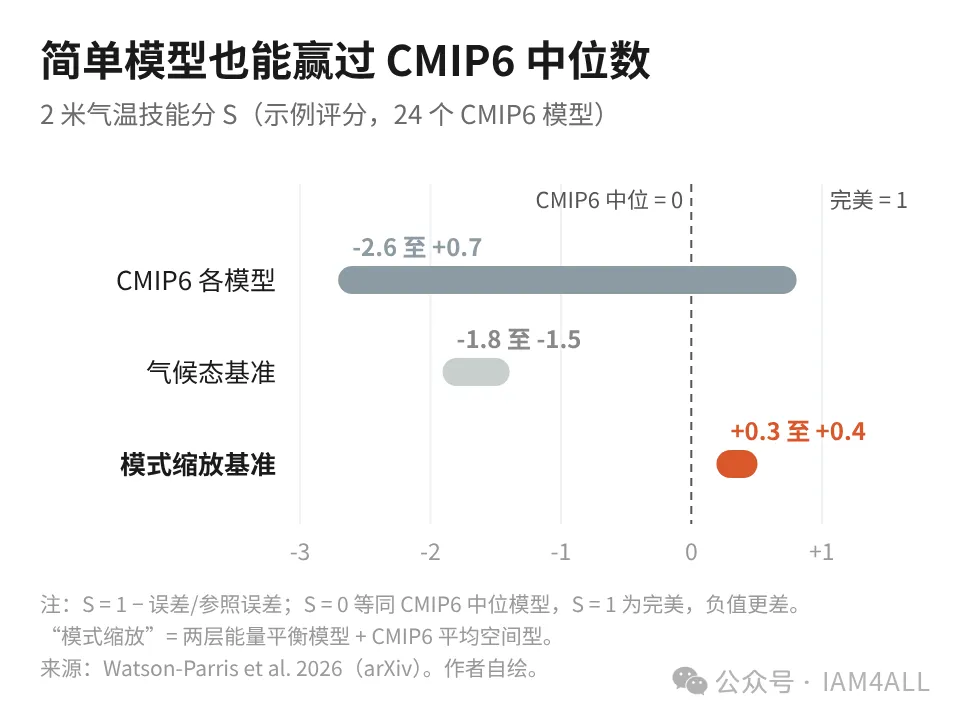
图2 示例评分:2 米气温技能分
五、第三关:没见过的气候
第三层(Tier III)考的是外推能力,也就是模型面对训练数据之外的气候时会不会“露馅”。
一是古气候。末次冰盛期(约2.1万年前,全球比现在冷约5—7 K,二氧化碳约190 ppm)是必做项,可以约束气候敏感度的高值尾部;末次间冰期(约12.7万年前)和全新世中期(约6000年前,北非夏季降水应增加至少0.5 mm/天)是可选项。[2]
二是“完美模型”实验。让AI模型用某个地球系统模式的历史模拟训练,再去预测这个模式在SSP2-4.5下的未来。必做的是气候敏感度较高的CESM2(ECS约5.2 K),可选的是MPI-ESM(约3.63 K)和GISS ModelE2(约2.31 K)。这样可以检验AI模型能否学到“气候对强迫的响应”,而不只是记住历史。[2]
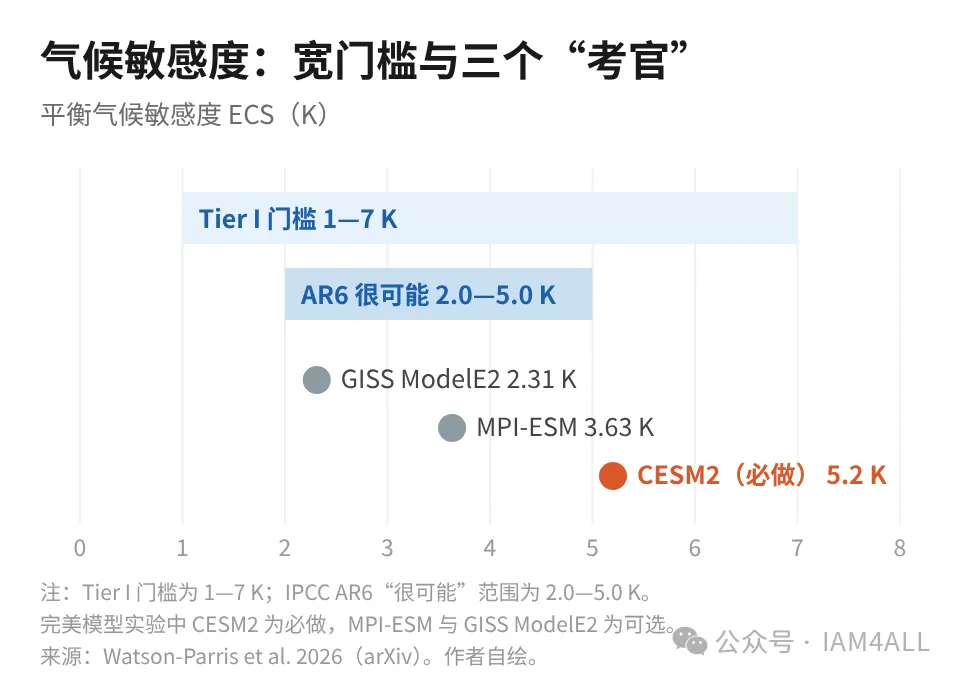
图3 气候敏感度门槛与完美模型
六、防止“刷榜”
机器学习领域常见的问题是测试数据泄露和针对榜单调参。v2列出了三类受保护的数据:2015年以后的观测(包括同化了这些观测的再分析)、三个完美模型的未来模拟、以及留作测试的古气候代用资料。参评者需要提交“模型卡”,说明训练数据来源和时间范围、调参方法和计算成本。评估代码基于ESMValTool,在GitHub上公开运行。[2]
七、放到更大的背景里看
ClimateBench v2并不是孤立的。2026年发布的AIMIP第一阶段研究,让8个AI天气气候模型只用1979—2014年的ERA5再分析训练,再用2015—2024年做样本外检验。结果显示,多数AI模型的气候态偏差小于参照的物理模型GFDL-CM4,但对历史变暖趋势的模拟差异很大;在海温整体升高2 K或4 K的试验中,有的模型出现了陆地反而变冷的不合理响应。[6]
这正说明了第三关的必要性:在“见过的气候”里表现好,不代表在“没见过的气候”里可靠。v2把大气环流指标留给AIMIP,自己专注于对结果的评估,两者形成互补。[2,6]
混合模型是另一条路线。谷歌团队2024年在《自然》发表的NeuralGCM结合了物理动力框架和机器学习,在1—15天的天气预报上可与ECMWF相当,并完成了40年的气候模拟。它也是ClimateBench v2论文中列举的混合模型例子。[7,8]
八、从综合评估模型(IAM)的角度看
第一,评测对象和IAM的需求高度相关。IAM给出排放路径,需要气候模型(或其简化模拟器)把排放转成温升和区域影响。ClimateBench v1面向的模拟器,正是IAM常用的工具;v2把问题提到了“能否直接用AI生成可信的区域气候”。如果AI模型通过了这套评测,IAM就有可能更快地为大量情景生成区域气候信息。
第二,简单模型的表现提醒我们不要迷信复杂度。示例评分中,模式缩放基准好于CMIP6中位模型。这与IAM领域常用简化气候模型的做法一致:在全球温升这类指标上,简单模型往往够用;真正的难点在区域降水、极端事件和尚未见过的气候状态。
第三,只评一条路径。v2的Tier II只用SSP2-4.5,评的是“中间路线”。IAM关心的低排放、超调和负排放情景,模型能否同样可靠,需要更多检验。
第四,“不给总排名”对决策者是好事也是挑战。成绩单更诚实,但决策者需要知道“我该用哪个模型”。这需要按用途(如农业、水资源、能源)给出解读。
九、对中国的启示
第一,中国的AI气象模型正在向气候尺度延伸。上海科学智能研究院和复旦大学开发的“伏羲”系列,第一版被称为中国首个次季节气候大模型,可预报15—60天;中国气象局的“风顺”作为首个AI全球次季节至季节预测系统,已稳定运行一年多,每天给出100个集合成员的60天预报。[9,10]
第二,参加公开评测是获得国际认可的有效方式。ClimateBench v2和AIMIP都是开放协议,代码和参考数据公开。中国的AI模型如果走向气候预测,可以主动按这些协议提交结果,与国际模型同台比较。
第三,“防泄题”和“模型卡”值得国内借鉴。国内AI气象模型的评测多由研发方自行完成,测试期和训练期的划分、所用数据的时间范围并不总是公开。v2的做法——锁定测试期、要求模型卡、开源评估流程——可以作为国内评测规范的参考。
第四,能量失衡的低估值得关注。所有CMIP6模型都低估了近十年能量失衡的增幅,这意味着基于这些模型的近期预估可能偏保守。在使用CMIP6结果做中国区域的适应规划时,应考虑这一偏差。
十、未来趋势
一是评测从“排行榜”走向“成绩单”。多维度、分变量、区分样本内外的评价方式,可能成为气候AI领域的通行做法。[2]
二是观测数据的价值上升。2015年以后的观测是检验AI气候模型的“黄金标准”,而CERES等卫星观测的延续性面临挑战。[4]
三是物理与AI的结合。从NeuralGCM到各类混合模型,能否通过古气候和完美模型等外推测试,将决定AI能否进入气候预估的主流。[7,6]
值得追问的三个问题:
1. 只有十年的“考场”够不够?内部变率会不会让模型评分的差异被噪声淹没?
2. 如何把评测扩展到低排放和超调情景,服务于IAM和政策分析?
3. 中国的AI气候模型何时、以何种方式参加这类国际评测?
结语
ClimateBench v2没有给出“哪个AI模型最好”的答案,它做的是先把考卷出好:考什么、怎么考、怎样防止作弊。对一个正在快速发展的领域,这比任何单一模型的突破都更基础。AI能否真正用于气候预测,要看它能否通过“没见过的气候”这道题。
利益声明:本文作者任职于国际应用系统分析研究所(IIASA),未参与该论文,论文作者中没有IIASA人员。文中观点为作者个人观点,不代表IIASA的立场。该论文为arXiv预印本,尚未经过同行评议。版权说明:本文为独立撰写的解读,插图根据论文公开数字自绘。AI 使用声明:本文初稿与插图由 Claude Opus 5.5(Anthropic)辅助生成,作者已核对全部事实与数据,并对全文负责。
参考资料
[1] ECMWF,2025,ECMWF's AI forecasts become operational,https://www.ecmwf.int/node/29308
[2] Watson-Parris et al.,2026,ClimateBench v2.0: Probabilistic Climate Model Benchmarking,arXiv:2610.04558,https://arxiv.org/abs/2610.04558
[3] Watson-Parris et al.,2022,ClimateBench v1.0: A benchmark for data-driven climate projections,Journal of Advances in Modeling Earth Systems 14: e2021MS002954,https://doi.org/10.1029/2021MS002954
[4] Mauritsen et al.,2025,Earth's energy imbalance more than doubled in recent decades,AGU Advances 6: e2024AV001636,https://doi.org/10.1029/2024AV001636
[5] Eos,2025,Earth's Energy Imbalance is Growing Faster Than Expected,https://eos.org/editor-highlights/earths-energy-imbalance-is-growing-faster-than-expected
[6] Henn et al.,2026,AIMIP Phase 1: systematic evaluations of AI weather and climate models,arXiv:2605.06944,https://arxiv.org/abs/2605.06944
[7] Kochkov et al.,2024,Neural general circulation models for weather and climate,Nature,https://doi.org/10.1038/s41586-024-07744-y
[8] Phys.org,2024,NeuralGCM 相关报道,https://phys.org/news/2024-07-scientists-ai-rivals-methods-weather.html
[9] China Daily(上海市政府网转载),2024,Shanghai researchers develop more accurate AI weather model,https://english.shanghai.gov.cn/en-Latest-WhatsNew/20240605/48d7889c74ac4bb48905eb2b2991a7ed.html
[10] 新华网(转载人民日报),2025,“人工智能+气象”让天气“变幻可测”,https://www.news.cn/tech/20251206/93b4002c213549efa784691a38dbb8f9/c.html