ARTICLE · 1308369
PDF表格转Excel:免费离线实跑
先说结论:能用,而且马上能用。 清晰的表格截图加 RapidOCR,本机约 0.6~1 秒出 Excel,7×6 中文几乎全对;文字型 PDF 报销单大约 0.5~1.1 秒,数据行正确,但表头常被揉成一格,要手修一行。全程离线、不上传。
适合:行政、运营、财务把 PDF/截图表格扒进 Excel 的人。别指望:糊成一团的拍屏、无线框「假表格」、以及表头 100% 免改。
项目是 GitHub 上的 img2table(MIT,约 900 星),我在 Linux 上从安装到导出完整跑了一遍。文末给可复制脚本。
一、为什么测 PDF/截图转 Excel
搜「PDF 转 Excel」「截图表格」,首页多半是要你上传的网站。报销单、价目表、后台数据截图,丢上去就等于把公司数字交给别人。
之前测过 Filee、PdfCraft,擅长转格式和打码,但不专攻「把表格结构抠进 Excel」。今天专测 img2table:输入 PDF 或图片,输出 .xlsx。
机器:8 核 Intel Xeon(vCPU),16 GB 内存,无显卡,Debian 13,Python 3.13.5。 软件:img2table 2.0.0 + RapidOCR 3.10.0 + onnxruntime 1.31.1;OpenCV 必须钉 4.14.0.94(见下文踩坑)。 素材:自制 3 页中文 PDF(费用报销 / AI 工具月费 / 商品 SKU)+ 一张清晰「周数据」截图风表 + 一张模糊扫描风图。不是真实财务数据。 测试日期 2026-11-04。数字都是这台机器跑出来的。
这段转给:总把报销单、价目表拖到在线「PDF 转 Excel」网站的同事。
二、安装:要钉死 OpenCV 版本
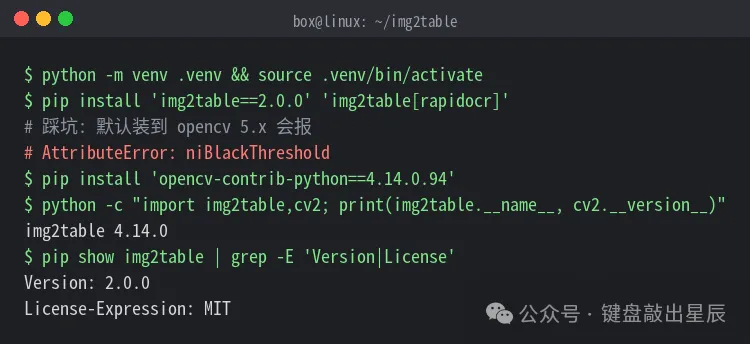
安装:img2table 2.0.0 + RapidOCR;OpenCV 钉 4.14.0.94
python3 -m venv .venv && source .venv/bin/activatepip install 'img2table==2.0.0' 'img2table[rapidocr]' openpyxl# 关键:默认会装到 OpenCV 5.x,调用 niBlackThreshold 直接报错pip install 'opencv-contrib-python==4.14.0.94' \ 'opencv-python-headless==4.14.0.94'图片和扫描件必须开 OCR;文字型 PDF 开 pdf_text_extraction=True 时可以不开 OCR,更快更省内存。
三、实测:截图最好,PDF 数据行也稳
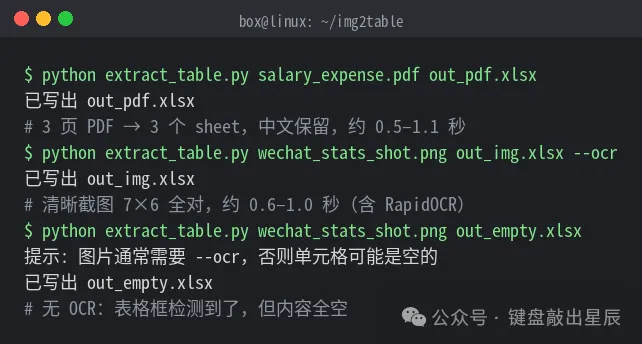
清晰截图 + RapidOCR:约 0.6~1.0 秒;文字 PDF 约 0.5~1.1 秒
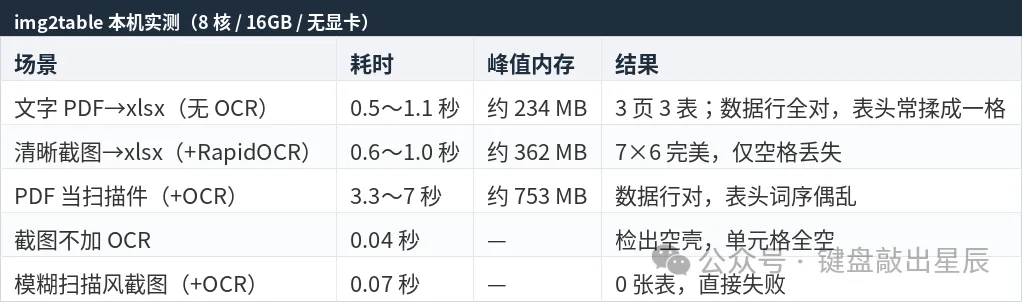
五种场景本机实测(耗时 / 内存 / 结果)
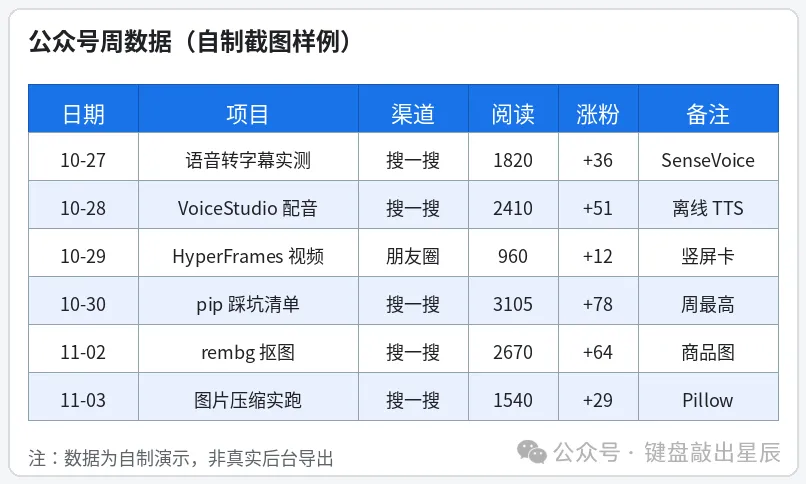
自制清晰截图:7 行 × 6 列「周数据」表
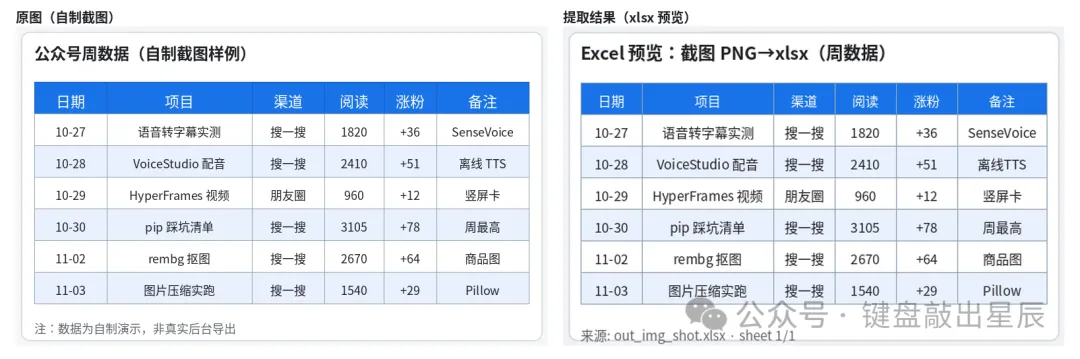
左:原截图;右:导出的 Excel 预览——结构对齐,中文可读
截图这条是我认为最适合转给普通人的:结构 7×6,无错误合并;唯一细差是「离线 TTS」变成「离线TTS」(空格丢了)。
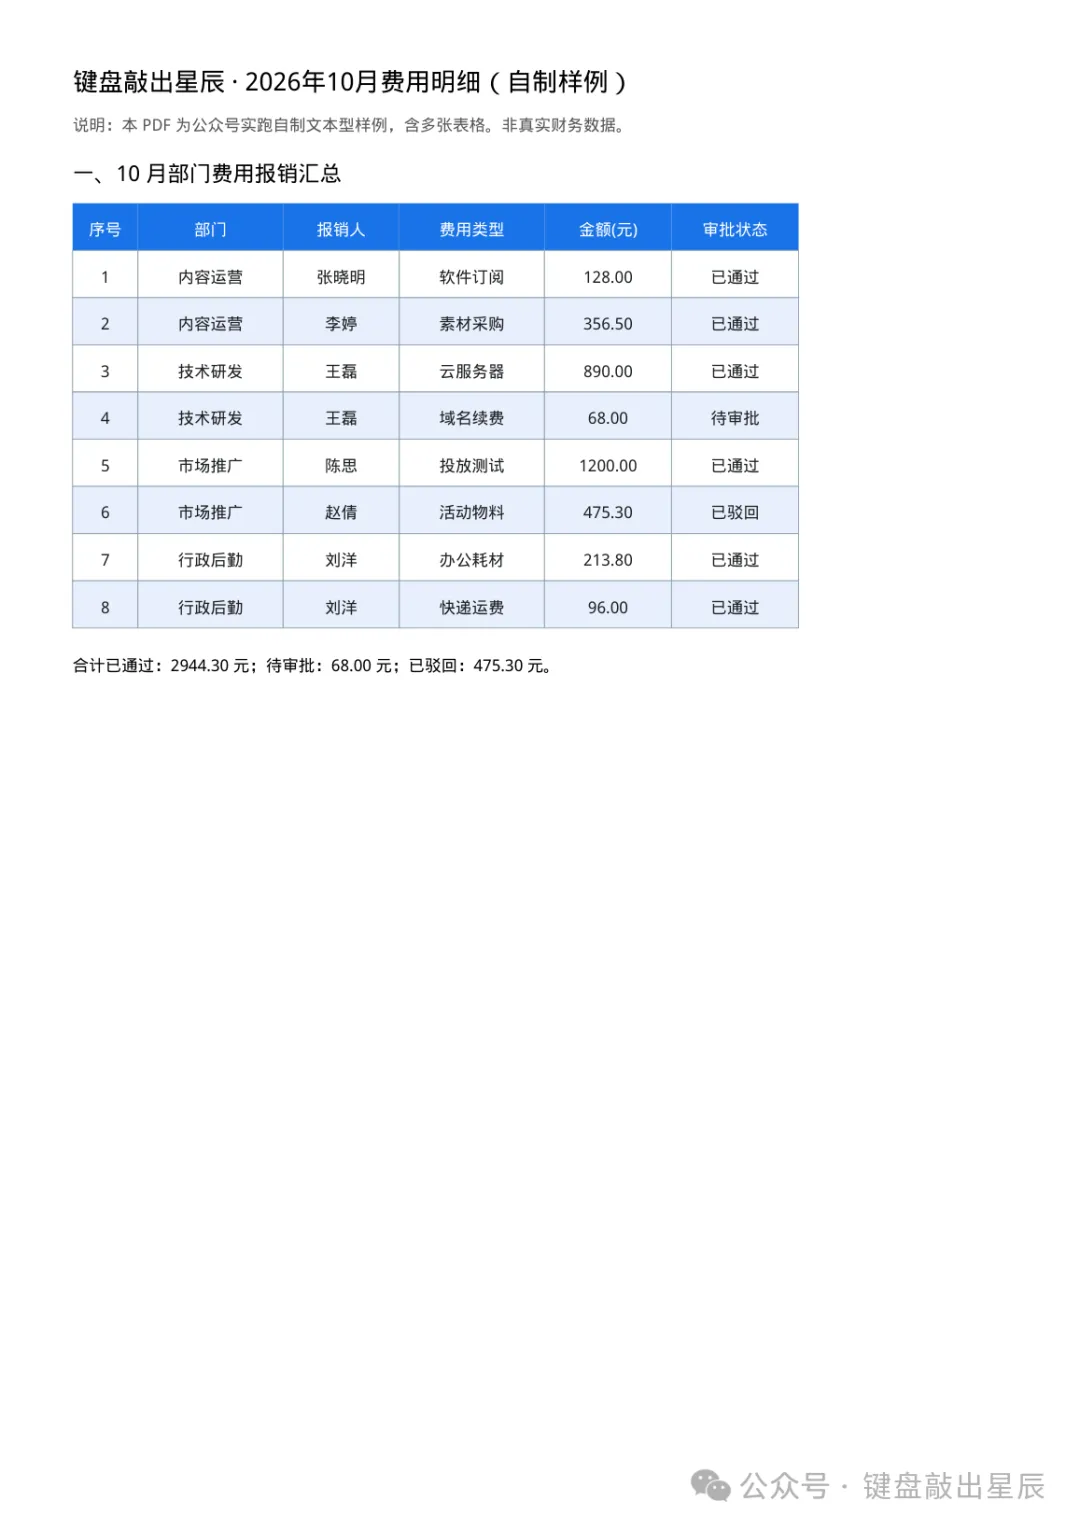
自制 PDF 第 1 页:费用报销表(文字型,可复制选中)
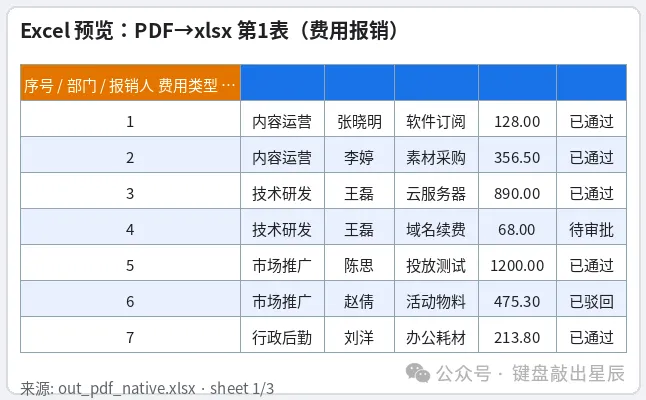
PDF 导出后:数据行全对;表头被合并成 A1:F1 一格
文字 PDF:8 行费用、6 行工具、6 行 SKU 的数据行中文和数字全部正确;三页变成三个 sheet。问题集中在表头——常被揉进 A1,用换行挤在一起,从第 2 行起列对齐正常。修起来就是拆一行表头。
这段转给:每周要从 PDF 价目表、后台截图往 Excel 抄数的运营和行政。
四、卡住我的地方
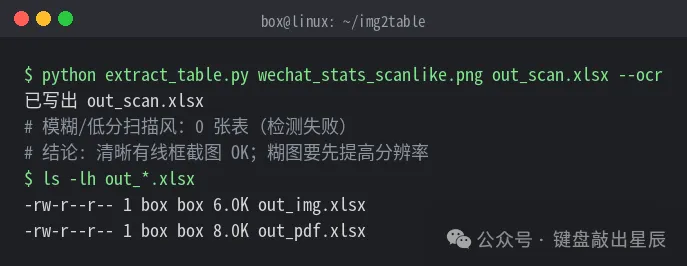
不加 OCR → 空壳;模糊图 → 0 张表;OpenCV 5 → 直接崩溃
1. OpenCV 5 会直接炸。 报错是 ximgproc 没有 niBlackThreshold。装完务必把 opencv-contrib-python 和 opencv-python-headless 都钉到 4.14.0.94。
2. 图片不加 OCR = 空表。 能检出 7×6 线框,但单元格全是空的。截图、扫描件请加 --ocr。
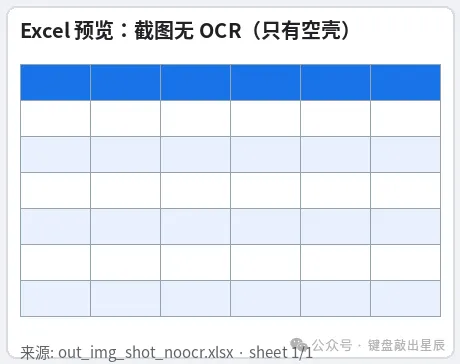
反例:同一张截图不加 OCR,导出全是空单元格
3. 糊图不是「错几个字」,是「一张都检不出」。 我把清晰表缩到 1/3 再放大并加模糊,模拟拍屏——0 张表。先想办法拍清楚,再跑提取。
模糊扫描风样例:本机检出 0 张表
4. PDF 表头要手修。 数据区可用,表头合并几乎必现。当扫描件强制走 OCR 时,表头词序还可能打乱,但数据行仍对。
5. 环境体积不小。 本机 venv 大约 789 MB(onnxruntime + OpenCV + RapidOCR 模型)。办公本第一次装要有点耐心。
五、一行命令脚本
把下面存成 extract_table.py(仓库 demo 里也有同款):
#!/usr/bin/env python3"""PDF/图片表格 → Excel(离线)用法: python extract_table.py 费用.pdf out.xlsx python extract_table.py 截图.png out.xlsx --ocr"""import argparsefrom pathlib import Pathdef main(): ap = argparse.ArgumentParser() ap.add_argument("src") ap.add_argument("dest") ap.add_argument("--ocr", action="store_true") ap.add_argument("--no-pdf-text", action="store_true") args = ap.parse_args() src = Path(args.src) ocr = None if args.ocr: from img2table.ocr import RapidOCR ocr = RapidOCR() if src.suffix.lower() == ".pdf": from img2table.document import PDF doc = PDF(src=str(src), pdf_text_extraction=not args.no_pdf_text) else: from img2table.document import Image doc = Image(src=str(src)) if ocr is None: print("提示: 图片通常需要 --ocr") doc.to_xlsx(dest=args.dest, ocr=ocr) print(f"已写出 {args.dest}")if __name__ == "__main__": main()# 文字 PDF(通常不用 --ocr)python extract_table.py 报销单.pdf out.xlsx# 截图 / 扫描件python extract_table.py 表格截图.png out.xlsx --ocr六、谁适合用
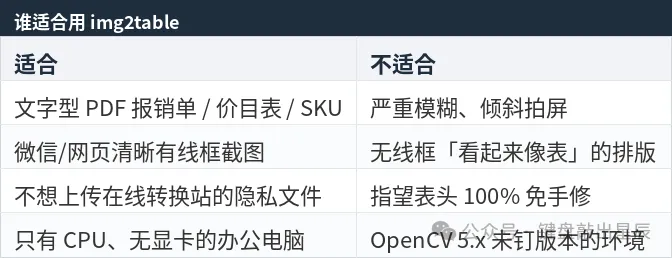
适合 vs 不适合(本机结论)
- 适合
:文字型 PDF 报销单、价目表、SKU;微信/网页清晰有线框表格截图;不想上传在线转换站的隐私文件;只有 CPU 的办公电脑。 - 不适合
:严重模糊/倾斜拍屏;无线框「假表格」;指望表头免手修;没钉 OpenCV 4.14 的环境。
一句话:截图清晰时几乎开箱即用;PDF 把数据行救出来,表头留一行手工。 比把公司表格丢给网站安心。
你平时卡在「PDF 转不出表」还是「只有一张截图」?留言说说,下次接着实跑。觉得有用,转给总在群里问「这个表怎么进 Excel」的那位。
AI 辅助创作:本文由 AI 辅助撰写。所有命令于 2026-11-04 在 8 核 Xeon、16GB、无显卡的 Debian 13 上用 img2table 2.0.0 + RapidOCR 3.10.0 实际运行;截图与 xlsx 为真实输出。演示 PDF/截图为自制样例,非真实财务或后台数据。星标数约为测试当日查询值。项目地址:github.com/xavctn/img2table