ARTICLE · 1309842
Excel合并:12个分部1615行,0.9秒拼成一张总表
你是不是也这样:每个月 12 个分部把台账发过来,你新建一个空表,开 12 个窗口,一块块复制粘贴,粘完还得挨个检查有没有把人家表尾的合计行也粘进来。
我按分部上报的真实样子造了 12 个台账试了一次(故意埋了毛病):1615 行合成 1612 行,只删 3 行合计行,128 行存成文本的金额全部转回数字,总金额 84,436,694.32 元和分部原始数据一分不差。全程 0.9 秒。
照着做,5 分钟(装库 2 分钟,剩下的等它跑完)。
先看效果
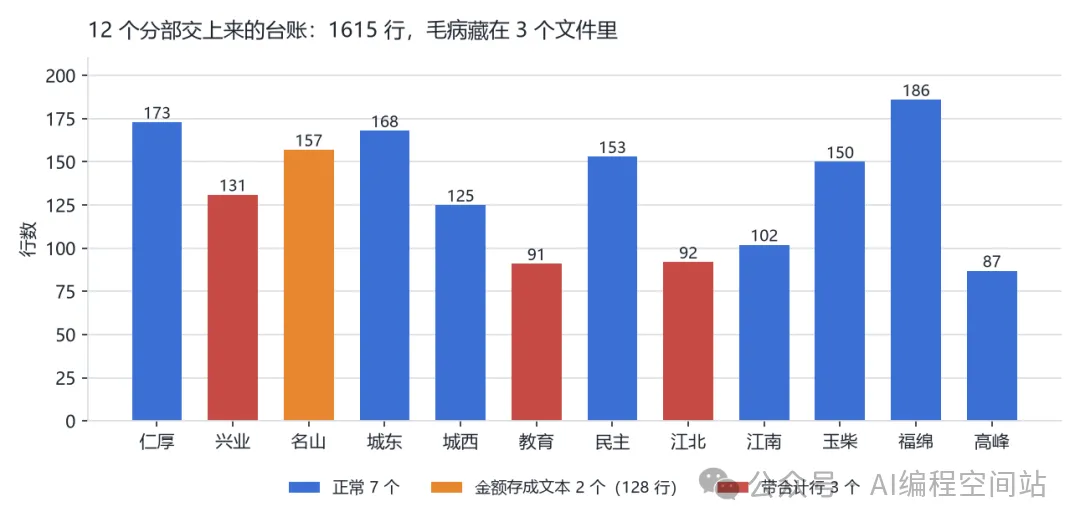
12 个文件长这样:7 个正常,2 个把金额存成了文本(名山 71 行、兴业 57 行),3 个在表尾带了自己的合计行(兴业还同时踩了文本金额的坑)。现实中交上来的表就是这样,你不可能要求 12 个人用一个模子。
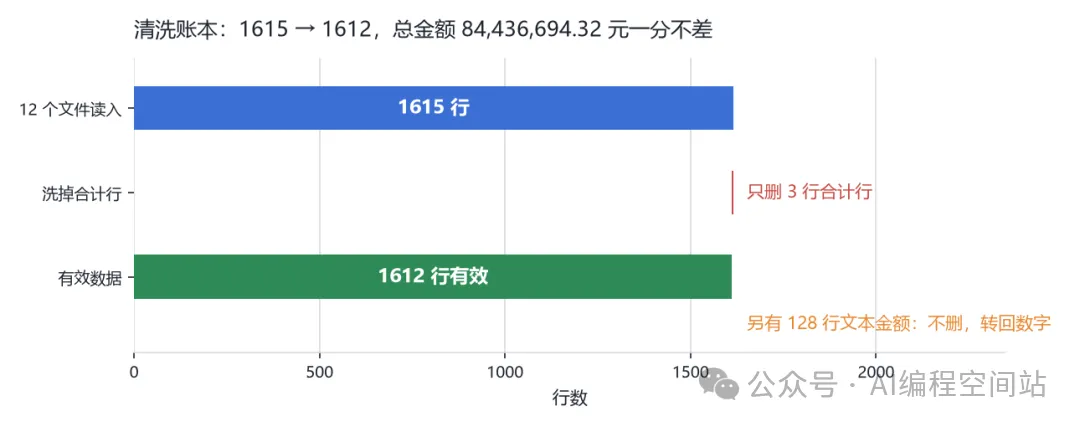
清洗账本很干净:1615 行读进来,删掉的只有 3 行合计行,剩下的 1612 行全部有效。注意 128 行文本金额不是删了,是「转正」了——千分位逗号剥掉、转回数字,一分钱没丢,所以总金额才能和 12 个分部各自的流水对得上。
怎么做
装两个库,一条命令:
pip install pandas openpyxl把各分部的表放进同一个文件夹(列名必须一致,这是模板的事,发模板时就该锁死),存成 20261104-demo.py:
# 用法: python 20261104-demo.py 表格文件夹 输出文件.xlsx # 把一个文件夹里所有列名相同的 Excel 合成一张总表,只加不动:原文件一个字节不改 import sys, os, glob, time import pandas as pd SRC = sys.argv[1] if len(sys.argv) > 1 else "各分部报表" OUT = sys.argv[2] if len(sys.argv) > 2 else "10月合并总表.xlsx" t0 = time.perf_counter() files = sorted(glob.glob(os.path.join(SRC, "*.xlsx"))) frames, raw_rows = [], [] for f in files: df = pd.read_excel(f) # 只读第一张工作表 raw_rows.append(len(df)) df.insert(0, "来源", os.path.splitext(os.path.basename(f))[0]) # 记住每行从哪来 frames.append(df) merged = pd.concat(frames, ignore_index=True) raw_total = len(merged) # 三步清洗,每一步都对着分部报上来的真实毛病 merged = merged.dropna(how="all") # ① 空行 merged = merged[~merged["客户名称"].astype(str).str.contains("合计")] # ② 合计行 merged["金额(元)"] = (merged["金额(元)"].astype(str) # ③ 文本金额 .str.replace(r"[¥¥,,\s]", "", regex=True) .str.replace(".00元", "", regex=False)) merged["金额(元)"] = pd.to_numeric(merged["金额(元)"], errors="coerce") merged = merged.dropna(subset=["金额(元)"]) merged.to_excel(OUT, index=False) sec = time.perf_counter() - t0 print(f"读入 {len(files)} 个文件,原始 {raw_total} 行") print(f"清洗掉:空行/合计行/坏金额 共 {raw_total - len(merged)} 行,剩有效 {len(merged)} 行") print(f"总金额 {merged['金额(元)'].sum():,.2f} 元,输出 {OUT}({os.path.getsize(OUT)/1024:.0f} KB)") print(f"耗时 {sec:.1f} 秒") for f, r in zip(files, raw_rows): print(f" {os.path.basename(f):<24}{r:>5} 行")跑:
python 20261104-demo.py 各分部报表 10月合并总表.xlsx跑出来的结果(真实输出):
读入 12 个文件,原始 1615 行 清洗掉:空行/合计行/坏金额 共 3 行,剩有效 1612 行 总金额 84,436,694.32 元,输出 10月合并总表.xlsx(59 KB) 耗时 0.9 秒 仁厚分部_10月台账.xlsx 173 行 兴业分部_10月台账.xlsx 131 行 名山分部_10月台账.xlsx 157 行 城东分部_10月台账.xlsx 168 行 城西分部_10月台账.xlsx 125 行 教育分部_10月台账.xlsx 91 行 民主分部_10月台账.xlsx 153 行 江北分部_10月台账.xlsx 92 行 江南分部_10月台账.xlsx 102 行 玉柴分部_10月台账.xlsx 150 行 福绵分部_10月台账.xlsx 186 行 高峰分部_10月台账.xlsx 87 行最后一列「来源」是脚本自己加的:每一行记着它从哪个文件来。哪个分部的数出了问题,在总表里筛一下就知道找谁——这是合并表里最值钱的一列,别删。
为什么这么写
1. 合计行必须删,不然总金额直接翻倍。 分部表尾的「合计」行是人家算好的小计,你原样粘进总表再一求和,84,436,694.32 会凭空多出 3 个分部的小计。更阴险的是合计行的金额是个 =SUM(...) 公式,pandas 读进来是一串公式文本不是数字,转数字时变成 NaN——就算侥幸没翻倍,那几行也是废行。所以第②步按「客户名称含合计」整行踢掉。
2. 文本金额不删、转正。 名山和兴业那 128 行金额,在 Excel 里带着绿色小三角,看着是数字其实是字符串「12,345.00」。直接 to_numeric 会报错,所以我先正则剥掉千分位逗号和可能的 ¥ 符号再转。这一步删了就是真丢 128 条流水,转正了一分不差——差别的确就一行代码。
3. errors="coerce" 是安全网,不是终点。 转不动的值变成 NaN,然后被 dropna 接走。这次实测没有一行落到这个网里(洗掉的 3 行全是合计行),但要是有,它会老老实实出现在「清洗掉」的数字里,而不是让整个脚本崩在半路。
踩坑提示
1. 12 个文件列名必须完全一致。 有一个文件把「金额(元)」写成「金额」,pd.concat 不会报错,只会静默生成一整列 NaN。发模板的时候把表头锁上(审阅 → 保护工作表),比事后对 12 遍表头省事得多。
2. pandas 读公式读不到结果。 没算过的 =SUM(...) 读进来是公式字符串。别指望拿别人表里的公式值做数,要么让对方存成值再发,要么像这篇一样把合计行整个删掉自己重算。
3. 文件顺序别赌运气。 脚本里 sorted(glob...) 按文件名排序,谁先谁后是确定的;你要是换成 os.listdir 不排序,同一份数据今天和明天合并出来行序都不一样,对账的时候会疯掉。
一页速查
pip install pandas openpyxl | |
python 20261104-demo.py 各分部报表 总表.xlsx | |
身边每个月初都在开 12 个窗口复制粘贴的同事,把这篇转给他——他下个月初能省出小半个上午。