ARTICLE · 1317653
最新Deepseek科研插件:实现多智能体协作任务!
一份科研代码,要检查数据有没有处理错、分析过程能不能对上方法说明,还要把问题整理成一份报告。把这些事一起交给AI,聊着聊着,常常就变成了:代码解释了一大段,真正需要核对的地方却没查完。你还得提醒它,这个先别改,那个要补证据,最后别忘了汇总。
今天分享Deepseek Harness最新拿下 2,257 star、196 fork 的插件dsh-agent-teams 。你说目标,它先出一份团队草案;你点头,它立马拉起多成员(智能体)分头干活。它让当前会话负责统筹,再安排几个AI成员各做一部分。谁先做、谁要等前面的结果、哪里需要补查,都可以放进同一份任务计划里。
01 / 先看界面:谁在做什么,能直接找到
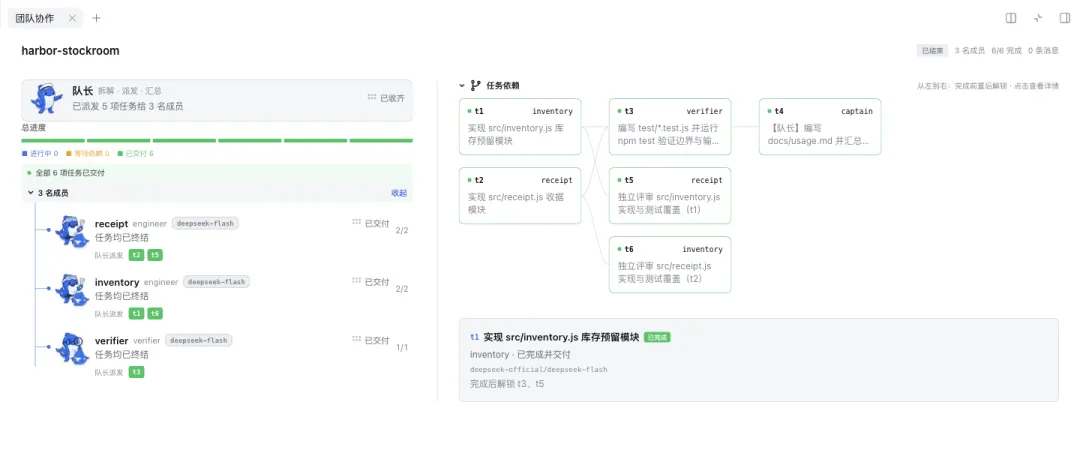
图01|左边是队长和成员,右边是任务及依赖关系
先看左边。最上面是队长,下面是不同成员,每个成员旁边有它领到的任务。
再看右边。一个个方框就是任务,连线表示先后依赖。比如,两个模块可以分别实现;验证要等前面的实现完成,最后再整理说明。
这里最实用的地方,是不用全靠翻聊天记录判断进度。
你可以点任务看详细内容,也可以从成员入口打开对应会话。想知道“这份结果是谁做的”“它前面等的是什么”,能顺着任务找过去。
02 / 用在科研里,可以怎样安排
拿“检查一份论文配套代码”来说,不妨先把它分成几块。
一个成员检查数据处理:筛选条件是什么,缺失值怎么处理,有没有把不该混在一起的数据放到一起。
一个成员检查分析脚本:每一步输入输出是什么,统计或建模过程在哪里,是否存在明显的实现问题。
另一个成员对照方法说明:论文或README写了什么,代码实现里哪些地方能够对应,哪些地方暂时找不到依据。
这些初步检查可以分头做。等各自留下文件位置和证据,再安排复核,最后由队长汇总。
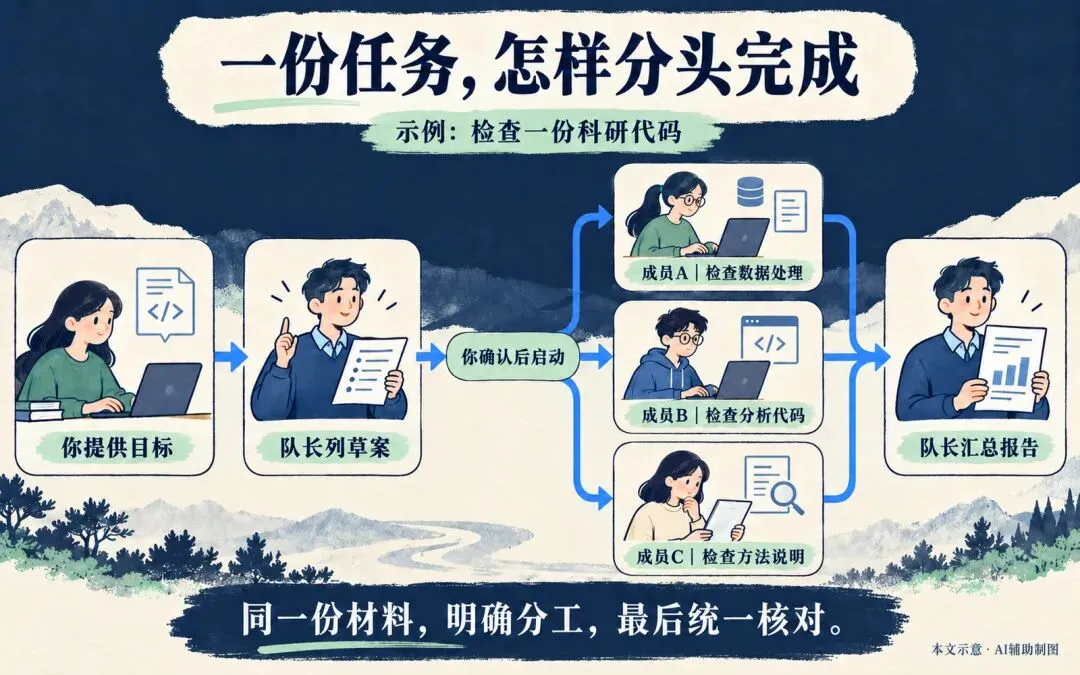
图02|科研代码检查示例。
分工最好按要检查的内容来写,交付也要落到具体材料。
“你是世界顶尖科学家”很难帮助我们验收;“检查缺失值处理,并给出文件路径和相关代码位置”就清楚得多。
除了代码检查,也可以把这种安排用在手头已经备好的文献材料上:分别整理研究对象、方法和局限,最后核对同一篇文章的不同记录有没有冲突。前提是成员确实有读取相应材料的工具;安装组队插件本身,并不会自动增加论文数据库权限。
这些是本文给出的使用思路,后面的指令也是教学示例,不是已经完成的实测报告。
03 / 安装:先分清桌面端和命令行
截至2026年11月2日,项目README推荐的组合是:DeepSeek Harness 0.2.1-rc.2,插件 0.1.28。插件的 0.1.28 发布于10月30日,修复了新宿主版本被安装器判为不兼容的问题。
参考推送中的插件版本是 0.1.25。如果现在跟着安装,建议回仓库看当前说明,别照着旧版本号一路复制。
已经在用桌面端
在 DeepSeek Harness 侧栏依次打开:
插件 → 添加插件
然后填入带版本号的包名:
@nanmicoder/dsh-agent-teams@0.1.28也可以使用仓库地址:
https://github.com/NanmiCoder/dsh-agent-teams仓库方式从默认分支安装,需要能够访问GitHub,代码也可能比npm发布版更新。安装完成后,点“立即启用”;如果应用提示重启,就重启一次。
桌面端自带Harness内核。单独升级电脑上的命令行工具,不等于桌面应用的内核也跟着升级。这一点遇到版本问题时尤其容易弄混。
准备用命令行和浏览器界面
电脑先准备好符合宿主要求的Node.js环境。下面按仓库推荐组合写明版本,便于对照:
npm install --global @deepseek-ai/dsh@0.2.1-rc.2dsh --version确认宿主版本以后,再给Web配置安装插件:
dsh plugin --profile web add --save-exact @nanmicoder/dsh-agent-teams@0.1.28安装好后,在准备处理的项目目录里启动Web界面:
dsh --profile web如果这个配置原本就在运行,先停止,再重新启动,最后刷新浏览器。这里的 web 是配置名称,已经使用其他CLI配置的人,需要换成实际名称。
第一次进入Harness,还要先把两件事办好:在“设置 → 模型”中配置可用的模型;添加并选择要处理的工作区。官方使用指南说明,尚未选择工作区时,会话输入区不可用。
先确认普通会话能够读到项目、正常回答,再试组队。 这样出问题时,比较容易分清是模型配置、工作区选择,还是插件本身的事情。
还有一个小细节:项目说明提到,桌面端使用的包管理器对刚发布的版本有等待期,裸包名或 @latest 可能选到旧版。因此安装时写明插件版本,更容易与教程对上。遇到更新,再看README和兼容清单,不用靠关闭检查来绕过去。
04 / 发出目标以后,先看草案
装好以后,可以在会话里以 /agent-teams 开头,接上要做的事情。
第一次不妨用一个范围小、材料明确的任务。下面这段可以直接改:
/agent-teams 检查当前工作区的科研代码,先给我团队草案,等我确认后再开始。目标:检查数据处理、分析脚本与方法说明是否一致。材料:只用当前工作区已有文件,先列出你实际读到的文件。分工:分别检查数据处理、分析代码、方法说明,最后交叉复核并汇总。约束:本次只做检查,不修改源代码,不安装依赖,不运行分析脚本,不联网补资料。交付:每条发现给出文件路径和相关位置;分清已确认问题、推测与待核实项;报告放到新建的 audit-notes 目录。这段话里,“不运行分析脚本”是为了先做静态检查;允许新建报告目录,是为了留下结果。以后真要复现运行,可以另开一步,说明使用的环境、命令和允许修改的范围。
正常的 /agent-teams 流程会先保存一份草案,列出成员和任务。这个阶段还没有创建成员会话,也没有开始领任务。 你可以先看、再改,确认以后才启动。
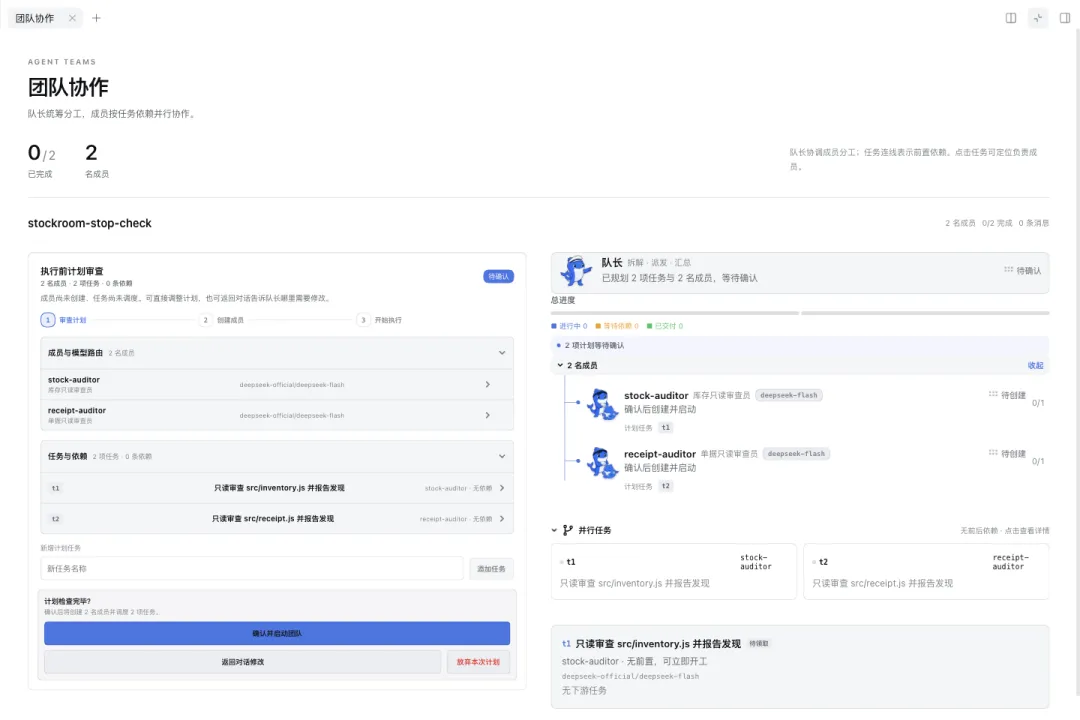
图03|左侧可检查成员与模型、任务与依赖,底部有“确认并启动团队”“返回对话修改”等入口。
这里建议认真看三件事。
第一,每个成员的职责有没有重叠。两个成员都写“全面审查”,很可能各交一份差不多的报告。
第二,前后顺序对不对。复核要看前面交出的证据,就不该在证据还没出来时把复核任务也安排为可以立即完成。
第三,产物放在哪里。如果大家同时改同一个报告文件,最后还要花时间处理冲突。可以先分别输出,再由队长合并。
觉得不合适,就通过面板调整,或者返回对话说明要改哪里。确认方案以后,再点击“确认并启动团队”。不用因为草案是AI给的,就把它当成已经合理的安排。
05 / 跑起来以后,重点看任务依赖
从聊天标题栏或团队卡片点“查看团队”,可以进入所属会话的“团队协作”页面。宽屏会并排展示,窄一些的区域会自动堆叠;点成员图标可以进入相应会话。
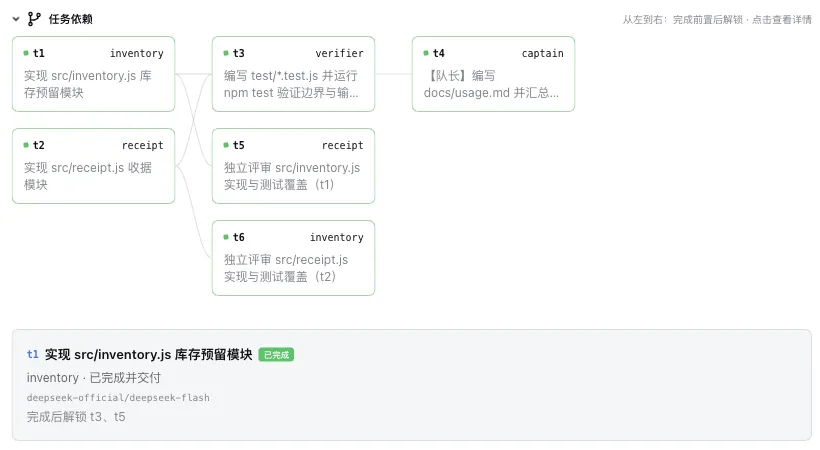
图04|上方连线表示任务依赖,下方展开选中任务的负责人、模型和后续解锁任务。
可以把“依赖”简单理解为:后面这项工作,需要先拿到什么。
两个人分别检查数据处理和分析脚本,通常可以同时开始。整理最终报告,则要等前面的检查结果。插件会让空闲成员领取已经就绪的任务;前置任务没有完成时,下游任务不能提前领取。
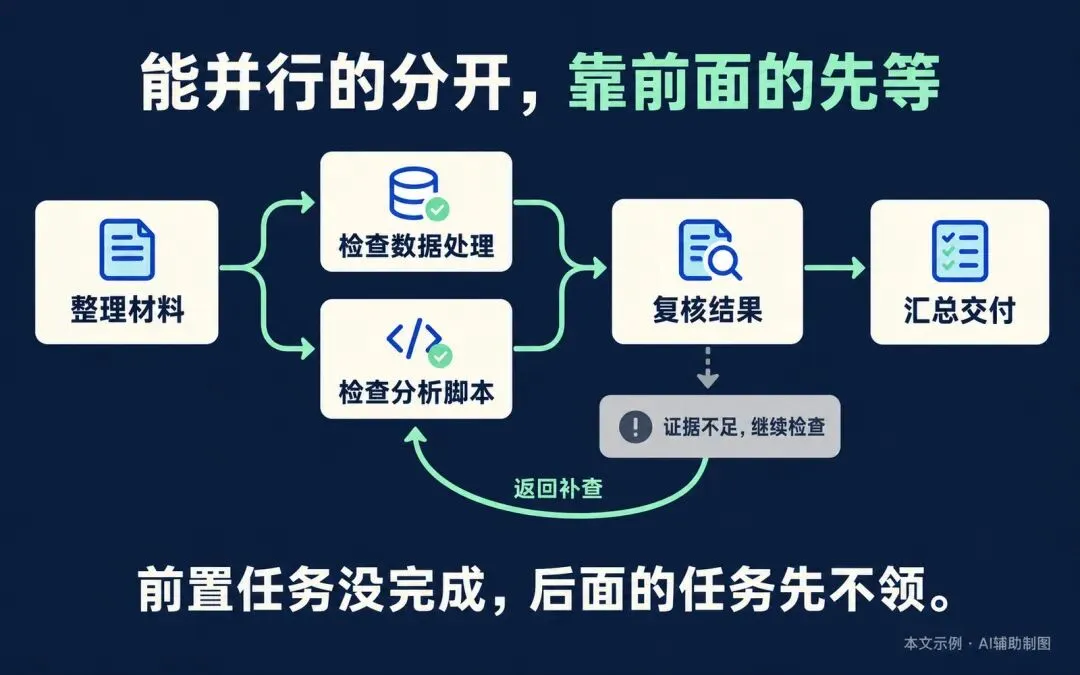
图05|并行检查之后再复核,证据不足时返回补查;不是插件已经完成的科研实验。
成员之间也可以直接发消息。例如,检查方法说明的成员发现论文写的是某个筛选条件,可以把位置发给检查代码的成员,请它对照。
这些消息保存在持久化邮箱里,暂时不能实时投递时,会留待后续重投。成员也是可以继续唤醒的,后面想追问一项发现,可以让对应成员接着查,不必重新从头解释整个项目。
06 / 常用分工,可以留成模板
如果你每周都做一次相似检查,不想每次重新安排成员,可以在配置里保存命名模板。
例如,在插件配置的 profiles 中,准备一个最小的两人检查流程:
profiles: research-check: members: - name: code-reader role: 检查代码并记录文件位置与依据 - name: evidence-checker role: 复核发现中的证据并整理待确认项 tasks: - id: inspect subject: 检查指定代码 assignee: code-reader - id: verify-notes subject: 复核检查记录 assignee: evidence-checker dependencies: [inspect]这是插件配置片段,不是让你覆盖整个配置文件;放置位置和已有设置的合并方式,要对照仓库文档。这里使用固定任务模板,不包含完整质量门禁配置。
以后调用时,明确写上模板名:
/agent-teams --profile research-check 检查本周新增的分析代码,并列出仍需人工确认的地方也可以只保存阵容和约束,由队长根据目标规划任务。仓库提供了 taskPlanning: captain 这一方式;刚开始使用时,先把默认流程跑明白,再决定有没有必要做模板。
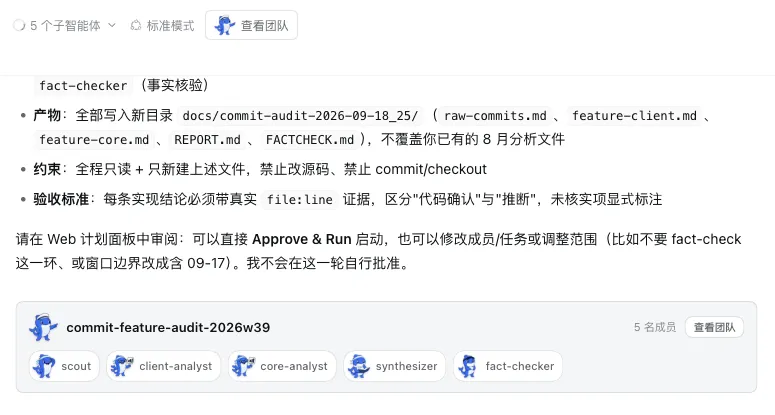
图06|团队卡片提供“查看团队”入口,聊天中保留目标、约束和执行说明。截图任务为仓库演示。