ARTICLE · 1339306
除了查文档,AI 能帮我查设备和工单吗
前三篇,我们在同一套 RHEL 10 和 NVIDIA L40S 环境上,搭起了 RAG 知识库,补上文档版本管理,又拿一组固定问题检查了回答和依据。
做完这些,再问一个很日常的问题:
「我的笔记本是什么型号,什么时候买的?」
知识库里有设备管理办法,但里面不会写每位员工正在用哪台电脑。再问「之前报修的工单,现在处理到哪一步了」,答案也不在管理办法里。
文档告诉我们应该怎么办,业务记录告诉我们现在是什么情况。 想让 AI 再往前走一步,就需要把这两类信息接到一起。
本篇继续沿用原来的模型和知识库,参考红帽的 IT 自助服务项目,加上只读的 MCP(Model Context Protocol)查询。先查自己的设备、查工单,再试着把台账和文档放进同一次回答。
一、先查一台电脑,再查一张工单
这次增加了一个 Web 页面。输入单独分配的演示凭据、连接到自己的会话后,就可以直接提问。
一个演示账号问「我的笔记本是什么型号,什么时候买的」,得到的回答是:
您的笔记本型号是 Latitude 7420,购买日期是 2020-01-15。
换另一个演示账号,查到的是它自己的设备。页面下方还保留了实际调用过程,可以展开看看用了哪个工具、工具返回了什么。
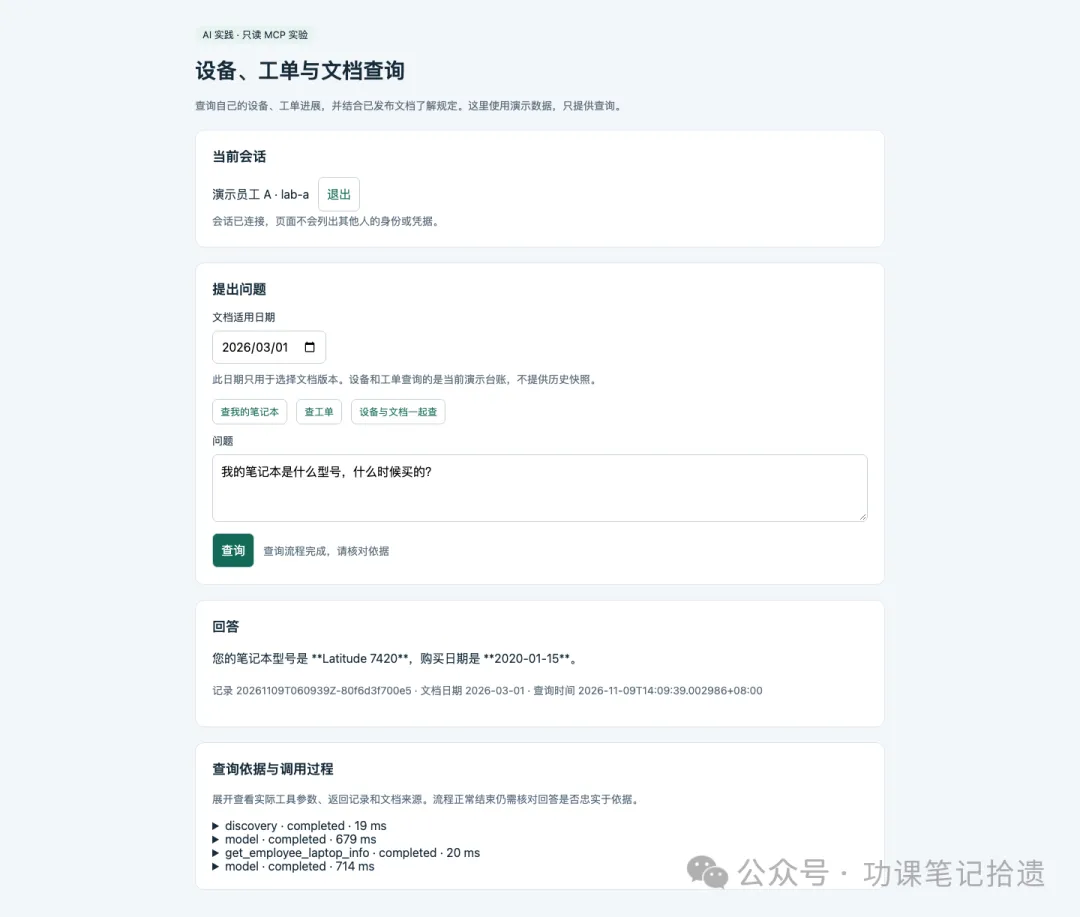
图:11 月 9 日基础查询阶段的实测页面,保留当次模型回答的原始文本。
接着问:「查询工单 LAB-TK-001 当前进展,有预计完成时间吗?」
查到的工单正在处理,由桌面支持组负责。备注中记录了接收设备、电池老化、申请更换电池和等待到货的进展。
但记录里没有预计完成时间。回答应当把进展整理清楚,同时说明这一项没有记录。不能因为前面查到了几条记录,顺手补一句「预计三个工作日完成」。
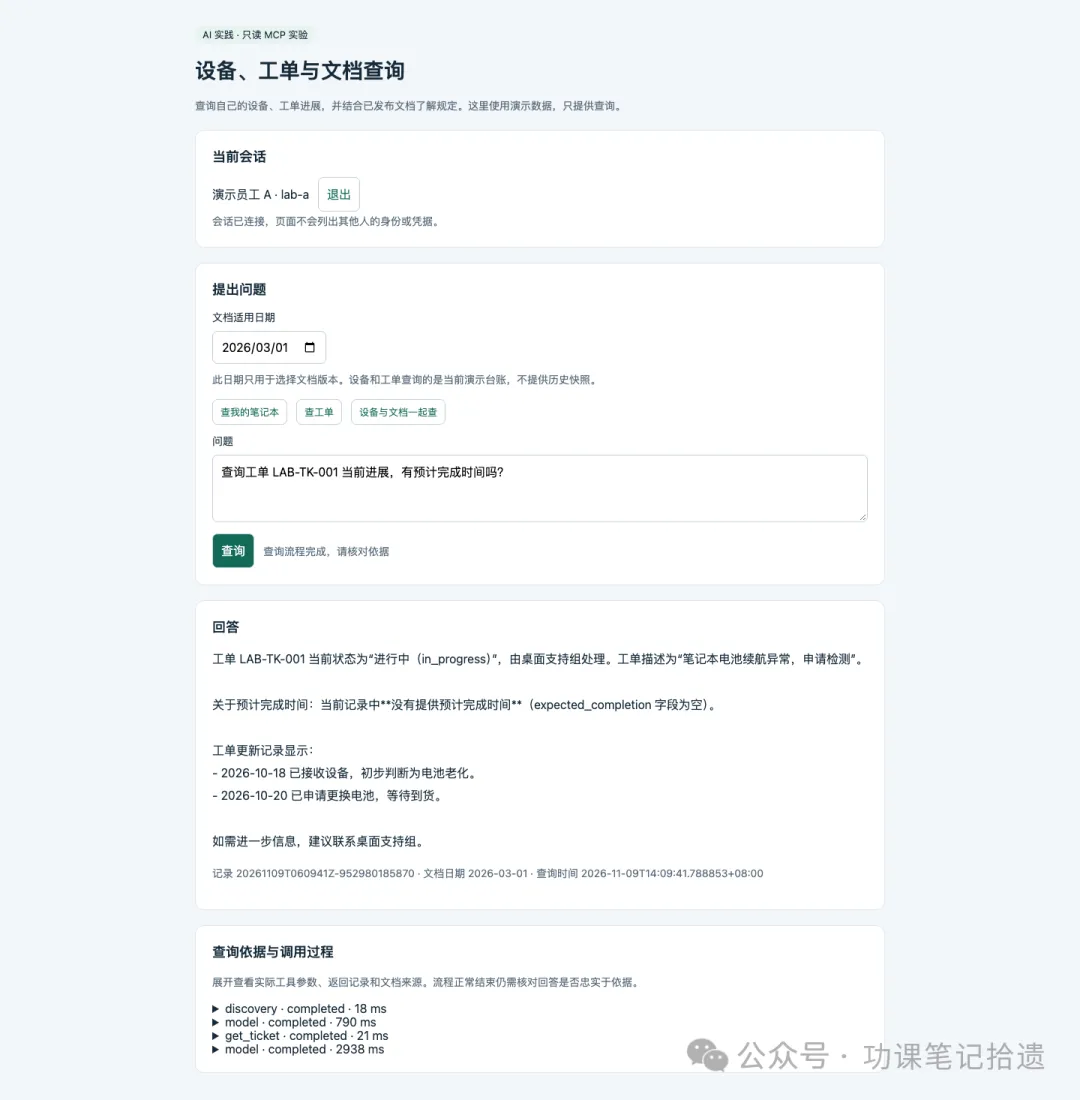
图:同轮工单查询实测,能够查到处理进展,但没有预计完成时间。
设备台账和工单都使用演示数据。我们先把「根据身份查记录、根据记录回答」这条链路走通。
二、从红帽的 IT 自助服务示例里取一部分来用
本篇主要参考 rh-ai-quickstart/it-self-service-agent。这个项目提供了 IT 自助服务场景、MCP 服务和模拟业务系统,和我们要做的事情很接近。
我们沿用了其中「查我的笔记本」的工具名称和查询思路,保留了上游十四条固定设备记录。设备查询在本篇使用本地样例数据,没有部署上游整套模拟业务系统。
在这个基础上,再补上模拟工单查询,并把第二篇的文档检索接进来。最终交给模型的工具只有三个:
get_employee_laptop_info | |
get_ticket | |
search_documents |
范围先放小一点,三个工具都只读。问它工单进展,可以查询;让它关闭工单,服务里没有对应能力。
三、MCP 接进来以后,OGX 还负责什么
先看整套服务的关系。绿色是本篇新增部分,蓝色沿用前面的模型和文档服务。
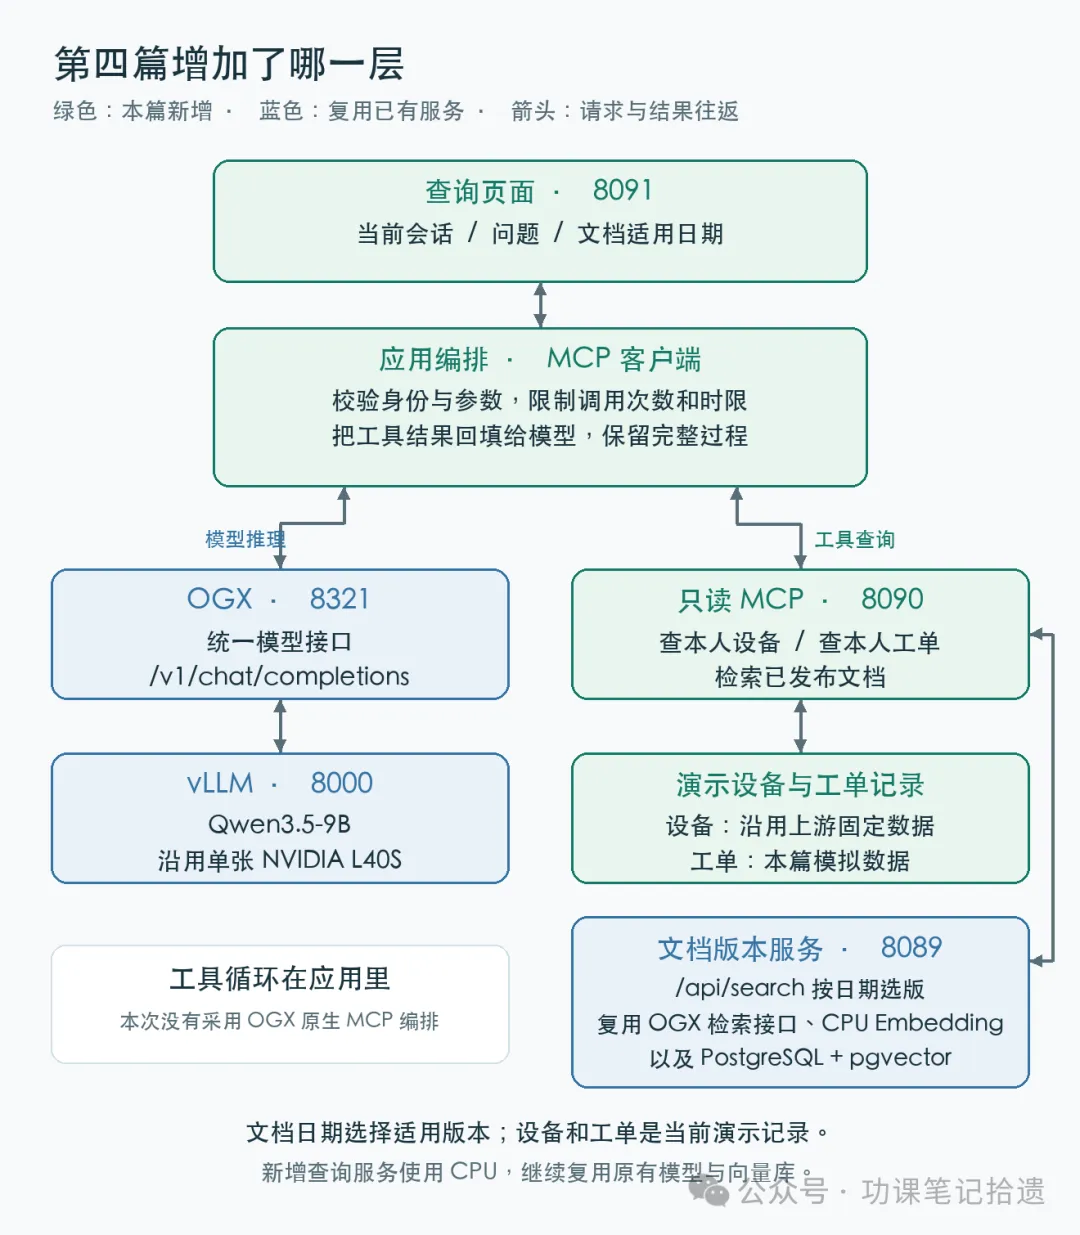
vLLM 继续运行模型,OGX 继续提供模型接口。 应用通过 OGX 的 /v1/chat/completions,调用之前注册的 local-vllm/rag-llm。
和普通问答相比,这次请求会带上三个工具的说明。模型可以先返回工具名和参数,比如调用 get_ticket,查询 LAB-TK-001。
接下来才轮到程序做事:应用检查工具名和参数,通过 MCP 客户端执行查询,再把返回结果放回对话,交给模型组织答案。需要补查文档时,就再走一轮。
这段工具循环由本篇的应用实现,OGX 承担推理接口。 MCP 则约定了应用与工具服务之间怎样发现、调用工具,以及返回结果。它们在这套部署里各有分工。
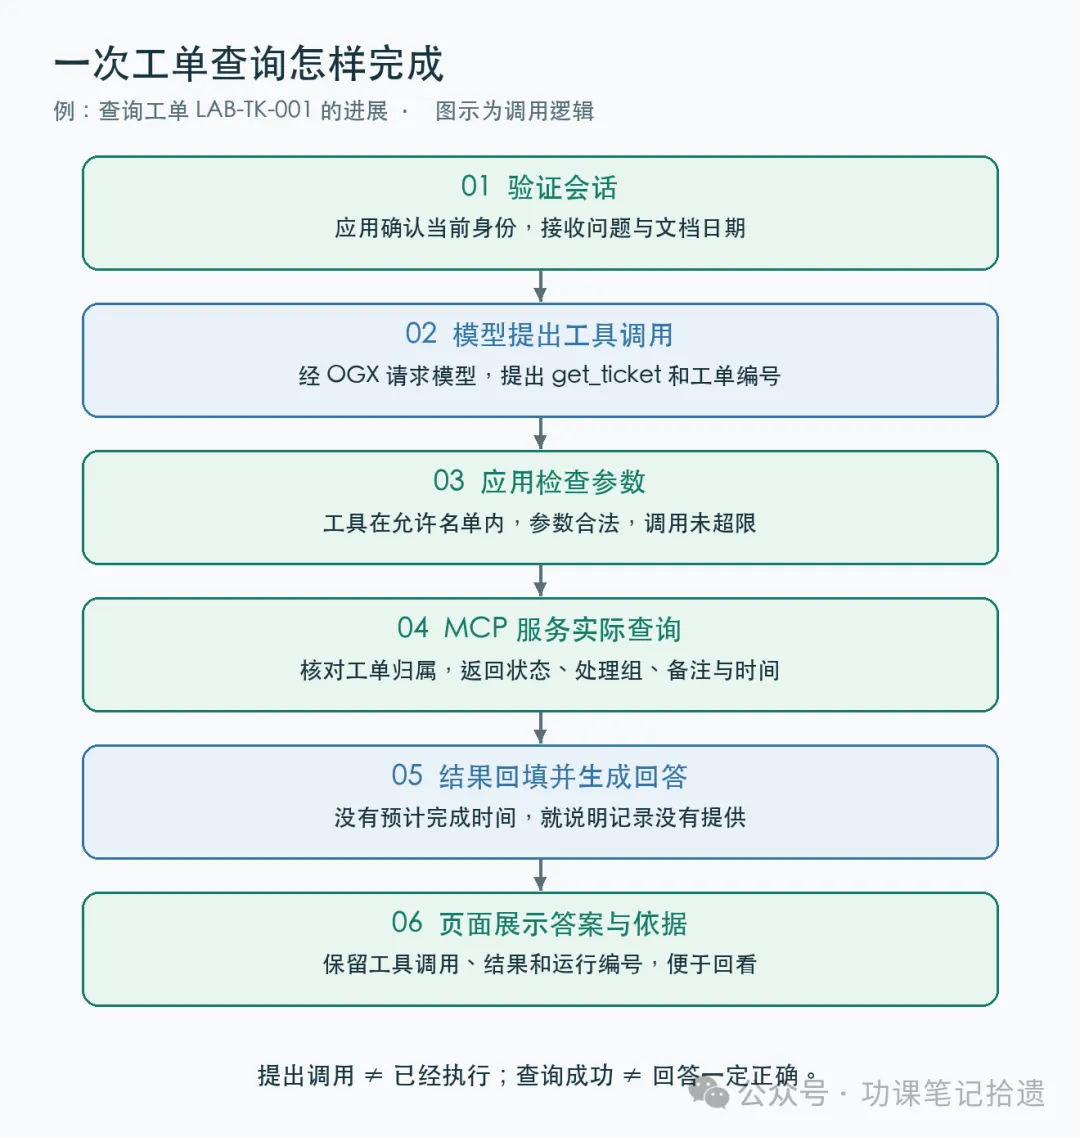
图:一次查询的六个步骤。绿色表示应用与工具服务的处理,蓝色表示模型参与的步骤。
文档查询也走同样的入口。MCP 服务调用已有版本服务的 /api/search,先按文档身份、适用范围和日期选版,再通过 OGX、CPU Embedding 和 pgvector 检索。取回的是片段及来源信息,最后和设备、工单记录一起交给模型。
这也意味着,接入 MCP 后,前几篇的 RAG 链路依然在用。只是应用多了一种选择:根据问题,决定需要查文档,还是需要查具体的业务记录。
有两件事仍由程序固定下来。
「我」是谁,由会话决定。 工具接口不接受模型自行指定员工邮箱。查工单时,服务还会检查记录归属;知道编号并不等于有权查看。本篇用单独分发的演示凭据完成这一步,企业单点登录和文档级权限留到真实系统接入时再补。
文档适用哪一天,由页面和应用决定。 模型不能自行改日期。这个日期只用于选择文档版本,设备和工单查询的是当前演示台账,不会跟着变成历史快照。
四、把设备和规定一起查,能直接判断换新吗
分别查询跑通之后,再试一个组合问题:
「查我的设备并对照设备文档,能否确认符合换新条件?」
这次,模型需要用到设备台账和第三篇的实验文档。文档规定:设备使用满四年,且维修成本超过重置价一半的,可以申请更换。
台账里有购买日期。看上去,从 2020 年买入到现在,早已超过四年,是不是可以直接回答符合条件?
还不够。购买日期不等于领用日期。 买入、入库、分配给员工使用,可能是不同的时间。当前台账没有领用日期,不能把按购买日算出的年数直接说成实际使用年限。
另一项条件也缺资料:维修成本没有记录,无法判断它是否超过重置价的一半。
一次组合查询复测中,回答把这两处缺项都说了出来:
由于台账中缺少领用日期和维修成本信息,无法确认您的设备是否符合换新条件。
这句话看起来没有「可以换新」那么干脆,却更有用。它告诉用户已经查到了什么,也指出下一步该补什么材料。
这里延续了上一篇的一个发现:信息拿回来,还要看是否足以回答问题。 现在只是从检查文档片段,扩展到了检查台账字段与文档条件能否对应起来。
文档版本仍按第二篇的规则处理。以实验差旅资料为例,选择 2026-03-01,上海住宿标准来自旧版,每人每晚八百元;选择 2026-07-01,则使用新版的一千元。
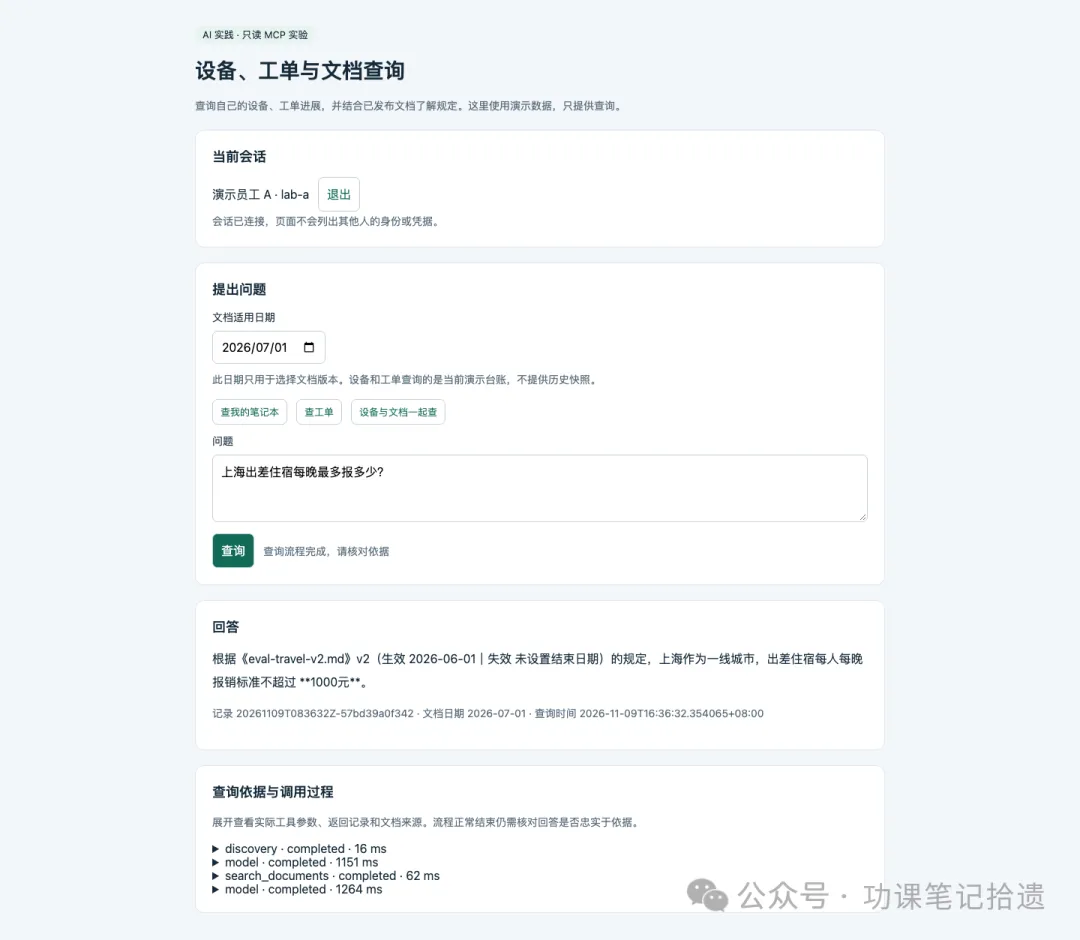
图:日期对照复测。回答中列出新版及其有效期,下方记录本次文档日期与查询时间。
答案和运行记录里分别显示文档日期、查询时间与文档有效期。查询日是 7 月 1 日,不意味着文档在那天失效;新版没有设置结束日期,也不能自行推断它之后还有一版。
五、在原环境上,增加两个服务
本篇仍在单张 L40S 上运行 Qwen3.5-9B。新增的查询应用和 MCP 服务使用 CPU,模型与 Embedding 沿用已有配置,不需要增加显卡。
新增端口只有两个:8091 是页面和编排 API,8090 是只读 MCP。两个新增服务都只监听本机,连接原来的 8089 文档版本服务、8321 OGX 和 8000 vLLM。
动手前,先确认模型能返回结构化工具调用。本次 vLLM 用下面的参数启用自动工具选择,并将模型输出解析成工具调用。这是现有启动命令中的参数片段,适用于本次测试的模型与版本:
--enable-auto-tool-choice \ --tool-call-parser qwen3_xml \ --reasoning-parser qwen3这些参数要放进已有的 vLLM 启动配置。还要确认文档库已准备好:组合查询使用第三篇的 eval3-device,日期对照使用 eval3-travel 的两个版本,文件需要完成入库并发布。
配套代码已放在 rag-mcp-lab,完整步骤见其中的部署与配置说明。首次获取时,在服务器的 root Bash 中执行,固定到本篇发布的版本:
git clone https://github.com/ian-research/ogx-rag-lab.git /root/rag-lab/ogx-rag-lab git -C /root/rag-lab/ogx-rag-lab checkout 31a3de3 cd /root/rag-lab/ogx-rag-lab/rag-mcp-lab bash scripts/prepare.sh已有仓库时,先保留本地修改,再按部署说明更新并进入其中的 rag-mcp-lab 目录,不必重复克隆。
脚本会创建本目录的 .venv,按锁文件安装依赖,并生成新的演示凭据。它使用自己的环境,原有 OGX 和 vLLM 的依赖无需重装。
接着核对 deploy/runtime.env.in 中的四个连接地址。本次使用的是:
OGX_BASE=http://127.0.0.1:8321 OGX_MODEL=local-vllm/rag-llm MCP_URL=http://127.0.0.1:8090/mcp DOC_SERVICE=http://127.0.0.1:8089首次安装时执行:
bash scripts/install.sh systemctl is-active article04-mcp article04-orchestrator curl --fail-with-body -sS http://127.0.0.1:8091/api/health安装脚本会生成两个 systemd 服务并启用开机自启动。持久配置位于 /etc/rag-lab/article04-runtime.env;后续修改连接地址后,重启这两个服务即可。已有同名服务时,首次安装脚本会拒绝覆盖;这类环境使用 bash scripts/switch-services.sh --switch 迁移,脚本会先备份原配置和服务单元。
本轮实际验证了安装、迁移、回退和服务恢复,尚未做整机重启测试。健康接口返回正常后,还要在页面上跑一次查询,才能确认模型和工具都接通了。
沿用前面的 SSH 隧道,把服务器 8091 转发到本机,再打开 http://127.0.0.1:8091/。管理员从 private/credentials-for-delivery.json 中单独取出对应账号的凭据,交给该账号使用;不要把整个凭据文件放到页面或公开仓库里。
连上会话后,可以按顺序问三次:查我的笔记本、查本人工单、设备与文档一起查。展开页面下方的「查询依据与调用过程」,确认有实际返回记录,再看回答是否和记录一致。
需要批量复查时,配套脚本会保存请求结果和运行编号:
.venv/bin/python scripts/verify.py \ --phase baseline --as-of 2026-03-01它检查流程是否完成,答案有没有漏条件、有没有编造,仍然要结合保存的记录检查。这和第三篇的评测方法是一致的。
六、调用过程也要能回头看
普通 RAG 问答里,我们保存「问题、检索片段、回答」。接入工具以后,中间又多了工具名、参数、实际结果和耗时。
这些记录能帮助区分两种很容易混在一起的情况:工具没有查成功,还是工具查对了、模型却说错了。
我们实际停止过 MCP 服务。此时页面所在的 API 仍然运行,请求会返回明确的服务不可用状态;恢复 MCP 并等它就绪后,再次查询能够继续完成。工具循环也设置了上限:最多四轮模型调用、六次工具调用,总请求时限为 240 秒。
还有一类输入来自工单备注和文档正文。它们可以包含业务事实,也可能夹着「忽略之前要求」这类指令。如果把这些文字直接当成操作要求,查询就可能偏离原来的问题。
本篇为构造的测试样例增加了处理:工单备注中的可疑指令按特征过滤;文档内容保留在来源记录中,业务答案若逐字复述命中的异常指令,应用会用省略标记替换,原始模型输出仍留在运行记录里。
这里起作用的是程序的过滤和输出处理,不能据此说模型已经解决了提示注入。真正决定可查范围的,仍是服务端身份检查和那三个只读工具。
复查时也分别看:程序有没有守住调用规则,模型有没有用对记录,服务中断后能否恢复。
七、从能查清楚,走向能办理事情
到这里,同一个页面已经可以查文档、查自己的设备和工单,也可以把台账事实与适用规定放在一起解释。
这个变化很具体:以前问「电脑换新有什么规定」,主要靠知识库;现在问「我的电脑能不能换」,还会去查这台设备。查不到的条件,就明确告诉用户还缺什么。
第三篇发现的检索漏项仍然需要继续改,MCP 不会自动把漏掉的片段补回来。它扩展了可以查询的信息来源,也让我们多了一条值得检查的链路。
下一步再考虑「帮我提交换新申请」,就要处理提交前确认、重复申请和失败重试了。先把当前这一步做扎实:让用户看得见查了什么,也知道回答是怎么来的。
附:本次使用的环境
requirements.lock 为准 |
参考资料
第四篇源码、配置与测试:rag-mcp-lab 系列实验仓库 ogx-rag-lab 第三篇评测资料与实验文档 红帽 IT 自助服务示例,本篇参考的固定版本 MCP 架构说明