ARTICLE · 1341842
11 万星的记忆插件 让 agent 记住上周干过什么
每次新开会话,agent 都像失忆——上周你解释过的架构,它一句都不记得。
这个问题不是模型不行,是没人给它留个本子。claude-mem 做的就是这本子。
它靠在会话全程挂钩子来记录:你让 agent 干了什么、读了哪些文件、改了什么,全落进本地库。
仓库 111,693 星,npm 上 15.9.0。我没法整跑(缺宿主 IDE),但把版本和结构都核对过了。
01一、它记的不是聊天,是动作
仓库是 thedotmack/claude-mem,完整地址 https://github.com/thedotmack/claude-mem 。111,693 star、9,721 fork,要求 Node 20 以上。
README 的定义很清楚:自动捕获工具使用观察,生成语义摘要,让未来会话能用。注意是「工具使用观察」,不是「聊天记录」。
差别很大:聊天记录是流水账,检索时全是噪音;观察是「它在哪个文件里做了什么、结果如何」,这才是能复用的东西。
它和「把上下文窗口做大」是两条完全不同的路。窗口再大,也是每次重开就归零;而记忆库是跨会话累积,还能被检索、被引用、被删。代价是多一个本地服务常驻,加上一层需要维护的数据库。值不值,取决于你把 agent 当临时工具还是长期同事。
还有个小细节:它明确区分「观察」和「摘要」。观察是原始记录,摘要是压缩后的语义版本,两层都存。这样做的好处是,摘要读错了还能回去看原文,而不是只剩一层被压扁的结论。
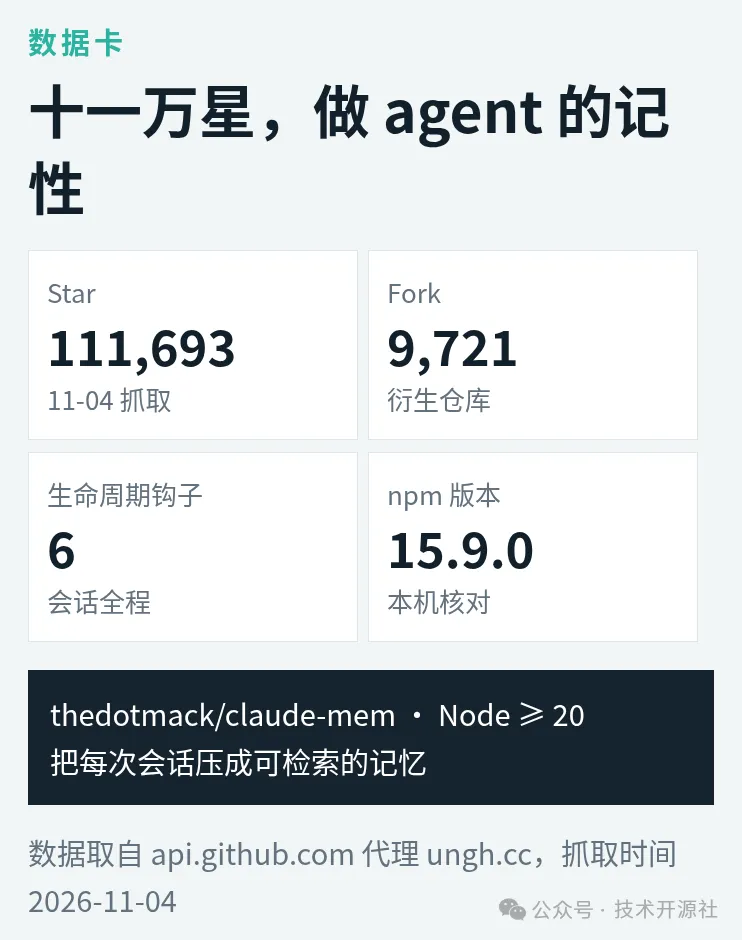
图 1:claude-mem 的关键数据,取自 api.github.com(经 ungh.cc 代理),2026-11-04 抓取,作者自绘
数据
111,693 star / 9,721 fork / npm 15.9.0 / Node ≥ 20(抓取与核对均于 2026-11-04)
它是怎么做到全程在场的?
02二、五个部件:钩子在前,库在后
第一层是六个生命周期钩子:SessionStart、UserPromptSubmit、PreToolUse、PostToolUse、Stop、SessionEnd。每个钩子最终就是一条命令 claude-mem hook claude-code
第二层是 Worker 服务:本地 HTTP API,带网页查看器和搜索接口,由 Bun 管着。第三层是 SQLite,存会话、观察、摘要。第四层是 Chroma 向量库,做语义加关键词的混合检索。
这套结构说明它不打算只做「记住」,而是要做「查得到」——有查看器、有 API、有检索,就是一个长在你机器上的小型知识库。
钩子的实现方式也值得一学:每个钩子都是一条无 shell 的命令,由安装器放进 PATH 的小启动器执行。这样做的好处是不会被你的 shell 配置、别名、环境变量搞坏,也不会因为某个 hook 脚本写错而卡死整个会话。
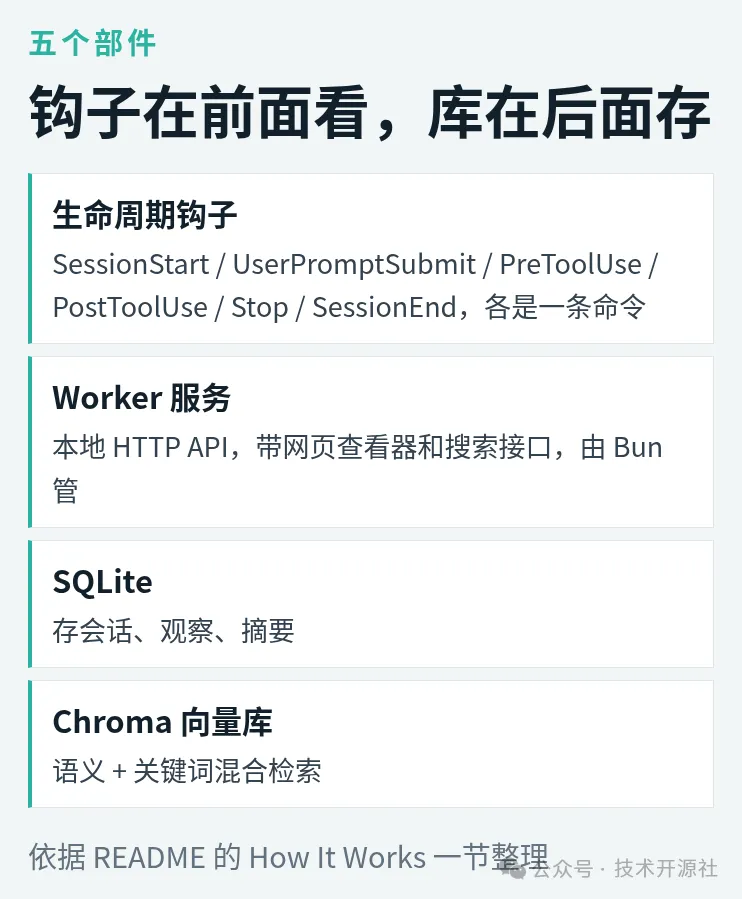
图 2:核心组件,依据 README 的 How It Works 一节整理,作者自绘
一个坑
npm install -g claude-mem 只装 SDK,不注册钩子、不起 worker。必须用 npx claude-mem install 或 /plugin 命令装,否则你会以为它没生效。
记下来之后,怎么取?
03三、三层检索,先看索引再取全文
第一步 search 拿回一份带 ID 的紧凑索引,每条约 50–100 token;第二步 timeline 看某条前后的时间线;第三步 get_observations 只对筛出来的 ID 取全文,每条约 500–1000 token。
它自称这套流程省约 10 倍 token。逻辑是对的:先粗筛再精读,比一股脑把历史全塞进上下文便宜得多,也更准——塞太多反而干扰判断。
这也是给所有做 memory 的人的一个可抄结构:索引、时间线、详情,三层各管一件事。
省 token 这件事,落到钱上很直接:一次会话里塞满历史,动辄几万 token 起步;三层检索把大部分请求压到几百 token。当然这是它自己的口径,我没法在这台机器上复测——没有宿主,就没有真实会话可省。
为什么非要分三层?因为一次性取全文有两个毛病:慢,而且脏。你只想确认「上个月那个 API 是怎么接的」,却被迫把整段调试过程读进来,模型注意力会被稀释。先索引后详情,本质上是在替模型做一次粗排。
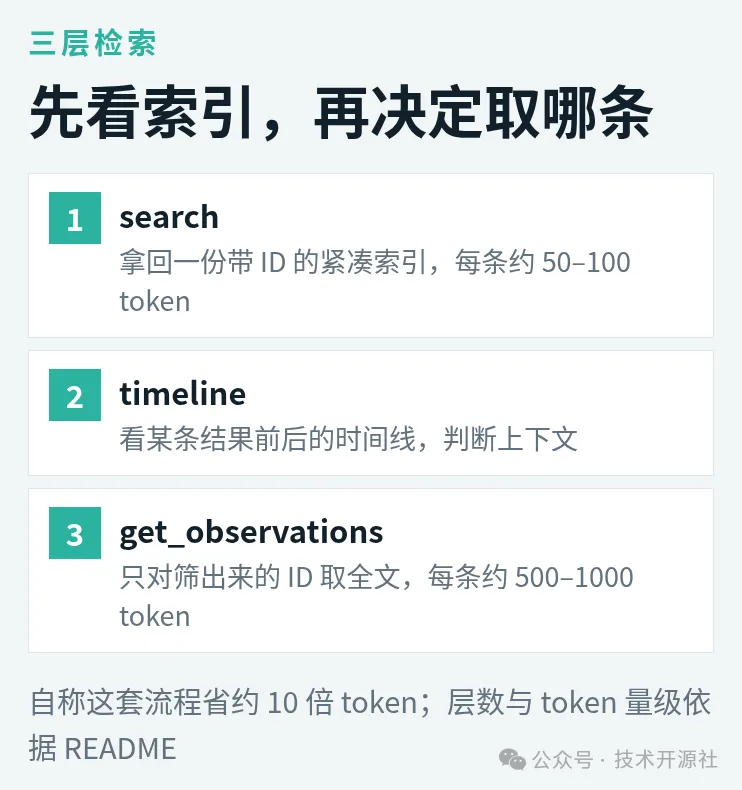
图 3:三层检索流程,依据 README 整理,作者自绘
设计
4 个 MCP 工具 + 3 层取用顺序;token 量级取自 README 原文,未独立复测。
该说的边界,也得说。
04四、三条现实约束
第一,它必须挂在宿主里。Claude Code、Codex、OpenCode、Cursor、Grok Bot 这些是它的土壤,没有宿主它什么也记不了。我这台机器没有,所以整条链路我没跑。
第二,数据在本地,也意味着隐私得你自己管。SQLite 加向量库都落在你的机器上,装之前想清楚它会记录多少工作内容。
第三,115 万 token 级的上下文在变便宜,有人会说记忆插件没必要。但只要你还得重开会话、还得解释一遍上下文,这层就省事。
顺便说个现实问题:这类插件会引入一个新的运维面。Worker 挂了、Bun 版本不对、数据库锁住了,症状都是「agent 突然失忆」,而你会先怀疑模型。装之前留一条命令给自己排查,比事后猜要省心。
未整跑:缺宿主 IDE
npm -g 只装 SDK,钩子不会注册
本地存储,隐私自负
与「长上下文」是两条路,不冲突
适合谁
每天在同一个仓库里跟 agent 反复拉扯的人。一周只开一次 agent 的,收益有限。
你上一次跟 agent 重复解释同一个项目架构,是什么时候?
我记得很清楚——就在今天早上。
记忆这件事,做得好你不会注意,做不好你天天在付费。
最后提醒一句:记忆做得越好,你越要注意它记了什么。定期翻一眼它的查看器,比事后惊讶要好——那些记录里可能有你不希望长期留存的客户信息和密钥片段。
再补一句:它的检索是靠向量加关键词混合做的,中文项目的注释和变量名混着来也不至于完全搜不到——这一点对中文用户比参数表上的数字更实用。
技术开源社