ARTICLE · 1342259
别再换更大的模型了:一个中国开发者写的插件,把 100K 的小窗口用出了十亿 token 的会话
6,100 多颗星、单日暴涨 764 颗、npm 累计下载约 393 万次——一个叫 billion-context 的上下文压缩插件,正在 GitHub Trending 上刷屏。它不训练模型、不换模型,只做一件事:把你的 AI 编程会话里已经"看过的"历史,悄悄压小。
这事跟你有直接关系:只要你用 Claude Code、Codex、Cursor 这类 AI 编程工具跑超过一天的活儿——改一个大项目、维护一段老代码——你早晚撞上两堵墙:上下文窗口撑爆,会话被迫重开,AI 失忆;token 账单失控,同样的代码上下文每一轮都在重复计费。这个项目给出的答案很反直觉:窗口不用换更大的,把历史压小就行了。
先说这是个什么东西
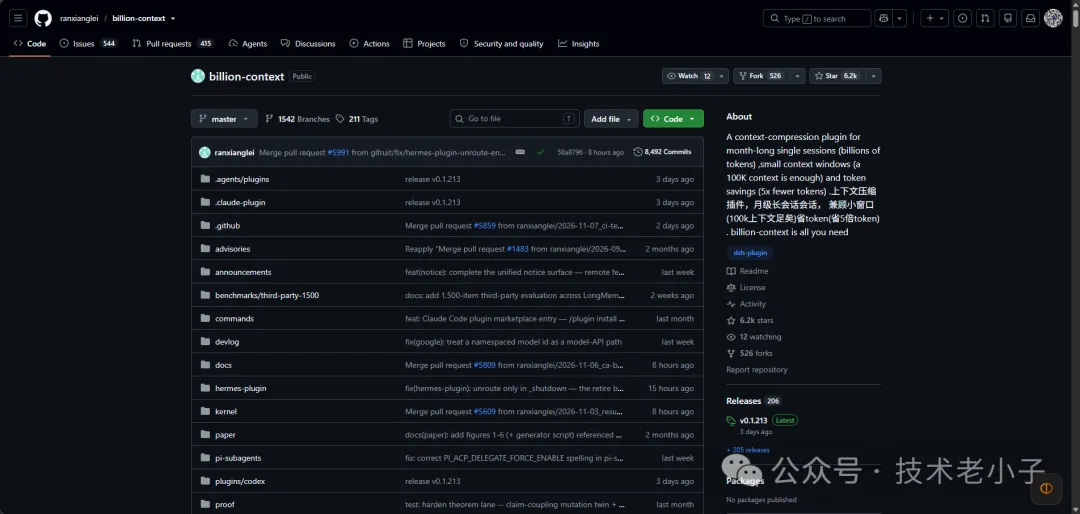
billion-context(命令名叫 bili)是一个开源的上下文压缩插件,作者 ranxianglei 是一位中国开发者,仓库从今年 8 月 6 日建仓,三个多月涨到 6,100 多颗星(GitHub API 实测 6,142★、471 fork),最新版本 v0.1.213 于 11 月 7 日发布。README 是中文优先写的,社区群也开在 QQ——从社区讨论看,中文技术圈对它的跟进速度明显快于英文圈。
它解决的核心问题一句话就能说清:AI 编程工具的会话越长,成本越高、越容易崩,而它让一个会话能连续跑几天甚至几周不重启。
用官方的话说,三个卖点:月级单会话(数十亿 token 流经同一个会话)、100K 的小窗口就够用、token 消耗降到原来的五分之一。这三个数字都是作者口径,后面我们会单独掰扯它们的水分。
它是怎么干活的:一层夹在中间的"翻译官"
理解这个工具,关键是理解它站在哪儿。它是一个 HTTP 反向代理——你可以把它想象成一个夹在你和模型服务商之间的中间人。你的 Claude Code 还是原来的 Claude Code,模型还是原来的模型,只是对话流量先经过它,它把已经聊过的历史"折叠"起来再发给模型。
具体机制是往对话里注入四个工具,让模型自己决定什么时候用:
• compress(压缩):把一段消息区间折叠成一份详细摘要,存在服务端; • decompress(解压):模型发现摘要里缺细节时,把原始记录还原回来; • search_context(检索):在压缩摘要和可见消息里做关键词搜索; • acp_status(状态):报告上下文用了多少、哪些区间可以压。
注意这个设计哲学:**压缩什么、什么时候压,是模型自己判断的,不是硬截断。**传统做法是超过窗口就砍头或黑盒摘要,模型没有发言权;这里模型像是拿到了一个"归档箱",自己决定哪些旧邮件塞进去、需要时再取出来。
真正值钱的一点:它对"前缀缓存"友好
如果只是"能压缩",市面上做上下文摘要的工具不少,这个项目凭什么三个月攒出六千星?答案是它踩中了大多数人不知道、但每个人都为之付过钱的机制——前缀缓存(prefix cache)。
先用人话解释这个机制:模型服务商计费时,你每一轮请求都要把完整对话历史重发一遍。为了给老客户优惠,服务商有个规定——如果这次请求的前半部分跟上次一模一样,这部分按大幅折扣计费,这就是"缓存命中"。你每一轮新对话其实只有最后几句话是新的,前面那一大段历史都能吃折扣。
**问题来了:凡是会"改写历史"的摘要工具,都是在亲手砸掉自己的折扣。**黑盒摘要把前面的历史重写、重排了,下一轮请求的前半部分跟上一轮对不上,缓存全部作废,你的账单反而更贵。这就是为什么很多人用了自带摘要功能之后,感觉"越用越贵"。
billion-context 的压缩是增量写入的:摘要在小范围内追加,已经稳定的部分一个字不动,缓存前缀保持完整。它还是可逆的:折叠的范围在历史里保持"摘要形态"而不是被抹掉,怀疑摘要漏了关键细节,一条 decompress 命令就能把原始消息找回来。项目给出的健康指标:正常会话的前缀缓存命中率应在 95%–97% 之间,压缩本身的额外开销不超过 2%——⚠️ 这是作者自报的口径。
配套的 /acp-cache 命令把缓存命中归因、可压缩区间、上下文构成全部摊开给你看。对把长会话当生产资料的重度用户,这种透明度本身就是卖点:宿主自带的摘要是黑盒,压掉了什么你永远不知道。
三篇证据链:从生产数据到第三方评测
这个项目少见的诚实做法是把证据全摊在仓库里。
第一份是生产规模的纵向研究:作者用四个半月、跨三个宿主客户端,累计 174,327 次模型调用、输入侧 187.6 亿 token,在 204,800-token 的窗口硬限制下做到零违规(从未因上下文溢出中断),最长的马拉松会话连续 8,584–12,049 次调用。论文随代码以 MIT 许可开源在仓库 paper 目录,并且声明是"活文档",接受任何人提 PR 修订。
第二份是自称的 1,500 题第三方评测:LongMemEval-S 记忆基准 79.20% 对比最佳 RAG 方案的 62.60%,ContextBench 综合第一、成本比不压缩低 58.3%,MemoryAgentBench 上 148 万 token 的会话 100% 存活。
第三份是迭代节奏本身:三个多月推进到 0.1.213,平均一天一个多版本,README 里专门维护"严重缺陷公告"章节并配强制更新通道。
必须泼的冷水:前两份的核心数字全部来自作者自报,第三方评测的"第三方"身份未独立核验,⚠️ 全部按待确认处理。生产研究的样本就是作者自己的工作负载,能不能迁移到你的场景,得自己验。倒是第三份——迭代密度和"不遮掩缺陷"的姿态——是可以直接观察到的。
怎么上手:三档接入,一分钟装完
安装一条命令:npm install -g billion-context(Windows 直接跑;Linux/macOS 官方建议加 --prefix=~/.local)。装完之后按你的工具选姿势,接入门路分三档:
1. 原生插件:有插件接口的工具一条命令挂载,比如 Claude Code 用户跑 bili plugin install claude,pi、OpenCode、Codex、Kimi 等都在列;2. 启动器:没有插件接缝的闭源工具,用 bili <客户端名>启动一个被包裹的会话,证书信任自动配置;3. URL 前缀:最通用的兜底——把工具的 API 地址改成 http://localhost:8787/bili/https://api.openai.com/v1这样的形式,流量绕道本地代理,Gemini CLI、aider、Copilot 这类最难啃的闭源二进制也能接。
合计支持 25 款以上客户端,README 给每一款的流量路径、证书机制都写了专门的适配文档。装完用 curl http://localhost:8787/__bili/health 验证代理活着,/acp-cache 看缓存健康度——命中率持续低于 95% 就按文档排查。
值得一提的是它的远程模式和会话派生:代理可以跑在远程服务器上(--host 参数),子会话可以继承父会话的压缩上下文,在主任务上分叉出并行探索分支而不丢主线记忆。
坑在哪、别被忽悠了
**第一,许可证不是纯 MIT。**仓库标注 MIT,但附加了一条署名条款:任何用户可见或可交互的产品只要用了这个软件,需要在首页、文档或 About 页注明使用并链接回仓库。个人使用无所谓,想集成进自己商业产品的团队,先把 LICENSE 全文拿给合规看。
**第二,压缩决策依赖模型的工具调用纪律。**压什么、什么时候压是模型自己定的,不同模型表现会有差异——纪律差的模型可能该压不压(浪费钱),也可能乱压(丢细节)。0.1.x 还在快速迭代期,生产环境建议锁定版本并盯住强制更新公告。
**第三,两种接入方式互斥。**原生插件和独立扩展(billion-context-pi、opencode-acp)同时启用意味着双重压缩,装的时候别贪多。
**第四,"十亿 token"是能力上限不是承诺。**它证明的是机制上撑得住,不代表你的会话就该跑那么长。压缩必然有取舍——哪些事实保留、哪些归档、摘要错了怎么纠正,这是所有记忆系统的本质难题。先用非关键项目跑一周双轨对照:同样的任务一边裸跑一边挂压缩,对比 token 消耗和任务完成质量,数字会替你做决定。
往深看一层:这可能是上下文战争的分水岭
过去两年,"能记住更多"的军备竞赛是往模型侧打的:128K、200K、1M、乃至更大的窗口。窗口大当然好,但每一轮重发的历史也在同步膨胀——窗口越大,不管理上下文的用户账单涨得越快。
billion-context 代表的是另一个方向:**在客户端与模型之间加一层可验证的记忆管理基础设施。**它不要求你换模型、换工具,任何遵循标准工具调用协议的模型都能直接受益——这也是它敢于声称支持 25 款客户端的技术前提。当"压缩即服务"成为一种独立的开源品类,模型厂商宣传的"超大窗口"就从刚需变成了可选项。
对这个赛道的判断留给你:如果你的日常是问一句答一句、会话不超过一小时,这个插件意义不大,工具自带的窗口管理够用;如果你有过"为了让 AI 记住三周前的架构决策而反复粘贴文档"、"月底账单三位数美元"、"任务跑到一半上下文溢出被迫重开"的任何一种经历——它值得装上试一周。