ARTICLE · 1356306
Claude Code 源码泄露:拆解 Claude Code 源码后,我发现它更像一个“AI 操作系统”
Claude Code 源码泄露:拆解 Claude Code 源码后,我发现它更像一个“AI 操作系统”
别再只会用 AI 写代码,你可能低估了它的复杂度
2026 年 3 月 31 日,一件在工程圈炸裂的事情发生了:安全研究者 Chaofan Shou 发现,Anthropic 发布到 npm 的 Claude Code 包中,source map 并未剥离。
这意味着什么?
整整 51.2 万行 TypeScript 源码、1903 个文件,毫无遮挡地暴露在公网。
这不是一个“demo 级工具”的体量,而是一个工程体系。
我没有逐行通读,而是带着三个关键问题切入:
Claude Code 和其他 AI 编程工具本质差异在哪?
为什么它的“手感”明显更顺?
51 万行代码,到底在解决什么问题?
读完之后,一个结论非常明确:
Claude Code 并不是一个 AI 编程工具,而是一套以 LLM 为内核的操作系统。
别再把 AI 当聊天接口:它其实在“操作你的环境”
如果你雇一个远程程序员,你会怎么管?
设想你把电脑权限交给一个远程工程师:
如果是 Cursor 风格:你盯着他,每一步都点“允许”
如果是 Copilot Agent:你给他一台隔离机器,他干完再提交
如果是 Claude Code:
他直接操作你的电脑,但所有行为都被精细化约束
这套约束包括:
能执行哪些命令
哪些必须人工确认
哪些完全禁止
即便执行
rm -rf,也要多层校验
这背后其实是三种完全不同的设计哲学:
| 工具 | 核心策略 |
|---|---|
| Cursor | 人工实时监管 |
| Copilot Agent | 环境隔离 |
| Claude Code | 精细化权限控制 |
为什么 Anthropic 选最复杂的一条?
因为只有这样,AI 才能真正使用:
你的终端
你的 Git 状态
你的项目约定
而不是在“隔离环境里写代码,再复制回来”。
代价是什么?
51 万行工程代码。
别再以为 AI = 输入输出:Claude Code 实际是 7 层系统
大多数人理解的 AI 编程流程:
用户输入 → 调用 LLM → 返回结果 → 展示而 Claude Code 的真实流程更接近这样:
用户输入→ 动态拼装 7 层 Prompt→ 注入 Git / 项目 / 记忆→ 加载工具系统(按需)→ LLM 决策工具调用→ 多层安全审查→ 权限竞争协调→ 延迟防误触→ 执行→ 流式返回→ 上下文压缩→ 子 Agent 并发执行→ 循环直到完成
这已经不是“调用模型”,而是一个运行时系统。
别再手写 Prompt:Claude Code 的提示词是“编译出来的”
核心代码
///usr/local/claude-code/src/constants/prompts.tsexport async function getSystemPrompt(tools: Tools,model: string,): Promise<string[]> {return [getSimpleIntroSection(),getSimpleSystemSection(),getActionsSection(),...(shouldUseGlobalCacheScope() ? [SYSTEM_PROMPT_DYNAMIC_BOUNDARY] : []),...resolvedDynamicSections,].filter(Boolean)}
关键点在这里:
SYSTEM_PROMPT_DYNAMIC_BOUNDARY这是一个“缓存分界线”:
上面:静态 Prompt(可缓存)
下面:动态内容(Git、记忆、环境)
这带来三个核心收益:
成本下降(缓存命中)
响应更快
每次对话都具备上下文感知
本质上,这是在做:
Prompt 编译优化,而不是 Prompt 编写。
别再忽视工具设计:每个工具都有“AI 使用说明书”
路径示例:
//usr/local/claude-code/src/tools/bash/prompt.tsGit Safety Protocol:- NEVER run destructive git commands- NEVER skip hooks- ALWAYS create new commits
这些不是给人看的文档,而是写给模型的行为约束。
这解释了一个现象:
Claude Code 很少做危险操作,不是模型更聪明,而是规则更严格。
别再堆功能:42 个工具是按需加载的
核心注册逻辑:
//usr/local/claude-code/src/tools/index.tsexport function getAllBaseTools(): Tools {return [BashTool,FileReadTool,FileEditTool,WebSearchTool,...(isToolSearchEnabledOptimistic() ? [ToolSearchTool] : []),]}
两个关键设计:
1)延迟加载
工具不会全部注入,而是:
需要时才加载
减少 token 消耗
2)极简模式
export CLAUDE_CODE_SIMPLE=true只保留:
Bash
Read
Edit
别再忽视安全:默认全部“不安全”
统一工厂方法:
///usr/local/claude-code/src/tools/factory.tsconst TOOL_DEFAULTS = {isConcurrencySafe: () => false,isReadOnly: () => false,}
这是典型的:
fail-closed(默认拒绝)设计
也就是说:
如果你没声明安全性,系统默认你是危险的
别再让 AI 乱改代码:“先读后改”是硬规则
function getPreReadInstruction(): string {return `You must use Read tool before editing`}
如果没读文件直接修改:
直接报错
这也是为什么 Claude Code 很少“胡乱覆盖代码”。
别再低估记忆系统:它真的在“认识你”
核心机制:
//usr/local/claude-code/src/memory/select.tsconst SELECT_MEMORIES_SYSTEM_PROMPT = `Return up to 5 useful memories`
关键点:
用一个小模型筛选记忆
只选最相关的 5 条
精度优先,不追求覆盖
别再觉得这是普通缓存:它甚至有“做梦机制”
日志结构:
/usr/local/claude-code/logs/2026/03/2026-03-30.md经过处理:
/usr/local/claude-code/memory/user_preferences.md流程:
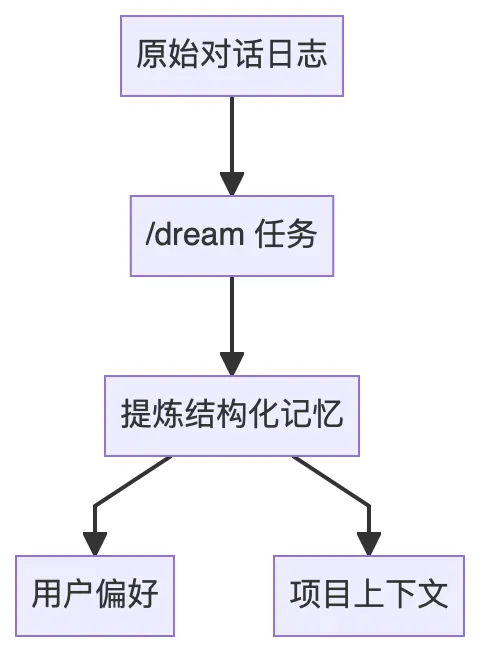
这已经不是缓存,而是:
记忆演化系统。
别再把它当单 Agent:它其实是“AI 蜂群”
子 Agent 定义:
//usr/local/claude-code/src/agent/AgentTool.tsz.object({description: z.string(),prompt: z.string(),model: z.enum(['sonnet', 'opus']),})
子 Agent 有严格限制:
export function buildChildMessage(): string {return `You are NOT the main agent.Do NOT spawn sub-agents.`}
也就是说:
子 Agent = 工人,不允许再拆任务
协调模式(任务编排)
Phase 1: ResearchPhase 2: SynthesisPhase 3: ImplementationPhase 4: Verification
原则:
读操作:并行
写操作:串行
别再担心上下文爆炸:三层压缩机制
第一层:微压缩
删除旧工具输出:
[Old tool result cleared]第二层:自动压缩
触发条件:
使用量达到 87%
第三层:完全压缩
AI 总结历史:
constNO_TOOLS_PREAMBLE=`TEXT ONLY. Do NOT call tools.`
避免总结过程中再次调用工具。
别再只看模型能力:90% 的工作在模型之外
51 万行代码里:
LLM 调用 < 5%
其余 95% 包括:
| 模块 | 内容 |
|---|---|
| 安全系统 | 多层审查 |
| 权限控制 | allow / deny |
| 上下文管理 | 压缩 + 记忆 |
| 调度系统 | 多 Agent |
| UI 系统 | React + IDE Bridge |
| 性能优化 | cache / 并发 |
别再用“Prompt 工程”理解它:这是系统工程
Claude Code 的 Prompt:
7 层动态拼装
工具级说明文档
缓存边界设计
内外版本差异
顺序稳定保证 cache 命中
这已经不是写 Prompt,而是:
构建 Prompt 编译系统。
别再把 AI 当工具:Anthropic 在做的是“操作系统”
重新理解 Claude Code:
| 组件 | 类比 |
|---|---|
| 工具系统 | 系统调用 |
| 权限系统 | 用户权限 |
| Agent | 进程 |
| 记忆 | 文件系统 |
| 压缩 | 内存管理 |
| MCP | 驱动 |
真正的 AI 产品,不是更聪明,而是更可靠
51 万行代码的意义,不在规模,而在方向。
Anthropic 给出的答案是:
AI 既不能被完全限制,也不能完全放开。
你必须为它构建:
可控的权限体系
可恢复的执行机制
可扩展的工具系统
可持续的上下文管理
最终你会发现:
决定 AI 产品体验的,不是模型有多强,而是系统有多稳。