ARTICLE · 1366605
把整个文档库压成 16 个 token:斯坦福这篇论文,先说了好处,再说了代价
把整个文档库压成 16 个 token:斯坦福这篇论文,先说了好处,再说了代价AI 记忆 · 11/16 把整个文档库压成 16 个 token:斯坦福这篇论文,先说了好处,再说了代价 文 / 胜比特 · 阅读约 8 分钟 斯坦福团队开源了一个叫 Memorilla 的记忆模块。它做的事听上去很极致:面对一整个文档库,不给模型读全文,也不检索出原文段落,而是把相关信息压成 16 个"软 token"送进冻结的大模型。 论文给出的数字很能打:在 FactKG 事实核查基准上,16 个记忆 token 拿到 84.33% 的准确率,全上下文(把文档全塞进去)是 80.43%,而读取的文档 token 少了 108 倍。在 LaMP-4 上领先全上下文 3.94 个 ROUGE-L 点,文档 token 少了 474 倍。 但在论文后半段,作者自己把另一面写清楚了:这些软 token 会丢掉细粒度的事实细节,它们是连续向量、不是人类能读的文本,而且三个基准上输给了别的方法。 好处和代价在同一篇论文里,这在 AI 记忆方向并不常见。值得两边都看。 一、16 个 token 到底是什么,不是什么 先把最常见的误解拆掉:Memorilla 不是把整个文档库永久压成 16 个文本 token。 论文里的机制分两步。第一步,用一个冻结的编码模型,把每篇文档——可能是一段对话、一个书章节——编码成一个持久化的向量,存进一个库里。这一步只做一次。 第二步,每次来一个新问题,一个可训练的记忆模块去"注意"库里的每一个向量,做一次以问题为条件的读取,输出固定数量(默认 K=16)的软 token。这 16 个 token 是模型输入嵌入空间里的连续向量,维度和一个正常文本 token 相同,所以它可以直接和文字拼在一起送进模型。 关键在这:文档原文全程不进上下文。RAG 是把检索到的文档段落当成文本 token 塞进去,Memorilla 是把"该记什么"压缩成 16 个向量,让模型直接读。用论文的话说,它从整个集合里"回忆"出对这个问题重要的东西,而不是把文档搬进上下文。 冻结的模型是 Qwen3-8B, decoder 一个参数都不动,只训练那个约 1.94 亿参数的记忆模块。作者还特别指出,因为记忆存储在模型外部,用户的向量可以按需删除、可以留在本地设备上,不用重训模型。 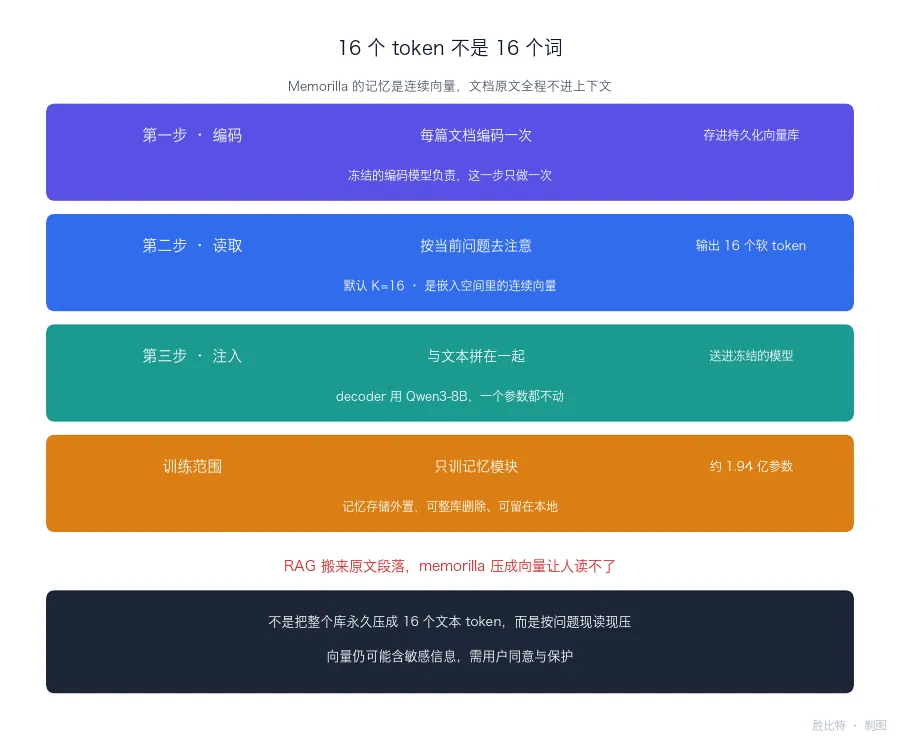
二、108 倍这个数,怎么来的 论文给了一组跨基准的对比,值得逐条看,因为它们的分母不一样。 FactKG 是知识密集型问答,任务是拿一个说法去知识库里核对。Memorilla 84.33%,全上下文 80.43%,MemoRAG 80.38%,xRAG 78.98%。论文特别注明,相比前两者,它用的文档 token 分别少了 108 倍和 36 倍。 LaMP-4 是个性化任务,Memorilla 18.15 ROUGE-L,全上下文 14.21,文档 token 少 474 倍。跨八个基准的平均分,Memorilla 49.68,而几个紧凑型基线 xRAG、LLMLingua-2、Mem0 分别是 41.92、40.75、38.02。 这里有个反直觉的发现:全上下文不是上限。论文明确写,除了 PubMedQA 之外,全上下文在每一个基准上都落后于 Memorilla,在表格的 21 个指标里输了 20 个。把整个文档库全塞进去,多数时候是帮倒忙——噪声和无关内容会稀释真正有用的信息。 这对做知识库产品的人是个提醒:上下文越长越好,是个需要验证的假设,不是公理。 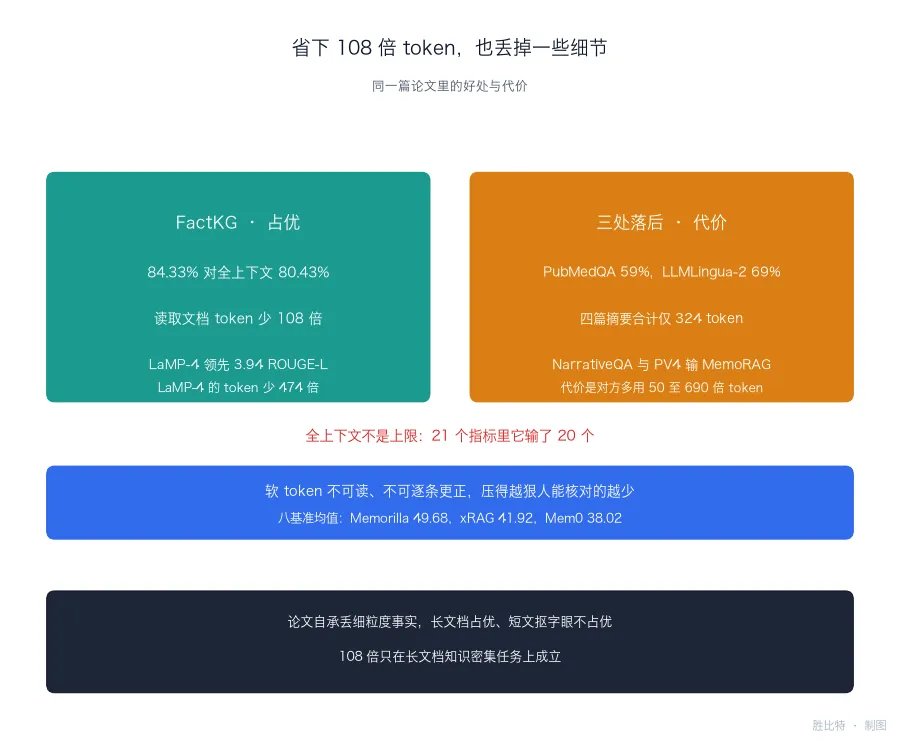
三、代价那一段:软 token 读不了,也删不掉其中一条 论文没有只报喜。它专门有一节叫"记忆什么时候不起作用"。 三个基准上别的方法领先:NarrativeQA 上 MemoRAG 的 ROUGE-1 和 ROUGE-L 更高(21.80 和 20.51,对 Memorilla 的 19.68 和 19.31),但代价是用了 50 倍的文档 token;PV4 上 MemoRAG 67.88% 对 66.65%,用了 690 倍的 token。PubMedQA 更典型——这个基准的四篇摘要加起来只有 324 个 token,短文场景里 LLMLingua-2 拿到 69%,Memorilla 只有 59%。 原因论文说得很直白:Memorilla 会丢掉细粒度的事实细节,很可能因为文档编码器当初就不是为记忆压缩训练的。长文档、大库上它占优,短文档、要抠字眼的任务上,老方法更稳。 但最值得注意的是它的形态:那 16 个 token 是嵌入空间里的连续向量,不是文本。你没法打开看"它记住了什么",也没法像编辑一段文字那样改掉其中一条。论文承认存储向量仍可能编码敏感信息,需要用户同意和保护;它也强调每个用户的记忆是独立的库、可以整体删除——但整体删除和逐条更正,是完全不同的两件事。 换句话说,这种记忆的效率来自把信息压进一个不可读的中间层。压得越狠、越省 token,人能核对的东西就越少。这是一个结构性的取舍,不是调参能绕过去的。 四、对"越用越懂你"的那类系统,这意味着什么 现在几乎所有做长期记忆的 Agent,都面临同一个选择题:记忆要以什么形态存在? 存成可读的文本,好处是能检查、能修改、能解释"我为什么这么答",坏处是越长越占上下文、越难检索。存成向量或软 token,好处是效率和压缩比惊人,坏处正是这篇论文自己写出来的那几条——丢细节、不可读、不可逐条更正。 一个务实的做法是把两者分开:把"可回溯的事实"存成能查原文、能逐条删除的形态,把"整体的语义印象"交给压缩表示。用户问起一个具体数字、一个日期、一句承诺,能回到原始记录;需要整体风格或长期偏好的判断,再用压缩的那部分。哪些结论来自哪一类记忆,分开标注。 这不是折中主义,而是承认两类需求本来就不同:可核对性要求可追溯,效率要求可压缩,它们的最优解不在同一个点上。能把边界划清楚的系统,比单纯比谁压得更狠的系统更值得信。 五、数字要连同它的适用范围一起记 回到 108 倍这个标题数字。它成立的前提是长文档、知识密集、需要跨整个库综合信息的任务。换成三篇摘要的 PubMedQA,同一个方法就落后了 10 个百分点。 一个指标离开它成立的范围,就只是一个漂亮的数字。论文把范围写在了正文里——三个基准落后、丢细粒度细节、短文场景不占优。转述的时候把这些一起带上,才算完整地读完了这篇论文。 记忆的目标不是"记得最多",而是"该记得住、能说得清、错了能改"。省下 108 倍 token 是好事,但如果代价是记了什么没人说得清,那这笔交易得重新算。 本文仅为技术与产业信息整理,不构成任何投资建议。