ARTICLE · 1368632
第 6.3 章:不同类型文档使用不同切分规则
《RAG 实战案例》第 6.3 节。
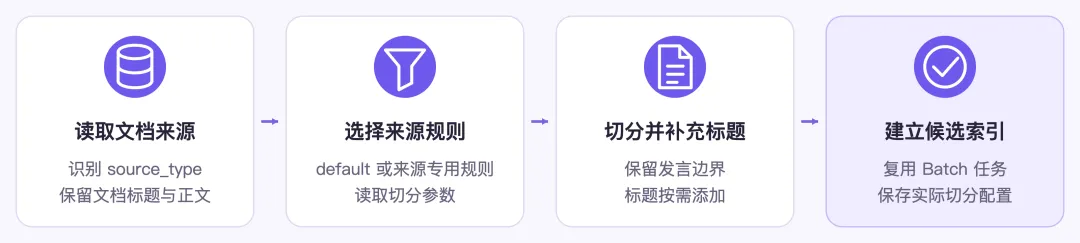
按来源选择切分规则,为会议记录保留发言边界,并支持给片段补充标题。
本节内容
会议记录、邮件和说明文档的结构不同,适合的切分规则也不同。本节把规则放进配置文件,索引时根据文档来源选择对应规则。
当前文档库用的是 Fireflies 会议记录。我们先把“按发言切分”的规则加进去,再补上“补充标题”的选项。6.4 补充结构感知切分的原理,6.5 再接入语义切分,预览和索引仍然共用这一套规则入口。
来源与正文结构
不同来源的文档要用不同的规则,具体怎么写,取决于正文的实际格式。例如:
本节的 Fireflies 规则针对当前文档中的“时间戳+发言人+正文”格式。接入其他来源时,也要先预览正文,再配好相应的规则。
切分配置
在 src/enterprise_rag_cli/domain/models.py 中补充导入:
from typing import Literalfrom pydantic import ConfigDict, model_validator然后在文件末尾增加:
# 分割策略class ChunkPolicy(BaseModel): # 输入数据中如果出现模型未声明的字段,直接报错 model_config = ConfigDict(extra="forbid") strategy: Literal["token", "sentence", "recursive"] = "token" chunk_size: int = Field(default=1200, ge=200) chunk_overlap: int = Field(default=150, ge=0) structure: Literal["paragraph", "meeting"] = "paragraph" include_title: bool = False # 跨字段校验 @model_validator(mode="after") def check_policy(self) -> "ChunkPolicy": if self.chunk_overlap >= self.chunk_size: raise ValueError("重叠长度必须小于切分长度") if self.strategy == "recursive" and self.chunk_overlap != 0: raise ValueError("递归切分的 chunk_overlap 必须为 0") if self.structure == "meeting" and self.strategy != "recursive": raise ValueError("meeting 结构需要使用 recursive 切分") return self创建 config/chunk-policies.json:
{ "default": { "strategy": "token", "chunk_size": 1200, "chunk_overlap": 150, "structure": "paragraph", "include_title":false }, "fireflies": { "strategy": "recursive", "chunk_size": 1200, "chunk_overlap": 0, "structure": "meeting", "include_title":false }}fireflies 对应文档的 source_type。来源匹配到 fireflies 时,就用它自己的配置,不走 default。所以当前会议记录走的是 recursive,不是默认的 token;其他来源没有专用配置时,才回落到 default。
structure 决定递归切分优先保留什么边界:paragraph 按段落,meeting 先按发言。include_title 控制是否补充标题,可以单独打开它来观察变化。
在 src/enterprise_rag_cli/config.py 的 Settings 中增加:
chunk_policies_path: Path = Path("config/chunk-policies.json")这里直接使用默认路径即可。
会议文档分割规则
在 src/enterprise_rag_cli/application/chunking.py 中增加:
# 定义「会议记录」的分层规则def meeting_rules() -> RecursiveRules: return RecursiveRules(levels=[ RecursiveLevel(delimiters=["\n["], include_delim="next"), *paragraph_rules().levels, ])当前会议记录里,每段新发言都以换行后的时间戳开头,例如 \n[01:55]。第一层规则按 \n[ 切开发言,并让时间戳跟着后面的发言走。单段发言超过长度上限时,再依次按段落、句子和字符继续拆。
修改 create_chunker 的参数列表,增加可选规则:
def create_chunker( chunk_size: int, chunk_overlap: int, strategy: str = "token", rules: RecursiveRules | None = None,) -> BaseChunker:在它的 recursive 分支中,把 rules=paragraph_rules() 改成:
rules=rules if rules is not None else paragraph_rules(),片段标题
单独取出“按 48 小时返回作业”这样的片段无法获取全局信息。给片段补上原文标题,就能带上一些主题背景。
将 chunking.py 中的 split_document 替换为:
# 执行切分def split_document( document: Document, chunker: BaseChunker, include_title: bool = False,) -> list[Chunk]: fallback = TokenChunker( tokenizer="character", chunk_size=chunker.chunk_size, chunk_overlap=0, ) title = " ".join((document.title or "").split())[:120] chunks = [] for raw_chunk in chunker.chunk(document.text): # 一条很长的句子也可能超过上限,继续按长度拆开。 pieces = ( fallback.chunk(raw_chunk.text) if len(raw_chunk.text) > chunker.chunk_size else [raw_chunk] ) for piece in pieces: text = piece.text if not text.strip(): continue if include_title and title and not text.lstrip().startswith(title): text = f"{title}\n\n{text}" if len(text.encode("utf-8")) > 8192: raise ValueError("Chunk 超过 Milvus 正文字段的 8192 字节上限,请减小切分长度") position = len(chunks) chunks.append(Chunk( chunk_id=make_chunk_id(document.document_id, text, position), document_id=document.document_id, source_type=document.source_type, source_id=document.source_id, position=position, text=text, token_count=len(text), )) return chunks标题最多取 120 个字符。原片段已经以标题开头时,不再重复添加。补充后的标题会同时参与向量生成和答案生成,所以也会算进片段长度。
Chunk ID 仍由文档 ID、片段正文和顺序生成。相同输入得到相同 ID;更换切法或补充标题后,正文或顺序可能改变,ID 也会随之改变。
规则加载与切分
创建 src/enterprise_rag_cli/application/chunk_policies.py:
from __future__ import annotationsimport jsonfrom pathlib import Pathfrom enterprise_rag_cli.application.chunking import ( create_chunker, meeting_rules, split_document,)from enterprise_rag_cli.domain.models import Chunk, ChunkPolicy, Document# 读取分割策略配置def load_chunk_policies(path: Path) -> dict[str, ChunkPolicy]: data = json.loads(path.read_text(encoding="utf-8")) if not isinstance(data, dict) or "default" not in data: raise ValueError("切分配置必须包含 default 规则") return { source: ChunkPolicy.model_validate(value) for source, value in data.items() }# 根据策略分割文档def split_with_policy(document: Document, policy: ChunkPolicy) -> list[Chunk]: rules = meeting_rules() if policy.structure == "meeting" else None chunker = create_chunker( policy.chunk_size, policy.chunk_overlap, policy.strategy, rules=rules, ) return split_document(document, chunker, include_title=policy.include_title)这两个函数分别负责读取配置和执行切分。预览和建立索引都调用它们,避免两边使用不同的规则。
预览命令的调整
在 src/enterprise_rag_cli/commands/chunks.py 中增加导入:
from enterprise_rag_cli.application.chunk_policies import load_chunk_policies, split_with_policyfrom enterprise_rag_cli.domain.models import ChunkPolicy将 strategy 参数改为可选。省略时使用来源配置:
strategy: ChunkStrategy | None = typer.Option(None, "--strategy"),把 preview 中从 actual_size = ... 到 chunks = ... 的四行替换为:
policies = load_chunk_policies(settings.chunk_policies_path)policy = policies.get(document.source_type, policies["default"])overrides = {}if size is not None: overrides["chunk_size"] = sizeif overlap is not None: overrides["chunk_overlap"] = overlapif strategy is not None: overrides["strategy"] = strategy.value overrides["structure"] = "paragraph"policy = ChunkPolicy.model_validate({**policy.model_dump(), **overrides})chunks = split_with_policy(document, policy)console.print(f"切分规则:{policy.model_dump()}")可以移除这个文件中已经不用的 create_chunker 和 split_document 导入。
执行:
uv run rag chunks preview dsid_aea4790d4bcc45859208d7d705f682a1 \ --contains "cold-cache"这次会自动使用 fireflies 规则。若要比较补充标题后的样子,把配置中 fireflies 的 include_title 改为 true,再运行一次。
Batch 索引接入
在 src/enterprise_rag_cli/application/batch_indexing.py 中,把原来的切分函数导入替换为:
from enterprise_rag_cli.application.chunk_policies import load_chunk_policies, split_with_policy在 prepare_full_index 中,把创建 chunker 的代码替换为:
policies = load_chunk_policies(settings.chunk_policies_path)把内部 chunks() 函数中的文档循环替换为:
for document in documents: policy = policies.get(document.source_type, policies["default"]) yield from split_with_policy(document, policy)最后,在这个函数调用 _save_manifest 前增加:
manifest["chunk_policies"] = { source: policy.model_dump() for source, policy in policies.items()}每个索引任务会保存实际使用的规则。即使之后修改了配置,也能查到旧索引是怎么切分的。
相关链接
• Chonkie RecursiveChunker:https://docs.chonkie.ai/oss/chunkers/recursive-chunker • Pydantic 模型校验:https://docs.pydantic.dev/latest/concepts/validators/ • 本节源码:https://github.com/agua-du/enterprise-rag-cli